
blog
AIブログ
クラスタリングとは | 分析の手法などをわかりやすく解説!
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
クラスタリングとは、教師なし学習と呼ばれる機械学習の一手法で、正解ラベルを与えずにデータの類似性・距離に基づいてグループ(クラスタ)に自動分類する技術です。クラスタ分析とも呼ばれ、マーケティングのセグメンテーションから異常検知・画像認識まで、幅広いビジネス課題に活用されています。本記事では、クラスタリングの意味、分類との違い、距離の考え方、主な手法の比較と選び方、クラスタ数の決め方と評価、Pythonでの試し方、活用例とメリット・デメリットまでを、初めての方にもわかりやすい順に解説します。
クラスタリングとは何か?ひとことでわかりやすく言うと
クラスタリングとは、正解(ラベル)を人が教えなくても、似ているデータ同士をコンピュータが自動でグループ分けする、機械学習の「教師なし学習」の手法です。
初心者がつまずきやすいのは「分類(クラス分類)」との違いです。ポイントを絞ると次のとおりです。
- グループを誰が決めるか:分類(クラス分類)は「迷惑メールか否か」のように人が正解のカテゴリを先に用意しますが、クラスタリングはグループの中身も数もデータ側から自動で見つけ出します(=正解ラベルが不要)。
- 身近な例:顧客データを渡すだけで「よく買う人」「たまに買う人」「離れそうな人」のように、似た者同士の集団へ自動で仕分けできます。事前にどんな層があるかを知らなくても分けられるのが特徴です。
- 向いている場面:正解が存在しない探索的な課題――たとえば未知の顧客層の発見や新市場の開拓、異常検知――のように「まだ答えがない」問題に強みを発揮します。
クラスタリング以外にはどんな種類があるかは、機械学習の種類とアルゴリズムで解説しています。
教師なし学習としてのクラスタリング:分類との違いと2つのタイプ
機械学習は大きく「教師あり学習」と「教師なし学習」の二つに分類されます。クラスタリングは教師なし学習に属します。
教師なし学習とは、正解データ(ラベル)を与えずにデータそのものに潜む構造やパターンを発見する学習方法です。正解と不正解が明確に定義された問題に有効な教師あり学習とは異なり、教師なし学習は「まだ答えが存在しない」状況、たとえば新市場の開拓や未知の顧客層の発見といった探索的な問題に適しています。
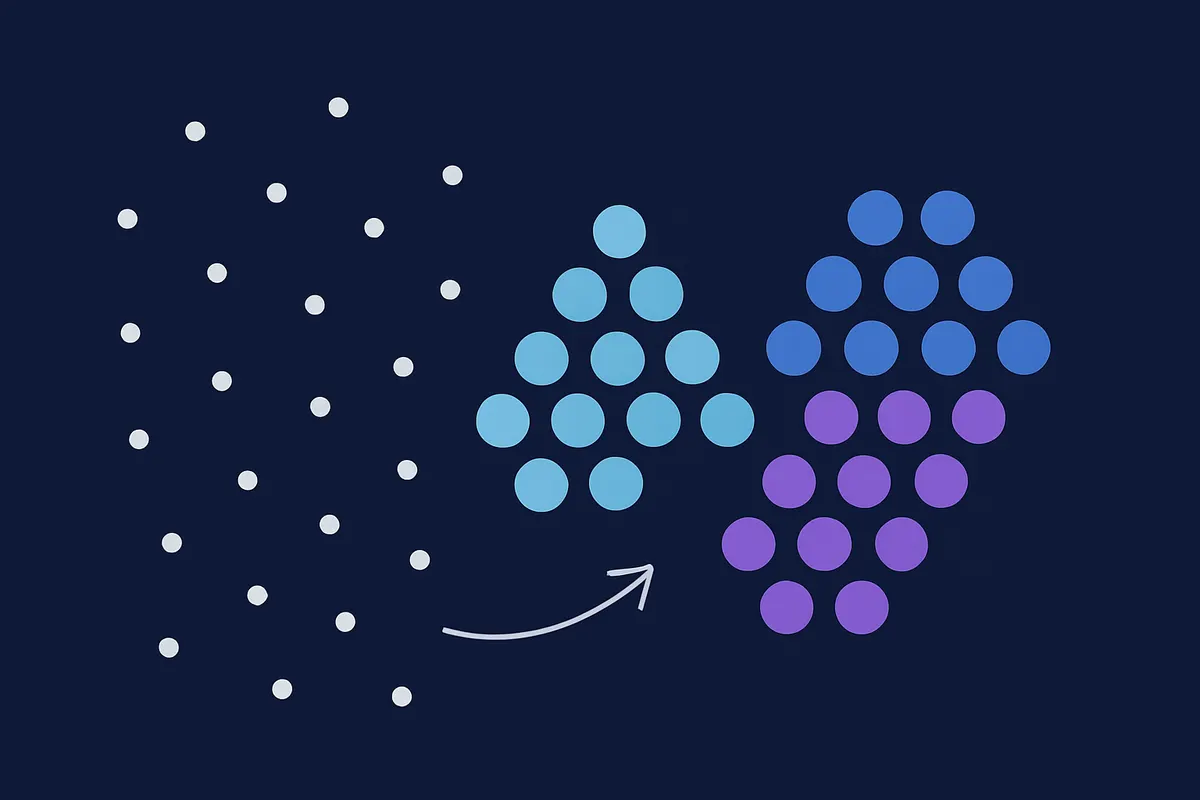
その教師なし学習の代表的手法がクラスタリングです。与えられたデータの特徴量を解析し、互いに似ているデータ点を同じクラスタ(グループ)にまとめます。対象となるデータは顧客属性・購買履歴・テキスト・画像・センサーデータなど多岐にわたり、顧客セグメンテーション・市場分析・異常検知・文書分類など幅広い場面で活用されます。
分類との違い
データをグループ分けするという点で「分類(Classification)」と混同されがちですが、両者は本質的に異なります。
| 比較項目 | クラスタリング | 分類(Classification) |
|---|---|---|
| 学習の種類 | 教師なし学習 | 教師あり学習 |
| 正解ラベル | 不要 | 必要 |
| グループの定義 | データから自動発見 | 事前に人間が定義 |
| 主な目的 | 未知の構造・パターンの発見 | 既知のカテゴリへの振り分け |
| 活用例 | 顧客セグメント発見・市場開拓 | スパム判定・画像認識 |
分類は「すでにあるデータを参考に、新しいデータが既知のカテゴリのどれに当てはまるかを予測する」手法です。一方、クラスタリングは明確な正解を持たず、データを分けること自体が目的ではなく、グループ分けを通じて新たな知見・市場を発見することに本質的な目的があります。
階層クラスタリングと非階層クラスタリング
クラスタリングは大きく「階層クラスタリング」と「非階層クラスタリング」の2種類に分けられます。それぞれ特性が異なり、データの性質や分析目的に応じて使い分けることが重要です。
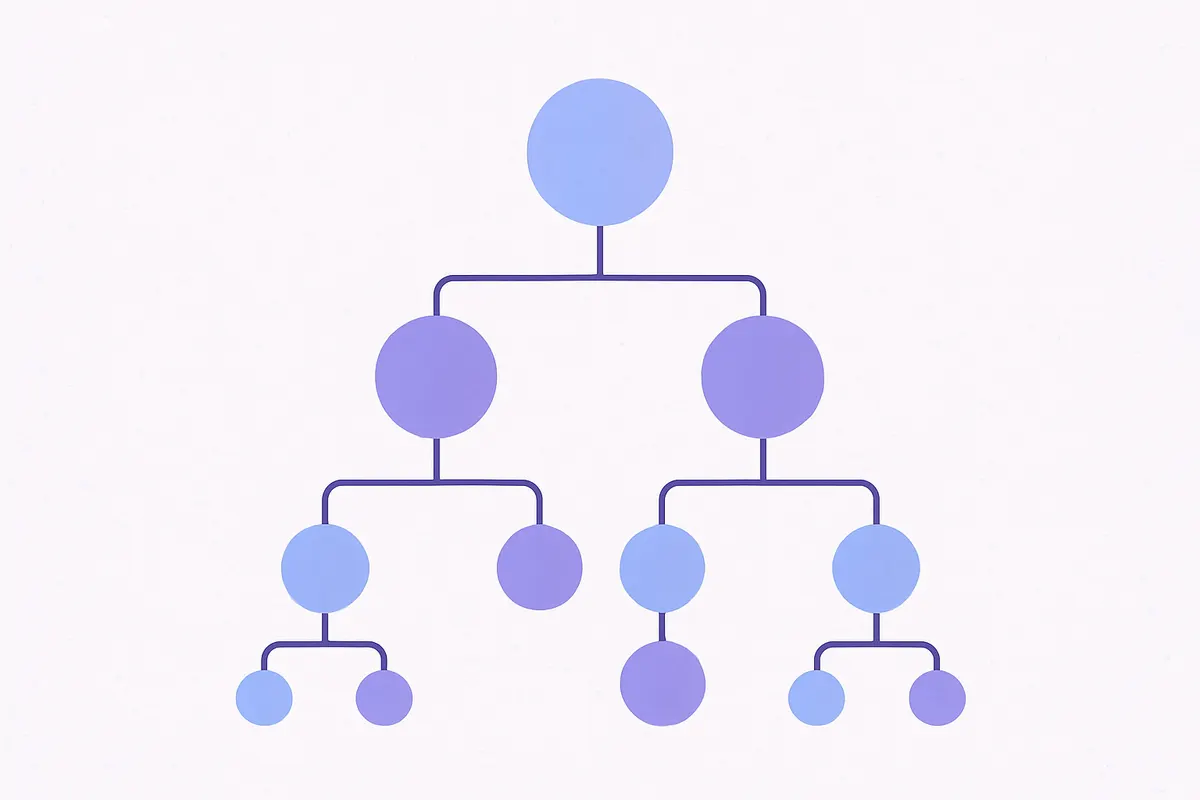
階層クラスタリングとは、データを段階的に統合(または分割)しながら、樹形図(デンドログラム)状のグルーピング構造を構築する手法です。たとえば寿司ネタを例にすると、まず「赤身・白身」と大きく二分し、赤身の中をさらに「マグロ・サーモン・カツオ」に分け、マグロをさらに「大トロ・中トロ・赤身」と細分化するイメージです。グルーピングの過程が樹形図として可視化されるため結果が直感的に把握しやすく、サンプル数が少ない場合に特に有効です。
非階層クラスタリングとは、あらかじめクラスタ数を決定し、その数のグループにデータを割り振る手法です。階層構造を作らないため計算コストを抑えやすく、大量データにも適用しやすいのが特徴です。ただし、最適なクラスタ数を自動で決定する汎用的な方法が確立されていないため、分析者がエルボー法やシルエット係数などを参考にしながら適切なクラスタ数を検討する必要があります。
- 樹形図(デンドログラム)で可視化
- サンプル数が少ない場合に有効
- グループ数を事前に決めなくてよい
- 大規模データでは計算コストが高い
- あらかじめクラスタ数kを指定
- 大量データに対応しやすい
- 計算が比較的高速
- クラスタ数の決定が課題
次に読む:データマイニングの手法と活用事例は?
ITで言う「クラスタリング」との違い:サーバーのクラスタ構成
IT用語の「クラスタリング」には、本記事のデータ分析とは別に、複数のコンピュータ(サーバー)を連携させて1台のシステムのように動かす構成を指す使い方があります。1台が故障しても別のサーバーが処理を引き継げるようにする(可用性の向上)、処理を分散して性能を上げる、といった目的で使われます。
| 観点 | データ分析のクラスタリング | サーバーのクラスタリング |
|---|---|---|
| 対象 | データ点(顧客・文章・画像など) | コンピュータ(サーバー) |
| やること | 似たデータを自動でグループ分け | 複数台を連携させ1つのシステムとして運用 |
| 主な目的 | データの構造・パターンの発見 | 障害への強さ・処理性能の向上 |
| 関連する分野 | 機械学習(教師なし学習) | インフラ・ネットワーク |
本記事は前者、機械学習のクラスタリング(クラスタ分析)を扱います。
クラスタリングはどうやってグループを決めるのか:距離と大まかな流れ
クラスタリングの多くは、データ点どうしの「距離」を「似ていなさ」の目安にします。距離が近いものほど似ている、と見なして同じグループに入れる、という考え方です。距離の測り方には代表的なものが3つあります。
| 距離・類似度 | 測り方 | 向く場面 |
|---|---|---|
| ユークリッド距離 | 2点を結ぶ直線の長さ | 数値データ全般。k平均法やウォード法の標準的な距離 |
| マンハッタン距離 | 各特徴量の差の絶対値を足し合わせた値 | 外れ値の影響を抑えたいとき、格子状の移動距離 |
| コサイン類似度 | 2つのベクトルの向きの近さ(長さは無視) | 文章や埋め込みベクトルなど、向きが意味を持つデータ |
流れはどの手法でも同じです。①分けたいデータと特徴量(年齢、購入回数、文章の埋め込みなど)を決める、②特徴量のスケールをそろえる(後述の前処理)、③距離を定義して手法を選ぶ、④グループを作る、⑤各グループの中身を見て人が意味づけする、の順です。⑤は自動化できず、「このグループは休眠顧客」のように名前をつけて初めて業務で使える結果になります。
クラスタリング手法の比較と選び方
手法は多数ありますが、選ぶ基準は「データの量」「グループの形」「グループ数を決められるか」「外れ値を扱いたいか」の4つに絞れます。機械学習ライブラリ scikit-learn の公式ドキュメント(Clustering、2026年10月29日確認)の整理をもとに、代表的な手法を比べます。
| 手法 | 事前に決める値 | データ量への強さ | 得意なケース |
|---|---|---|---|
| k平均法(K-Means) | クラスタ数 | 大量データ向き | 丸くまとまった、大きさが似たグループ |
| ウォード法(階層型) | クラスタ数または距離のしきい値 | 大きなデータにも対応 | 樹形図で過程を見ながら分けたいとき |
| DBSCAN | 近傍の範囲(eps)など | 大量データ向き | いびつな形のグループ、外れ値の除去 |
| HDBSCAN | 最小クラスタ人数など | 大きめのデータ向き | 密度がばらつくデータ、外れ値の除去 |
| スペクトラルクラスタリング | クラスタ数 | 中規模まで | 非線形で複雑な形、クラスタ数が少ないとき |
| 混合ガウスモデル(GMM) | クラスタ数など複数 | 大規模には不向き | 所属を確率で表したいとき |
迷ったときの目安は次のとおりです。
- まず試すならk平均法:速く、結果の解釈も単純です。クラスタ数kを決める必要があります。
- グループ数が分からない・形がいびつ・外れ値を除きたい:DBSCANやHDBSCANを検討します。
- グループができる過程を説明したい:階層クラスタリング(ウォード法)で樹形図を示します。ただしデータ件数が増えると重くなります。
- どれが正しいか分からない:複数の手法で分けて、グループの中身が業務上説明できるものを採用します。
クラスタリングの分け方の違い:ハードとソフト、凝集型と分割型、混合ガウスモデルとEMアルゴリズム
手法は「1点を必ず1つのグループに入れるか」「グループを作る向き」でも整理できます。
| 分け方 | 内容 | 代表的な手法 |
|---|---|---|
| ハードクラスタリング | 各データを必ず1つのクラスタだけに所属させる | k平均法、DBSCAN、ウォード法 |
| ソフトクラスタリング | 各データがどのクラスタにどれくらい属するかを確率で表す | 混合ガウスモデル(GMM) |
| 凝集型(ボトムアップ) | 1点ずつのクラスタから、近いもの同士を順に統合していく | ウォード法、群平均法 |
| 分割型(トップダウン) | 全体を1つのクラスタとして、順に分割していく | 二分k平均法(Bisecting K-Means)など |
混合ガウスモデル(GMM)は、データが複数の正規分布(ガウス分布)の混ざったものから生まれたと考え、各分布の中心・広がり・混ざる比率を推定する手法です。推定にはEMアルゴリズムを使います。Eステップで「各データが各分布から生まれた確率」を計算し、Mステップでその確率をもとに各分布の平均・分散・比率を更新する、という2段階を、結果が変わらなくなるまで繰り返します。k平均法の「最も近い重心に割り当てて重心を更新する」を、確率で行うものと考えると理解しやすくなります。
アイリスのデータをGMM(3成分、GaussianMixture(n_components=3, random_state=0))で分けた結果、70番目のデータは「ある成分に94.1%、別の成分に5.9%」と、2つのグループにまたがって所属すると出ました。k平均法のように必ずどちらか1つとして扱う手法では、この「境目にいる」という情報が失われます。顧客を「優良顧客70%・休眠予備軍30%」のように扱いたいときに向きます。
DBSCANとHDBSCAN:密度でグループを見つける手法と外れ値の扱い
k平均法は「丸い塊」を前提にしますが、DBSCANはデータが密集している領域をグループとして見つけます。クラスタ数は決めず、代わりに2つの値を指定します。
- eps:近傍と見なす半径
- min_samples:その半径内に最低何点あれば「密集している」と見なすか
半径eps内にmin_samples点以上ある点をコア点、コア点の近くにあるがそれ自身は条件を満たさない点を境界点、どちらでもない点をノイズ(外れ値)と呼びます。コア点どうしがつながる範囲が1つのクラスタになり、ノイズはクラスタに入れられず「-1」のラベルが付きます。HDBSCANはDBSCANを拡張し、epsを事前に決めなくても、密度がばらつくデータを扱える手法です(scikit-learn公式ドキュメント、2026年10月29日確認)。
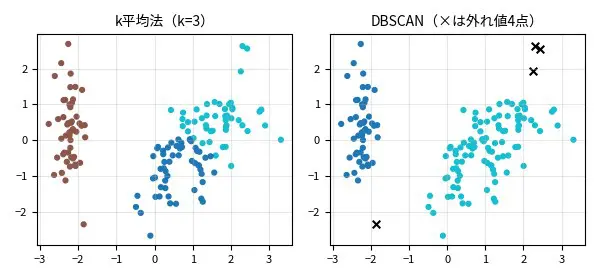
同じデータにDBSCAN(eps=0.9、min_samples=5)を使うと、2つのクラスタ(49点と97点)と外れ値4点に分かれました。k平均法のようにkを指定せずに分けられ、外れ値も自動で取り除けた一方、実際の品種は3種類なので、重なり合う2品種は1つの塊として扱われています。密度で分ける手法は、グループ同士が近接している場合に分け切れないことがあります。
代表的な3つの手法の仕組み(群平均法・ウォード法・k平均法)
クラスタリングの多くの手法では、データ点間の「距離」を類似度の指標として使用します。最も基本的な指標がユークリッド距離で、二点間の直線距離に相当します。距離が近いデータ点ほど「似ている」と判断して同じクラスタに分類します。以下に代表的なアルゴリズムを紹介します。
群平均法(平均連結法)
階層クラスタリングの代表的手法の一つです。二つのクラスタ間に含まれるすべての点の組み合わせにおける距離の平均値をクラスタ間距離として定義し、この平均距離が最も小さいクラスタ同士を順番に統合していきます。
最も近い点同士でクラスタを統合する「単連結法(最短距離法)」と、最も遠い点同士の距離でクラスタを統合する「完全連結法(最長距離法)」の中間的なアプローチに当たります。一つだけ大きく外れた外れ値が存在しても、その影響を平均化によって緩和できる点が強みです。
ウォード法(最小分散法)
階層クラスタリングの中でも実務で最も広く使われる手法の一つです。二つのクラスタを統合した場合に、クラスタ内分散(各点と重心の距離の二乗和)の増加量が最小になる組み合わせを選んで統合します。
群平均法と同様に外れ値の影響を受けにくく、形状が均等で円状のクラスタが形成されやすい特徴があります。クラスタ内がコンパクト(密集)になるように統合を繰り返すため、視覚的にも解釈しやすいデンドログラムが得られることが多いです。
k平均法(k-means法)
非階層クラスタリングの中で最も広く知られたアルゴリズムです。kはクラスタ数を意味し、以下の手順で繰り返しグループを更新します。
処理が高速で大規模データにも対応しやすいため実務で広く採用されています。ただし、初期重心をランダムに配置する性質上、初期値によってはクラスタ重心が近接してしまい、最適な分類に収束しない場合があります。
この弱点を補う手法としてk-means++があります。k-means++では、最初の重心は通常通りランダムに選びますが、2つ目以降の重心は既存の重心からの距離が大きい点ほど高い確率で選ばれるよう設計されています。これにより初期重心が偏らずに分散して配置され、最終的なクラスタリングの品質と安定性が向上します。現在、多くの機械学習ライブラリ(scikit-learnなど)ではk-means++がデフォルト設定となっています。
その他の主要手法
上記の三手法以外にも、目的やデータ特性に応じて選択される主要なアルゴリズムがあります。
| 手法名 | 種別 | 特徴・適した場面 |
|---|---|---|
| DBSCAN | 密度ベース | クラスタ数の指定不要。不規則な形状のクラスタや外れ値の検出に強い。ノイズを自動除外できる |
| 混合ガウスモデル(GMM) | 確率モデル | 各データ点がどのクラスタに属するかを確率で表現。楕円形クラスタにも対応 |
| スペクトラルクラスタリング | グラフベース | データ間の類似度グラフをもとに分割。非線形・複雑な形状のクラスタに有効 |
| 凝集型クラスタリング(Agglomerative) | 階層型 | 各データ点を個別クラスタとして開始し、逐次統合。Ward法・群平均法などの連結基準を選択可能 |
クラスタ数の決め方と結果の評価(エルボー法・シルエット係数)
k平均法では、分ける前にクラスタ数kを決める必要があります。目安をつける代表的な方法が2つあります。
- エルボー法:kを変えながら、各点と所属クラスタの重心との距離の二乗和(inertia、群内二乗和)を並べます。kを増やすと必ず小さくなりますが、減り方が急に鈍る「肘」の位置が候補になります。
- シルエット係数:各点について、自分のクラスタ内の平均距離と、いちばん近い別クラスタまでの平均距離を比べた値で、−1〜1の範囲を取ります。1に近いほどグループがはっきり分かれていることを示します(scikit-learn公式ドキュメント、2026年10月29日確認)。
- デービス・ボールディン指数とカリンスキー・ハラバシュ指数:正解ラベルがなくても使える内在的な評価指標です。デービス・ボールディン指数は小さいほど、カリンスキー・ハラバシュ指数は大きいほど、グループ内がまとまりグループ間が離れていることを示します(scikit-learn公式ドキュメント、2026年10月29日確認)。
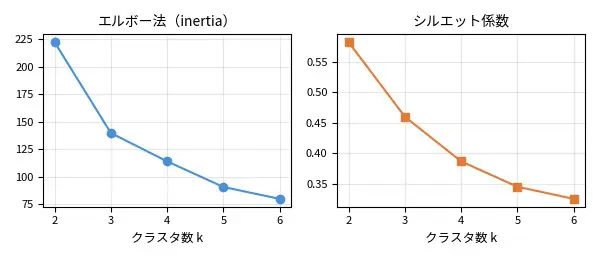
同じアイリスのデータでk=2〜6を試すと、デービス・ボールディン指数は0.593(k=2)から1.052(k=6)へ悪化し、カリンスキー・ハラバシュ指数は251.3(k=2)から187.1(k=6)へ下がります。3つの指標とも、この例ではkが小さいほど良い評価になりました。
ただし、どちらも「数学的にきれいなk」を示すだけで、業務上の正解を示すわけではありません。次章のアイリスのデータでは、シルエット係数はk=2が最高ですが、実際の品種は3種類です。点数が高いkと、意味のあるkが一致するとは限らないため、最終的には各グループの中身を見て人が決めます。
Pythonでクラスタリングを試す:scikit-learnのk平均法
実際に動かすと仕組みがつかめます。次のコードは、scikit-learnに同梱されているアイリス(あやめ)のデータを標準化し、クラスタ数を2〜6に変えてinertiaとシルエット係数を出します。
from sklearn.datasets import load_iris
from sklearn.preprocessing import StandardScaler
from sklearn.cluster import KMeans
from sklearn.metrics import silhouette_score

X = StandardScaler().fit_transform(load_iris().data)

for k in range(2, 7):
    km = KMeans(n_clusters=k, n_init=10, random_state=0).fit(X)
    print(k, round(km.inertia_, 1), round(silhouette_score(X, km.labels_), 3))
scikit-learn 1.7.2、Python 3で2026年10月29日に実行した結果は次のとおりです。
| k | inertia | シルエット係数 |
|---|---|---|
| 2 | 222.4 | 0.582 |
| 3 | 139.8 | 0.460 |
| 4 | 114.1 | 0.387 |
| 5 | 90.8 | 0.346 |
| 6 | 80.0 | 0.326 |
inertiaはkが増えるほど小さくなり、k=2から3への減り方が大きく、その後は緩やかになります。コードの n_init=10 は初期重心を変えて10回試し、最も良い結果を採用する設定、random_state=0 は結果を再現するための固定です。前の章で触れた初期値依存への対策になります。
クラスタリング精度を左右する「前処理」──スケーリングと次元の呪いへの対処
k平均法や階層クラスタリングの多くは、データ点間の距離を類似度の基準として計算します。そのため、アルゴリズムそのものより前段の「前処理」が結果を大きく左右します。手法選びの前に、以下の2点を押さえておくと失敗を避けやすくなります。
第一に、特徴量のスケール(単位)を揃える標準化です。たとえば「年収(数百万円)」と「年齢(数十)」のように桁数が大きく異なる特徴量をそのまま距離計算に用いると、値の大きい特徴量だけが距離を支配し、他の特徴量がほとんど無視されてしまいます。各特徴量を平均0・分散1に変換する標準化(z-score)や、0〜1の範囲に収める正規化を事前に行うことで、すべての特徴量を公平に扱えるようになります。
第二に、「次元の呪い」への対処です。特徴量(次元)が増えるほどデータ点同士の距離が均一化し、「近い・遠い」の差が失われて距離ベースのクラスタリングが機能しにくくなる現象を指します。特徴量が多い場合は、主成分分析(PCA)などの次元削減で情報を保ちながら次元を圧縮したり、分析目的に寄与しない特徴量を事前に取捨選択したりすることが有効です。次元削減は計算コストの抑制と、二次元・三次元での結果の可視化にも役立ちます。
「思うようにクラスタが分かれない」というトラブルの多くは、アルゴリズムの選定ミスではなく、このスケーリング不足や高次元性に起因します。手法を切り替える前に、まず前処理を見直すことが実務上の近道です。
クラスタリングの実際の活用場面
クラスタリングはマーケティング分析以外にも、現代のビジネス・研究の多様な場面で活用されています。
- 顧客セグメンテーション:購買履歴・行動データをもとに顧客を自動的にグループ化し、One to Oneマーケティングや製品レコメンドに活用
- 異常検知・不正検出:通常の取引パターンとは大きく異なるデータ点(外れ値クラスタ)を検出し、金融詐欺や機器の故障予兆を特定
- 文書・テキスト分類:ニュース記事や問い合わせ内容をクラスタリングし、トピック自動分類・FAQ整理に利用
- 画像・動画解析:類似画像のグループ化、画像を色や位置が近い領域に分ける画像セグメンテーション、医療画像における組織の自動分類など
- バイオインフォマティクス:遺伝子発現データのクラスタリングによる病型分類・薬剤応答予測
- 地理・都市分析:GPS位置データや人口統計データをクラスタリングし、商圏分析・配送ルート最適化に活用
クラスタリングの手法を導入するメリットとデメリット
クラスタリングはビジネス上の多くの問題に応用できる一方、固有の限界も存在します。導入前にメリットとデメリットの両面を正確に理解しておくことが重要です。
メリット
- 効果的なセグメンテーションが行える
- 差別化戦略や市場の空白を発見できる
- アンケート・テキストデータのパターンを抽出できる
- ラベルなしデータからも知見を得られる
セグメンテーションとは、市場に存在する顧客を年齢・購買行動・地域・嗜好などの多様な観点からグループ分けすることです。顧客をグループ化することで、自社製品を最も必要としているターゲットに的確にアプローチできるほか、グループごとの特性を新製品開発や広告戦略に活用できます。クラスタリングはこのセグメンテーションを人手ではなくデータドリブンで実現するため、主観バイアスを排除した精度の高い市場分析が可能になります。
差別化戦略・市場の空白発見においても、クラスタリングは力を発揮します。競合他社の製品をクラスタリングの対象にすることで、市場に存在する製品群の特徴や偏りが可視化され、どのポジションがまだ埋まっていないか(空白地帯)を把握しやすくなります。その空白地帯への参入は、新たな市場開拓と競合優位の確保に直結します。
アンケート・テキストデータの分析でも効果的です。市場調査や製品テストで収集した自由記述回答は一見バラバラに見えますが、クラスタリングを適用することで類似した意見・要望をグループ化でき、隠れたニーズやクレームのパターンを系統的に把握することができます。
さらに、クラスタリングは正解ラベルが存在しないデータにも適用できるという根本的な強みがあります。ラベル付けのコスト・時間が省けるため、新しいドメインへの素早い探索的分析に向いています。
デメリット
- データ量の増加に伴い計算コストが急増する(特に階層クラスタリング)
- 非階層クラスタリングはクラスタ数の設定に依存し、再現性が下がる場合がある
- 結果の解釈・評価基準が主観的になりやすい
- 外れ値・ノイズの影響を受けやすい手法がある
階層クラスタリングはデータ数が増えると計算量が爆発的に増加し、数万件以上のデータでは処理時間が現実的でなくなる場合があります。また、デンドログラムが複雑になり過ぎて結果の解釈が困難になることもあります。
非階層クラスタリング(k平均法など)では、最初にクラスタ数kを自分で決める必要があります。これを初期値依存といい、kの設定や初期値の乱数によって結果が変わるため、安定した再現性のある結果を得るには複数回の試行と検証が必要です。エルボー法(クラスタ数を変えながら誤差平方和の推移を確認する方法)やシルエット係数(クラスタ内の凝集度とクラスタ間の分離度を数値化した指標)などを活用してkを選ぶことが推奨されます。
また、クラスタリングには「正解」が存在しないため、得られたクラスタが本当に意味のある区分けかどうかは分析者の解釈に委ねられる面があります。ビジネス上の知識と組み合わせた解釈の質が最終的な分析価値を左右します。
AIの業務導入をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
AI開発での使われ方:埋め込みベクトルのグルーピング
クラスタリングは統計・マーケティング分析だけでなく、生成AIの周辺でも使われます。文章や音声を高次元の「埋め込みベクトル」に変換し、近いベクトル同士をグループにまとめる、という使い方です。考え方はk平均法や階層クラスタリングと同じで、対象が表の数値ではなく埋め込みベクトルになるだけです。
例えばRAG(検索拡張生成)では、大量の文書ベクトルを事前にクラスタリングしておくと、検索対象を絞り込んで類似文書の探索を効率化できます。問い合わせ文や自由記述アンケートを埋め込みにしてクラスタリングし、話題ごとに整理する使い方もあります。埋め込みベクトルは次元数が数百〜数千に及ぶことが多いため、前の章で触れた「次元の呪い」への対処(次元削減や距離指標の選定)が実装でも重要な検討事項になります。
このように、クラスタリングは統計分析の手法であると同時に、生成AIを支える実装上の考え方でもあります。自分のデータで「似ているもの」をどうまとめるかを考えるときは、対象が数値データなのか埋め込みベクトルなのかも踏まえて手法を選んでください。
まとめ
クラスタリングは、正解ラベルを必要としない教師なし学習の代表的手法であり、データに潜む未知のグループ構造を自動的に発見できる点が最大の特徴です。本記事の要点を整理します。
- クラスタリングは教師なし学習に属し、分類(教師あり学習)とは学習方法・目的が異なる
- 階層クラスタリングはデンドログラムで過程を可視化でき少量データに有効、非階層クラスタリングは大量データに対応しやすいがクラスタ数の決定が課題
- 代表的手法として群平均法・ウォード法(階層型)、k平均法・k-means++(非階層型)、DBSCAN(密度ベース)などがある
- マーケティングのセグメンテーション・差別化戦略・市場空白の発見から、異常検知・テキスト分析・医療分野まで幅広く活用されている
- データ量増加による計算コスト・初期値依存・結果解釈の主観性などの限界も理解した上で活用することが重要
クラスタリングは「まだ答えが見えていない問題」に対して強力な探索ツールとなります。市場調査・顧客分析・新規事業開発など、データドリブンな意思決定を進める際は、ぜひクラスタリングをファーストステップの分析手法として検討してみてください。
よくある質問
Q. クラスタリングとは何ですか?
A. 正解ラベルを与えずに、データの似ている度合い(距離)をもとに、コンピュータがデータを自動でグループ(クラスタ)に分ける機械学習の「教師なし学習」の手法です。クラスタ分析とも呼ばれます。
Q. クラスタリングと分類の違いは何ですか?
A. 分類は「迷惑メールか否か」のように人が先に正解カテゴリを用意して学習させる教師あり学習で、クラスタリングはグループの中身も数もデータから見つける教師なし学習です。正解ラベルが要るか要らないかが最大の違いです。
Q. 代表的なクラスタリング手法には何がありますか?
A. 階層型のウォード法・群平均法、非階層型のk平均法、密度ベースのDBSCAN、確率モデルの混合ガウスモデル、グラフベースのスペクトラルクラスタリングなどがあります。データ量・クラスタの形・外れ値の有無で選びます。
Q. クラスタ数はどうやって決めますか?
A. k平均法ではエルボー法(クラスタ数ごとの群内二乗和の減り方を見る)やシルエット係数で目安をつけ、最後は業務上の意味で人が判断します。DBSCANや階層クラスタリングはクラスタ数を事前に決めなくても使えます。
Q. クラスタリングの結果が思うように分かれないときは?
A. 手法を替える前に、特徴量のスケールをそろえる標準化と、次元が多い場合の次元削減(PCAなど)を見直してください。多くの場合、原因はアルゴリズムではなく前処理です。
Q. クラスタリングは何に使われますか?
A. 顧客セグメンテーション、異常検知、文書・問い合わせの話題分類、画像の類似グループ化、商圏分析などに使われます。
AIの業務活用をご検討の方へ
クリスタルメソッドは、バーチャルヒューマンをはじめAIの開発・業務導入を支援しています。生成AI・AIエージェントの活用や、自社業務へのAI導入をご検討の際は、お気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
【入門】機械学習とは?種類やアルゴリズムをわかりやすく解説!
機械学習(Machine Learning)は、AIを語るうえで欠かせない中核技術です。スマートフォンの顔認証やNetflixのレコメンド、ChatGPTの回答...
-
データマイニングとは?意味と手法から活用事例まで、わかりやすくご紹介します!
データマイニングとは、膨大なデータの中から統計学やパターン認識を駆使して、隠れた法則や相関関係を発見する手法のことです。「マイニング(mining)」は採掘を意...
-
データサイエンスとは?注目されている理由と活用事例を紹介!
「データサイエンス」という言葉はビジネス・行政・研究の現場で頻繁に使われるようになりましたが、「具体的に何をする学問なのか」「どんな事例があるのか」を正確に理解...