
blog
AIブログ
OpenCVとは?できることや特徴をわかりやすく解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
Pythonをはじめとする様々なプログラミング言語で画像処理・コンピュータビジョンを実装するとき、真っ先に名前が挙がるのがOpenCVです。正式名称は「Open Source Computer Vision Library」といい、無料で使えるオープンソースのライブラリです。ライセンスはApache 2.0で、個人でも商用でも無料で使えます(GitHub opencv/opencv)。本記事では、OpenCVの定義と早わかり、できること、モジュール構成、pipでのインストールと最小のコード、最新バージョン(5.0と4.x)とライセンスの注意点、メリット、活用例、ほかのライブラリとの違い、始める前の注意点までを順に解説します。物体検出のモデル比較や精度の測り方は、物体検出の解説に分けています。
OpenCVとは
OpenCV(オープンシーブイ)は、画像や動画を読み込み、加工・解析するためのオープンソースのライブラリです。正式名称は「Open Source Computer Vision Library」で、出発点はIntelで始まったプロジェクトで、その後Willow Garage、Itseezなどが開発に関わり、現在は非営利団体のOpen Source Vision Foundationが運営しています(公式サイト:opencv.org/anniversary、opencv.org/about)。画像のリサイズ・色の変換・ノイズ除去から、輪郭や特徴点の検出、顔などの検出、動画の解析まで、コンピュータビジョンに必要な処理がまとまっています。2026年10月時点では、5.0系(5.0.0)と4.x系(4.14.0)の両方がGitHubで公開されています。
OpenCVの早わかり
| 項目 | 内容 | 出典 |
|---|---|---|
| 正式名称 | Open Source Computer Vision Library | GitHubのREADME |
| ライセンス | Apache-2.0(Apache License 2.0) | GitHub opencv/opencv、PyPI |
| 開発の場 | GitHub(opencv/opencv)。公式サイトはopencv.org、質問はフォーラムで受け付け | GitHubのREADME |
| Pythonでの入手 | pip install opencv-python。Pythonから使うときの名前はcv2 |
PyPI |
| 最新バージョン | 5.0.0(2026年6月6日)・4.14.0(2026年7月19日)。詳しくは「最新バージョンとライセンス」の節 | GitHub Releases |
| 対応環境 | Windows・Linux・macOS・iOS・Android(公式サイトの対応プラットフォーム一覧)。インターフェイスはC++・Python・Java・JavaScript | opencv.org/platforms、5.0のドキュメント |
| 高速化 | CPUのSIMD・CUDA・OpenCL・Vulkanによる高速化(5.0のドキュメントの記述)。GPUを使う場合は、使う版のビルド条件を公式ドキュメントで確認します | 5.0のドキュメント |
出典:GitHub opencv/opencv、GitHub Releases、PyPI opencv-python(2026年10月29日確認)。
OpenCV本体はC++で書かれたライブラリで、公式ドキュメントにはC++のほか、Python・Java・JavaScript(OpenCV.js)向けの説明があります。Pythonから使う人が多く、その入り口がPyPIのopencv-pythonです。Androidや、Windows on Armなど、パソコン以外の環境向けの公式バイナリも用意されています。

ライブラリとは
プログラミングにおける「ライブラリ」とは、よく使われる機能をあらかじめプログラムしてまとめたもの、いわばソフトウェアの部品集です。画像のリサイズや物体検出といった処理を一から実装しようとすれば、数百行以上のコードと専門知識が必要になります。しかしOpenCVのようなライブラリを利用すれば、数行のコードで同じ機能を呼び出せます。開発効率を大幅に高められる点が、ライブラリ活用の最大の利点です。
また、ライブラリはコミュニティや企業によって品質管理・バグ修正・最適化が継続的に行われているため、自前実装よりも信頼性が高いことも多いです。OpenCVの場合、GitHubで活発に開発が続いており、世界中の研究者・エンジニアの知見が反映されています。
画像処理とコンピュータビジョン
画像処理とは、デジタル画像を入力としてさまざまな演算や変換を施し、目的の情報を取り出したり、別の形式に変換したりする技術です。スマートフォンのカメラにおける顔認証・自動車の衝突防止システム・医療画像の解析・工場の外観検査など、現代社会のいたるところで活用されています。
コンピュータビジョンはその発展形であり、画像や動画からシーンの意味を理解する技術を指します。ディープラーニングの発展により、パターン認識の精度は飛躍的に向上し、かつて人間にしかできなかった判断をAIやロボットが担う場面が急増しています。OpenCVはこのコンピュータビジョンの実装基盤として、学術研究から産業応用まで幅広く活用されています。
コンピュータビジョンで物体を見つけるときは、物体検出AIの仕組みと代表的なモデルで解説しています。
できること(画像処理・検出・動画解析)
OpenCVが提供する機能は非常に広範囲にわたります。以下に代表的な機能を詳しく紹介します。
| 機能カテゴリ | 代表的なメソッド・処理 | 主な用途 |
|---|---|---|
| 画像の読み込み・表示・保存 | imread / imshow / imwrite | 画像ファイルの入出力 |
| 画像編集・変換 | resize / flip / rotate / cvtColor | データ整形・オーグメンテーション |
| ノイズ除去・平滑化 | blur / GaussianBlur / medianBlur | 前処理・画質改善 |
| 物体検出 | CascadeClassifier / DNN module | 顔検出・人物検出・工業検査 |
| 類似画像検出 | matchTemplate | テンプレートマッチング |
| 輪郭・エッジ検出 | Canny / findContours | 形状認識・セグメンテーション |
| 光学フロー・動体追跡 | calcOpticalFlowPyrLK | 動画解析・監視カメラ |
画像の表示・読み込み・保存
OpenCVではimreadメソッドを使うことで、JPEG・PNG・BMPなどの形式の画像ファイルをNumPy配列として読み込めます。読み込んだ画像はカラー(BGR形式)またはモノクロを選択でき、imshowでウィンドウに表示、imwriteで別のファイルとして保存することができます。読み込みに失敗(パスの間違いなど)してもエラーにはならず、Noneが返るため、読み込んだあとにNoneかどうかを確認します(公式チュートリアル:Getting Started with Images)。imshowはウィンドウを開くため、GUIなしのopencv-python-headlessでは使えません。数行で入出力が完結するため、開発のスタート地点として取り組みやすい機能です。
画像の編集・データオーグメンテーション
機械学習モデルを学習させるには、大量の画像データが必要です。しかし実際には数万枚の写真を用意できないケースも多く、そこで活用されるのがデータオーグメンテーション(data augmentation)です。既存の画像を上下左右に反転・回転・ズームイン・色調変化させることで、実質的にデータ量を増やし、モデルの汎化性能を向上させます。
OpenCVではresize(リサイズ)・flip(反転)・rotate(回転)・cvtColor(色空間変換)などのメソッドを組み合わせることで、こうしたオーグメンテーション処理を効率的に実行できます。また、学習に不要なカラー情報を取り除いてグレースケール化することで、モデルの計算量を削減しつつ必要な特徴を抽出しやすくする前処理も、cvtColor(img, cv2.COLOR_BGR2GRAY)の一行で実現できます。
ノイズ除去・平滑化
実際に収集した画像には、カメラのセンサーノイズや照明環境によるムラなど、処理の妨げとなるノイズが含まれることが多くあります。OpenCVでは目的に応じた複数のフィルタリング手法を提供しています。
- blur(平均フィルタ):指定したカーネルサイズの範囲内のピクセルを平均化し、単純なぼかしを実現する。
- GaussianBlur(ガウシアンフィルタ):中心ほど重みを大きくしたガウス分布で平均化する。自然な平滑化に向いており、エッジをある程度保持する。
- medianBlur(メディアンフィルタ):カーネル内の中央値を採用するため、胡椒ノイズ(salt-and-pepper noise)の除去に特に有効。
適切なノイズ除去処理を前処理として加えることで、後段の物体検出や特徴抽出の精度を高められます。
物体検出・顔検出
OpenCVの中でも特に活用シーンが多い機能が物体検出です。画像はコンピュータにとってピクセルの数値配列に過ぎませんが、OpenCVでは特定の物体をバウンディングボックス(四角い検出枠)で囲む形で検出できます。
objdetectモジュールは、顔や人など、あらかじめ決められた種類の物体を検出するためのモジュールです(公式ドキュメント 4.13のモジュール一覧)。Haar特徴量ベースのCascadeClassifierが代表的な使い方で、深層学習のモデルを使う場合はDNNモジュール(cv2.dnn)で学習済みモデルを読み込んで推論します。OpenCVが担うのはモデルの学習ではなく、推論と、その前後の画像処理です。
顔検出の最小コード(YuNet)
深層学習の顔検出には、公式チュートリアル(DNN-based Face Detection And Recognition)がFaceDetectorYN(YuNet)を使っています。モデルのファイルはOpenCVのopencv_zooリポジトリ(face_detection_yunet)から入手します。
import cv2 as cv

img = cv.imread("face.jpg")
h, w = img.shape[:2]

# model_path: opencv_zooのYuNetモデル
detector = cv.FaceDetectorYN.create(model_path, "", (w, h))
_, faces = detector.detect(img)   # 顔なしならNone

if faces is not None:
    for f in faces:
        x, y, bw, bh = f[:4].astype(int)   # 左上の座標と幅・高さ
cv.rectangle(img, (x, y), (x + bw, y + bh), (0, 255, 0), 2)検出結果は顔ごとの配列で、枠の位置・顔のランドマーク・スコアが並びます(OpenCV.js版の説明では1つの顔につき15個の値)。古くからのCascadeClassifierより新しい方法ですが、どちらを選ぶかは精度と処理の軽さで決めます。
YOLO・SSD・DETRといった検出モデルの違い、精度の測り方(IoU・mAP)、自分のデータで検出AIを作る流れは、物体検出の解説で詳しく説明しています。この記事では、OpenCVで何ができるかの全体像に絞ります。
類似画像の検出(テンプレートマッチング)
テンプレートマッチングとは、「テンプレート画像」(見本)と「ターゲット画像」(検索対象)を比較し、ターゲット内でテンプレートと最も類似する位置を特定する処理です。OpenCVではmatchTemplateメソッドを使い、テンプレートをターゲット画像上で少しずつスライドさせながら類似度を計算して最適位置を見つけます。
ただし、テンプレートマッチングは回転・拡大縮小・視点変化に弱いという制約があります。傾いた状態の類似領域を検出したい場合は、特徴点マッチング(ORB・AKAZE・SIFTなどの特徴量記述子を使った手法)と組み合わせることで、より頑健な類似画像検出が可能になります。
輪郭・エッジ検出
画像中の物体の輪郭やエッジ(境界線)を検出する機能も、OpenCVの重要な役割の一つです。Cannyエッジ検出(Cannyメソッド)は、ノイズ除去→勾配計算→非最大値抑制→ヒステリシス閾値処理という4段階のパイプラインで高精度なエッジを抽出します。findContoursメソッドと組み合わせれば、検出したエッジから物体の輪郭を取得し、面積・重心・バウンディングボックスなどの形状特徴量を計算することができます。工場の外観検査や文字認識(OCRの前処理)にも広く応用されています。
動画解析・光学フロー
OpenCVは静止画だけでなく、動画(ビデオストリーム)の処理にも対応しています。VideoCaptureでカメラや動画ファイルからフレームを取得し、フレームごとに画像処理を適用することで、リアルタイムの物体追跡や動体検知が実現できます。光学フロー(calcOpticalFlowPyrLKなど)を使えば、フレーム間の物体の動きベクトルを計算でき、動きの解析に使えます。動きの推定や背景差分、追跡は、公式ドキュメントでvideoモジュールとして分類されています。
カメラ映像を取り込む最小コード
公式チュートリアル(Getting Started with Videos)の流れに沿った例です。0は標準のカメラを指し、qキーで終了します。
import cv2 as cv

cap = cv.VideoCapture(0)
if not cap.isOpened():
    raise SystemExit("カメラを開けません")

while True:
    ok, frame = cap.read()
    if not ok:
        break
    gray = cv.cvtColor(frame, cv.COLOR_BGR2GRAY)
    cv.imshow("frame", gray)
    if cv.waitKey(1) == ord("q"):
        break

cap.release()
cv.destroyAllWindows()フレームに枠や文字を描くときは、rectangleやputTextなどの描画関数を使います(顔検出の例のrectangleと同じ使い方です)。

AIの業務導入をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
次に読む:画像分類AIの仕組みと比較は?
主なモジュール構成
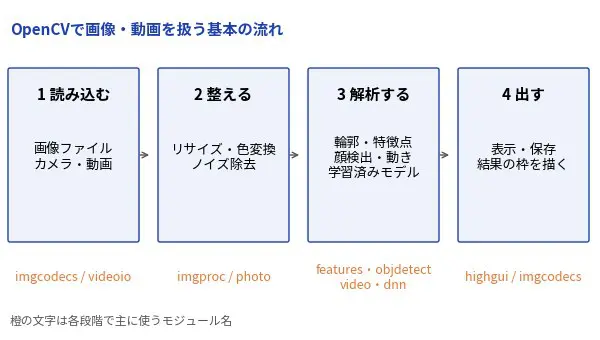
OpenCVは機能ごとに「モジュール」に分かれています。画像を読み込み、整え、解析し、結果を出すという流れで見ると、どのモジュールを使うか整理しやすくなります。
| モジュール | 役割 | バージョンによる違い |
|---|---|---|
| core | 基本のデータ構造(多次元配列のMatなど) | 4.x・5.0とも |
| imgproc | フィルタ・拡大縮小などの図形変換・色の変換・ヒストグラム | 4.x・5.0とも |
| imgcodecs | 画像ファイルの読み書き | 4.x・5.0とも |
| videoio | カメラや動画ファイルの取り込み・書き出し | 4.x・5.0とも |
| highgui | 簡単なウィンドウ表示などのGUI | 4.x・5.0とも |
| video | 動きの推定・背景差分・追跡 | 4.x・5.0とも |
| features2d/features | 特徴点の検出・記述・照合 | 4.xはfeatures2d、5.0はfeatures(学習ベースの検出器・照合器が加わり、SIFTやORBなど定番の検出器は残る) |
| objdetect | 顔や人など、決まった種類の物体の検出 | 4.x・5.0とも |
| dnn | 深層学習モデルの推論(学習ではなく、学習済みモデルを動かす) | 5.0でエンジンが新しくなり、ONNXへの対応範囲が広がった |
| photo | ノイズ除去・欠損部分の補完などの写真処理 | 4.x・5.0とも |
| stitching | 複数の画像をつなぐパノラマ合成 | 4.x・5.0とも |
| calib3d/calib・geometry・stereo・ptcloud | カメラの校正、複数視点の幾何、姿勢推定など | 4.xはcalib3dの1つ、5.0では4つに分割 |
| ml | 分類・回帰・クラスタリング | 4.xの一覧にある。5.0の主要モジュール一覧には見当たらない |
出典:OpenCV 4.13 モジュール一覧、OpenCV 5.0 Main modules、OpenCV 5の紹介(opencv.org)(2026年10月29日確認)。
インストール方法と最小のコード
Pythonでは、pipでパッケージを1つ入れるだけで使い始められます。入れるパッケージは、使う環境に合わせて4種類から選びます(PyPI opencv-python)。
| パッケージ | コマンド | 向いている環境 |
|---|---|---|
| opencv-python | pip install opencv-python |
パソコンで使う標準版。主要モジュールを含む |
| opencv-contrib-python | pip install opencv-contrib-python |
標準版に加えて、contrib(追加)モジュールも使いたいとき |
| opencv-python-headless | pip install opencv-python-headless |
サーバーやDockerなど画面のない環境。GUIを含まないため軽い |
| opencv-contrib-python-headless | pip install opencv-contrib-python-headless |
画面のない環境で、contribモジュールも使いたいとき |
macOSでHomebrewを使う場合
macOSでは、パッケージ管理ツールのHomebrewでbrew install opencvとすると、OpenCV本体を入れられます。Homebrewのformulaページ(formulae.brew.sh/formula/opencv)では、安定版が5.0.0、ライセンスがApache-2.0と表示されています(2026年10月29日確認)。pipのパッケージとは配布元が別なので、Pythonから使うときは、どちらの経路で入れたかを確認します。
4つとも読み込み名は同じcv2で、同じ環境に複数入れると競合するため、どれか1つだけ入れます。PyPIの記載では、ビルド済みパッケージはPython 3.6以上(3.14まで)に対応しています(2026年10月29日確認)。
入れたら、画像を1枚読み込んで、グレースケール化・ぼかし・エッジ検出をして保存する最小のコードで動作を確かめます。公式チュートリアルと同じくimport cv2 as cvで読み込みます。
import cv2 as cv

img = cv.imread("sample.jpg")        # 読み込み(BGR順)
if img is None:
    raise SystemExit("画像を読み込めませんでした")

gray = cv.cvtColor(img, cv.COLOR_BGR2GRAY)   # グレースケール
blur = cv.GaussianBlur(gray, (5, 5), 0)      # ぼかし
edges = cv.Canny(blur, 100, 200)             # エッジ検出
cv.imwrite("edges.png", edges)               # 保存
実際に上のコードを動かした結果です(OpenCV 4.13.0、2026年10月29日に実行)。左から、元の画像・グレースケール化・Cannyでエッジだけを取り出した画像です。
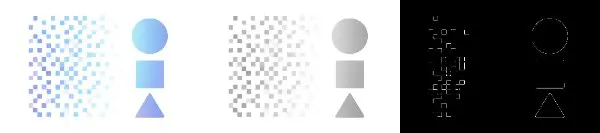
画像はBGR(青・緑・赤)の順に読み込まれます(公式チュートリアル:Getting Started with Images)。MatplotlibなどRGB前提のライブラリへ渡すときは、cv.cvtColor(img, cv.COLOR_BGR2RGB)で変換します。
最新バージョン(5.0と4.x)とライセンス
OpenCVは、2026年10月時点で5.0系と4.x系の2つが並行して公開されています。日付は、GitHub ReleasesとPyPIの公開ページに表示されたものです(2026年10月29日確認)。
| 系統 | GitHubのリリース | PyPI opencv-python | 主な特徴 |
|---|---|---|---|
| 5.0系 | 5.0.0(2026年6月6日) | 5.0.0.93(2026年7月2日) | C++17が最低条件。Python 2は非対応(Python 3.6以上)。旧C APIを削除。DNNエンジンを刷新。calib3dを分割 |
| 4.x系 | 4.14.0(2026年7月19日) | 4.14.0.94(2026年7月29日) | これまで広く使われてきた系統。4.13.0は2025年12月31日公開 |
5.0の変更点は、OpenCV公式の紹介と5.0のドキュメントに基づきます(OpenCV 5の紹介、docs.opencv.org/5.0)。4.xから5.xへの移行ガイドもドキュメントにあります(Transition guide)。
ライセンスと同梱されるもの
OpenCV本体はApache-2.0ライセンスです(GitHub)。一方、pipで入れるopencv-pythonは、本体とは別に同梱物があるため、PyPIの記載を整理します。
| 対象 | ライセンス | 出典 |
|---|---|---|
| OpenCV本体 | Apache-2.0 | GitHub opencv/opencv、PyPI |
| opencv-pythonのパッケージ化のスクリプト | MIT | PyPI(opencv-python) |
| すべてのビルド済みパッケージに含まれるFFmpeg | LGPLv2.1 | PyPI(opencv-python) |
| GUI付きLinux向けパッケージに含まれるQt 5 | LGPLv3 | PyPI(opencv-python) |
商用の製品や配布物にOpenCVを組み込むときは、本体のライセンスだけでなく、同梱される部品のライセンス条件も確認してください。なお、2.4.10など古い版のドキュメントには「BSDライセンス」と書かれており、今のApache-2.0とは異なります。古い解説記事を読むときは版に注意します。
メリット
無料で利用できる上に、画像処理・機械学習の両方をカバーするOpenCVには、実務・学習の両面で優れたメリットがあります。主なポイントを整理します。
初心者でも導入・使用が簡単
Pythonではpip install opencv-pythonの一行でインストールが完了します。環境構築の手間が少なく、インストール直後からサンプルコードを動かすことができます。また、主要なメソッド(imread・imshow・resizeなど)の命名規則が直感的であり、公式ドキュメントやコミュニティの情報も豊富です。初心者がつまずきやすいポイントについても、日本語を含む多数のチュートリアルが公開されています。
機械学習の準備作業(前処理)を効率化できる
機械学習モデルに画像を入力するには、そのまま使うことはできません。グレースケール化・リサイズ・正規化・ノイズ除去・輪郭強調など、多くの前処理が必要です。OpenCVはこれらの前処理をシンプルなAPIで一括して実行できるため、データパイプラインの構築が大幅に効率化されます。
たとえば閾値処理(threshold)で二値化すれば輪郭が明確になり、GaussianBlurでノイズを取り除けば後段のモデルが誤った特徴を学習するリスクを減らせます。こうした前処理工程を丁寧に設計することが、モデルの精度向上に直結します。
ARやVRの開発にも活用できる
カメラ映像を使うアプリでも、OpenCVは映像の取り込みと前処理の部分で使えます。VideoCaptureでフレームを取り込み、特徴点の検出や追跡といった処理にかけ、その結果を表示や次の処理に渡す、という使い方です。ARのようにカメラ映像と位置合わせが必要なコンテンツでも、この入口の処理を担えます。
NumPyやTensorFlowなど他ライブラリと組み合わせられる
OpenCVはPythonのNumPy配列(ndarray)を基本データ形式として使用します。そのため、NumPy・SciPy・scikit-image・TensorFlow・PyTorchといった科学計算・機械学習ライブラリとシームレスに連携できます。OpenCVで読み込んだ画像をそのままTensorFlowの入力テンソルに変換したり、PyTorchで推論した結果をOpenCVで可視化したりといった組み合わせは、実務では標準的なワークフローです。
商用利用を含め完全無料で使える(Apache 2.0ライセンス)
OpenCVはApache 2.0ライセンスで提供されており、個人利用・商用利用を問わず無料で使えます。ライセンス料が不要なため、スタートアップから大企業まで、コスト面の障壁なく導入できる点は大きな強みです。ただし、pipで入るパッケージには別のライセンスの部品(FFmpegなど)が同梱されます。詳しくは「最新バージョンとライセンス」の節で整理しています。
活用事例(分野別)
OpenCVは、車・医療・工場・店舗・農業など、カメラ映像や画像を扱う場面で使われます。公式ブログが挙げている分野を表にまとめます。
| 分野 | 使われ方の例(公式ブログ) | 関係するモジュール(目安) |
|---|---|---|
| 自動車 | 車線検出・歩行者の認識・衝突回避などの運転支援 | imgproc(エッジ・輪郭)、objdetect、dnn |
| 医療 | 医療画像の解析、腫瘍や異常の検出支援 | imgproc、dnn |
| 製造 | 品質管理、検査の自動化 | imgproc、features、objdetect |
| 小売 | 来店客の動線や人気商品の把握、盗難検知、家具を自宅に置いた様子をARで確認 | objdetect、video、dnn |
| 農業 | ドローン画像による作物の状態の解析 | imgproc、dnn |
使われ方の例は、OpenCV公式ブログ「From Healthcare to Automotive: Exploring OpenCV Applications」の記述に基づきます(2026年10月29日確認)。公式の紹介記事であり、特定の企業の導入実績や効果の数値を示すものではありません。「関係するモジュール」は、各モジュールの役割(上の表)から整理した目安です。
Pillow・scikit-image・PyTorchとの違い(使い分けの指針)
「opencvとは何か」を理解するうえで見落とされがちなのが、OpenCVはあくまで画像処理・コンピュータビジョンの実装ライブラリであり、ディープラーニングそのものを学習・訓練するためのフレームワークではないという位置づけです。PythonにはOpenCV以外にも画像を扱うライブラリが複数あり、役割が異なります。目的に応じて使い分ける、あるいは組み合わせて使うことで開発効率が大きく変わります。
| ライブラリ | 主な役割 | OpenCVとの違い・使い分け |
|---|---|---|
| OpenCV | 画像・動画の読み込み、幾何変換、フィルタリング、特徴抽出、物体検出、リアルタイム映像処理 | 古典的な画像処理から学習済みモデルの推論(DNNモジュール)まで幅広くカバーする総合ライブラリ。動画・カメラ入力の扱いに強い。 |
| Pillow(PIL) | 画像の開閉・保存・簡単な編集 | 軽量で扱いやすい反面、動体追跡や特徴点検出といった高度なコンピュータビジョン処理は持たない。単純な入出力・サムネイル生成向き。 |
| scikit-image | 研究・分析向けの画像処理アルゴリズム | NumPyベースで科学計算と親和性が高いが、リアルタイム動画処理や豊富な物体検出機能ではOpenCVに分がある。 |
| PyTorch / TensorFlow | ディープラーニングモデルの学習・推論 | モデルの訓練そのものを担うフレームワーク。OpenCVは前処理(リサイズ・グレースケール化)や推論結果の可視化を担当し、これらと組み合わせて使うのが実務の定番。 |
整理すると、「画像を素早く入出力したいだけならPillow、研究用途で分析アルゴリズムを試すならscikit-image、モデルを学習させるならPyTorch/TensorFlow、そして映像処理を含む実装全般とそれらの橋渡しならOpenCV」という棲み分けになります。OpenCVは単独でも強力ですが、真価を発揮するのはこれらのライブラリと連携させて一連のパイプラインを組んだときです。「どのライブラリを学ぶべきか」で迷ったら、まずは適用範囲が最も広く情報量も多いOpenCVから触れておくと、後段のディープラーニングへの橋渡しがスムーズになります。
始める前の注意点と弱点
OpenCVを実際に使い始める上で知っておくと役立つ点をいくつか挙げます。
- 色空間はBGR形式:OpenCVで読み込んだ画像はRGBではなくBGR(青・緑・赤)の順に格納されます。Matplotlibで表示する際など、他のライブラリと連携するときは
cvtColor(img, cv2.COLOR_BGR2RGB)で変換が必要です。 - パッケージは1種類だけ入れる:
opencv-python・opencv-contrib-python・各headless版は、同じ環境に複数入れると競合します。どれも同じcv2の名前で読み込むため、入れ替えるときは先に入っているものを消します(PyPI)。 - バージョンの違い:5.0ではPython 2が非対応でPython 3.6以上が必須になり、旧C APIが削除され、calib3dが分割されました(OpenCV 5の紹介、5.0のドキュメント)。古い解説記事のコードは、動かすバージョンを確認してから使います。TensorFlowやPyTorchと組み合わせる場合は、それぞれが対応するPythonのバージョンも確認します。
- 学習は別のフレームワークで:OpenCVのDNNモジュールは学習済みモデルを動かす(推論)ためのもので、モデルの学習にはPyTorchやTensorFlowなどを使います。
- GUI付きは重い:サーバーやDockerではGUIを含まないheadless版のほうが軽く、
imshowは使えません(PyPIの説明)。 - リアルタイム処理の負荷:動画のリアルタイム処理は計算負荷が大きくなります。解像度やフレームレートを下げる、処理するフレームを間引くといった工夫が必要になる場合があります。
次に学ぶこと
OpenCVの全体像がつかめたら、目的に合わせて次の記事と公式チュートリアルに進みます。
| 知りたいこと | 読むページ | この記事との分担 |
|---|---|---|
| 物体検出のモデル(YOLO・SSD・DETR)と精度の測り方 | 物体検出とは | この記事はOpenCVの紹介まで。検出モデルの比較・IoU・mAP・作る流れは物体検出の解説で説明 |
| 画像分類(画像全体に1つのラベルを付ける) | 画像分類の解説 | OpenCVは前処理や表示で使う側 |
| 画素単位の領域分割 | セマンティックセグメンテーションの解説 | 輪郭の検出(Canny・findContours)とは目的が異なる |
| 画像認識AIの全体像 | 画像認識AIの解説 | OpenCVは実装の道具のひとつ |
| 手を動かして学ぶ | 公式チュートリアル:5.0・4.13 | 画像の読み込み、画像処理、動画の扱いなどが順に学べる |
公式チュートリアルは2026年10月29日確認時点の公開ページです。
よくある質問
Q. OpenCVとは何ですか?
OpenCV(Open Source Computer Vision Library)は、画像や動画を読み込み、加工・解析するためのオープンソースのライブラリです。Intelが公開したライブラリが出発点で、現在はGitHubで公開されています。Pythonからはopencv-pythonをインストールして、cv2という名前で使います。
Q. OpenCVは無料ですか?商用利用できますか?
OpenCV本体はApache-2.0ライセンスで公開されており、無料で使えます。ただし、pipで入るopencv-pythonのパッケージには、LGPLv2.1のFFmpegなど、別のライセンスの部品が同梱されています。商用の製品に組み込むときは、同梱物のライセンスも確認してください。
Q. OpenCVで何ができますか?
画像の読み込み・保存、リサイズや色の変換、ノイズ除去、輪郭やエッジの検出、特徴点の検出、顔など決まった種類の物体の検出、動画の解析、学習済みの深層学習モデルによる推論ができます。
Q. OpenCVとopencv-pythonは何が違いますか?
OpenCVはライブラリ本体の名前で、opencv-pythonはPythonから使うためにビルド済みの形で配布されているパッケージの名前です。インストール後は、どちらもPythonでは「import cv2」で読み込みます。
Q. opencv-pythonとopencv-contrib-pythonの違いは何ですか?
opencv-pythonは主要モジュールだけの標準版で、opencv-contrib-pythonはそれに追加のモジュール(contrib/extra)を加えた版です。どちらにもGUIなしのheadless版があり、サーバーやDockerでは軽いheadless版が向いています。同じ環境にはどれか1つだけ入れます。
Q. OpenCV 5と4.xはどちらを使えばよいですか?
2026年10月時点で、GitHubには5.0.0と4.14.0が、PyPIのopencv-pythonには5.0.0.93と4.14.0.94が公開されています。5.0ではPython 2が非対応になり、旧C APIが削除されるなどの変更があるため、既存のコードや使うライブラリが5.0に対応しているかを確認して選びます。公式に4.xから5.xへの移行ガイドがあります。
Q. 読み込んだ画像が表示されない、色がおかしいのはなぜですか?
ファイルのパスが間違っていると、imreadはエラーを出さずNoneを返すため、Noneかどうかを確認してください。色がおかしいときは、OpenCVがBGRの順で画像を扱うためです。MatplotlibなどRGBを前提にするライブラリに渡すときは、cvtColorでBGRからRGBに変換します。
まとめ
OpenCVは、画像や動画を読み込み、加工・解析するためのオープンソースのコンピュータビジョン向けライブラリです。Apache-2.0ライセンスで無料で使え、Pythonではpip install opencv-pythonで入ります。2026年10月時点では5.0系と4.x系の両方が公開されており、使うバージョンは既存のコードや連携するライブラリの対応で決めます。
できることは、画像の入出力・リサイズ・色変換・ノイズ除去、輪郭や特徴点の検出、決まった種類の物体の検出、動画の解析、学習済みモデルの推論まで幅広くあります。まずは数行のコードで画像を読み込み、グレースケール化して保存するところから試してください。検出モデルの選び方と精度の測り方は物体検出の解説へ進んでください。
AIの業務活用をご検討の方へ
クリスタルメソッドは、バーチャルヒューマンをはじめAIの開発・業務導入を支援しています。生成AI・AIエージェントの活用や、自社業務へのAI導入をご検討の際は、お気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
物体検出AIとは|仕組みと代表的なモデル比較【2026年最新版】をわかりやすく解説
画像の中に写っている物が「何か」「どこにあるか」「いくつあるか」を自動で判別するAI技術が物体検出(Object Detection)です。スマートフォンのカメ...
-
画像分類とは?AIモデルの仕組み・比較・活用シーンを解説
「画像認識AI」や「ディープラーニング」という言葉は広く知られるようになりましたが、実際にどのような仕組みで画像を分類しているのか、詳しく理解している方はまだ多...
-
セマンティックセグメンテーションとは?仕組みと活用をわかりやすく解説【2026年版】
セマンティックセグメンテーション(Semantic Segmentation)は、画像内のすべてのピクセルをクラスラベルに分類するコンピュータビジョン技術です。...