
blog
AIブログ
音声合成とは?仕組み・種類・活用例をわかりやすく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
音声合成AIは、テキストを自然な音声に変換するだけでなく、声質変換・ノイズ抑制・感情表現など、幅広い音声処理を実現する技術です。近年の深層学習の進化により、かつての「機械音」から人間と区別がつかないほど自然な合成音声が実用化されており、医療・福祉・コンテンツ制作・カスタマーサポートなど、あらゆる産業での活用が加速しています。本記事では、音声合成AIの仕組みから活用事例、そしてクリスタルメソッドでの実装経験まで、体系的に解説します。
AI音声とは(全体像・種類) では、AI音声の全体像と種類をまとめています。
音声合成の基礎知識と業務での活用シーンは、音声合成とは(活用ガイド)もあわせてご覧ください。この記事では、音声合成とは何か、どんな仕組みで自然な声が作られるのか、どこで使われているのかを順に説明します。
AI音声合成の仕組み|TTSの基礎
音声合成(Text-to-Speech / TTS)とは、文字テキストを入力として受け取り、コンピュータが人間らしい音声を生成して出力する技術です。単純にテキストを読み上げるだけでなく、ピッチ(音の高さ)・話速・イントネーション・声質を細かく制御できる点が特徴です。
音声合成の歴史は1800年代以前にまでさかのぼります。当時の研究者たちは、人間の声道・唇・舌などの発声器官を物理的に模した機械装置を作ることで、人間に近い音声を生成しようとしていました。その後、コンピュータの登場と計算能力の向上により、統計的手法が取り入れられ、音声合成へのアプローチは劇的に変化しました。
1990年代以降に音声合成が実用化され始めた頃から広く研究・利用されてきたのが、隠れマルコフモデル(HMM:Hidden Markov Model)を用いた音声合成システムです。HMMは音声の時系列的な特性を確率モデルで表現することに優れており、比較的少ないデータ量で安定した合成音声を生成できることから、長年にわたって音声合成の主流技術として君臨しました。
しかし2010年代以降、HMMに代わってディープニューラルネットワーク(DNN)を用いた深層学習ベースの手法が急速に台頭しました。深層学習による音声合成は、HMMでは難しかった細やかな感情表現・話者の個性の再現・複雑なイントネーションパターンの習得を可能にし、音声合成の品質を飛躍的に向上させました。2016年にGoogleが発表したWaveNetを転機に、深層学習による音声合成は各社のクラウドサービスや読み上げソフトに広く使われるようになり、音声合成は新たな成熟期に突入しています。
音声合成の主な方式
音声合成の方式は、大きく3つの世代に分けられます。いま使われている読み上げサービスの多くは、3つ目のニューラル方式です。
| 方式 | 仕組み | 特徴 |
|---|---|---|
| 波形接続型 | 録音した人の声を短い単位に切り分けて保存し、つなぎ合わせて文を作る | 録音した声そのものなので音質はよいが、つなぎ目が不自然になりやすく、大量の録音が必要 |
| 統計的パラメトリック型(HMMなど) | 声の高さや音色の特徴を統計モデルで学習し、その特徴から音声を作る | 少ないデータで安定して動き、声の調整もしやすいが、こもった機械的な音になりやすい |
| ニューラル型(深層学習) | 大量の音声と文章の組からニューラルネットワークが学習し、音声を生成する | 人の声に近い自然さ。感情や話し方の表現、少ない音声からの声の再現もできる |
スマートフォンで音声を読み上げるアプリは、iPhone・Android別の読み上げアプリ比較で解説しています。
音声合成AIを支えるニューラルネットワークの進化
音声合成AIの性能向上の背景には、ニューラルネットワーク技術の段階的な発展があります。各技術がどのような課題に対応して生まれたかを理解することが、音声合成AIの仕組みを把握する上で重要です。
画像認識から転用
空間的特徴の抽出
時系列処理を追加
経時変化を学習
勾配消失を解決
長期依存を保持
並列処理・注意機構
現在の主流
CNN(畳み込みニューラルネットワーク)
人間の脳構造を模したニューラルネットワーク(NN)を発展させたCNN(Convolutional Neural Network)は、もともと画像認識の分野で大きな成果を上げたネットワークです。フィルタリングによって空間的な特徴を効率的に抽出できることから、音声認識への応用も試みられました。ただし、CNNは時間的に静止した画像データの処理に強みを持つ構造であったため、時間軸を持つ音声データの経時的な変化を十分に捉えることが難しいという課題がありました。
RNN(再帰型ニューラルネットワーク)
この課題を解決するために生まれたのがRNN(Recurrent Neural Network)です。RNNでは、ある時刻での音声波形を学習する際に、直前の時刻の学習で得られたパラメータを隠れ層への入力として利用する仕組みが導入されました。これにより音声データの連続的な変化をひとまとまりとして捉え、より文脈に沿った意味のある学習が可能になりました。
LSTM(Long Short-Term Memory)
しかしRNNにも問題が生じました。長い音声データを学習しようとすると、時間が経つにつれて勾配が消失・爆発し、過去の情報が正しく伝わらなくなる「勾配消失問題」と計算量の爆発的増大です。これを解決するために開発されたのがLSTM(Long Short-Term Memory)です。LSTMはゲート機構により、重要な情報を長期間保持しつつ不要な情報を選択的に忘れることができます。クリスタルメソッドの音声合成AIにも、このLSTMをベースとしたネットワークが組み込まれています。
Transformer・最新アーキテクチャ
2020年以降は、自然言語処理分野で革新をもたらしたTransformerアーキテクチャが音声合成にも積極的に導入されています。注意機構(Attention Mechanism)により、文章全体の文脈を並列で処理できるため、長文でも自然なイントネーションが維持されます。FastSpeech・VITS・Voicebox(Meta)などのモデルはTransformerベースで開発されており、リアルタイム性・音質・多言語対応の三拍子を高い水準で実現しています。
次に読む:日本語特化の音声合成はSakuraSpeech?
 SakuraSpeech(サクラスピーチ)|日本語特化のAI音声合成 – ブラウザ・API・完全オフライン対応【2026年版】
音声解析に重要なメルスペクトログラム
音声合成AIがテキストから音声を生成する際、内部では音を数値データとして扱うための変換処理が行われています。その中核となるのがメルスペクトログラムです。
音は空気中を伝わる波の重なりで構成されています。コンピュータでは音声ファイルを周波数の異なる波形の集合として表現します。この波形データをそのままニューラルネットワークに学習させるのは非効率であるため、人間の聴覚特性に合わせた対数スケール(メルスケール)で周波数を変換し、時間・周波数・音の大きさを二次元の画像的表現に落とし込んだものがメルスペクトログラムです。
- 横軸:時間の経過
- 縦軸:周波数(低音〜高音)
- 色の濃淡:音の大きさ(振幅)。黒に近いほど小さく、白に近いほど大きい
深層学習では、音声ファイルをメルスペクトログラムへと変換した上で、テキストデータとの対応関係を学習させます。これにより、テキストを入力するとメルスペクトログラムが生成され、それをVocoderと呼ばれる音声生成器で実際の音声波形に変換するというパイプラインが構築されます。このパイプライン全体が「音声合成エンジン」として機能しています。
なお、近年はテキストから音声波形までを1つのモデルでまとめて学習する、エンドツーエンドのモデル(VITSなど)も普及しています。中間の表現を人が設計しないぶん、より自然な音声を得やすいとされています。
声質変換とは?AI音声合成の応用技術
音声合成AIの重要な応用技術のひとつが声質変換(Voice Conversion)です。これは、特定の人物の音声データを学習させることで、入力された別の人物の声をその人物の声に変換する技術です。わかりやすく言えば「AIが作る高精度なボイスチェンジャー」ですが、単なるピッチ変換とは異なり、声の質感・癖・話し方のニュアンスまで再現できる点が大きな特徴です。
従来の声質変換技術では、入力音声と出力音声を対応付けるために大量の音声データペアが必要でした。しかし、深層学習を活用することで必要なデータ量が大幅に削減され、限られた音声サンプルからでも高品質なモデルを構築できるようになりました。
クリスタルメソッドでは、ハスキーな女性の声をプレーンな声に変換する声質変換AIを実際に開発・実証しています。入力音声のピッチ成分・スペクトル包絡・非周期成分をそれぞれ独立して変換することで、音声の自然さを保ちながら声質を別の人物のものに近づけることが可能です。
声質変換技術が注目される応用領域としては、以下のようなものがあります。
- 失われた声の復元:事故や病気で声を失った方の過去の音声データから、その人固有の声質を再現するリハビリ・福祉支援
- コンテンツ制作:声優・ナレーターの声を素材として多言語吹き替えや複数キャラクターへの展開
- 思い出の保存:故人の声を学習させ、家族が対話できる形で記録・保存する取り組み
- プライバシー保護:オンライン会議などで身元を隠すための匿名化音声変換
なお、声質変換技術はその性質上、倫理的・法的な問題とも表裏一体です。他者の声を無断で複製・悪用するディープフェイク音声の問題は社会的な議論を呼んでおり、クリスタルメソッドでもバーチャルヒューマン・ディープフェイク関連技術の開発において、利用目的の明確化・当事者の同意取得・ウォーターマーク埋め込みなどの倫理的対策を実装する方針をとっています。
ノイズ抑制:音声合成AIによる音質改善
音声合成AIのもうひとつの重要な活用例がノイズ抑制(ノイズキャンセレーション)です。これは、雑音が混入した低品質な音声から目的の音声成分だけを抽出・強調し、クリアな音声を生成する技術です。
従来のノイズ抑制は、特定の周波数帯域のノイズを機械的に除去するフィルタ方式が主流でしたが、環境音・空調音・車両音など多種多様なノイズに対応するのが難しく、過剰に除去すると肝心の音声品質まで劣化するという問題がありました。
深層学習ベースのノイズ抑制では、クリーンな音声とノイズが混入した音声のペアデータを大量に学習させることで、ノイズと音声を精度高く識別し分離できるモデルを構築します。クリスタルメソッドの実装では、ノイズが混じった低品質な音声を入力とし、フィルタリング処理を通じて高品質なクリア音声を出力することに成功しています。
ノイズ抑制AIの主な活用シーンには以下があります。
- オンライン会議・テレワーク:キーボード入力音・環境音・エコーをリアルタイムで除去し、クリアなコミュニケーションを実現
- 音声認識の精度向上:音声認識エンジンに入力する前段階でノイズを除去し、誤認識率を低減
- 医療現場:聴診器の録音データや音声記録から環境ノイズを除去し、診断精度を向上
- メディア・放送:屋外収録音声・歴史的音声資料の修復・リマスタリング
- 製造業の異音検知:設備から発生する異常音をノイズ混じりの環境から抽出し、故障予兆を早期発見
音声合成の業務導入や自社サービスへの組み込みをご検討の方は、日本語特化AI音声合成「SakuraSpeech」を開発するクリスタルメソッドの無料相談をご利用ください。
音声合成AIの主な活用場面
音声合成AIは、すでに日常のさまざまな場面に組み込まれており、さらに活用領域は拡大し続けています。
| 活用領域 | 具体的な用途 | 音声合成が解決する課題 |
|---|---|---|
| カスタマーサポート | AIコールセンター・自動応答 | 24時間対応・人件費削減 |
| カーナビ・IoT | 道案内・スマートスピーカー | 自然な音声指示で操作性向上 |
| 医療・福祉 | 読み上げアプリ・コミュニケーション支援 | 視覚障害・失語症者のアクセシビリティ向上 |
| 教育・eラーニング | テキスト読み上げ・語学学習 | 大量コンテンツの音声化コスト削減 |
| コンテンツ制作 | 動画ナレーション・ゲームキャラ音声 | 収録コスト・スケジュール制約の解消 |
| バーチャルヒューマン | AI接客・デジタルヒューマン | 自然な対話体験・ブランド統一 |
クリスタルメソッドが開発・運用するバーチャルヒューマン技術においても、音声合成は中核技術のひとつです。映像・表情・ジェスチャーとの統合において、「声の自然さ」が視聴者の没入感を左右する最重要要素であると、実制作の経験から確認しています。「機械音っぽさ」が残ると、視覚的なリアリティをいくら高めても違和感が生じる「不気味の谷」現象が音声にも起こるため、イントネーション・ポーズ(間)・感情の乗り方まで細かく制御できる高精度な音声合成エンジンが求められます。
病院・医療現場での音声合成
日本では少子高齢化が進み、医療・福祉の現場では人手不足が大きな課題になっています。需要が増える一方で、担い手の確保が追いついていません。
一人の医師や看護師が抱える業務が増えると、確認や説明にかけられる時間が減り、ミスのリスクも高まります。案内や記録のような定型的な業務を機械に任せ、人は患者と向き合う時間を確保する、という考え方が広がっています。
この課題に対してAI・音声合成技術は具体的な解決策を提供します。
- 医療事務の自動化:受付案内・診察室への呼び出し・会計案内などのルーティンアナウンスを音声合成AIが担うことで、スタッフは対人ケアに集中できる
- 電子カルテの音声入力支援:医師の発話をリアルタイムでテキスト変換し、カルテ入力の負担を軽減
- 患者コミュニケーション:服薬指導・退院指導の音声合成による個別対応で、看護師の説明負荷を軽減しながら患者理解度を向上
- リハビリ支援:失語症や声帯障害を持つ患者が、残存する声の特徴から個人音声モデルを構築し、コミュニケーションを補助
クリスタルメソッドでは対話型AI「DeepAICopy」などの開発を通じて、病院・医療機関での自然な音声コミュニケーション実現に取り組んでいます。現在は実在する人間の声や容姿・仕草を深層学習で取り込むアプローチを採用していますが、将来的には音声と脳波を連携させるBMI(Brain-Machine Interface)的アプローチも視野に入れ、より自然なコミュニケーションの確立を目指しています。
音声生成AIとは?無料で使えるツールはある?
音声生成AIとは、テキストを自然な音声に変換したり、既存の音声の声質を別の声に変換したりする技術の総称です。無料で試せるサービスも複数公開されており、代表例として音読さんやVOICEVOXのようなテキスト読み上げ・歌声合成ツールがあります。以下では、実際に確認できた範囲でその特徴を解説します。
無料で使える音声生成AIツールの特徴
音声合成AIの技術的な仕組みを理解したうえで、実際に手軽に音声を生成できる無料ツールを知っておくと活用の幅が広がります。ここでは代表的な2つのサービスを、TTS(Text-to-Speech)の仕組みの観点も交えて紹介します。
| サービス名 | 概要 | 主な特徴 |
|---|---|---|
| 音読さん | テキスト読み上げ(TTS)ツール | 登録なしで1,000文字、無料登録で5,000文字まで読み上げ可能。多言語に対応し、生成した音声はMP3としてダウンロードできる(公式サイト・2026年10月12日確認)。 |
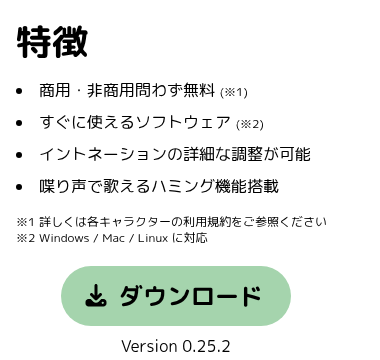
| VOICEVOX | テキスト読み上げ・歌声合成ソフト | 無料で使えるテキスト読み上げ・歌声合成ソフト。Windows / Mac / Linuxに対応したダウンロード型で、多数のキャラクターボイスを収録し、商用・非商用を問わず利用できる。利用規約はキャラクターごとに異なるため要確認で、VOICEVOXを利用したことが分かるクレジット表記が必要(公式サイト・利用規約、2026年10月12日確認)。 |
音読さんで読み上げる手順(登録なしで試せます)
音読さんはブラウザだけで使えます。音読さん公式サイトの画面で文章を貼り付け、読み上げの設定を選んでダウンロードするだけです。
- 公式サイトを開き、「テキスト」タブの入力欄に読み上げたい文章を貼り付けます。入力した文字数は入力欄の右下に表示されます。
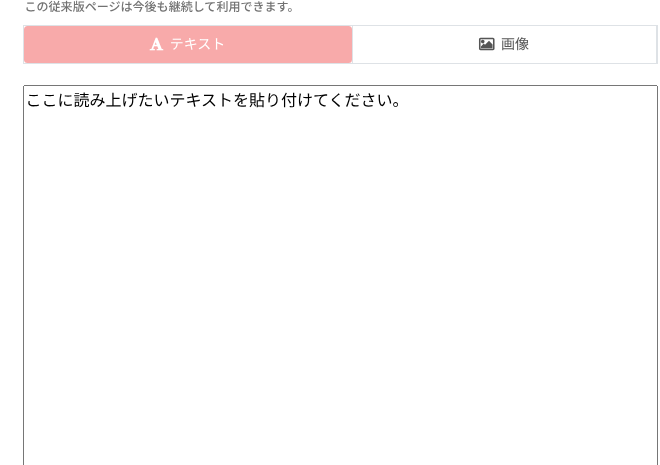
- 言語と声を選び、読み上げのボタンを押して聞きます。速度や高低も調整できます。
- 気に入った音声は「ダウンロード」から音声ファイル(.mp3)として保存します。
登録なしで読み上げられるのは1,000文字までで、無料登録をすると5,000文字まで増えます。無料登録をすると、履歴の確認や会話機能も使えるようになると公式サイトに記載されています。
VOICEVOXで読み上げる手順(ダウンロード型)
VOICEVOXはソフトをパソコンにインストールして使います。VOICEVOX公式「使い方」に沿った流れは次のとおりです。
- 公式サイトからお使いのOS(Windows / Mac / Linux)のソフトをダウンロードし、インストールして起動します。起動すると最初に音声合成エンジンが立ち上がります。
- キャラクターアイコンの右の空白をクリックしてテキストを入力し、Enterキーで確定します。画面の下に読みとアクセントが表示されます。
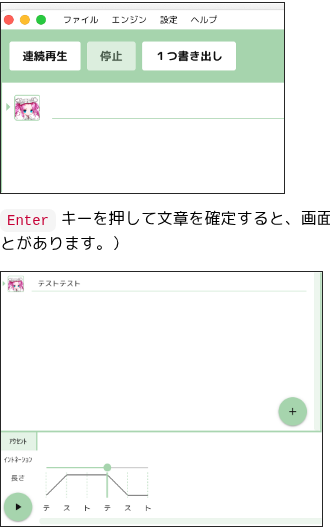
- 再生ボタンを押すと音声が生成されて再生されます。読みやアクセント、イントネーションが違うときは、その場で手直しできます。
- 書き出すときは、メニューの「ファイル」にある「音声書き出し」を押します。全テキスト欄の音声がWAVファイルとして保存されます。
VOICEVOXで作った音声を公開する場合は、各キャラクターの利用規約に従い、VOICEVOXを利用したことが分かるクレジット表記を入れてください。公式の利用規約でも、作成した音声を使うときは各音声ライブラリの規約に従うことと、クレジット表記が求められています。
こうしたツールが自然な音声を生成できる背景には、本記事で解説しているメルスペクトログラムを介した音響特徴量の予測と、ニューラルボコーダによる波形生成という2段階のTTSアーキテクチャがあります。クリスタルメソッドでも音声合成技術の研究の中で、アクセント推定や音韻区切れ検出といった要素技術に取り組んでおり、無料ツールを使う際も「どの区間で声の高さ・区切りが不自然になりやすいか」を意識すると、生成結果の品質を見極めやすくなります。
クリスタルメソッドにおける音声合成AIの取り組み:アクセント推定と音韻区切れ検出
日本語の音声合成において長年の技術的課題となっていたのがアクセントの不自然さです。日本語はアクセント型(高低アクセント)が単語・文脈によって複雑に変化するため、単純にテキストを音素に分解して音声を合成するだけでは、正しいアクセントが再現されません。
従来の音声合成モデルでは、テキストデータのみを学習させていたため、以下のような誤アクセントが生じていました。
- 「母の誕生日に、手紙と鞄をあげました。」→「誕生日」のアクセントが不自然
- 「ご飯を食べようとした時、塩を入れ忘れたことに気づいた。」→「ご飯」のアクセントが不自然
- 「あの店のハンバーガーは大きすぎるから、一人では全部食べられないよ。」→「食べられないよ」のアクセントが不自然
クリスタルメソッドが開発した音声合成モデルTTS(Text-to-Speech)は、テキストに加えてアクセント情報を別特徴量として学習させるアーキテクチャを採用しています。具体的には、形態素解析・アクセント辞書・音韻境界情報を組み合わせてアクセント型を推定し、それをTTSモデルの条件付け入力として与えることで、合成音声のアクセント品質を大幅に改善しました。
さらに、音韻区切れ(ポーズ)の検出にも独自の研究を行っています。人間の自然な発話では、句読点の位置だけでなく、文の意味的まとまりや話者の呼気・リズムに応じた適切な間(ポーズ)が挿入されます。この自然なポーズを機械学習で推定することにより、長文の朗読においても聴きやすいリズム感を持った音声が生成できるようになりました。
被験者を対象とした主観評価実験(MOS:Mean Opinion Score、5段階評価)では、テキストのみを学習した従来モデルと比較して、テキスト+アクセント情報を学習したクリスタルメソッドモデルのほうが高い評価を得たとしています(社内での評価実験によるもので、詳しい数値は本記事では公開していません)。この改良モデルは、クリスタルメソッドの対話型AI「HAL3」の朗読機能および「DeepAICopy」に実装されています。
- 従来モデル(テキストのみ学習):アクセント誤りが頻発し、聴取者の違和感が高い
- クリスタルメソッドモデル(テキスト+アクセント学習):アクセント誤りが減り、自然性の評価が向上したとしています
- 特に複合語・固有名詞・長文における差が顕著
音声合成AIの最新動向(2025〜2026年)
音声合成AIの技術は急速に進化を続けており、2025〜2026年時点では以下のトレンドが注目されています。
感情・スタイル制御の高度化
単語・文単位でのピッチ制御にとどまらず、「喜び」「悲しみ」「怒り」などの感情状態や「ニュースキャスター調」「フレンドリー調」といったスタイルを指定して音声を生成できるモデルが実用化されています。コンテンツ制作・教育・ゲーム分野での需要が高まっています。
Few-shot・Zero-shot音声クローニング
わずか数秒〜数十秒の音声サンプルから特定話者の声を再現する技術が急速に成熟しています。従来は数時間〜数十時間の収録データが必要だったところが、短時間のサンプルで高品質なクローニングが可能になったことで、パーソナライズドTTSの大衆化が進んでいます。
多言語・多方言対応
クリスタルメソッドでも取り組んできた標準語から関西弁への変換のように、方言・アクセントの再現は音声合成の品質向上における重要テーマです。近年は100言語以上に対応したマルチリンガルモデルが登場しており、単一モデルで言語をまたいだ音声変換も実現されています。
リアルタイム合成の実用化
クラウドAPIを介したTTSは既に低遅延化が進んでいますが、エッジデバイス上でのオンデバイス処理(ネットワーク接続なしでのリアルタイム音声合成)も実用レベルに達しつつあります。IoTデバイス・医療機器・車載システムへの組み込みが加速しています。
倫理・規制への対応
音声クローニング技術の普及に伴い、声の無断複製や詐欺への悪用を防ぐ法整備・業界自主規制が各国で進んでいます。日本でも2024〜2025年にかけて、AI生成コンテンツの表示義務化・声優等の権利保護に関する議論が活発化しており、音声合成技術を扱う事業者には倫理的対応が必須となっています。
👉 日本語特化のAI音声合成サービス(ブラウザ・API・完全オフライン対応)については、SakuraSpeech(サクラスピーチ)|日本語特化のAI音声合成で詳しく解説しています。
音声合成の品質はどう評価する?
合成音声が「自然かどうか」は、機械的な数値だけでは決めにくく、人が実際に聞いて採点する主観評価が基本です。代表的な方法がMOS(Mean Opinion Score)で、複数の聴取者が音声を聞いて5段階で採点し、その平均を取ります。
数値で自動的に測る客観指標については、日本語版Wikipediaの「音声合成」が、合成音声の自然性を客観的に評価するのは難しく、専門家の間で広く有効と認められた客観指標はないと説明しています(2026年10月14日確認)。手法どうしを公平に比べにくい点も同じ記事で触れられています。研究者ごとに別のデータで学習し、別の課題で評価することが多いためです。これに対し、ISCAのSynSIGが2005年から毎年「Blizzard Challenge」を開き、共通のデータと共通の課題で評価する形をとっています。
読み上げサービスを選ぶ場面では、次の3点を自分の文章で聞き比べるのが実用的です。
- アクセント・読み間違い:固有名詞や専門用語、同音異義語が正しく読まれるか
- 長文のリズム:句読点以外の位置でも自然な間があり、息継ぎが不自然でないか
- 利用条件:商用利用の可否やクレジット表記の要否(前の章のVOICEVOXのように、規約で条件が決まっています)
読み方や間を指定するSSMLとは
テキストの解析を完全に正しく行うのは難しく、文字だけでは読み方を決められない場合があります。「行った」を「いった」と読むか「おこなった」と読むか、といった例です。そこで、読み方・間・高さなどを人が書き添える仕組みが使われます。その標準のひとつが、W3Cが勧告として定めたSSML(Speech Synthesis Markup Language)です。SSML 1.1は2010年9月7日にW3C勧告となっています(W3C公式仕様で確認、2026年10月14日)。
| 要素 | 役割 |
|---|---|
break | 音声の途中に間(ポーズ)を入れる |
prosody | 声の高さ・話す速さ・音量を調整する |
say-as | 日付・数字・略語など、文字列の種類を示して読み方を助ける |
phoneme | 単語や短い語句に、発音記号などで読み方を直接指定する |
sub | 書かれた文字と別の読み(alias)に置き換えて読ませる |
W3C仕様にあるphonemeの書き方は次の形です(仕様の例を基にした英語の例で、breakのtimeはSSMLの標準的な指定です)。
<speak version="1.1" xmlns="http://www.w3.org/2001/10/synthesis" xml:lang="en-US">
  Say <phoneme alphabet="ipa" ph="təmeɪtoʊ">tomato</phoneme>.<break time="500ms"/>
  Thank you.
</speak>
ただし、どの要素や属性に対応しているかは読み上げサービスごとに異なります。使う前に、各サービスのドキュメントで対応状況を確認してください。VOICEVOXのように画面上でアクセントを直接直せるソフトもあります。
よくある質問
Q. 音声合成AI(TTS)とはどのような技術ですか?
A. テキストを入力として受け取り、コンピュータが人間らしい音声を生成して出力する技術です。ピッチ(音の高さ)・話速・イントネーション・声質を細かく制御できる点が、単純な読み上げ機能との違いです。
Q. 音声合成AIはどのような仕組みで自然な声を作り出しているのですか?
A. 音声データを人間の聴覚特性に合わせて変換した「メルスペクトログラム」という時間・周波数・音の大きさを表す二次元データに変換し、テキストとの対応関係を深層学習で学習します。生成されたメルスペクトログラムはVocoder(音声生成器)で実際の音声波形に変換されます。
Q. 音声合成の技術はどのように進化してきましたか?
A. 1990年代以降は隠れマルコフモデル(HMM)が主流でしたが、2010年代以降はディープニューラルネットワーク(DNN)が台頭し、CNN→RNN→LSTM→Transformerという段階的な発展を経て、現在はFastSpeech・VITS・Voiceboxなどトランスフォーマーベースのモデルがリアルタイム性・音質・多言語対応を高水準で実現しています。
Q. 声質変換(Voice Conversion)とはどのような技術ですか?
A. 特定の人物の音声データを学習させ、入力された別の人物の声をその人物の声質に変換する技術です。ピッチ成分・スペクトル包絡・非周期成分を個別に変換することで、声の質感や話し方のニュアンスまで再現できます。失われた声の復元やコンテンツ制作の多言語吹き替え、オンライン会議での匿名化などへの応用が期待されています。
Q. 音声合成AIによるノイズ抑制はどのように機能しますか?
A. クリーンな音声とノイズが混入した音声のペアデータを深層学習に学習させることで、ノイズと音声成分を精度高く識別・分離するモデルを構築します。オンライン会議のノイズ除去、音声認識精度の向上、設備の異音検知など幅広い場面での活用が想定されています。
Q. 日本語の音声合成でアクセントが不自然になりやすいのはなぜですか?
A. 日本語は単語や文脈によってアクセント(高低)が複雑に変化するため、テキストを音素に分解するだけでは正しいアクセントが再現されないことがあります。テキストに加えてアクセント情報を別の特徴量として学習させるアーキテクチャにより、この課題に対応できます。
Q. 無料で使える音声生成AIツールはありますか?
A. 音読さん(テキスト読み上げ、無料1,000文字・無料登録で5,000文字まで、多言語対応)やVOICEVOX(無料のテキスト読み上げ・歌声合成ソフト、多数のキャラクターボイスを収録)などが代表例です。利用規約はキャラクターごとに異なるため、商用利用の際は個別確認が必要です。
Q. 音声クローニング(声の複製)にはどのような注意点がありますか?
A. 声質変換・音声クローニング技術は、他者の声を無断で複製・悪用するディープフェイク音声のリスクと表裏一体です。利用目的の明確化、当事者の同意取得、ウォーターマーク埋め込みなどの倫理的対策が重要です。
Q. 音声合成にはどんな方式がありますか?
A. 録音した声をつなぎ合わせる「波形接続型」、声の特徴を統計モデルで学習する「統計的パラメトリック型(HMMなど)」、深層学習で音声を生成する「ニューラル型」の3つに大きく分けられます。現在の読み上げサービスの多くはニューラル型です。
Q. 音声合成と音声認識は何が違いますか?
A. 音声合成は文字を声に変える技術(Text-to-Speech)、音声認識は声を文字に変える技術(Speech-to-Text)で、向きが逆です。AIと声で会話する仕組みでは、音声認識で聞き取り、文章で考え、音声合成で話す、という形で両方が使われます。
Q. 合成音声の品質はどう評価しますか?
A. 基本は、聴取者が聞いて5段階で採点するMOSなどの主観評価です。自然性を測る客観指標は、専門家の間で広く有効と認められたものがないと日本語版Wikipediaも説明しています。サービスを選ぶときは、自分の文章で試聴し、アクセントの誤りや長文の間を確認するのが実用的です。
Q. SSMLとは何ですか?
A. 読み方・間・声の高さなどを指定するための、W3Cが勧告として定めた音声合成用のマークアップ言語です。breakで間を入れ、phonemeで読みを指定するなどの使い方があります。対応する要素はサービスごとに異なります。
まとめ
音声合成AIは、HMMから深層学習(DNN・LSTM・Transformer)へと技術的基盤を大きく更新しながら、かつての不自然な機械音から人間と遜色ない自然な音声へと品質を飛躍的に向上させてきました。メルスペクトログラムを介した音声の数値表現・声質変換・ノイズ抑制・アクセント推定といった要素技術が組み合わさることで、医療・福祉・コンテンツ制作・カスタマーサポートなど幅広い産業での活用が現実のものとなっています。
クリスタルメソッドでは、テキストとアクセント情報を組み合わせた日本語TTS・声質変換・ノイズ抑制をはじめ、バーチャルヒューマン・対話型AIへの統合実装を通じて、より自然なヒューマン・AI間コミュニケーションの実現を追求しています。今後は感情制御・Few-shot音声クローニング・オンデバイス処理といった技術がさらに成熟し、音声合成AIは社会インフラの一部として生活に深く浸透していくことが予想されます。倫理的な利用指針を守りながら、この技術の可能性を最大限に活用していくことが重要です。
AIの業務活用をご検討の方へ
クリスタルメソッドは、バーチャルヒューマンをはじめAIの開発・業務導入を支援しています。生成AI・AIエージェントの活用や、自社業務へのAI導入をご検討の際は、お気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
読み上げアプリ無料7選|iPhone・Android別比較【2026】
読み上げアプリ無料の決定版を選ぶときは、iPhone・Android別のOS標準機能をまず試し、不足を専用アプリで補うのが最短ルートです。この記事では、2026...
-
SakuraSpeech(サクラスピーチ)|日本語特化のAI音声合成 – ブラウザ・API・完全オフライン対応【2026年版】
SakuraSpeech(サクラスピーチ)は、入力したテキストを自然で表情ゆたかな日本語音声に変換する、日本語特化のAI音声合成(TTS:Text-to-Spe...
-
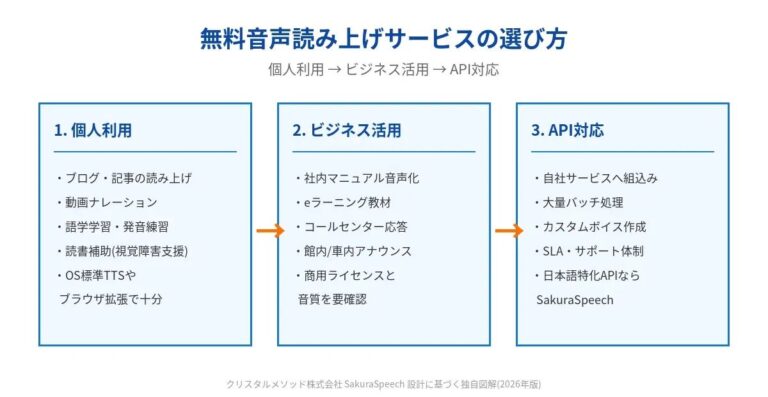
無料で使える音声読み上げサービス比較|API対応まで【2026】
音声 読み上げ無料で利用できるサービスは、個人のブログ読み上げから企業のマニュアル音声化、自社サービスへのAPI組み込みまで、用途別に幅広く揃っています。ただし...