
blog
AIブログ
マルチモーダルAIとは?意味・仕組み・できることをわかりやすく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
マルチモーダルAIとは、テキスト・画像・音声・動画など複数の種類の情報(モダリティ)を、ひとつのAIがまとめて受け取り、統合して理解・処理できるAIのことです。1種類の情報しか扱えない「シングルモーダルAI」と対になる言葉で、ChatGPT・Gemini・Claudeのように画像を読める対話型AIが身近な例です。
「画像を見せるだけでAIが内容を説明してくれる」「音声と映像を同時に解析して感情を読み取る」——これらはすべてマルチモーダルAIの働きです。ChatGPTへの画像入力、スマートスピーカーの文脈対話、自動運転車のセンサー融合、製造現場の予知保全まで、2026年現在、マルチモーダルAIはデジタル社会の基盤技術となっています。本記事では、マルチモーダルAIの定義・仕組み・歴史的背景・活用事例・リスクと限界・選定基準、そして自社の研究・開発事例まで、順を追って解説します。
マルチモーダルAIとは何か――定義と基本概念
マルチモーダルAI(Multimodal AI)とは、「multi(複数の)+modal(様式・モード)」を語源とする技術用語で、テキスト・画像・音声・動画・センサーデータなど複数種類の情報(モダリティ)を同時に受け取り、統合して処理するAIシステムを指します。
「モダリティ」とは情報の種類・様式のことです。テキストのみを扱うAI、あるいは画像のみを扱うAIは「シングルモーダル」と呼ばれます。シングルモーダルでは1種類の情報しか取り込めないため、文脈・感情・状況の複合的な判断には限界があります。マルチモーダルAIはこの壁を超え、人間が五感を使って状況を総合判断するのに近い処理を実現します。
たとえば人間は「怒鳴り声が聞こえる」だけでなく、相手の表情・姿勢・状況の文脈をあわせて「これは危険な口論だ」と瞬時に判断します。マルチモーダルAIも同様に、音声・映像・テキストを統合することで、より正確で文脈に即した判断を下せるようになります。
- 入力:1種類(例:テキストのみ)
- 判断:部分的な情報に依存
- 限界:文脈・感情・状況の見落とし
- 強み:軽量・高速・低コスト
- 入力:複数(テキスト+画像+音声など)
- 判断:情報を統合した総合的な判断
- 強み:文脈・感情・状況の正確な把握
- 注意:高い計算リソースが必要
2022年以降、ChatGPT・Gemini・Claudeなどの大規模言語モデル(LLM)の主要サービスが画像入力に対応し、テキストと画像を同時に入力して回答を得ることが一般ユーザーにも身近になりました。2026年現在、マルチモーダルはAI研究・開発の中核技術として位置づけられており、研究論文数・製品実装数ともに急増しています。
マルチモーダルAIが処理できる主なモダリティは以下の通りです。
| モダリティ | 具体例 | 主な用途 |
|---|---|---|
| テキスト | 文書・チャット・ラベル | 質問応答・要約・感情分析 |
| 画像 | 写真・X線・衛星画像 | 物体検出・検品・医療診断支援 |
| 音声 | 発話・環境音・機械音 | 音声認識・感情推定・異音検知 |
| 動画 | 監視映像・講義動画 | 行動認識・要約・スポーツ分析 |
| センサーデータ | 振動・温度・LiDAR・IMU | 自動運転・予知保全・ロボット制御 |
| 構造化データ | 検査数値・ログ・EHR | 診断支援・異常検知・財務分析 |
詳しい仕組み(エンコーダー・フュージョン戦略・アーキテクチャ)については マルチモーダルAIの仕組み で詳しく解説しています。また、できることの全体像は マルチモーダルAIでできること をご覧ください。
複数の種類の情報をどう扱って判断するかは、マルチモーダルAIの仕組み・原理で解説しています。
マルチモーダルAIとシングルモーダル・LLM・生成AIの違い、主なメリット
主なメリット(3つ)
- 状況の取りこぼしが減る:画像だけ・音声だけでは判断が割れる場面でも、複数の情報を突き合わせて判断できます。
- 人と同じ入力でやり取りできる:写真を撮って質問する、声で指示するなど、文字に直す手間なく使えます。
- 眠っているデータを使える:録画・録音・図面・帳票など、文字になっていない資産を活用できます。
一方で、計算コストやハルシネーションなどの課題もあります。詳しくは下の「リスクと限界」で解説します。
LLM・生成AI・シングルモーダルとの違い
| 用語 | 意味 | マルチモーダルAIとの関係 |
|---|---|---|
| シングルモーダルAI | テキストだけ、画像だけなど1種類の情報を扱うAI | 対になる言葉です。 |
| LLM(大規模言語モデル) | 文章(言語)を中心に学習した大規模なモデル | 画像などの入力にも対応したものを「マルチモーダルLLM」と呼びます。 |
| 生成AI | 文章・画像・音声などを新しく作るAIの総称 | 「何を作るか」の軸の言葉です。「何種類の情報を扱うか」の軸であるマルチモーダルとは軸が別で、両方に当てはまる製品もあります。 |
次に読む:主要なマルチモーダルAIモデルにはどんなものがある?
マルチモーダルAIの仕組み――入力をそろえて統合し、答えを作る
マルチモーダルAIの処理は、大きく3つの段階に分けて考えると分かりやすくなります。細かい構造はモデルごとに異なるため、ここでは共通する考え方だけを説明します。
- 入力を数値に直す(エンコード):文章・画像・音声などは、そのままでは計算できません。種類ごとの変換部品が、それぞれを「意味を表す数値の並び」に直します。
- 種類をまたいで統合する(フュージョン):変換した数値を同じ土俵に載せ、「この画像のこの部分が、質問文のこの語に対応する」といった関係を学習します。ここがマルチモーダルの中心で、統合のタイミングには、入力の段階でまとめる方法と、種類別に処理した後でまとめる方法などがあります。
- 答えを出す(デコード・出力):統合した情報から、文章や判定結果などを出します。画像や音声を「作る」場合は、別の生成モデルが担当する製品も多くあります。
たとえば「工場の写真を渡して、異常がないか尋ねる」場合は、写真が数値に直され、質問文と結び付けられ、回答の文章が作られます。エンコーダー・統合方式・アーキテクチャの詳細はマルチモーダルAIの仕組みで解説しています。
代表的なマルチモーダルAIと、入力できる情報の種類(2026年10月時点)
身近なマルチモーダルAIは、ChatGPT・Gemini・Claudeのような対話型サービスです。各社の公式ドキュメントで確認できる範囲を表にまとめます(2026年10月19日確認)。OpenAIのモデル一覧ではフラッグシップがGPT-6 Astraで、最新モデルはテキストと画像の入力に対応するとされています(音声はGPT-Live 1・GPT-Realtime-2.1などの音声系モデルが担当)。GoogleのGemini 4 Argonのモデルページでは、入力はテキスト・画像・動画・音声・PDF、出力はテキストのみです。Anthropicのモデル概要では、現行モデルはいずれもテキストと画像を入力でき、出力はテキストです。対応する入力はモデルや更新ごとに変わるため、利用前に各社の最新ドキュメントで確認してください。
| サービス | 公式ドキュメントで確認できる入力 | 補足 |
|---|---|---|
| ChatGPT/OpenAI API(フラッグシップ:GPT-6 Astra) | テキスト・画像(PNG・JPEG・WEBP・アニメーションなしのGIF) | 画像はURL・Base64・ファイルIDで渡せます。画像の「生成」はGPT Image系のモデルが担います。(OpenAI 画像とビジョンのガイド) |
| Gemini/Gemini API(フラッグシップ:Gemini 4 Argon) | テキスト・画像・音声・動画・PDF | 音声対話用のLiveモデルや、画像・動画を生成するモデルは別系統として一覧に載っています。(Gemini API モデル一覧) |
| Claude/Claude API(現行:Claude Opus 5.5・Sonnet 5.5ほか) | テキスト・画像(JPEG・PNG・GIF・WebP) | APIは1リクエストに画像を最大100枚(200kトークンの文脈のモデル)または600枚(その他)、claude.aiは1メッセージ20枚まで。Claudeは画像を理解する側で、画像の生成・編集はしません。(Claude Vision 公式ガイド) |
表は「入力」の対応です。画像や動画を「作る」出力側は、別のモデルが担当する製品が多くあります。個別のモデルの一覧はマルチモーダルAI一覧、料金・精度の比較はマルチモーダルAI比較、無料で試せるものはマルチモーダルAI無料、業務での使い方はマルチモーダルAI事例、手元のPCで動かす方法はマルチモーダルLLM ローカルで整理しています。
マルチモーダルAIの業界別活用事例(公開事例・2026年10月19日確認)
マルチモーダルが実用化されることで、AIの応用範囲は大幅に広がりました。視覚・聴覚・触覚・センサー情報を統合対象とし、以下の分野で活用が進んでいます。特定企業の公開事例には出典のリンクを付けています。それ以外は一般的な活用の説明です。主要事例の詳細は マルチモーダルAI事例 でも紹介しています。
活用事例1:行動認識技術による防犯対策・トラブル防止
行動認識技術とは、人の骨格・位置関係・動作・音声・表情を複合的に検知し、「誰がどのような行動をしているか」を認識する技術です。主に監視カメラシステムや公共空間の安全管理に導入されています。
たとえば、2人の男性が向かい合っている場面を考えます。
- 画像情報のみ:普通の会話と口論の区別がつかない
- 音声情報のみ:音量が大きくても、冗談か本気の怒りかが分からない
- 行動情報のみ:肩を叩く動作が友好的なものか暴力行為かが判断できない
これら複数の情報をマルチモーダルで統合することで、AIは状況をより正確に判断し、危険を早期に察知して管理者に通知できます。誤警報を減らしながら迅速な対応を可能にする点で、施設管理の現場で活用が進んでいる分野です(特定の導入事例ではなく一般的な説明です)。
活用事例2:生産工場での異変検知・品質管理
マルチモーダルは振動・異音・温度・圧力といった産業用センサーデータにも応用できます。単独のセンサーでは見落としやすい「音と振動の同時異常」も、複数のセンサーを組み合わせることで捉えやすくなります(向上の幅は現場や設備によって異なります)。
- 画像認識による検品:正しい規格か、異物混入がないかをカメラで自動判定
- 音声認識による機械診断:動作音からモーターの摩耗・ベアリング異常を早期検知
- 振動センサーとの融合:通常動作と異なる振動パターンを検知し即座にアラートを発報
- 温度センサーとの連携:加熱異常・冷却不足を正常値との比較で自動検出
予知保全(Predictive Maintenance)はマルチモーダル活用が進む領域の一つです。人間の目視・聴覚チェックでは見落としがちな異常を拾える可能性があります。
公開事例(製造・保守):日立パワーソリューションズと日立製作所は、受変電設備の真空遮断器(VCB)の点検後に、作業者がスマートフォンで撮影した画像をAI(Googleの「Gemini」)が確認し、ボルトの取付け方向の誤り・コンデンサの電極配線の接続ミス・放電クリップの取り外し忘れを判定するAIエージェントを開発し、現在その有効性を検証しています。正しい状態と誤った状態の参照画像と現場画像を比べる方式で、当初は判定が揺らいだため、確認箇所への赤枠の注釈や注意点の文章を添えて精度を上げたと説明されています。導入済みの成果ではなく検証段階で、判定精度や時間短縮の数値も公表されていません。今後は動画のリアルタイム通知や、音声・振動・温度などのセンサー対応が構想されています。(出典:日立「フィジカルAIのリアル 第2回 中編」2026年7月27日公開)
活用事例3:視覚に障害のある人の日常を支える(Be My Eyes)
アプリ「Be My Eyes」の「Be My AI」は、利用者が撮った写真をAIが詳しく言葉で説明し、続けて質問もできる機能です。OpenAIのGPT-4(画像入力に対応したマルチモーダルモデル)を使い、全盲・弱視の利用者には無料と案内されています。AIが答えられないときや結果を確かめたいときは、ボランティアに頼める形も残されています。(出典:Be My Eyes「Introducing: Be My AI」。この発表は2023年8月時点のベータ版の説明で、現在の提供状況は公式サイトで確認してください)
画像(入力)と質問の文章(入力)から、説明の文章(出力)を返す、本記事で試す手順と同じ基本形の活用です。
活用事例4:医療――読影レポートの所見文とCT画像の解析結果を突き合わせる(富士フイルム)
富士フイルムメディカルは2025年4月、CTの読影レポートを作成する医師向けに「SYNAPSE SAI Report 構造化機能」の提供を始めました。AIが所見の文章と画像ビューアの解析結果を照合し、臓器・解剖位置(左右)・性別などが食い違うとアラートを表示して記載ミスを防ぎます。文章(テキスト)と画像の解析結果を突き合わせる、医療でのマルチモーダルの活用例です。判断するのはあくまで医師で、AIは記載の食い違いを知らせる補助という位置づけです。(出典:富士フイルムメディカル「SYNAPSE SAI Report 構造化機能 提供開始」)
活用事例5:小売・EC――画像を使った商品の試着体験(Google ショッピング)
Googleは2023年6月、検索上の「Try On」バッジが付いた衣類について、生成AIが多様な体型・肌の色のモデルに服を着せた様子をポーズごとに表示する機能を発表しました。公開時点では米国のユーザー向けで、対象は女性用トップスのみでした。(出典:Google公式ブログ「Virtually try on clothes with a new AI shopping feature」)その後、利用者自身の写真をアップロードして試す方法も公式ブログで案内されています(利用方法の解説)。提供国・対象商品は変わるため、日本で使えるかは公式で確認してください。商品画像と人物の画像という複数の入力を組み合わせる、小売・ECの代表的な活用です。
活用事例6:小売――需要予測・発注と、写真を使った接客・商品探し
小売では、売れ行きの予測と店頭・ネットでの接客の2つで活用が進んでいます。
需要予測・発注(公開事例):ソフトバンクは2026年3月30日、AI需要予測サービス「サキミル」で、飲食・小売向けのAI自動発注の提供を始めると発表しました。発表によると、過去の来店客数や売上予測データ、日本気象協会の気象データ、商品価格、過去の発注実績、日々の棚卸入力などを組み合わせて発注の推奨値を自動で算出し、担当者が確認・調整できる仕組みです。公式の発表に導入効果の具体的な数値は載っておらず、在庫の最適化とフードロス・機会ロスの削減が目標として示されています。(出典:ソフトバンク「飲食・小売向けAI自動発注サービスを提供開始」(2026年3月30日発表・2026年10月20日確認))この発表で挙げられている入力は数値データが中心です。商品画像や売り場の写真、レビューの文章といった別の種類の情報も同じ予測に取り込めるようにするのが、マルチモーダル化で期待される方向です(一般的な説明であり、このサービスが画像を使うという意味ではありません)。
接客・商品探し:次の事例5で紹介したGoogleの試着機能のように、商品の画像と利用者の画像を組み合わせる活用が代表的です。店舗やECの問い合わせ対応でも、お客様が送った商品の写真とメッセージの文章を合わせて読み取り、型番の特定や使い方の案内につなげる使い方が考えられます(一般的な説明です)。この手順は、本記事の「実際に試す手順」で画像を読ませて質問する方法と同じ基本形です。
活用事例7:自動運転
自動運転はマルチモーダルが最も集約的に活用される領域の一つです。人間のドライバーは走行中、視覚・聴覚・触覚・空間認識を同時に処理して瞬時に判断しています。これをAIで再現するには、複数センサーとモダリティの高度な統合が不可欠です。
- カメラ映像:白線・信号・歩行者・障害物の認識
- LiDAR(レーザーレーダー):3D空間の距離計測、立体物の把握
- 音声認識:クラクション・踏切音・緊急車両のサイレンを識別
- 歩行者属性の識別:高齢者・幼児・自転車利用者など詳細なカテゴリ分類
- ドライバー状態監視:視線・頭部動作・瞬き頻度から眠気・注意散漫を検知
- 音声対話システム:ナビゲーション操作や交通情報提供を音声で行い、視線移動を最小化
「信号は青だが右折先に歩行者がいて横断しようとしている」「左前方から急ブレーキ音がした」といった複合的な判断が可能になります。2026年現在、特定条件下での完全自動運転(SAEレベル4)は複数の国・地域で実証段階に入っており、マルチモーダル処理のさらなる精度向上が求められています。
公開事例(自動運転):Waymoは公式ページで、車に載せた数十個のセンサーの情報を使い、他の車や歩行者などの物体を識別する「Waymo Driver」を、センサーと計算機を一体で設計した統合システムとして説明しています。(出典:Waymo Driver)
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
実際に試す手順――画像を読ませて質問する
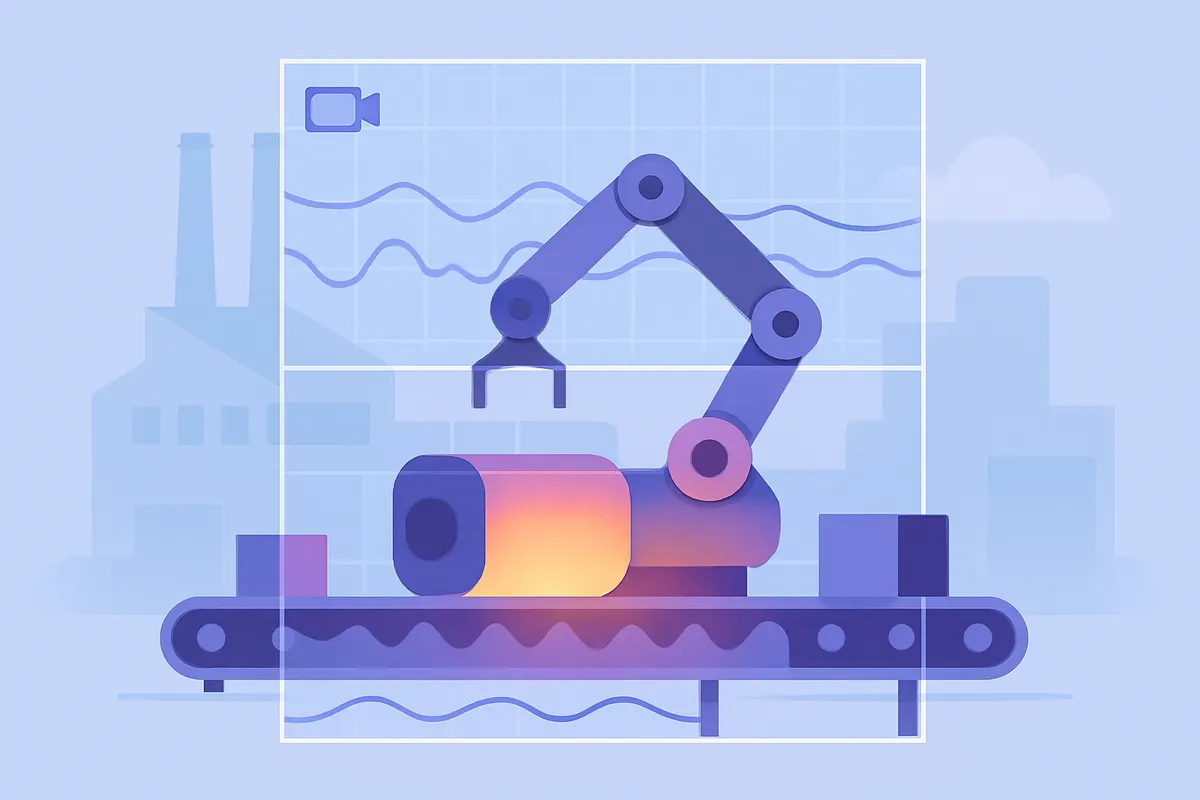
いちばん簡単な体験は「画像1枚+質問」です。ここでは、このページ上部にある製造現場のイラストを画像ファイルとして用意し、Claude Codeに読ませた実際の画面(2026年10月14日に実行)を示します。ChatGPT・Gemini・Claudeのチャット画面でも手順は同じで、画像を添付して質問するだけです。
- 画像を用意する:JPEG・PNGなど、使うサービスが対応する形式にします(形式は上の表の公式ガイドで確認できます)。
- 画像を渡す:チャット画面では添付ボタンかドラッグ&ドロップです(Claudeの公式ガイドでも、claude.aiは画像をファイルのようにアップロードする方法が案内されています)。Claude Codeでは、画像のあるフォルダで起動し、ファイル名を書いて読むよう頼みます。
- 質問を具体的に書く:「何が写っているか」「文字を書き起こして」「数字を表にして」など。今回は「15字で3行」と形も指定しました。
- 答えを画像と見比べる:AIの説明が実際の画像と合っているかを、人の目で確認します。
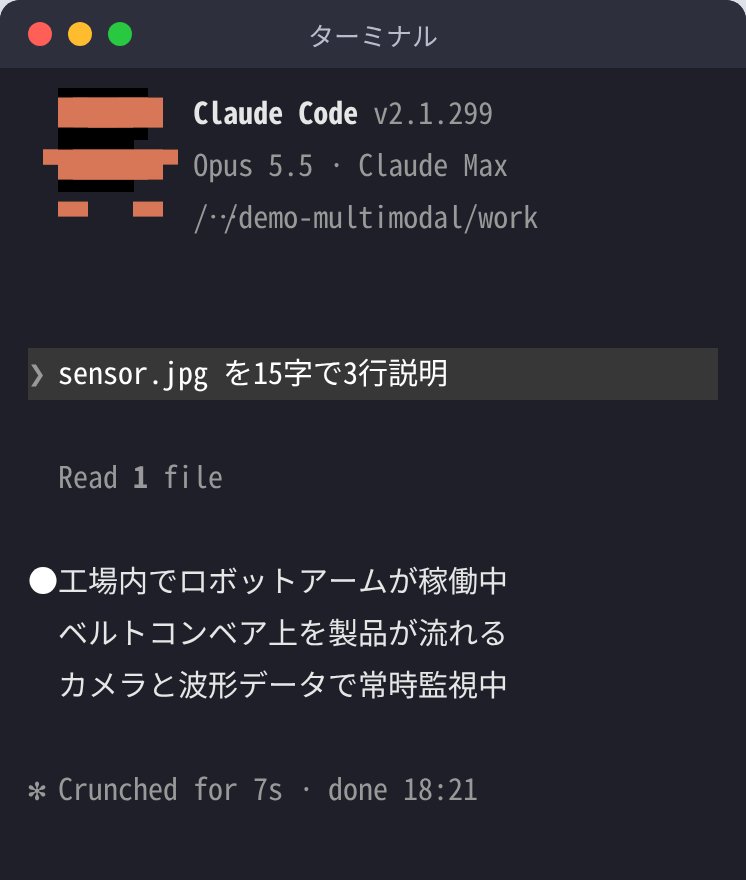
入力は「画像」と「日本語の指示」の2種類、出力は文章です。これがマルチモーダルAIの基本の動きです。答えは画像の内容とおおむね合っていますが、「常時監視中」のような解釈は絵からの推測なので、必ず元の画像で確かめます。
画像を読ませるときの注意(Claude公式ガイドより)
- 小さすぎる(200ピクセル未満)・回転している・不鮮明な画像では、誤りやすくなります。
- 物の数は、数が多く小さいほど不正確になることがあります。
- 人物の特定はできず、CTやMRIなど複雑な診断画像の読影用には設計されていません。
- 社外のサービスに送る画像は、機密や個人情報が含まれないか、社内ルールで先に確認してください。
リスクと限界――導入前に知っておくべきこと
マルチモーダルAIのメリットは大きい一方で、導入・運用にあたっては以下のリスクと限界を正確に理解しておく必要があります。技術を過信せず、リスク管理とセットで活用することが信頼性の高いシステム構築につながります。
計算コスト・インフラ要件
複数モダリティを統合するモデルは、シングルモーダルと比較してモデルサイズ・推論計算量が大幅に増大します。クラウドAPIで利用する場合はコスト増、オンプレミス・エッジ実装の場合はGPU等の高性能ハードウェアが必要です。用途・予算・レイテンシ要件を踏まえた選定が重要です。
学習データの偏りとバイアス
マルチモーダルモデルは大量の学習データから統計的パターンを学習しますが、データに偏りがあればAIの判断にもバイアスが生じます。特に顔認識・感情認識では、特定の人種・年齢・性別に対する精度差が報告されており、NIST(米国国立標準技術研究所)の顔認識の評価(2019年)でも、人種・年齢などによって誤認識率に差があることが示されています。公平性の担保には、多様なデータでの検証と継続的なモニタリングが必要です。
プライバシーと法的リスク
顔画像・音声・行動データは個人を特定できる情報であり、収集・利用には本人の同意と適切な法的根拠が必要です。GDPRでは生体データは「特別なカテゴリのデータ」として厳格な要件が課されます。日本では個人情報保護法の改正により、仮名加工情報・匿名加工情報の要件も明確化されています。
誤認識・幻覚(ハルシネーション)
マルチモーダルLLMであっても、画像内の細部を誤認識したり、存在しない情報をもっともらしく生成する「ハルシネーション」が発生します。医療診断・法的文書・安全システムなど誤りが重大な結果を招く用途では、ヒトによる最終確認と二重チェックの仕組みが不可欠です。
セキュリティリスク(敵対的攻撃)
マルチモーダルモデルは「アドバーサリアル攻撃」に脆弱な場合があります。人間には見えにくいノイズを画像に加えることで、AIに意図的な誤認識を起こさせる攻撃が知られています。セキュリティが重要な用途では、モデルのロバスト性テストと入力検証の仕組みを設けることが推奨されます。
解釈可能性の低さ
複数モダリティを統合した深層モデルは「なぜその判断をしたか」の説明が困難です。医療・金融・採用など説明責任が求められる用途では、XAI(説明可能なAI)技術の組み合わせや、判断根拠を提示できる設計が必要です。EUのAI規制法(AI Act)では高リスクAIシステムに透明性と説明可能性が求められており、日本の「AI事業者ガイドライン」でも同様の考え方が示されています。
自社に必要か――向く場面・向かない場面と選び方
「とは」を理解した次に迷うのが、自社の課題にマルチモーダルAIが本当に適しているのかという判断です。ここでは定義の解説ではなく、検討者が最初の意思決定を下すための「向き・不向き」と「用途別の当てはめ」「主要サービスの使い分け」を整理します。
向いている場面(3つ)
- 複数の情報源を突き合わせて初めて意味が出るとき:映像+音声、画像+テキストのように、単一モダリティでは判断が割れる状況(例:現場の異常検知、来店者の状況把握)。
- 人が目と耳と文脈を同時に使って判断している業務:接客・面接・診療補助・品質検査など、五感的な情報統合が本質の作業。
- 非構造データが大量に眠っているとき:録画・録音・画像・自由記述など、テキスト化されていない資産を活用したい場合。
向かない場面(3つ)
- 入力がすでに構造化された数値・テキストだけで完結する:表形式データの予測や集計は、従来の機械学習・BIの方が安価で速く精度も安定します。
- 低遅延・低コストが最優先の大量処理:マルチモーダル推論は計算負荷とレイテンシが増えるため、リアルタイム性やコスト単価がシビアな用途では単一モダリティが有利。
- 判断根拠の完全な説明責任が求められる領域:モデルの解釈性に限界があるため、法的・医療的に「なぜその結論か」を厳密に立証する必要がある工程では人の最終判断を外せません。
用途別の判断早見
| やりたいこと | マルチモーダルの必要性 | まず検討する選択肢 |
|---|---|---|
| 売上・需要の予測、数値の分類 | 低い | 従来型の機械学習/統計モデル |
| 文章の要約・分類・下書き生成 | 低〜中 | テキスト特化のLLM |
| 画像・図面・帳票の読み取り+テキスト処理 | 中〜高 | 画像+テキスト対応のマルチモーダルLLM |
| 映像・音声から状況をリアルタイム把握 | 高い | 用途特化のマルチモーダルAI(自社構築・専用モデル) |
| 対話に表情・声のトーンなど非言語を反映 | 高い | 感情認識を組み込んだマルチモーダル基盤 |
主要サービスの1行使い分け(2026年時点の傾向)
汎用のマルチモーダルLLMは、まず「手元のデータで試す」段階で使い分けると迷いません。※対応モダリティ・料金・最新モデルは各社で頻繁に更新されるため、導入前に必ず公式ドキュメントで最新版を確認してください。
- GPT系(OpenAI):テキストと画像を一つの対話で扱いたい、汎用的な検証を素早く始めたいとき。
- Gemini系(Google):長い動画や大量ドキュメントをまとめて読ませる、長文脈のマルチモーダル処理を試したいとき。
- Claude系(Anthropic):画像を含む資料の読解や、指示への忠実さ・出力の扱いやすさを重視した業務組み込みを試したいとき。
- 用途特化・自社構築:汎用APIでは遅延・コスト・機密要件が合わない、あるいは現場固有の映像・音声を扱う場合は、専用モデルの構築が現実解になります。
選び方の4つの軸
- モダリティの一致:扱いたい入力(映像/音声/画像/テキスト)に確実に対応しているか。
- 遅延とコストの許容範囲:1件あたりの処理時間と単価が、業務のスループット要件に収まるか。
- データの機密性と設置形態:外部APIに送れるデータか、オンプレ・専用環境が必要か。
- 説明性と人の関与設計:誤りが許されない工程で、人による最終確認をどう組み込むか。
これらの軸で「汎用API」か「用途特化の構築」かが分かれます。現場固有の映像・音声・感情といった非言語情報まで踏み込む場合は、既製の汎用モデルでは要件を満たしきれず、専用の設計・構築が必要になるケースが多くなります。
選定チェックリスト
導入支援の現場で実際に使用されている確認項目をベースに、導入前に検討すべきポイントを整理しました。
- 目的と要件の明確化:何のモダリティを組み合わせ、何を判断・生成させるか?精度目標・レイテンシ要件は?
- データの確保:必要なモダリティのデータが十分な量・品質・多様性で揃っているか?ラベリングコストは?
- 法規制の確認:個人情報・生体情報・医療データに関する法令・ガイドラインへの対応は済んでいるか?
- インフラ・コスト:クラウドAPIか自社構築か。必要なGPU・ストレージ・ネットワーク帯域は確保できるか?
- バイアス・公平性の検証:学習データに偏りはないか。性能を年齢・性別・属性別に検証したか?
- セキュリティ対策:入力検証・敵対的攻撃対策・アクセス制御は設計されているか?
- 人間による監視・運用設計:AIの判断を最終確認するヒトのプロセスがあるか?誤り発生時の対応フローは?
- 継続的モニタリング:本番環境での精度劣化を検知するモニタリング仕組みはあるか?
主要なマルチモーダルAIサービスの比較は マルチモーダルAI比較、無料で試せるツールの一覧は マルチモーダルAI無料、代表的なモデルの一覧は マルチモーダルAI一覧 をご参照ください。
歴史――ディープラーニングとの深い関係
マルチモーダルAIの発展はディープラーニング(深層学習)の進化と不可分です。各モダリティの認識精度がディープラーニングによって飛躍的に向上したからこそ、複数モードの統合という次のステップが現実的になりました。
ディープラーニング以前のAIとその限界
20世紀までのAIは主に数値・記号データを対象とした機械学習に限られており、人間の視聴覚に相当する高次元データを扱う能力は極めて低いものでした。ニューラルネットワークは早くから研究されていましたが、当初は層が浅く表現力に限界がありました。また、計算リソースの不足・学習データの少なさ・勾配消失問題なども実用化の壁となっていました。
これらを打開したのがディープラーニング(深層学習)——ニューラルネットワークを多層化し、GPU並列計算・ビッグデータ・アーキテクチャ改良を組み合わせた手法です。人間が情報を処理する過程をコンピュータに学習・再現させることで、AI技術は飛躍的に向上しました。
ディープラーニングがもたらした認識精度の革命
ディープラーニングによって各モダリティの認識精度は劇的に向上しました。
| モダリティ | 従来AI技術 | ディープラーニング以後 |
|---|---|---|
| 画像認識 | バーコード読み取り・テンプレートマッチングによる限定的な認識 | 人・動物・物体など多様なカテゴリを高精度認識、顔認証・骨格検出も実現 |
| 音声認識 | 特定話者・単語辞書に依存、事前登録が必須 | 雑音分離・感情推定・リアルタイム音声テキスト変換が可能 |
| テキスト解析 | 数値・コード化データのマイニングに限定 | 大量の自然言語から意味・文脈・感情を抽出可能 |
各モダリティ単体の精度が上がった一方で、「単一の情報だけでは限界がある」という課題も明確になりました。画像だけでは「会話しているのか口論しているのか」が判断できない。音声だけでは「倒れているのか休んでいるのか」が区別できない。複数のモダリティを組み合わせて総合的に判断するマルチモーダルの必然性がここにあります。
マルチモーダルAIの技術的マイルストーン
| 時期 | 主なできごと |
|---|---|
| 2010年代前半 | ディープラーニングの台頭。画像認識コンテストILSVRCでCNNが圧倒的な精度を示す(エラー率26%→16%に激減) |
| 2010年代後半 | 画像キャプション生成(画像→テキスト)やVQA(Visual Question Answering)が研究されはじめる。Transformerアーキテクチャが登場し自然言語処理が飛躍的に向上 |
| 2021年 | CLIP・DALL-Eが登場。テキストと画像の相互変換・検索が飛躍的に向上。対照学習(Contrastive Learning)が画像-テキスト統合の主要手法に |
| 2023年 | GPT-4(視覚対応)・Google Gemini・LLaVA・Flamingo等のマルチモーダルLLMが一般公開。画像+テキスト入力が日常利用に |
| 2024〜2026年 | 音声・動画・3Dデータを含む広範なマルチモーダル統合が実用化段階へ。リアルタイム処理・エッジ推論・ローカル実行の普及が加速 |
現在は「モダリティを増やす」競争から「より深く・効率よく統合する」研究へと軸が移りつつあります。テキスト・画像・音声だけでなく、3Dポイントクラウド・触覚センサー・嗅覚センサーとの融合も研究されており、AIが扱える「感覚」の幅はさらに広がっています。ローカル環境でのマルチモーダル実行については マルチモーダルLLM ローカル で詳しく解説しています。
シングルモーダルとマルチモーダルの使い分け
マルチモーダルが優れているからといって、あらゆる用途でシングルモーダルより適しているわけではありません。処理するモダリティが増えるほど、計算コスト・推論レイテンシ・モデルサイズは増大します。
動きや音が含まれる動的なシーン・複合的な文脈判断が必要な業務はマルチモーダルに向いていますが、静止画の品質検査や単純なテキスト分類のようにモダリティが1種類で完結する業務では、シングルモーダルのほうが軽量・高速・低コストです。どのモードの情報をどう組み合わせるかを設計する力こそが、マルチモーダルAI活用のカギです。用途と予算・インフラに応じた選定が重要です。
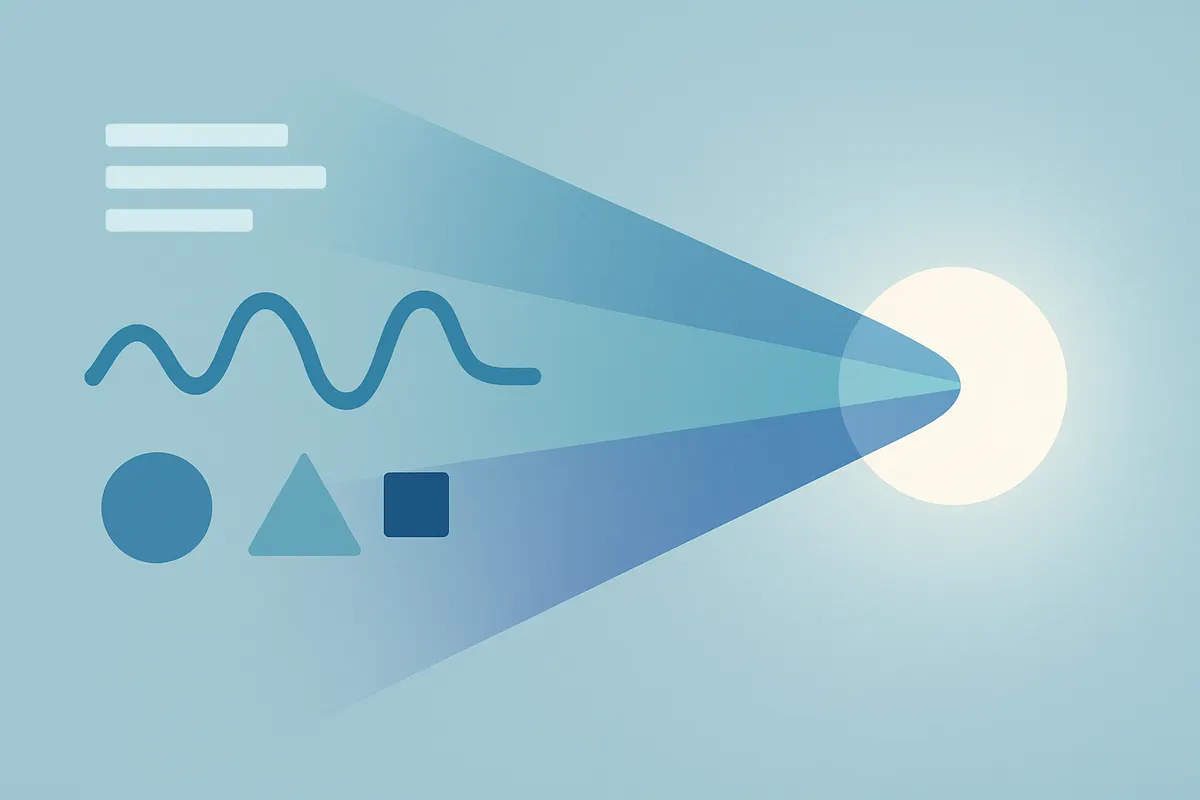
マルチモーダルAIは、テキスト・画像・音声など異なるモダリティを共通のベクトル空間へ埋め込み、Fusion(統合)して処理します。エンコーダ構成やEarly/Late Fusionなどアーキテクチャの詳細な仕組みは専用記事にまとめています。 詳細はマルチモーダルAIの仕組み・原理ガイドで解説しています。
今後――期待される7つの領域
マルチモーダルAIの発展は様々な産業領域に変革をもたらすことが予測されています。特に注目すべき領域について、2026年時点の動向を踏まえて考察します。前半の4つは産業分野、後半の3つ(AIエージェント・スマートグラスとXR・フィジカルAI)は、マルチモーダルAIの使われ方そのものが広がっていく方向です。
医療×マルチモーダル
医療分野はマルチモーダルが最もインパクトを発揮できる領域の一つです。医師はカルテの文字情報だけでなく、レントゲン・MRI・CT画像、血液検査の数値、患者の声や表情、問診内容など多様な情報を統合して診断しています。AIがこれを補助できれば、診断精度と医療効率を同時に高められます。
- カルテ・検査データ・医療画像を統合した早期疾患検出(がん・認知症など)
- 過去の患者データとの照合による治療方針の最適化提案
- 患者の表情・声のトーン・バイタルデータを組み合わせた疼痛・精神状態のモニタリング
- AIロボットによる遠隔診察補助(非接触での問診・基本診断)
なお、医療AIの導入にあたっては、薬機法・医療機器プログラム(SaMD)規制・個人情報保護法など関連法規の遵守が不可欠です。AIはあくまで医師の判断を補助するものであり、最終診断はヒトが行うという原則は2026年現在も変わりません。特に人手不足が深刻な地方医療・訪問診療においては、適切な規制枠組みのもとでのマルチモーダルAI活用が急務となっています。
工場・製造×マルチモーダル
すでにカメラ画像による検品や音声による機械診断は多くの工場で導入されていますが、今後はさらに統合的なスマートファクトリー化が進みます。ディープラーニングによって画像認識AIと音声認識AIの技術精度は条件の整ったベンチマークで高い水準が報告されており、これらを掛け合わせた予知保全・品質管理は実用段階にあります。
製造ロボットへの複合マルチモーダル搭載が進むことで、検品・組み立て・異常検知・在庫管理を一体的なシステムで担うことも現実的になっています。一方で、単純作業のAI代替が雇用構造を変えることも事実です。AIオペレーターやシステム保守の専門職需要が高まる一方、単純作業人員の減少が見込まれます。産業構造の変化に適応した人材育成が社会的課題として浮上しています。
コミュニケーション×マルチモーダル
AIが次のステージとして目指しているのが「自然なコミュニケーション」です。文脈を踏まえた柔軟な対話・感情の読み取り・非言語情報の解釈は、マルチモーダルなしには実現できません。
- 介護施設での傾聴・見守りロボット(高齢者の表情・声・バイタルの変化を検知)
- 企業受付・案内窓口での接客AI(来訪者の表情・声・要件を統合して対応)
- 教育支援での個別学習AI(学習者の集中度・理解度を表情・視線から推定)
- メンタルヘルスケアでの感情サポートAI(声のトーン・語句・表情から精神状態を把握)
「顔色を窺う」「空気を読む」という人間特有のコミュニケーションに近づくためには、目線・眉の動き・表情・声の強弱・抑揚・発言内容をマルチモーダルで総合判断することが不可欠です。
マーケティング×マルチモーダル
マーケティング領域では、これまで数値・テキストが中心だった顧客データ分析に、動画・音声・表情分析が加わることで、より多角的な顧客理解が可能になります。
- 顧客の行動分析:店舗内の動線・視線・立ち止まり行動の映像解析
- 感情ベースの満足度調査:インタビュー動画から表情・音声・語句を統合して満足度を定量化
- 広告効果測定:視聴者の表情反応・視線追跡データと購買行動の相関分析
- 売上予測の高度化:SNS投稿の画像・テキスト・エンゲージメントを組み合わせたトレンド予測
ただし、表情・感情データは個人情報・センシティブ情報に該当する可能性が高く、GDPR・個人情報保護法・AI倫理ガイドライン(経済産業省「AI事業者ガイドライン」など)への対応が不可欠です。収集・利用目的の明示、同意取得、データの適切な管理が求められます。
AIエージェント×マルチモーダル
AIエージェントとは、AIが画面を見て、自分で操作しながら複数の手順をこなす使い方です。画像(画面のスクリーンショット)を入力とし、クリックや文字入力といった操作を出力とするため、マルチモーダルAIの代表的な応用先になっています。たとえばAnthropicの公式ドキュメントでは、Claudeのコンピュータ操作ツールを「スクリーンショットの取得とマウス・キーボード操作を通じて、デスクトップを自律的に操作できる」ものと説明しています。一方で同じ公式ドキュメントは、専用の仮想マシンなど権限を絞った環境で使うこと、重要な判断は人が確認すること、Webページ内の指示に従ってしまう危険(プロンプトインジェクション)があることも注意点として挙げています。(出典:Claude公式ドキュメント「Computer use tool」(2026年10月20日確認))
スマートグラス・XR×マルチモーダル
カメラとマイクを備えたメガネ型の端末に、見たものと聞いた音をAIが理解して答える使い方が広がりつつあります。Googleは「Android XR」で、カメラ・マイク・スピーカーを備えたグラスにGeminiを載せ、「Geminiが見て聞いているものから文脈を理解できる」と説明しています。道案内、写真撮影、2人の会話のリアルタイム翻訳などのデモが公開されています。この発表は2025年のGoogle I/O時点のもので、発売時期や対応地域は公式で確認してください。(出典:Google公式ブログ「A new look at how Android XR will bring Gemini to glasses and headsets」(2026年10月20日確認))
フィジカルAI(ロボット)×マルチモーダル
フィジカルAIは、AIが現実の世界で体(ロボット)を動かす領域です。カメラの映像と人の指示(言葉)を入力とし、ロボットの動きを出力とするため、マルチモーダルの延長にあります。Google DeepMindは2026年7月30日、ロボット向けの「Gemini Robotics 2」ファミリーを発表しました。視覚と言語の入力をモーター制御に変えるVLA(視覚・言語・行動)モデルと、数分かかる複数手順の作業を計画する推論モデル「Gemini Robotics ER 2」などで構成され、ヒューマノイドや双腕ロボットの制御に対応するとしています。公式の記載では、ER 2はGoogle AI Studioで利用でき、VLAモデルは早期アクセスのパートナー向けです。(出典:Google DeepMind「Gemini Robotics 2 brings whole body intelligence to robots」(2026年7月30日・2026年10月20日確認))
自社の研究・開発事例――マルチモーダル感情認識・HALさん・IPO株価推定
クリスタルメソッドは、音声認識の技術をコミュニケーション分野に応用し、発話内容と声の調子(抑揚・強弱・話速など)を統合して感情を認識する技術の開発を進めています。「嬉しい」と言いながら声が沈んでいれば本心が異なる可能性があるため、音声の特徴量(MFCC・パワー・ピッチ)とテキストを組み合わせて分析します。音声認識・深層学習のサンプルはこちら(音のAI・深層学習)でご確認いただけます。
対話型AI「HALさん」は「ロボットをより人間に近づける」をテーマにした研究開発の代表例で、映像・音声・テキストを統合して判断する仕組みを組み込み、一定のオフィス業務を想定した開発を続けています(業務での実働水準は社内での確認段階です)。
また、人工知能学会 金融情報学会第20回で、音声・画像・テキストの3種類を統合した「IPO株価推定」の研究を発表しました。新規上場企業のインタビュー番組(ストックボイスTV)の動画から、登壇者の表情・声色・発話内容と株価変動の相関を検証したものです。日足では196社分でロジスティック回帰が53%の水準、1分足では138社分でXGBoostが最良ケースで70%の精度でしたが、すべての手法で過学習(学習データとテストデータの精度差)が見られました。
この研究から得た教訓は、マルチモーダルのデータが豊富でも、統合(フュージョン)の設計とデータの質・量のバランスがモデル性能を大きく左右するという点です。今後は発話を意味のまとまりで区切り直すこと、スライドのOCR、決算短信などとの組み合わせ、データ量の増加を課題としています。
よくある質問
マルチモーダルAIとは何ですか?
テキスト・画像・音声・動画など複数の種類の情報(モダリティ)を、ひとつのAIがまとめて受け取り、統合して処理するAIのことです。
ChatGPTはマルチモーダルAIですか?
OpenAIの公式ガイドで、モデルが画像入力を扱えることが案内されています。テキストと画像を同じ対話で扱えるため、マルチモーダルAIの一種です。対応する入力はモデルごとに異なります。
シングルモーダルAIとの違いは何ですか?
シングルモーダルAIは1種類の情報(例:テキストだけ)しか扱えません。マルチモーダルAIは複数の情報を組み合わせて判断できます。ただし、計算コストは増えやすくなります。
マルチモーダルAIは画像を作れますか?
製品によって異なります。たとえばClaudeは画像を理解する側で、画像の生成・編集はしないと公式ガイドに書かれています。画像を作るには、GPT Image系など生成用のモデルを使います。
無料で試せますか?
各社のチャットサービスに無料の枠があることが多いですが、内容は頻繁に変わります。最新の状況はマルチモーダルAI無料の記事と各社の公式ページで確認してください。
まとめ
マルチモーダルAIとは、テキスト・画像・音声・センサーデータなど複数種類の情報を統合して処理するAI技術です。人間が五感で状況を総合判断するのと同様のアプローチを取ることで、シングルモーダルでは不可能だった高精度な認識・判断を実現します。
ディープラーニングの進化によって各モダリティの認識精度が飛躍的に向上したことで実用化が加速し、2026年現在ではChatGPT・Gemini・Claudeなどのマルチモーダル対応のLLMが一般にも普及しています。防犯・製造・医療・自動運転・コミュニケーション・マーケティングなど応用領域は広大であり、今後も拡張し続けるでしょう。
一方で、計算コスト・データバイアス・プライバシーリスク・ハルシネーション・説明可能性の低さといった課題は現時点でも存在します。導入前に目的・データ・法規制・セキュリティ・運用設計を十分に検討し、ヒトによる監視プロセスをセットで設けることが信頼性の高い活用につながります。
感情認識・対話型AI「HALさん」・IPO株価推定研究など、独自のマルチモーダル開発・導入支援が継続的に推進されています。AIが人間と自然にコミュニケーションを取り、生活・業務のパートナーとして共存できる未来の実現に向けて、日々技術の深化に取り組んでいます。
マルチモーダルAIの開発・導入をご検討の方は、こちらからお気軽にお問い合わせください。
関連記事
LLM・ローカルLLMの業務導入をご検討の方へ
クリスタルメソッドは、オープンモデル・ローカルLLMの選定からRAG構築・PoC・本番導入までのAI開発を支援しています。「機密データを外部に出さずにLLMを使いたい」「自社の業務に合うモデルを選びたい」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-

マルチモーダルAIの仕組み・原理|複数情報をどう扱うか【2026年版】
現場知見:マルチモーダルAIの「出力側」で難所になる時間同期 マルチモーダルAIの解説は入力・融合の話が中心になりがちですが、バーチャルヒューマン「DeepAI...
-
マルチモーダルAI一覧|主要モデルとできること【2026年版】
マルチモーダルAI一覧:主要モデルと活用領域を徹底整理 「どのマルチモーダルAIを選べばいいか分からない」「画像・音声・動画それぞれに強いモデルを比べたい」――...
-
ローカルで動くマルチモーダルLLM|OSSモデルと始め方【2026年版】
マルチモーダルLLMをローカルで動かす完全ガイド――セットアップから実務活用まで 「画像も音声も扱えるマルチモーダルLLMを、クラウドに頼らず自社サーバーやPC...