
blog
AIブログ
強化学習入門 アルゴリズムから解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
掃除ロボットや自動運転、ゲームAI、ChatGPTのような対話AIまで、身近なところに強化学習の技術は広がっています。しかし「強化学習とは何か」と問われると、正確に説明できる人は多くありません。この記事では、強化学習の定義・アルゴリズム・活用事例・歴史・深層強化学習への進化まで、体系的にわかりやすく解説します。
強化学習とは
強化学習(Reinforcement Learning)とは、機械学習の手法のひとつであり、与えた目標に対して試行錯誤を繰り返しながらタスクを実行できるようになる学習手法です。
もう少し噛み砕くと、コンピュータに「目標(ゴール)」だけを与え、そのゴール達成に向けてAI自身が大量の試行錯誤を自律的に繰り返し、その過程で得たフィードバックをもとに最善の行動パターンを自動で構築していく技術です。あらかじめ正解データを与えるのではなく、「行動→結果→報酬」というサイクルを通じて学習が進む点が最大の特徴です。
人間の子どもが自転車の乗り方を覚えるプロセスに近いイメージです。最初は転びながらも、バランスのとり方を少しずつ体で覚え、最終的にはスムーズに乗れるようになります。強化学習はこれと同じ仕組みをコンピュータ上で実現します。
学んだ理論を実際のプログラムで動かすときは、Pythonによる機械学習の実装で解説しています。
機械学習の3つのカテゴリと強化学習の位置づけ
かつてコンピュータに何かをさせるには、人間がひとつひとつプログラムを書いて指示を出す必要がありました。しかし「自ら学習してプログラムを構築する」機械学習の登場により、自分で考えるAIが実現しました。機械学習は大きく次の3つに分類されます。
教師あり学習
学習データに人間が事前に正解ラベルを付与して学習させる。正解との一致度を基準に精度を高める。
教師なし学習
正解ラベルなしにデータの特徴や傾向をAI自身が発見する。クラスタリングや異常検知などに活用。
強化学習
目標(報酬)を最大化するため、行動→結果→フィードバックのサイクルをAI自身が繰り返して最適行動を学ぶ。
教師あり学習
教師あり学習とは、学習データに人間があらかじめ正解を与えた状態でAIを学習させる手法です。人間が付けた正解ラベルとAIの出力がどれだけ一致するかを基準に、パラメータを調整して精度を上げていきます。
たとえば、大量の郵便物の宛名を読み取り特定の都道府県だけを選別したいときや、画像内に写った動物の種類を分類したいときなどに有効です。正解データが豊富に用意できる問題に強みを発揮します。
教師なし学習
教師なし学習は、学習データに正解を与えない状態でAIを学習させる手法です。AIが過去データの特徴や傾向を自ら見つけ出し、判断や分類を行います。天気予報の精度向上や購買データを用いた売り上げ予測、顧客のセグメンテーションなどに用いられています。
3つの学習方式の比較表
| 項目 | 教師あり学習 | 教師なし学習 | 強化学習 |
|---|---|---|---|
| 学習に使うもの | 入力と正解ラベルのペア | 正解のない入力データ | 環境とのやりとりで得る報酬 |
| 目的 | 正解に近い出力を予測する | データの構造やパターンを見つける | 累積報酬を最大にする行動方針を学ぶ |
| 正解データ | 必要(人間が用意) | 不要 | 不要(報酬の設計が必要) |
| 代表的な用途 | 画像分類・需要予測 | 顧客のグルーピング・異常検知 | ゲームAI・ロボット制御・LLMの調整 |
このように機械学習の3手法にはそれぞれ得手不得手があり、解きたい問題の性質に合わせて使い分けることで、最短・最適な解を導き出すことができます。強化学習は特に「正解データを用意しにくいが、試行錯誤できる環境がある」問題で真価を発揮します。
次に読む:機械学習の種類とアルゴリズムは?
基本用語(エージェント・環境・状態・行動・報酬・方策)
強化学習の説明には、決まった用語が登場します。ここを押さえると、論文や解説記事が読みやすくなります。迷路を進むロボットを例に整理します。
| 用語 | 意味 | 迷路ロボットの例 |
|---|---|---|
| エージェント(Agent) | 学習して行動する主体 | ロボット本体 |
| 環境(Environment) | エージェントが行動する世界 | 迷路 |
| 状態(State) | 環境の今の状況 | ロボットの現在位置 |
| 行動(Action) | エージェントが選べる操作 | 上・下・左・右に1マス進む |
| 報酬(Reward) | 行動の結果として受け取る点数 | ゴールで+1、壁にぶつかると-1、1歩ごとに少しマイナス |
| 方策(Policy) | 状態に応じてどの行動を選ぶかのルール | 「この位置なら右へ進む」という方針 |
| 価値(Value) | その状態や行動から将来得られる報酬の見込み | 「ここからならゴールに近い」という評価 |
学習のゴールは、目先の報酬ではなく将来にわたる累積報酬が最大になる方策を見つけることです。1歩ごとに少しマイナスの報酬を与えておけば、遠回りせず最短でゴールへ向かう方策が選ばれやすくなります。
仕組み(学習サイクル)と代表的なアルゴリズム
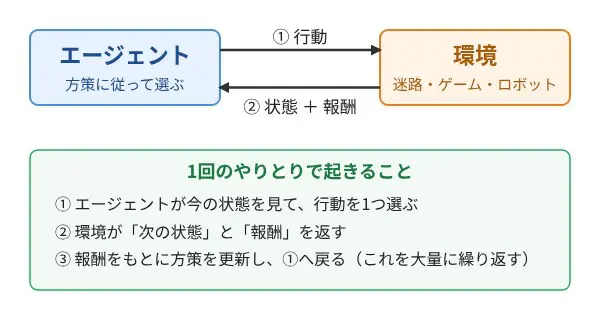
強化学習は、ある「環境(Environment)」の中でエージェント(Agent)が行動を選択し、その結果として「報酬(Reward)」を受け取り、将来の累積報酬を最大化できるよう行動方針(Policy)を更新していく仕組みです。
一度行動してみてその結果を評価し、より良い結果を目指してまた行動する――このサイクルを膨大な回数繰り返すことで、AIは瞬時に最良の行動を選択できるようになります。
強化学習の基本サイクルを図で示すと次のようになります。
↑ Reward(報酬)+ State(状態)
エージェントは行動を実行 → 環境が状態と報酬を返す → エージェントがPolicyを更新 → 繰り返し
カーナビゲーションシステムを例にとると、仕組みがよりイメージしやすくなります。
- Agent(カーナビ)はPolicy(辿るルート方針)に基づいてAction(ルートを選択・進む)を実行する
- その結果に応じてReward(報酬:所要時間の短縮など)を獲得する
- PolicyとActionが更新され、次のステップへ移行する
- Rewardを最大化するPolicy・Actionを見つけるまで1〜3を繰り返す
目標地点まで無数のルートを瞬時に評価し、最短・最適なルートを導き出すカーナビの動作は、まさに強化学習の典型的な応用例です。
代表的なアルゴリズムの種類
強化学習にはこのような基本構造のほかに、複数の代表的なアルゴリズムが存在します。
| アルゴリズム | 概要 | 特徴・用途 |
|---|---|---|
| DP法(動的計画法) | 環境のモデル(状態遷移確率)が既知の場合に、最適方策を計算で求める手法 | 理論的に最適解が得られるが、環境モデルが必要 |
| MC法(モンテカルロ法) | 実際にエピソードを最後まで経験し、得られた報酬の累積から価値を推定する手法 | モデル不要。エピソードが完結する問題に向く |
| TD法(時間差分学習) | 1ステップごとに価値推定を更新する手法。Q学習やSarsaが代表例 | リアルタイム更新が可能。実用的な場面で広く使われる |
| Q学習 | TD法のひとつ。状態と行動の組み合わせに価値(Q値)を与え更新していく | 深層学習と組み合わせたDQNに発展。ゲームAIで実績多数 |
| 方策勾配法 | 行動方針(Policy)を直接パラメータとして学習する手法 | 連続的な行動空間を持つロボット制御などに向く |
マルコフ決定過程・割引率・ベルマン方程式(数式の入口)
強化学習を数式で扱うときの土台がマルコフ決定過程(MDP)です。離散的なタイムステップごとに「状態を見る→行動を選ぶ→新しい状態へ移る→報酬を受け取る」を繰り返す意思決定を数学的にモデル化する枠組みで、強化学習の基礎になっています(出典:IBM「強化学習とは」https://www.ibm.com/jp-ja/think/topics/reinforcement-learning 、Amazon Web Services https://aws.amazon.com/jp/what-is/reinforcement-learning/ 、2026年10月29日確認)。
| 言葉 | 意味 | ひとこと |
|---|---|---|
| 状態空間・行動空間 | 取りうる状態の全体、状態ごとに選べる行動の集合 | 迷路なら「全マス」と「上下左右」 |
| 収益(累積報酬) | 将来にわたって受け取る報酬の合計 | 学習の目標はこれを最大にすること |
| 割引率(γ) | 将来の報酬をどれだけ割り引いて評価するかを決める0〜1の係数 | 0に近いほど目先重視、1に近いほど将来重視 |
| 価値関数 | ある状態(または状態と行動の組)から先に得られる報酬の期待値 | 「ここからならどれだけ稼げるか」 |
| ベルマン方程式 | ある時点の状態の価値を、即時の報酬と将来の期待報酬の合計として表す式 | 動的計画法やQ学習の更新式の出発点 |
Q学習やDP法の更新式は、すべて「今の価値の見積りを、ベルマン方程式が示す値に少しずつ近づける」という発想で説明できます。最初は式を暗記せず、「報酬を割り引きながら将来まで足し合わせる」という意味だけ押さえれば十分です。
種類の分け方(価値ベース・方策ベース・モデルフリー)
「強化学習 種類」で調べる人が知りたいのは、手法がどんな軸で分類されるかです。代表的な軸は次の3つです。
| 分け方 | 種類 | ポイント | 代表例 |
|---|---|---|---|
| 何を学ぶか | 価値ベース | 状態や行動の価値を学び、価値が高い行動を選ぶ | Q学習、DQN |
| 方策ベース | 行動を選ぶ方策そのものを直接学ぶ。連続的な行動に向く | 方策勾配法 | |
| Actor-Critic | 方策(Actor)と価値(Critic)を両方学び、安定性を高める | PPOなど | |
| 環境のモデルを使うか | モデルベース | 環境の仕組み(状態遷移)を使って先読みする | 動的計画法(DP法) |
| モデルフリー | 環境の仕組みを知らなくても、経験から学ぶ | MC法、TD法、Q学習 | |
| 学習に使うデータ | オンポリシー | 今の方策で集めたデータだけで更新する | PPO、Sarsa |
| オフポリシー | 過去の方策や別の方策で集めたデータも使って更新できる | Q学習、DQN |
近年よく名前が挙がるPPO(Proximal Policy Optimization)は、方策勾配系のオンポリシー手法で、方策が一度に大きく変わりすぎないよう更新幅を抑える工夫(クリッピング)を持つのが特徴です(出典:OpenAI Spinning Up「Proximal Policy Optimization」https://spinningup.openai.com/en/latest/algorithms/ppo.html 、2026年10月29日確認)。
Q学習とSarsaの違い(オフポリシーとオンポリシー)
価値ベースの代表であるQ学習とSarsaは、更新式の「次の行動の価値」の取り方だけが違います。Sutton と Barto の教科書では、Sarsaは次の状態で実際に選んだ行動A′の価値Q(S′,A′)を使うオンポリシー、Q学習は次の状態で価値が最大の行動を使うオフポリシーとして説明されています。Q学習で学習される行動価値は、実際に従っている方策に関係なく最適な行動価値を直接近似する、とも書かれています。
| 手法 | 更新式で使う次の価値 | 性質 |
|---|---|---|
| Sarsa | Q(S′, A′)(ε-greedyなどで実際に選んだ行動) | 探索中の行動も含めて学ぶオンポリシー。探索で失敗しうる分も価値に反映される |
| Q学習 | max Q(S′, a)(最大の価値の行動) | 実際の行動方針と切り離して最適な価値を学ぶオフポリシー。過去のデータも使える |
2015年にはDeepMindがQ学習を深層学習と組み合わせたDQNを発表し、Atariの多数のゲームを画面のピクセルだけから学習しました。初期の2013年の論文では、7つのAtariゲームのうち6つで従来手法を上回り、3つで人間の専門家を超えたと報告されています。
出典:Sutton・Barto「Reinforcement Learning: An Introduction」第6章(講義スライド)、Mnihら「Playing Atari with Deep Reinforcement Learning」(arXiv:1312.5602)、2026年10月29日確認。
探索と活用のトレードオフ:ε-greedy法・ボルツマン選択
強化学習では、すでに報酬が高いとわかっている行動を選ぶ「活用」と、まだ試していない行動を試す「探索」のバランスが性能を左右します。探索が多すぎると方策が収束しにくく、活用が多すぎると局所的な解にとどまる恐れがあります。学習初期は探索を多めにし、学習が進むにつれて活用を増やすのが合理的だとされています(出典:MathWorks「強化学習」https://jp.mathworks.com/discovery/reinforcement-learning.html 、2026年10月29日確認)。
| 手法 | 行動の選び方 | 特徴 |
|---|---|---|
| ε-greedy法 | 小さな確率ε(例:10%)でランダムに行動し、残りは価値が最も高い行動を選ぶ | 実装が簡単。εを学習の進行に合わせて小さくする使い方が一般的 |
| ボルツマン選択(ソフトマックス) | 価値が高い行動ほど高い確率で選ぶ。温度パラメータで偏りを調整する | 価値の差を反映して選べる。温度が高いとほぼランダム、低いと価値最大の行動に近づく |
どちらも強化学習の教科書で扱われる基本的な方法です。迷路の例で言えば、いつも同じ最短経路ばかり通る(活用)だけでは、もっと近道があっても見つけられません。
深層強化学習とは(ディープラーニングとの組み合わせ)
1950年代から研究されてきた強化学習ですが、ディープラーニング(深層学習)の登場によって大きなターニングポイントを迎えました。
ディープラーニングとは、人間の神経細胞(ニューロン)の仕組みを模したニューラルネットワークを多層に重ねることで、画像・音声・テキストなど複雑なデータから特徴を自動的に抽出できる機械学習の手法です。
従来の強化学習は、状態と行動の組み合わせを表にまとめた「Qテーブル」で管理していました。しかし状態の数が爆発的に増えるゲームや実世界の問題では、テーブルが巨大になりすぎて現実的に扱えないという課題がありました。
そこにディープラーニングを組み合わせた深層強化学習(Deep Reinforcement Learning)は、ニューラルネットワークを「Q値の近似関数」として使うことで、膨大な状態空間にも対応できるようになりました。これがDeepMindのDQNに代表される手法であり、Atariのビデオゲームをピクセル画像だけの入力で人間超えの成績で攻略したことで世界を驚かせました。
深層強化学習の登場により可能になったことを整理すると、次のとおりです。
- 高次元な状態(画像・センサーデータなど)を直接入力として扱えるようになった
- 連続的な行動空間(ロボットの関節角度など)への対応が可能になった
- これまで不可能だった複雑なゲームや実世界のロボット制御で人間水準・人間超えを達成
- 自然言語処理や対話AIなど、従来の強化学習が苦手とした分野にも応用が広がった
飛躍的な性能向上と適用範囲の拡大により、ゲーム・ロボット・自動運転・医療・金融・エネルギー管理など、現在では実に多様な分野にAIが組み込まれるようになったのです。
オンライン学習とオフライン学習・マルチエージェント
強化学習は、データの集め方や登場するエージェントの数でも分けられます(出典:MathWorks https://jp.mathworks.com/discovery/reinforcement-learning.html 、2026年10月29日確認)。
| 種類 | 内容 | 向く場面 |
|---|---|---|
| オンライン強化学習 | 環境とやりとりしながら、その場で経験を集めて学ぶ | 安全で高速なシミュレーションがある場合 |
| オフライン強化学習 | 環境とやりとりせず、記録済みの経験(人間のデモや過去の方策のデータ)だけから学ぶ | 現実世界でのやりとりにコストや危険が伴う場合。オンライン学習の前の事前学習にも使われる |
| マルチエージェント強化学習 | 複数のエージェントが同じ環境で相互作用しながら学ぶ | 協調・交渉が必要な複雑なタスク。環境が刻々と変わるため学習が不安定になりやすい |
活用事例:ゲーム・自動運転・ロボット・対話AI
強化学習はゲームAIや自動運転、ロボット制御など多岐にわたる分野で実績を上げています。特に注目度の高い事例を紹介します。
AlphaGo・AlphaZero(囲碁・チェス・将棋)
強化学習の活用事例として最も世界的に有名なのが、Google傘下のDeepMind社が開発した囲碁AIのAlphaGoです。人間棋士の棋譜データをもとに学習し、さらに自分自身と数千万回もの対戦を繰り返すことで最適な一手を打てるようになりました。
2016年には世界トップ棋士のイ・セドル九段に完勝し、世界に衝撃を与えました。囲碁は一局の中で選択しうる手の組み合わせが10の170乗を超えるとも言われ、「コンピュータが人間を超えることは不可能」とさえ言われていた分野でした。AlphaGoの勝利はその常識を覆した歴史的な出来事です。
その後に登場したAlphaZeroは、人間の棋譜すら使わず自己対戦のみで囲碁・チェス・将棋すべてにおいて従来の最強AIを超える性能を達成。純粋な強化学習の威力を証明しました。
自動運転
強化学習は自動運転の分野でも実用的な成果を上げています。Preferred Networks社では、車が密集した交差点でのミニカーを用いた自動運転実験において強化学習を採用しました。周囲の全方向の状況を同時に把握できるため、前方だけでなく後方にも正確に移動制御が可能になり、「ぶつからない車」として展示でも大きな注目を集めました。
自動運転において強化学習が特に有効なのは、交差点や合流地点のような複雑な状況判断です。あらかじめすべてのシナリオを人手でプログラムするのは現実的ではなく、AI自身が試行錯誤を繰り返して最適な判断を学んでいく強化学習のアプローチが威力を発揮します。
ロボット制御・物体把持
工場の自動化やサービスロボットの分野でも、強化学習は不可欠な技術になっています。特に「掴む・持つ」という物体把持の動作は、対象物の形状・重さ・素材が多様なため、固定的なプログラムでは対応しきれません。
物体把持の研究では、アームやロボットハンドが自律的に試行錯誤を繰り返すことで、柔らかい物体・不規則な形状の物体・人間が持てない高温の物や重量物など、多様な条件下での把持動作を習得させる取り組みが進んでいます。自動車組み立ての自動化、部屋の片づけロボット、人間では扱えない素材の搬送など、製造・生活支援の幅広い領域が応用先です。詳しくは後段の「物体把持(ロボット制御)の応用領域」で整理しています。
自然言語処理・対話AIへの応用
近年では、ChatGPTをはじめとする大規模言語モデルの学習にも強化学習が組み込まれています。特にRLHF(人間のフィードバックを用いた強化学習)と呼ばれる手法が注目されており、人間の評価者が「良い回答」「悪い回答」を採点し、その報酬シグナルをもとにAIが応答の質を高めていく仕組みです。これにより、単に文章を生成するだけでなく、有害な内容を避けたり、より有益な回答をする方向へAIの行動を誘導できます。
AIの業務導入をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
物体把持(ロボット制御)の応用領域
強化学習の応用が特に広がっている分野のひとつが、機械制御による物体把持です。
物体把持とは、アームやロボットハンドが対象物を「掴む・持つ・運ぶ」という動作全般を指します。一見シンプルに見えますが、対象物の形状・重さ・柔らかさ・滑りやすさが毎回異なる実環境では、あらかじめすべての状況をプログラムで定義することは不可能に近く、強化学習による自律的な習得が不可欠です。
代表的な応用先は次のとおりです。
- 自動車組み立て工程の自動化:複数の部品を正確に組み付けるロボットアームの制御
- 生活支援ロボット(片づけロボット):形状が不規則な日用品を認識して把持・整理する機能
- デリケートな素材への対応:人間の手では持ちにくい柔らかさや壊れやすさの物体を適切な力加減で把持する技術
- 危険環境での代替作業:人間が持ち上げられない重量物や高温・有害物質の取り扱い
強化学習によって機械が自律的に「どのくらいの力で、どの角度から掴むか」を学習し続けることで、工場の生産効率向上だけでなく、高齢化社会における生活支援や、人間には危険な作業環境での代替作業の実現に貢献することが期待されます。
ゲーム・ロボット以外の活用事例(金融・広告・物流・クラウド費用)
強化学習は、ゲームやロボットだけでなく、次のような分野でも使われています(出典:Amazon Web Services https://aws.amazon.com/jp/what-is/reinforcement-learning/ 、SHIFT AI https://service.shiftinc.jp/column/14471/ 、MathWorks https://jp.mathworks.com/discovery/reinforcement-learning.html 、2026年10月29日確認)。
| 分野 | 強化学習でやること |
|---|---|
| 金融(取引・財務予測) | 市場データをもとに売買のタイミングを最適化し、利益を最大化する取引戦略を作る。金融市場は統計的な性質が時間とともに変わるため、取引コストを考慮しながら市場の変化に適応し、長期的なリターンの最適化を図る |
| Web広告・レコメンド・マーケティング | 個々のユーザーとのやりとりに応じて提案を調整する。広告ごとの反応を重ねるうちに、どの広告を誰に見せるべきかを学習し、販売の最適化につなげる |
| 製造・物流 | 工場ラインの人員配置、配送ルートの最適化、倉庫内の動線改善を仮想環境のシミュレーションで最適化する。工場の搬送ロボットでは、運用を重ねるごとに移動経路や判断ロジックが改善される |
| クラウド費用の最適化 | 変動するリソース需要に対応するため、利用可能なインフラ・支出・利用率を踏まえて、インスタンスの種類・数量・設定を選ぶ |
| スケジューリング・制御・設計 | 信号制御や工場内のリソース調整、エンジンや生産ラインの調整、レーダー設計やチップ配置などの最適化に使う |
共通するのは「1回の選択の結果が後の状況に影響し、長期の成果で評価したい」という性質です。単発の予測で済む問題は教師あり学習のほうが向いています。金融のように環境が変わり続ける分野では、過去データで学んだ方策がそのまま通用しない点にも注意が必要です。
LLM時代の強化学習(RLHF・RLVR・GRPO・Agentic RL)
近年、強化学習はロボット制御やゲームAIだけでなく、大規模言語モデル(LLM)の学習プロセスにも組み込まれるようになりました。代表的なのが「RLHF(Reinforcement Learning from Human Feedback)」で、人間の評価をもとに報酬モデルを構築し、その報酬を最大化する方向にLLMの出力方針を調整する手法です。さらに、数学やコードのように正解・不正解を機械的に判定できるタスクでは、人間の評価の代わりにルールベースの検証結果を報酬として使う「RLVR(Reinforcement Learning from Verifiable Rewards)」が用いられ、推論能力を伸ばすモデル(Reasoning系モデル)の学習で採用が広がっています。学習アルゴリズムの面では、方策の更新に用いる目的関数を効率化した「GRPO(Group Relative Policy Optimization)」のような手法も登場しています。また、LLM自身が計画・実行・修正のループを繰り返しながらタスクを遂行する「Agentic RL」も研究が進む領域です。
ロボット制御における強化学習は、実環境またはシミュレーション環境との試行錯誤を通じて方策を獲得する点が特徴です。これに対しLLMのRLHF/RLVRは、あらかじめ大量のテキストで事前学習されたモデルの出力方針を、追加の報酬信号で微調整するという点で前提が異なります。一方で「報酬をどう設計するか」「どの粒度で報酬を与えるか」という設計上の課題は、ロボット制御・LLMのどちらの強化学習にも共通する論点です。
強化学習を導入するときの進め方(環境定義から展開まで)
実際の課題に強化学習を使うときの流れは、次の5段階で説明されています(出典:MathWorks https://jp.mathworks.com/discovery/reinforcement-learning.html 、2026年10月29日確認)。
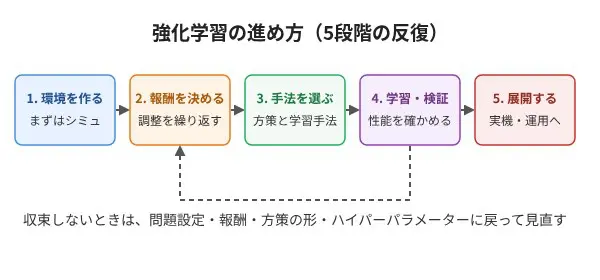
- 環境を作る:シミュレーションモデルか実物理システムを用意する。まずはシミュレーションから始めるのが推奨されています。
- 報酬を定義する:目標に対する性能を測る報酬信号を設計する。反復が必要になることが多い工程です。
- エージェントを作る:方策の表現(ニューラルネットワークやルックアップテーブルなど)と学習アルゴリズムを選んで調整する。
- 学習と検証:停止条件などを設定して学習し、学習後に方策の性能を確かめる。
- 方策を展開する:学習済みの方策を組み込み機器や運用システムへ載せる。
学習が最適な方策に収束しないときは、問題の定義・報酬・方策の形・ハイパーパラメーターに戻って見直します。
試してみる(Python・Gymnasiumの入門)
強化学習は、ライブラリの練習用環境を使うと手元で動かせます。Gymnasiumは、単一エージェントの強化学習環境に共通のAPIを提供するPythonライブラリで、CartPole(カートの上の棒を倒さずに釣り合わせる環境)など代表的な環境が含まれています(出典:Gymnasium公式ドキュメント https://gymnasium.farama.org/introduction/basic_usage/ 、2026年10月29日確認)。
- 環境を作る:
env = gymnasium.make("CartPole-v1") - 初期化する:
observation, info = env.reset()で最初の状態(observation)を受け取る - 行動を送る:
observation, reward, terminated, truncated, info = env.step(action)で、行動後の状態と報酬が返る - 終わりを判定する:
terminated(成功・失敗による終了)かtruncated(時間切れによる打ち切り)が True になったら、env.reset()で次のエピソードを始める
最初はランダムに行動を選ぶだけで構いません。「状態を見る→行動する→報酬が返る」というやりとりが、先の用語表そのものであることを確認できます。そのうえで、Q学習やPPOなどのアルゴリズムに置き換えて、報酬が増えていく様子を観察するのが学習の流れです。体系的に学ぶ入門書としては、前述のサットン教授らの教科書『Reinforcement Learning: An Introduction』が定番です。
メリットと、実問題で直面する課題(報酬設計・サンプル効率・安全性・シミュレーションと現実の差)
強化学習は「報酬を最大化するように試行錯誤する」という明快な仕組みで、次のような強みがあります。
- 正解ラベルが不要で、人間の好みや修正といったフィードバックも報酬として取り込める
- 多くのルールや依存関係がある複雑な環境でも、変化に適応して戦略を見つけられる
- 目先ではなく長期的な報酬の最大化を狙うため、結果が後から出る問題に向く
一方、実際の課題に当てはめると、教師あり学習にはない固有の難しさに直面します。次の表は、公式の解説と学術論文で挙げられている課題を、実務での現れ方とあわせて整理したものです。
| 課題 | 何が起きるか | よく取られる対処 |
|---|---|---|
| 報酬設計(報酬ハッキング) | 目標を報酬の式に落とすときに抜け道があると、AIが本来の目的を無視して報酬だけを稼ぐ。OpenAIが公開したボートレースゲームCoastRunnersの例では、ゴールを目指さず、同じ場所を回りながら再出現するターゲットを倒し続けるほうが高い得点になった | 報酬を複数の指標で設計する、挙動を目視で確認する、人間の評価を報酬に取り込む |
| サンプル効率 | 試行錯誤で学ぶため、良い方策に届くまでに膨大な試行が要る。実機で試せる回数は限られる | シミュレーションで大量に学習する、過去のログから学ぶオフライン強化学習を使う |
| 探索と活用 | 既知の良い行動だけ繰り返すと改善できず、探索ばかりだと成績が安定しない | ε-greedy法で探索の割合を学習の進みに合わせて減らす |
| 安全性(安全な探索) | 学習中の試行錯誤そのものが危険になる。実機のドローンで失敗すると機体を損傷するおそれがある | 危険な行動を制約として禁止する、まずシミュレーション上で学習する |
| シミュレーションと現実の差 | シミュレーションで学んだ方策が、現実の機器では摩擦・ノイズ・見た目の違いのためにうまく動かないことがある(sim2real、リアリティギャップ) | ドメインランダマイゼーション(シミュレーションの見た目や条件をランダムに変えて学習する)で現実を「変化の1つ」にする |
| 解釈性 | どの行動が結果につながったのかを人が説明しにくく、運用担当者が方策を信頼しにくい | 行動のログと報酬の内訳を残す、説明可能な手法を併用する |
| 再現性・学習の不安定さ | 深層強化学習は同じ手法でも、環境の非決定性や手法そのもののばらつきのため、結果の再現や比較が簡単ではない | 乱数の種を変えて複数回実行し、平均とばらつきで評価する |
| 遅延・観測の欠け | 報酬が遅れて返る、状態の一部しか観測できないなど、現実のシステムは理想的な設定と違う | 遅延を考慮した設計、過去の観測を入力に含める |
学習にかかる時間と計算リソースの目安
強化学習は試行錯誤の回数がそのまま計算コストになるため、「どれくらいの時間と計算機が要るのか」は導入前に最も気になる点です。論文・公式発表で公開されている数字を並べると、規模は次のように大きく3段階に分かれます。
| 題材 | 公開されている学習規模 | 出典 |
|---|---|---|
| DQN(Atari、2013年の論文) | 10 million(1,000万)フレームを学習。直近100万フレームを再生用メモリに保持 | Mnihら, Playing Atari with Deep Reinforcement Learning |
| AlphaZero(チェス・将棋・囲碁、2017年の論文) | 70万ステップ(ミニバッチ4,096)。自己対局の生成に第1世代TPU 5,000個、ニューラルネットの学習に第2世代TPU 64個。チェスは約4時間(30万ステップ)でStockfishを、将棋は2時間未満(11万ステップ)でElmoを、囲碁は8時間(16.5万ステップ)でAlphaGo Leeを上回った。比較対象のAlphaGo Zeroは3日間の学習 | Silverら, Mastering Chess and Shogi by Self-Play with a General Reinforcement Learning Algorithm |
| OpenAI Five(Dota 2、2018〜2019年) | 2018年6月30日から2019年4月22日までの1回の学習実行。約10か月(再起動や巻き戻しを除く学習は180日)、計算量は770±50 PFlops/s・日。ピーク時のオプティマイザGPUは最大1,536個 | Berner ら, Dota 2 with Large Scale Deep Reinforcement Learning |
上の表は研究機関が専用の大規模計算機で行った例であり、個人や企業の現場で同じ規模が必要になるわけではありません。個人が試す入門用の環境は規模がまったく異なります。たとえばStable-Baselines3の公式クイックスタートではmodel.learn(total_timesteps=10_000)、PPOのページの例ではtotal_timesteps=25_000といった桁の学習ステップ数が使われています。PPOのドキュメントには、画像を使わない(CNNを使わない)場合は主にCPUでの実行を想定しており、GPUをオフにしてCPUで動かす書き方も紹介されています。
実務では、シミュレーターを何台並列に動かせるか、1回の試行にどれだけ時間がかかるか(実機を使うのか、ソフトウェア上のシミュレーションか)で、学習時間とクラウド費用が大きく変わります。学習時間を見積もるには、まず小さい環境で1,000〜1万ステップほど試し、1ステップあたりの所要時間を測るのが確実です。この「1,000〜1万ステップ」は試し方の一例であり、公式資料に書かれた数字ではありません。
出典(2026年10月29日確認):Mnihら, Playing Atari with Deep Reinforcement Learning(2013)/Silverら, Mastering Chess and Shogi by Self-Play(DeepMind、2017)/OpenAIら, Dota 2 with Large Scale Deep Reinforcement Learning(2019)/Stable-Baselines3 ドキュメント Getting Started/同 PPO
実世界へ強化学習を持ち込む際の課題は、Dulac-Arnoldらが論文「Challenges of Real-World Reinforcement Learning」で9つに整理しています。固定のログからのオフライン学習、限られたサンプルでの実システム上の学習、高次元の連続的な状態・行動空間、決して(またはほとんど)破ってはならない安全制約、部分観測・非定常・確率的なタスク、未指定・多目的・リスク感応の報酬、説明可能な方策の要求、制御周波数でのリアルタイム推論、アクチュエータ・センサ・報酬の大きな/未知の遅延、です。
AI安全性の分野でも、Amodeiらの論文「Concrete Problems in AI Safety」が、副作用の回避・報酬ハッキングの回避・スケーラブルな監督・安全な探索・分布シフトの5つを実用的な研究課題として挙げています。AlphaGoのような成功の裏にも、丁寧な報酬設計と大量の試行を支える計算資源があります。強化学習を「魔法の技術」ととらえず、目的を報酬として正しく表現でき、安全に試行錯誤できる環境があるかという観点で適用可否を見極めることが、実務の出発点になります。
出典(2026年10月29日確認):Amazon Web Services「強化学習とは何ですか?」/Dulac-Arnoldら, Challenges of Real-World Reinforcement Learning(2019)/Amodeiら, Concrete Problems in AI Safety(2016)/OpenAI, Faulty reward functions in the wild/Tobinら, Domain Randomization(2017)/Hendersonら, Deep Reinforcement Learning that Matters
歴史:最適制御からAlphaGo・RLHFまで
強化学習の起源は古く、機械の自律的制御を目指す「最適制御」の研究として1950年代にはその原型が存在していました。
その後、1980〜1990年代にかけてカナダ・アルバータ大学のリチャード・サットン(Richard Sutton)教授らが理論を体系化し、「強化学習の父」と呼ばれるようになりました。サットン教授が著したテキスト『Reinforcement Learning: An Introduction』は現在も基本教科書として世界中で読まれています。
1990年代には時間差分学習(TD学習)やQ学習が確立され、理論的な基盤が整いました。しかし当時は扱えるデータ量や計算資源の限界から、実用的な応用は限られていました。
2010年代に入りディープラーニングが台頭すると、強化学習との組み合わせ「深層強化学習」が誕生し、飛躍的な性能向上が実現。AlphaGoの衝撃的な勝利(2016年)がその到達点を世界に示しました。
| 時代 | 主な出来事 |
|---|---|
| 1950年代 | 最適制御理論として原型が誕生。動的計画法(DP)の基礎が形成される |
| 1980〜90年代 | サットン教授らが理論を体系化。TD学習・Q学習が確立される |
| 2013年 | DeepMindがDQN(Deep Q-Network)を発表。Atariゲームで人間超えを達成 |
| 2016年 | AlphaGoが世界トップ囲碁棋士に完勝。深層強化学習の威力を世界に証明 |
| 2017年〜 | AlphaZeroが自己対戦のみで囲碁・チェス・将棋すべてで最強AIを更新 |
| 2022年〜現在 | RLHFがChatGPT等の大規模言語モデルに組み込まれ、対話AIの品質向上に貢献 |
よくある質問
Q. 強化学習とは何ですか?
A. 与えられた目標(報酬)を最大にするために、AI(エージェント)が環境の中で行動と結果を繰り返し、試行錯誤しながら最適な行動方針を学ぶ機械学習の手法です。正解データを事前に用意しない点が特徴です。
Q. 強化学習と教師あり学習・教師なし学習の違いは何ですか?
A. 教師あり学習は正解ラベル付きのデータ、教師なし学習は正解のないデータから学びます。強化学習は正解ラベルではなく、行動の結果として得られる報酬を手がかりに学びます。
Q. 強化学習にはどんな種類がありますか?
A. 代表的な分け方に、価値を学ぶ「価値ベース(Q学習など)」、行動方針を直接学ぶ「方策ベース(方策勾配法)」、両者を組み合わせた「Actor-Critic」があります。環境のモデルを使うかどうかで「モデルベース/モデルフリー」にも分けられます。
Q. 深層強化学習とは何ですか?
A. 強化学習の価値や方策の計算にディープラーニング(ニューラルネットワーク)を使う手法です。画像のような高次元な入力や連続的な行動も扱えるようになり、Atariゲームの攻略や囲碁AIの AlphaGo などで成果を上げました。
Q. 強化学習はどんな場面で使われていますか?
A. ゲームAI、自動運転、ロボット制御(物体把持など)、そしてChatGPTのような大規模言語モデルの調整(RLHFやRLVR)などで使われています。
Q. 強化学習を自分で試すにはどうすればよいですか?
A. Pythonの強化学習用ライブラリ Gymnasium に、CartPole などの練習用環境が用意されています。まずは行動をランダムに選ぶプログラムを動かして、環境・行動・報酬のやりとりを確認するのが入門の第一歩です。
まとめ
この記事では強化学習について、定義から始まり、アルゴリズムの仕組み・活用事例・歴史・深層強化学習への進化まで体系的に解説しました。
強化学習の要点を改めて整理すると次のとおりです。
- 強化学習は機械学習の一手法であり、「行動→報酬→Policy更新」のサイクルで最適行動を自律的に学ぶ
- 教師あり学習・教師なし学習とは異なり、正解データが不要で、試行錯誤できる環境があれば機能する
- アルゴリズムにはDP法・MC法・TD法(Q学習など)・方策勾配法などがある
- AlphaGo、自動運転、ロボット制御、大規模言語モデル(RLHF)など幅広い分野で実用化が進んでいる
- ディープラーニングとの融合で誕生した深層強化学習が、複雑な実問題への適用を可能にした
- 今後もロボティクス・医療・自然言語処理など多くの分野でさらなる応用拡大が期待される
機械学習から発展し、ディープラーニングとの融合によって一気に高精度化した強化学習は、現在も急速に進化を続けています。AIが自ら試行錯誤して最適解を学び取る技術は、生活・産業・社会のあらゆる場面に浸透しつつあります。この記事が強化学習への理解を深めるきっかけになれば幸いです。
AIの業務活用をご検討の方へ
クリスタルメソッドは、バーチャルヒューマンをはじめAIの開発・業務導入を支援しています。生成AI・AIエージェントの活用や、自社業務へのAI導入をご検討の際は、お気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-

Pythonを使って機械学習を実装する
機械学習は、膨大なデータから法則性を見つけ出し自律的に学習する技術です。近年ではビジネス・研究・サービス開発など幅広い領域で活用されており、その実装手段としてP...
-
【入門】機械学習とは?種類やアルゴリズムをわかりやすく解説!
機械学習(Machine Learning)は、AIを語るうえで欠かせない中核技術です。スマートフォンの顔認証やNetflixのレコメンド、ChatGPTの回答...
-
ディープラーニング(深層学習)とは何か?機械学習との違い等をわかりやすく解説します!
ディープラーニング(深層学習)は、画像認識・自然言語処理・自動運転など、現代のAI技術を支える中核的な仕組みです。しかし「AIとどう違うのか」「機械学習との関係...