
blog
AIブログ
物体検出AIとは|仕組みと代表的なモデル比較【2026年最新版】をわかりやすく解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
画像の中に写っている物が「何か」「どこにあるか」「いくつあるか」を自動で判別するAI技術が物体検出(Object Detection)です。スマートフォンのカメラから自動運転、工場の品質検査まで、現代の身近な場面に広く浸透しています。本記事では、物体検出の定義と画像分類・セグメンテーションとの違い、仕組み、代表的なモデル(R-CNN・YOLO・SSD・DETR・RT-DETR)の比較と選び方、精度の見方(IoU・mAP)、使える道具とライセンス、自分のデータで作る流れ、活用事例までを順に解説します。
物体検出とは何か
物体検出(物体検知)とは、入力された画像や映像の中から、あらかじめ定められたカテゴリに属する物体の位置・種類・個数を同時に特定する技術です。
よく混同される「画像分類」と比較すると、その違いが明確になります。画像分類は「この画像には犬が写っている」というように、画像全体に対してラベルを付けるだけです。一方、物体検出ではそれに加えて次の処理を行います。
- 物体が存在する領域(バウンディングボックス)の位置座標を特定する
- 複数の物体が写っている場合、それぞれを個別に識別する
- 検出対象以外の背景や無関係な物体を排除する
- 同じカテゴリの物体が複数あっても、それぞれを個別にカウントする
このように物体検出は、「何が写っているか(分類)」に加えて「どこに何個あるか(位置・個数)」まで答えられる、より高度な画像認識タスクです。検出結果は通常、物体の周囲に矩形のバウンディングボックスと、クラス名および確信度スコアとして出力されます。
画像全体を見て「犬が写っている」と判定する。位置や個数は問わない。
「左上に犬1匹」「右下に猫2匹」のように、位置・種類・個数を確信度スコアとともに特定する。
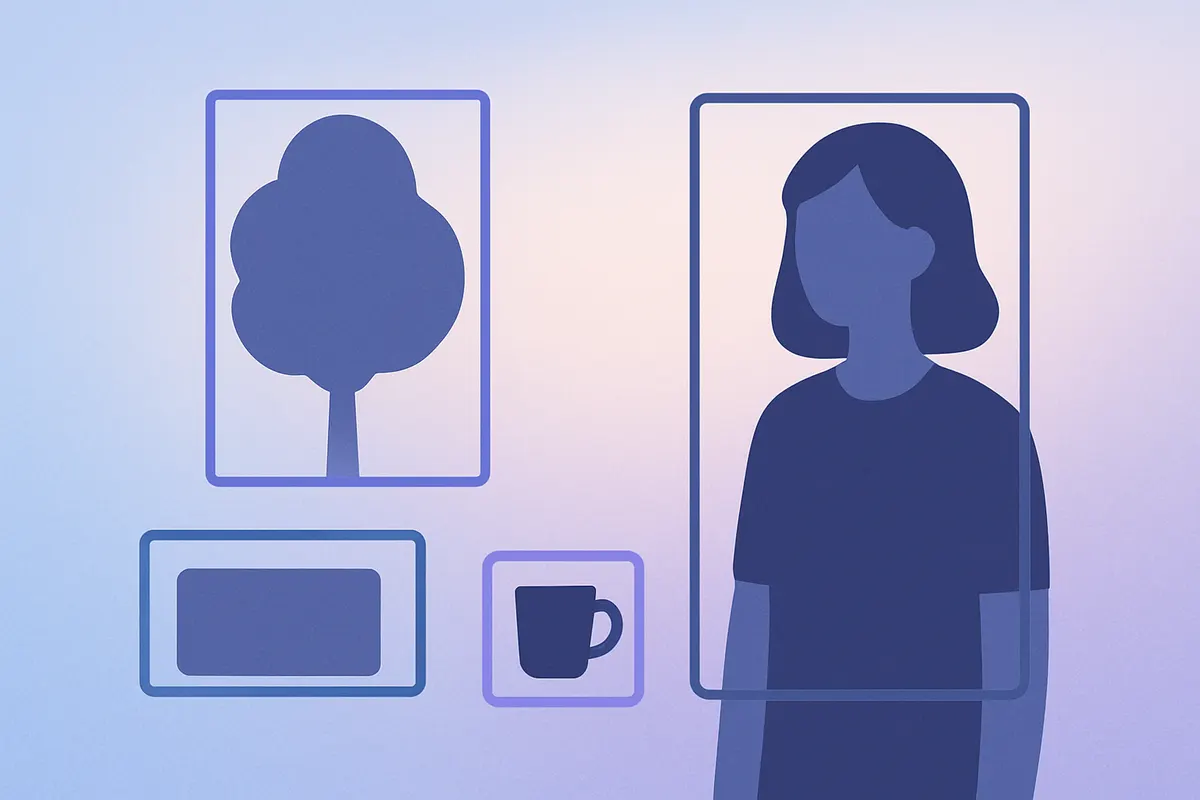
バウンディングボックスより細かく領域を分けたいときは、セマンティックセグメンテーションの仕組みで解説しています。
関連記事OpenCVでできることは?
画像分類・物体検出・セグメンテーションの違い
「画像認識」は、画像から情報を読み取る技術の広い呼び方です。その中で、何を答えるかによって名前が分かれます。IBMの解説(IBM「物体検出とは」)でも、画像分類は画像全体に1つのラベルを付け、物体検出は複数の物体それぞれの位置と種類を示し、セグメンテーションはボックスではなくピクセル単位で物体を区別するため、より精密と整理されています。
| タスク | 答えること | 出力 | 使う場面の例 |
|---|---|---|---|
| 画像分類 | この画像は何か | 画像全体に対する1つのラベル | 写真の仕分け、良品/不良品の2択判定 |
| 物体検出(この記事) | 何が・どこに・いくつあるか | バウンディングボックス+クラス名+確信度 | 人や車の位置、棚の商品数、部品の欠品 |
| セグメンテーション | どの画素がどの物体か | ピクセル単位の領域 | 形の輪郭が必要な医療画像、農地の区分 |
位置が要らないなら画像分類、枠で十分なら物体検出、形そのものが必要ならセグメンテーションが目安です。それぞれの詳しい説明は、画像分類の解説とセマンティックセグメンテーションの解説にまとめています。この記事は物体検出に絞って進めます。
次に読む:画像分類AIの仕組みと比較は?
物体検出の基本的な仕組み
現代の物体検出AIの多くは、CNN(畳み込みニューラルネットワーク)をベースに構築されています。CNNは画像の特徴(エッジ・テクスチャ・形状など)を階層的に学習できる構造を持ち、画像認識タスクに非常に高い適性を示します。
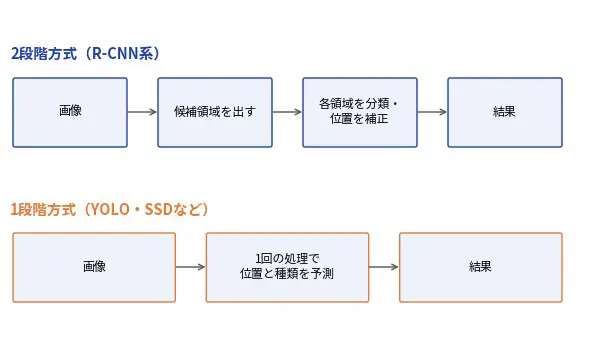
物体検出の処理フローは、大きく「特徴抽出」「領域提案」「分類・位置回帰」の3段階に分けられます。
モデルによって「領域提案」を別ネットワークで行うか(Two-stage方式)、一度の処理で完結させるか(One-stage方式)が異なり、それが精度と処理速度のトレードオフに直結します。
深層学習以前の物体検出——HOGとViola-Jonesから今のモデルまで
物体検出は深層学習が出る前からある技術で、今も軽い処理が必要な場面で名前が出ます。大きな違いは、特徴を人が設計したか、学習で自動的に得るかです。
| 手法 | 考え方 | 特徴 |
|---|---|---|
| Viola-Jones(Haar-like特徴+カスケード) | 2001年にPaul ViolaとMichael Jonesが提案。矩形の明暗差の特徴をAdaBoostで選び、判定の段を連ねて、物体がない窓を早い段で捨てる | 主に顔検出。計算が軽く、限られた機器でも速く動くが、現代のCNNより精度は低い |
| HOG+SVM | 2005年にNavneet DalalとBill Triggsが歩行者検出で発表。画像を小さなセルに分け、勾配の向きのヒストグラムを特徴にして、SVMで判定 | 人や物の形の特徴をとらえる。照明や影に強くなる工夫がある。特徴の設計は人が行う |
| 深層学習(R-CNN・YOLO・SSD・DETRなど) | 特徴の抽出から位置・種類の予測までを、大量の画像から学習 | 対象や条件を変えても同じ枠組みで学習し直せる。学習データとGPUが必要 |
出典:Wikipedia「Viola–Jones object detection framework」、Wikipedia「Histogram of oriented gradients」(2026年10月29日確認)。
物体検出が活用されている場面
物体検出は特定の専門領域に限らず、製造・医療・交通・日常生活など幅広い分野で実用化されています。
製造業・品質検査
物体検出は外観検査の自動化に最も多く用いられている分野のひとつです。部品の取り付け忘れ・取り付け間違い・キズや異物の混入など、従来は熟練した作業員が目視で行っていた検査を、AIが高速かつ高精度で代替します。検査ラインにカメラを設置するだけで24時間365日安定した品質管理が実現できるため、製造コストの削減と品質向上を同時に達成できます。
自動運転・交通インフラ
自動運転車は走行中に周囲の環境をリアルタイムで把握する必要があります。物体検出はカメラ映像から歩行者・他の車両・信号機・道路標識・自転車などを瞬時に識別し、安全な走行判断を支援します。交差点や駐車場での混雑検知、交通量モニタリングにも応用されています。
スマートフォン・カメラ
スマートフォンのカメラアプリで顔にフレームが表示されるのは、物体検出が動作している典型例です。人物の顔を検出してオートフォーカスを最適化したり、笑顔を検出してシャッターを自動で切ったりする機能もこの技術を応用しています。
医療・ヘルスケア
X線・CT・MRI画像から腫瘍・病変・異常な組織を検出する用途で急速に普及しています。医師の診断を補助するCAD(コンピュータ支援診断)システムへの組み込みが進んでおり、見落としリスクの低減や診断効率の向上に貢献しています。
セキュリティ・監視
監視カメラ映像から不審者・危険物・異常行動をリアルタイムで検出するシステムが空港・駅・商業施設などに導入されています。人流分析や不法侵入検知にも活用されています。
農業・インフラ点検
ドローン映像を解析して農作物の生育状況・病害虫の発生・収穫時期を判定したり、橋梁・道路・プラントのひび割れや劣化を自動検出したりする取り組みも進んでいます。
小売・マーケティング
店舗の棚の商品数や欠品の確認、売り場に来た人の数や動線の把握などに使われます。商品や人を枠で囲んで数えられるため、「何がどこに何個あるか」という物体検出の出力がそのまま業務の指標になります。商品の種類が多く入れ替わる売り場では、新商品のたびに画像と注釈を追加して再学習する運用が必要です。
物体検出AIの実務への適用例
実際の産業現場では、物体検出AIは以下のような形で活用されています。
部品の誤欠品検査
製造ラインを流れる製品に対して、カメラで撮影した画像をリアルタイムで解析し、部品の取り付け忘れ・取り付け位置のズレ・誤った部品の組み込みを自動検出します。従来は熟練した検査員が目視で確認していた工程を自動化することで、検査漏れを大幅に削減し、人員を高付加価値業務に集中させることができます。
異常品・不良品の検知
製品表面のキズ・変形・汚れ・異物混入などを物体検出AIで自動識別します。複数の不良パターンをモデルに学習させることで、目視では見落としやすい微細な欠陥も高精度で検出できます。検査速度も人間の目視より格段に速く、大量生産ラインでの品質維持に有効です。
このように物体検出AIは、「人が目視で行ってきた判断業務」を自動化・高速化・安定化する基盤技術として、製造現場をはじめとする様々な産業で導入が加速しています。
代表的な物体検出モデルの解説
物体検出モデルは研究が盛んな分野であり、多くの手法が提案されています。ここでは実務でも広く使われている代表的なモデルを詳しく解説します。
R-CNN(Regional CNN)系列
R-CNNは、ディープラーニングを物体検出に本格的に導入した先駆的モデルです。それまでの手法と比べて検出精度を大幅に向上させ、後続の多くのモデルに影響を与えました。
R-CNNの処理手順は次のとおりです。
- 画像を入力する
- Selective Searchアルゴリズムを用いて、物体が存在しそうな領域候補(Region Proposal)を約2,000個抽出する
- 抽出した各候補領域を一定サイズにリサイズし、CNNで特徴量を計算する
- SVMを用いて各領域に写っている物体のクラスを分類する
- バウンディングボックスの位置を回帰によって精密化する
R-CNNの課題は処理速度とメモリ消費です。2,000個の候補領域それぞれに対して個別にCNNを適用するため、1枚の画像の推論にも時間がかかり、学習フェーズも各コンポーネントを別々に訓練する必要がありました。
この問題を解決するためにFast R-CNNが登場しました。画像全体を一度だけCNNに通して特徴マップを作成し、その上でRoI(Region of Interest)プーリングを行うことで、各候補領域の特徴量抽出を共有化することに成功。Fast R-CNNの論文(arXiv:1504.08083)では、VGG16の学習がR-CNNの9倍、推論が213倍高速と報告されています。
さらにFaster R-CNNでは、領域提案自体もニューラルネットワーク(RPN: Region Proposal Network)に置き換えることで、画像入力から物体検出結果の出力まで完全にエンドツーエンドで学習・推論できるようになりました。精度・速度ともにR-CNN系の集大成として位置付けられ、現在でも精度重視の用途で広く利用されています。
- R-CNN 論文:https://arxiv.org/pdf/1311.2524.pdf
- Fast R-CNN 論文:https://arxiv.org/pdf/1504.08083.pdf
- Faster R-CNN 論文:https://arxiv.org/pdf/1506.01497.pdf
YOLO(You Only Look Once)
YOLOは「You Only Look Once(一度見るだけ)」の名が示すとおり、画像全体を一度だけ処理して物体の検出を完了させるOne-stage型の代表的モデルです。リアルタイム処理を最大の特徴としています。
R-CNN系が「候補領域の提案」→「各領域の分類」という2段階で処理するのに対し、YOLOは以下のアプローチを取ります。
- 画像全体をS×Sのグリッドに分割する(例:7×7)
- 各グリッドセルが、そのセルに中心を持つ物体のバウンディングボックスとクラス確率を同時に予測する
- 全グリッドの予測結果をまとめてNMS(Non-Maximum Suppression)で重複除去する
この一括処理方式により、2段階方式より高速になり、リアルタイムの映像ストリームへの適用が現実的になりました。また画像全体を1枚として学習するため、背景の誤検出(false positive)を抑える効果もあります。
一方で初代YOLOの弱点は、密集した小物体の検出精度です。各グリッドセルが担当できる物体数に制限があるため、物体が密集するシーンでの精度がFaster R-CNNより劣りました。
YOLOはその後も改良が続き、名前に「YOLO」が付くモデルは複数の開発元から出ています。Ultralyticsの対応モデル一覧(docs.ultralytics.com/models)には、YOLOv3からYOLOv12、YOLO11、2026年1月公開のYOLO26までが並びます。たとえばYOLOv6は美団(Meituan)、YOLOv10は清華大学のNMS(重複枠を消す後処理)不要の検出として掲載されています。YOLO26はn・s・m・l・xの5つの大きさがあり、NMSを使わない推論を選べます(既定はNMSあり)。版が多いため、使うときは「どの開発元の、どの版か」を確認してください。
- YOLO論文(v1):https://arxiv.org/pdf/1506.02640.pdf
SSD(Single Shot MultiBox Detector)
SSDは「Single Shot MultiBox Detector」の略で、YOLOと同じOne-stage型でありながら、精度をFaster R-CNN並みに保ちつつリアルタイム処理を実現したモデルです。
SSD最大の特徴は、複数スケールの特徴マップを同時に活用する点です。CNNの浅い層では解像度が高く小さな物体を捉えやすく、深い層では解像度が低いがより抽象的な特徴を捉えます。SSDはこれら複数の異なるスケールの特徴マップからそれぞれ検出を行い、最後に統合することで、大きな物体から小さな物体まで幅広いサイズの物体を精度良く検出できます。
各特徴マップでは、あらかじめ定義された複数のアスペクト比・スケールを持つ「デフォルトボックス(アンカーボックス)」を使って、物体の存在確率とバウンディングボックスのオフセットを予測します。
YOLOと比較すると、マルチスケール対応により特に物体が多数写っているシーンや小物体の検出精度が高い点が優れています。処理速度もリアルタイム検出に十分なレベルを維持しており、速度と精度のバランスが優れた手法として広く利用されています。
DETR(DEtection with TRansformers)
DETRは、2020年に論文が発表された、Transformerアーキテクチャを物体検出に応用した革新的なモデルです。それまでの物体検出モデルが抱えていた以下の課題を根本から解決しました。
- アンカーボックスの手動設計が必要(サイズ・アスペクト比のチューニング)
- NMS(Non-Maximum Suppression)による事後処理が必須
- 重複する物体候補の除去ロジックが複雑で、アノテーション方法によって精度が大きく左右される
DETRの処理は次の段階で構成されます。
Backbone(特徴抽出):入力画像をCNNで処理し、低次元の特徴マップを生成します。
Transformer Encoder:CNNが出力した特徴マップを1次元のシーケンスに変換し、位置エンコーディングを付加してTransformer Encoderに入力します。EncoderはSelf-Attentionにより画像全体の文脈的な特徴を学習し、並列処理で効率よく特徴を統合します。
Transformer Decoder:EncoderからのクロスアテンションとN個の「object query」(学習可能な位置エンコーディング)を組み合わせてデコードします。object queryはネットワークの重みと同様に学習されるパラメータです。機械翻訳と異なり、N個のqueryをすべて同時にDecodeする並列処理(parallel decoding)が可能です。
FFN(Feed Forward Network):Decoderが出力したN個のオブジェクト特徴それぞれを独立したFFNに通し、各物体のクラスラベルとバウンディングボックス座標(矩形)を予測します。
処理フローを整理すると次のとおりです。
- CNN出力の特徴マップを1×1 convolutionでdチャネルに圧縮する
- Transformer EncoderにH×W個のd次元特徴として入力し、H×W個の中間オブジェクト特徴を出力する
- Transformer DecoderにEncoder出力とN個のobject queryを入力し、N個のオブジェクト特徴(各d次元)を出力する
- N個のオブジェクト特徴をそれぞれFFNへ通し、N個のオブジェクト推論結果(クラス、矩形座標)を得る
DETRでは位置エンコーディング(object queryとspatial positional encoding)をEncoder・Decoderの各層で繰り返し使用することで精度を向上させています。また、object query(学習値)とspatial positional encoding(固定値)を場所ごとに使い分ける設計も精度向上に寄与しています。
学習済みDETRモデルを使えば、街中の風景画像から人・車・バッグなどの物体を検出し、クラス名と確信度スコア(1に近いほど確信が高い)が付いたバウンディングボックスを出力することができます。
DETRの登場以降、Deformable DETR・Conditional DETR・DN-DETRなど派生モデルの研究が活発化しており、Transformerベースの物体検出は2026年現在も最前線の研究テーマです。
RT-DETR(リアルタイム向けのDETR系)
RT-DETRは、DETRの枠組みをリアルタイム処理向けに作り直したBaiduの検出器です。Ultralyticsの解説(docs.ultralytics.com/models/rtdetr)では、NMSなどの後処理が不要で、アンカーを使わないこと、畳み込みのバックボーンと効率化したハイブリッドエンコーダーを組み合わせていることが説明されています。同ページには、COCO val2017でRT-DETR-Lが53.0% AP(T4 GPUで114 FPS)、RT-DETR-Xが54.8% AP(同74 FPS)という公式の数値が載っています。比較するときは、評価データと機器の条件が同じか確認してください。
その他の注目モデル
上記以外にも、用途に応じて選択肢となる代表的なモデルがあります。
Pelee:モバイル・組み込みデバイスなどリソースが限られた環境向けに設計された軽量モデルです。MobileNetベースのアーキテクチャを採用し、計算コストを抑えながら実用的な精度を実現しています。
M2Det:SSDのマルチスケール特徴を発展させた手法で、Multi-Level Feature Pyramid Network(MLFPN)と呼ばれる特徴ピラミッド構造により、様々なスケールの物体をより精度高く検出します。
AIの業務導入をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
主要モデルの特徴比較
| モデル | 方式 | 論文(arXiv) | 特徴・向いている用途 |
|---|---|---|---|
| R-CNN/Fast R-CNN/Faster R-CNN | 2段階 | 2013年・2015年 | 候補領域を出してから分類。位置の精度を重視する用途向き。処理は1段階より遅い傾向 |
| YOLO系 | 1段階 | 2015年(v1) | 画像全体を一度に処理。リアルタイムの映像向き。版・開発元が多いので要確認 |
| SSD | 1段階 | 2015年 | 複数スケールの特徴マップで大小の物体を検出。速度と精度のバランス |
| DETR | Transformer | 2020年 | アンカー設計とNMSが不要。エンドツーエンドで学習 |
| RT-DETR | Transformer | Baidu(Ultralytics解説で確認) | DETR系をリアルタイム向けにしたもの。NMS不要 |
| Pelee | 1段階 | 2018年 | モバイル・組み込みなど軽い環境向け |
「2段階は位置の精度が高く遅い、1段階は速くリアルタイム向きだが位置の精度は2段階より劣る傾向」という整理は、IBM「物体検出とは」(2026年10月29日確認)に基づきます。精度や速度の実際の数値は、評価データと実行環境によって変わるため、この表では順位を付けていません。
用途別の選び方
モデルは「何を優先するか」から選ぶと絞り込めます。
| 優先すること | 候補 | 理由 |
|---|---|---|
| 映像をリアルタイムで処理したい | YOLO系・SSD・RT-DETR | 1段階方式は速くリアルタイム向き(IBM)。RT-DETRはリアルタイム向けに設計 |
| 位置を細かく合わせたい | Faster R-CNNなど2段階方式 | 2段階は位置推定の精度が高い傾向(IBM)。速度は落ちる |
| 後処理(NMS)を減らしたい | DETR・RT-DETR・YOLOv10・YOLO26(NMSなしの設定) | NMSを使わない設計または推論設定が公式に説明されている |
| 小さな機器に載せたい | Pelee・SSDlite・YOLOの小さいサイズ | 軽量・小サイズの版がある(Ultralyticsの版は n〜x の5段階) |
| 学習データなしで試したい | YOLO-World・YOLOEなどの言葉で指定する検出 | Ultralyticsの一覧で「オープンボキャブラリー検出」と説明される。精度は実画像で確認が必要 |
どれを選んでも、最後は自分の画像での検証が必要です。次の節で道具を、そのあとに精度の測り方を説明します。
物体検出から物体追跡へ——動画で同じ物体を追い続ける
防犯・監視、人流分析、車両の追跡などでは、1枚ごとの検出に加えて、動画の中で同じ物体を追い続ける物体追跡(トラッキング)が使われます。Ultralyticsの解説(Multi-Object Tracking)では、追跡は各フレームで物体の位置とクラスを見つけたうえで、動画が進む間も物体ごとに固有のIDを保つ処理と説明されています。追跡は物体検出の上に成り立ち、出力は検出結果にIDが加わった形になります。
| 追跡の方式 | 特徴(公式の説明) |
|---|---|
| ByteTrack | 軽量な基本形。2段階で候補を対応付ける。見た目の特徴(外観モデル)やカメラの動きの補正は持たない |
| BoT-SORT | ByteTrackを拡張し、カメラの動きの補正と、任意で同一人物の再識別(ReID)を加えたもの |
| その他 | OC-SORT・Deep OC-SORT・FastTracker・TrackTrackも同じ仕組みで選べる |
公式ページが挙げる用途は、監視・セキュリティ、スポーツ分析、交通(車両の追跡)、小売(人の追跡)などです。「1枚の写真で何が写っているか」なら検出、「同じ物体が動画の中でどう動いたか」なら追跡、と使い分けます。
物体検出を試せる道具とライセンスの注意点
自分で動かすなら、公開されているライブラリで学習済みモデルを読み込むのが出発点です。代表的な3つを、公式ドキュメントに書かれている範囲で整理します(2026年10月29日確認)。
| 道具 | 入っている検出モデル | 使い方の要点 | ライセンス |
|---|---|---|---|
| TorchVision(PyTorch) | Faster R-CNN・FCOS・RetinaNet・SSD・SSDlite | 重みの指定で学習済みモデルを読み込み、eval()で推論。検出モデルはTorchVisionのインストールが前提 | 公式ドキュメントで確認 |
| Hugging Face Transformers | RF-DETRなど(Transformersが対応する検出モデル) | AutoModelForObjectDetectionで読み込み。注釈はCOCO形式、評価はmAP(公式チュートリアル) | モデルごとに異なる。各モデルのページで確認 |
| Ultralytics | YOLOv3〜YOLOv12・YOLO11・YOLO26・RT-DETR・YOLO-World・YOLOEなど | 検出のほか、セグメンテーション・分類・姿勢推定・追跡に対応 | AGPL-3.0と企業向けのEnterpriseライセンスの2種(GitHub) |
商用で使うときはライセンスを必ず確認してください。Ultralyticsのリポジトリでは、AGPL-3.0は学生・研究者・愛好家向けのオープンソースライセンス、開発・商用利用にはEnterpriseライセンスと案内されています(GitHub ultralytics/ultralytics)。モデルの重みもライセンスが別になる場合があるため、使う版ごとに配布元で確認します。出典:Hugging Face「Object detection」、PyTorch「Models and pre-trained weights」。
物体検出の精度の見方:IoUとmAP
「精度が高い」と言うときは、何で測ったかを見ます。物体検出は「枠の位置が合っているか」と「種類が合っているか」の両方を測るため、画像分類より指標が多くなります。Ultralyticsの解説(YOLO Performance Metrics)に沿って整理します。
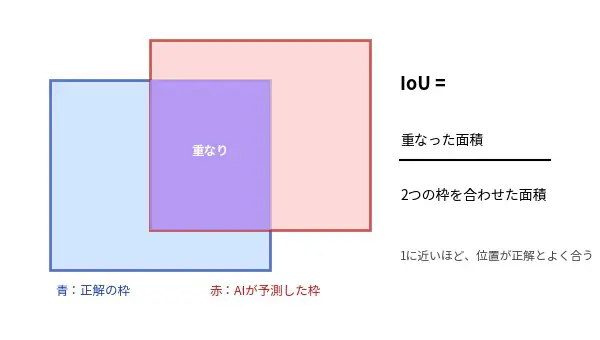
| 指標 | 意味 | 見るときの注意 |
|---|---|---|
| IoU | 予測した枠と正解の枠がどれだけ重なっているか。位置の正確さの目安 | 1に近いほど正解に近い枠。「何割重なれば正解とみなすか」のしきい値を決めて使う |
| 適合率(Precision) | AIが「ある」と言ったもののうち、正しかった割合 | 低いと誤検出が多い |
| 再現率(Recall) | 実際にある物体のうち、AIが見つけられた割合 | 低いと見落としが多い |
| mAP50 | IoUのしきい値を0.50にして、クラスごとの平均適合率(AP)を平均した値 | 位置のずれに寛容な測り方 |
| mAP50-95 | IoUのしきい値を0.50から0.95まで変えて求めたmAPの平均 | 位置の細かさまで問う、より厳しい測り方 |
同じ「mAP」でも、IoUのしきい値や評価データが違えば比べられません。たとえば見落としが許されない検査なら再現率、誤警報が負担になる監視なら適合率を優先して見る、というように、用途に合わせて指標を選びます。
自分のデータで物体検出AIを作る流れ
既存の学習済みモデルを、自分の画像で追加学習(ファインチューニング)するのが一般的な進め方です。Hugging Faceの公式チュートリアル(Object detection)の手順を軸に、6段階で整理します。
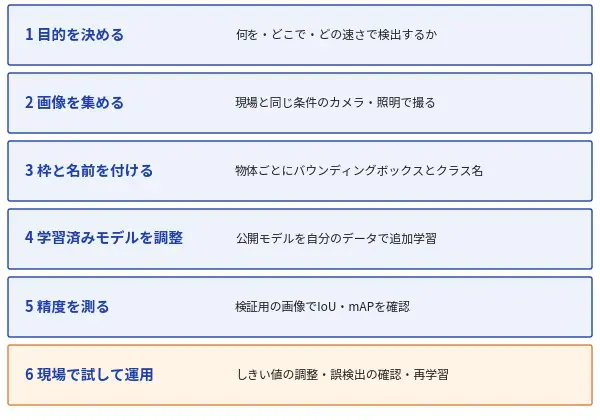
| 段階 | やること | つまずきやすい点 |
|---|---|---|
| 1 目的を決める | 何を検出し、どこで動かし、どれくらいの速さが要るかを決める | 決めずにモデルを選ぶと、速度か精度のどちらかで作り直しになる |
| 2 画像を集める | 実際に使うカメラ・照明・距離で撮る | 現場と違う条件の画像だけで学習すると、本番で精度が落ちる |
| 3 枠と名前を付ける(アノテーション) | 物体ごとにバウンディングボックスとクラス名を付ける。公式チュートリアルの注釈は、COCO形式(x, y, 幅, 高さ) | 幅や高さが0以下の枠は学習前に除く(チュートリアルでも除外している) |
| 4 学習済みモデルを調整する | 公開モデルを読み込み、クラス数に合わせて出力部分を入れ替えて追加学習する。チュートリアルでは学習にGPUが必要と説明 | 明るさの変更や反転などの水増しは学習用だけに行い、検証用には行わない |
| 5 精度を測る | 検証用の画像でmAPなどを確認する | 学習に使った画像で測ると実力より高く出る |
| 6 現場で試して運用する | 確信度のしきい値を調整し、誤検出・見落としを確認して再学習する | チュートリアルの推論例でも、確信度のしきい値で結果を絞っている |
注釈ファイルの形式:COCOとYOLO
注釈は、使うライブラリに合わせた形式で保存します。注釈ツールは多数あるため、出力できる形式を確認して選びます。
| 形式 | 内容 | 出典 |
|---|---|---|
| COCO形式 | JSONファイルに、画像ごとの物体のクラスと枠(x, y, 幅, 高さ)を記録。Hugging Faceのチュートリアルが採用 | Hugging Face「Object detection」 |
| YOLO形式 | 画像1枚につきtxtファイル1つ。1行が1物体で「クラス番号 中心x 中心y 幅 高さ」。座標は0〜1に正規化、クラス番号は0から。物体がない画像はtxt不要 | Ultralytics「Object Detection Datasets」 |
| COCOからYOLOへの変換 | ultralytics.data.converterのconvert_cocoで、COCOのJSONをYOLO形式のtxtに変換できる | 同上 |
画像を集める段階とアノテーションの段階は、どちらも人手がかかります。自社で用意するか、専門の事業者に依頼するかは、枚数とクラス数、品質のそろえ方で決まります。モデルの種類より、データの質が結果を左右することが多い工程です。
推論を速く・軽くするには——画像サイズ・モデルの大きさ・書き出し形式
リアルタイムで動かしたい、小さな機器に載せたい、という場合は、モデルを選ぶだけでなく、動かし方も調整します。速さの単位にはFPS(1秒あたりに処理できる画像の枚数)がよく使われます。数値は機器と設定で変わるため、必ず自分の環境で測ってください。
| 調整できること | 内容 | 出典 |
|---|---|---|
| モデルの大きさ | YOLO26にはn・s・m・l・xの5つの大きさがある。小さいほど軽く、大きいほど精度を狙える(一般的な傾向) | Ultralytics「YOLO26」 |
| 画像サイズ | 小さな物体が多いデータは、元の解像度かそれ以上で学習する。推論の画像サイズは学習と合わせると結果がよい | Ultralytics YOLOv5「Tips for Best Training Results」 |
| 書き出し形式 | ONNX・OpenVINO・TensorRT・CoreML・TFLiteなどに書き出して、動かす機器に合わせる。公式は、TensorRTでGPUが最大5倍、ONNXまたはOpenVINOでCPUが3倍速くなると説明している(条件による) | Ultralytics「Export」 |
| FP16・INT8 | FP16は精度を保ちやすくモデルを小さくでき、INT8はさらに圧縮して主にエッジ機器向け。INT8には較正用のデータが必要 | Ultralytics「Export」 |
また、アンカーボックス(あらかじめ用意した複数の大きさ・縦横比の枠)を使うかどうかも速度と設計に関わります。DETRの論文は、アンカーの生成とNMSという手作業の設計を不要にしたと述べており、RT-DETRもアンカーを使わない設計と説明されています。出典:Ultralytics「Export」、「YOLO26」、「Tips for Best Training Results」(2026年10月29日確認)。
物体検出AIを導入する前に知っておきたい注意点とデメリット
精度が出ない原因の多くはモデルではなくデータにあります。Ultralyticsのデータ収集の解説(Data Collection and Annotation)や学習のコツ(Tips for Best Training Results)に書かれている内容を中心に整理します。
| 注意点 | なぜ問題になるか | 事前の対策 |
|---|---|---|
| データの偏り | 特定の場面や対象に偏ると、一部では高精度でも別の場面で精度が落ちる | 集める画像の場面・対象をそろえて偏りを確認する |
| 撮影条件が現場と違う | 公式の解説では、画像は実際に使う環境を反映させるべきで、時間帯・季節・天候・カメラの違いなどを含めるとされる | 本番と同じカメラ・照明で撮る。条件が変わる場合は変わった画像も集める |
| ラベルの付け漏れ | 公式の解説では、全画像の全物体にラベルが必要で、一部だけの付与は機能しないとされる | 注釈の基準を文書にし、第二の担当者が確認する |
| 画像の枚数が足りない | YOLOv5の公式の学習ガイドは、クラスごとに1,500枚以上・10,000個以上のラベル付き物体を推奨している | 目安を満たせるか、クラス数を絞れるかを先に検討する |
| 誤検出が多い | 物体が写っていない画像(背景画像)を0〜10%程度含めると誤検出を減らせると、同ガイドが説明している | 背景だけの画像も用意する。背景画像にラベルは不要 |
| 小さい物体・環境の変化 | 小さな物体は検出が難しく、照明や設備が変わると精度が時間とともに落ちることがある(一般的な傾向) | 画像サイズや撮影距離を検証し、運用後の定期確認と再学習の計画を入れる |
| 計算資源とライセンス | 学習にGPUが必要。商用利用ではライセンスの確認が必要 | 前述のライセンス表を確認し、クラウドと自前の機器を比較する |
なお、同じ画像の枚数目安でも、対象の難しさやモデルによって必要量は変わります。目安を満たしていても、必ず自分の検証用画像でmAPを確認してください。
よくある質問
Q1. 物体検出とは何ですか?
画像や動画の中から、物体の「位置」「種類」「個数」を同時に見つけるAI技術です。バウンディングボックス(矩形の枠)で位置を示し、クラス名と確信度スコアを付けて出力します。
Q2. 物体検出と画像認識・画像分類の違いは何ですか?
画像認識は画像から情報を読み取る技術の広い呼び方です。画像分類は画像全体に1つのラベルを付け、物体検出は物体ごとの位置と種類を示します。ピクセル単位で物体の範囲を示すものはセグメンテーションと呼びます。
Q3. 代表的な物体検出モデルにはどんなものがありますか?
2段階方式のR-CNN系列、1段階方式のYOLO・SSD、Transformerを使うDETRとRT-DETRなどが代表的です。1段階は速くリアルタイム向き、2段階は位置の精度が高い傾向があります。
Q4. YOLOは商用でも無料で使えますか?
Ultralyticsのリポジトリでは、AGPL-3.0(オープンソース)と、開発・商用利用向けのEnterpriseライセンスの2種が案内されています。「YOLO」という名前のモデルは開発元が複数あるため、使う版ごとに配布元のライセンスを確認してください。
Q5. 物体検出の精度(mAP)はどう見ればよいですか?
mAPは、枠の重なり具合(IoU)のしきい値を決めて、クラスごとの平均適合率を平均した指標です。mAP50は0.50、mAP50-95は0.50から0.95までのしきい値で測ります。評価データとしきい値が違う数値は比べられません。
Q6. 自分の画像で物体検出AIを作るには何が必要ですか?
対象を写した画像、物体ごとの枠とクラス名の注釈、学習済みモデル、学習用のGPU環境が必要です。注釈はCOCO形式がよく使われます。段階は、目的の決定、画像収集、注釈、追加学習、精度測定、現場での試験運用の順です。
Q7. 物体検出はどんな場面で使われていますか?
製造業の外観検査、自動運転の周辺認識、スマートフォンのカメラ、医療画像の補助、監視カメラ、ドローンによる農業・インフラ点検などです。
まとめ
物体検出AIは、画像・映像の中から物体の「位置・種類・個数」を同時に特定する技術であり、単なる画像分類を超えた高度な認識能力を持っています。CNNを基盤としながら、R-CNN系・YOLO・SSD・DETRといったモデルがそれぞれ異なるアプローチで精度と速度のバランスを追求してきました。
- R-CNN / Faster R-CNN:Two-stage方式で高精度。精度重視の用途に適する
- YOLO:One-stage方式でリアルタイム処理が強み。バージョンアップが続く実用モデル
- SSD:マルチスケール特徴により速度と精度を両立。多物体・小物体検出に強い
- DETR:Transformerによるエンドツーエンド学習でアンカー設計不要。研究最前線のアーキテクチャ
活用シーンは製造業の品質検査・自動運転・医療診断支援・セキュリティ・農業など多岐にわたり、2026年現在も精度・速度・汎用性のさらなる向上を目指した研究開発が世界中で続いています。用途に合ったモデルを選び、ライセンスを確認したうえで、実際のデータで追加学習し、mAPなどの指標と現場での試験で確かめる、という流れが基本です。画像分類・セグメンテーションとの違いを押さえておくと、自分の課題にどのタスクが合うかを判断しやすくなります。
参考にした公式資料
- IBM「物体検出とは」(2026年10月29日確認)
https://www.ibm.com/jp-ja/think/topics/object-detection - Ultralytics Docs「Models」「YOLO26」「RT-DETR」「YOLO Performance Metrics」(2026年10月29日確認)
https://docs.ultralytics.com/models/ - GitHub「ultralytics/ultralytics」(2026年10月29日確認)
https://github.com/ultralytics/ultralytics - Hugging Face Transformers「Object detection」(2026年10月29日確認)
https://huggingface.co/docs/transformers/tasks/object_detection - PyTorch「Models and pre-trained weights」(2026年10月29日確認)
https://docs.pytorch.org/vision/stable/models.html - Ultralytics Docs「Multi-Object Tracking」「Export」「Object Detection Datasets」「Data Collection and Annotation」(2026年10月29日確認)
https://docs.ultralytics.com/modes/track/ - Fast R-CNN論文(arXiv:1504.08083)/DETR論文(arXiv:2005.12872)
AIの業務活用をご検討の方へ
クリスタルメソッドは、バーチャルヒューマンをはじめAIの開発・業務導入を支援しています。生成AI・AIエージェントの活用や、自社業務へのAI導入をご検討の際は、お気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
セマンティックセグメンテーションとは?仕組みと活用をわかりやすく解説【2026年版】
セマンティックセグメンテーション(Semantic Segmentation)は、画像内のすべてのピクセルをクラスラベルに分類するコンピュータビジョン技術です。...
-
画像分類とは?AIモデルの仕組み・比較・活用シーンを解説
「画像認識AI」や「ディープラーニング」という言葉は広く知られるようになりましたが、実際にどのような仕組みで画像を分類しているのか、詳しく理解している方はまだ多...
-
OpenCVとは?できることや特徴をわかりやすく解説
Pythonをはじめとする様々なプログラミング言語で画像処理・コンピュータビジョンを実装するとき、真っ先に名前が挙がるのがOpenCVです。正式名称は「Open...