
blog
AIブログ
AIが判断する仕組みとは?学習からデータ・モデル・推論まで解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
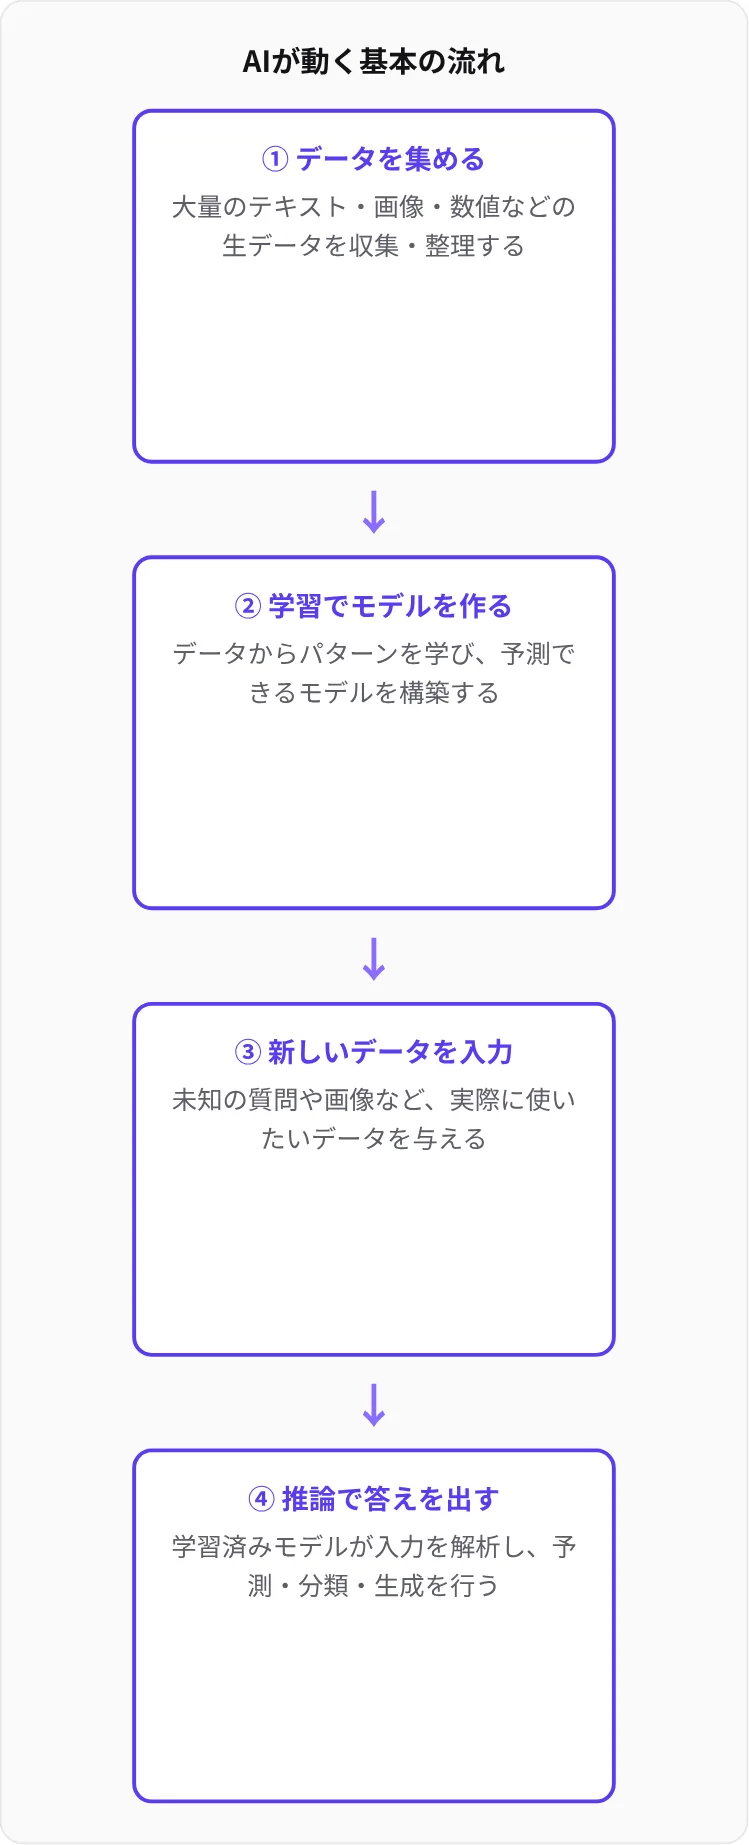
AIの仕組みとは、大量のデータから規則性を学んで「モデル」を作り(学習)、そのモデルに新しいデータを入力して答えを出す(推論)という2段階の流れのことです。ChatGPTのような生成AIも同じ流れで動いており、膨大な文章から言葉のつながりを学んだモデルが「次に来る言葉」を1つずつ予測して文章を組み立てています。
この記事では、AIの仕組みを初めて学ぶ方に向けて、機械学習・ディープラーニング・ニューラルネットワーク・Transformerといった中核技術を「学習→推論」の流れに沿って順番に解説します。ハルシネーション(もっともらしい誤り)が起きる理由と対策、仕組みごとの活用事例、手元で仕組みを体感できる小さな実験も紹介します。記述は2026年11月時点の情報に基づいています。
AIの仕組みの基本:データで「学習」し、モデルで「推論」する
結論から言うと、現在のAIのほとんどは「人間がルールを書く」のではなく「データからルールを見つけさせる」仕組みで作られています。この点が、従来の普通のプログラムとの最も大きな違いです。
総務省の「令和元年版 情報通信白書」でも、AIの基本的な仕組みとして、機械学習によってデータから特徴やパターンを学び、判断に使う流れが解説されています(出典:総務省 https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r01/html/nd113210.html)。
普通のプログラムとAIプログラムの違い
たとえば「迷惑メールを見分ける」処理を作る場合、2つの作り方は次のように異なります。
| 比較点 | 普通のプログラム | AI(機械学習) |
|---|---|---|
| ルールの作り方 | 人間が「件名に特定の語があれば迷惑」と条件を書きます | 迷惑メールと通常メールの実例を大量に与え、AIが見分け方を見つけます |
| 想定外への対応 | 書いていない条件には対応できません | 学習した傾向から、似た新しいパターンも判定できます |
| 結果の説明 | 条件が明確なので説明しやすいです | 判断の根拠が見えにくくなりがちです |
| 改善の方法 | 人間がコードを書き換えます | データを追加・修正して再学習します |
AIを構成する4つの要素
AIは、次の4つがそろって初めて動きます。どれか1つが欠けても、期待した精度は出ません。
- データ:学習の材料です。量だけでなく、偏りの少なさや正確さが精度を左右します。
- モデル:入力を出力に変換する「計算式の集まり」です。中には学習で調整される大量の数値(パラメータ)が含まれます。
- 学習アルゴリズム:モデルの数値をどう調整するかの手順です。後述する勾配降下法が代表例です。
- 計算資源:学習と推論を実行するコンピュータです。大規模なモデルではGPUなどの専用ハードウェアが使われます。
学習と推論の違い
「学習」はモデルを作る段階、「推論」は完成したモデルを使う段階です。ChatGPTに質問して回答が返ってくるのは推論にあたり、その瞬間にモデルが新しく学習しているわけではありません。学習には大量の計算と時間がかかりますが、推論は一度作ったモデルを繰り返し使えるため、多くの人が同時に利用できます。
関連記事ニューラルネットワークとは?仕組みと種類(DNN・RNN)をわかりやすく解説 / CNNとは何か|畳み込みニューラルネットワークの仕組みをわかりやすく解説
AI・機械学習・ディープラーニング・生成AIの関係と種類
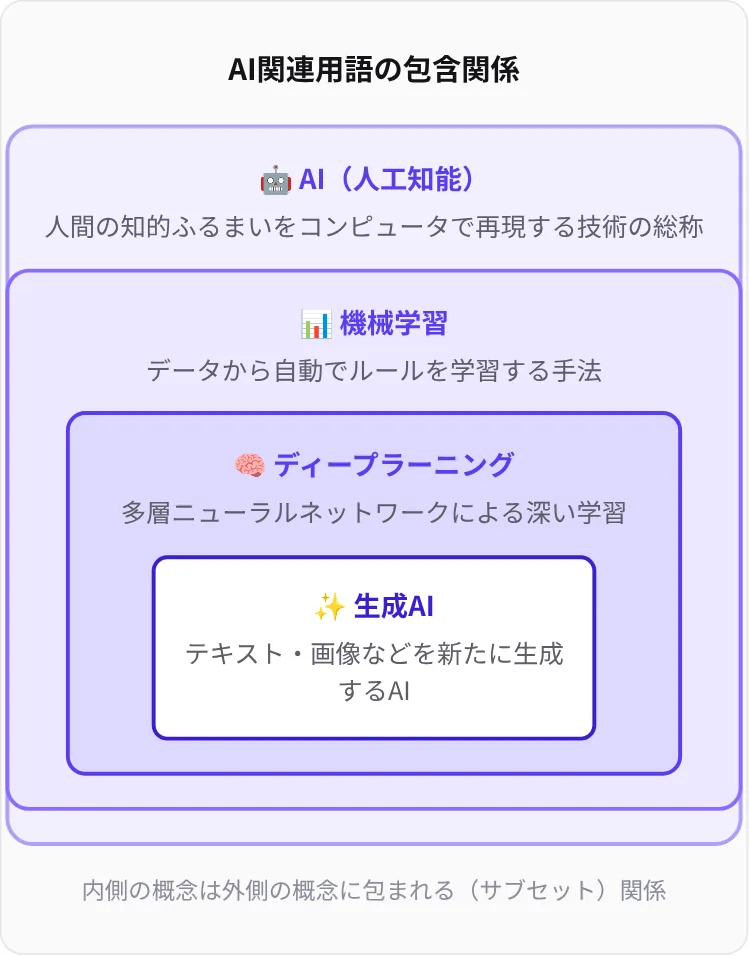
結論として、これらの言葉は「AI ⊃ 機械学習 ⊃ ディープラーニング ⊃ 生成AI(の多く)」という入れ子の関係にあります。生成AIは突然現れた別物ではなく、機械学習とディープラーニングの延長線上にある技術です。
予測・識別型AIと生成AIの違い
現在使われているAIは、「何を出力するか」で大きく2つに分けると理解しやすくなります。
| 比較点 | 予測・識別型AI | 生成AI |
|---|---|---|
| 出力 | 分類結果や予測値(例:「不良品」「来月の需要量」) | 新しい文章・画像・音声・コード |
| 代表的な用途 | 画像認識、需要予測、異常検知、レコメンド | 文書作成、要約、翻訳、対話、画像生成 |
| 学習データ | 目的ごとに用意した業務データが中心です | 大量の汎用データで事前学習した基盤モデルを使うのが一般的です |
| 作り方 | 目的別にモデルを個別に作ることが多いです | 既存の大規模モデルを指示や追加データで調整することが多いです |
特化型AIと汎用型AI(AGI)
特定の作業だけをこなすAIを「特化型AI」、人間のように幅広い課題を自分で理解して解ける知能を「汎用型AI(AGI)」と呼びます。画像認識も需要予測も、そして幅広い質問に答えられる生成AIも、現時点では学習した範囲のパターンに基づいて動く技術であり、AGIが実現しているとは言えません。AGIの実現時期や定義は研究者の間でも議論が続いています。
AIの歴史:3度のブームと「冬の時代」
AIはこれまで、期待の高まりと停滞を繰り返してきました。各ブームの限界を知ると、現在の仕組みがなぜデータ中心なのかが見えてきます。
| 時期 | 中心となった考え方 | 行き詰まった理由 |
|---|---|---|
| 第1次ブーム(1950年代後半〜1960年代) | 探索・推論(パズルや迷路を解く) | 現実の複雑な問題は解けませんでした |
| 第2次ブーム(1980年代) | 専門家の知識をルールとして書き込むエキスパートシステム | 知識を人手で書き尽くすことが困難でした |
| 第3次ブーム(2000年代〜) | 機械学習、2010年代以降はディープラーニング | 現在も発展中で、2022年末以降は生成AIが急速に普及しています |
第2次ブームの「人間がルールを書き尽くす」限界を、第3次ブームでは「データからルールを学ばせる」ことで乗り越えた、という流れが現在のAIの仕組みの出発点になっています。
機械学習の仕組み:データからパターンを学ぶ
機械学習とは、データを与えてモデルの数値を少しずつ調整し、入力と出力の関係(パターン)を自動で見つけさせる技術です。どんなデータを与え、何を正解とするかによって、学習方法は3つに分かれます。
教師あり学習・教師なし学習・強化学習の違い
| 学習方法 | 仕組み | 代表的な使い道 |
|---|---|---|
| 教師あり学習 | 入力と正解のペアを与え、正解に近づくようモデルを調整します。数値を当てる「回帰」と、カテゴリを当てる「分類」があります | 売上予測、迷惑メール判定、画像分類 |
| 教師なし学習 | 正解を与えず、データの中にある似たもの同士のまとまりや構造を見つけます | 顧客のグループ分け(クラスタリング)、異常検知、次元削減 |
| 強化学習 | AIが試行錯誤で行動し、結果に応じた「報酬」が大きくなる行動を学びます | ゲームAI、ロボット制御、生成AIの応答調整(RLHF) |
代表的な機械学習アルゴリズム
- 線形回帰:入力と出力の関係を直線で近似し、数値を予測します。
- ロジスティック回帰:名前に「回帰」とありますが、「はい/いいえ」の確率を求める分類に使います。
- 決定木・ランダムフォレスト:条件分岐の木で判定します。ランダムフォレストは多数の木の多数決で精度を高めます。
- k近傍法:新しいデータに近い既知のデータを探し、その多数決で分類します。
- k平均法:データをk個のグループに分ける、教師なし学習の代表的な手法です。
- ニューラルネットワーク:脳の神経回路をヒントにした多層の計算モデルで、ディープラーニングの土台です(次の章で詳しく説明します)。
AI開発の流れと、よくある失敗
機械学習のモデルは、次の流れで作られます。各段階で起きやすい失敗を知っておくと、AIの「精度が高い」という説明を鵜呑みにせず確かめられるようになります。
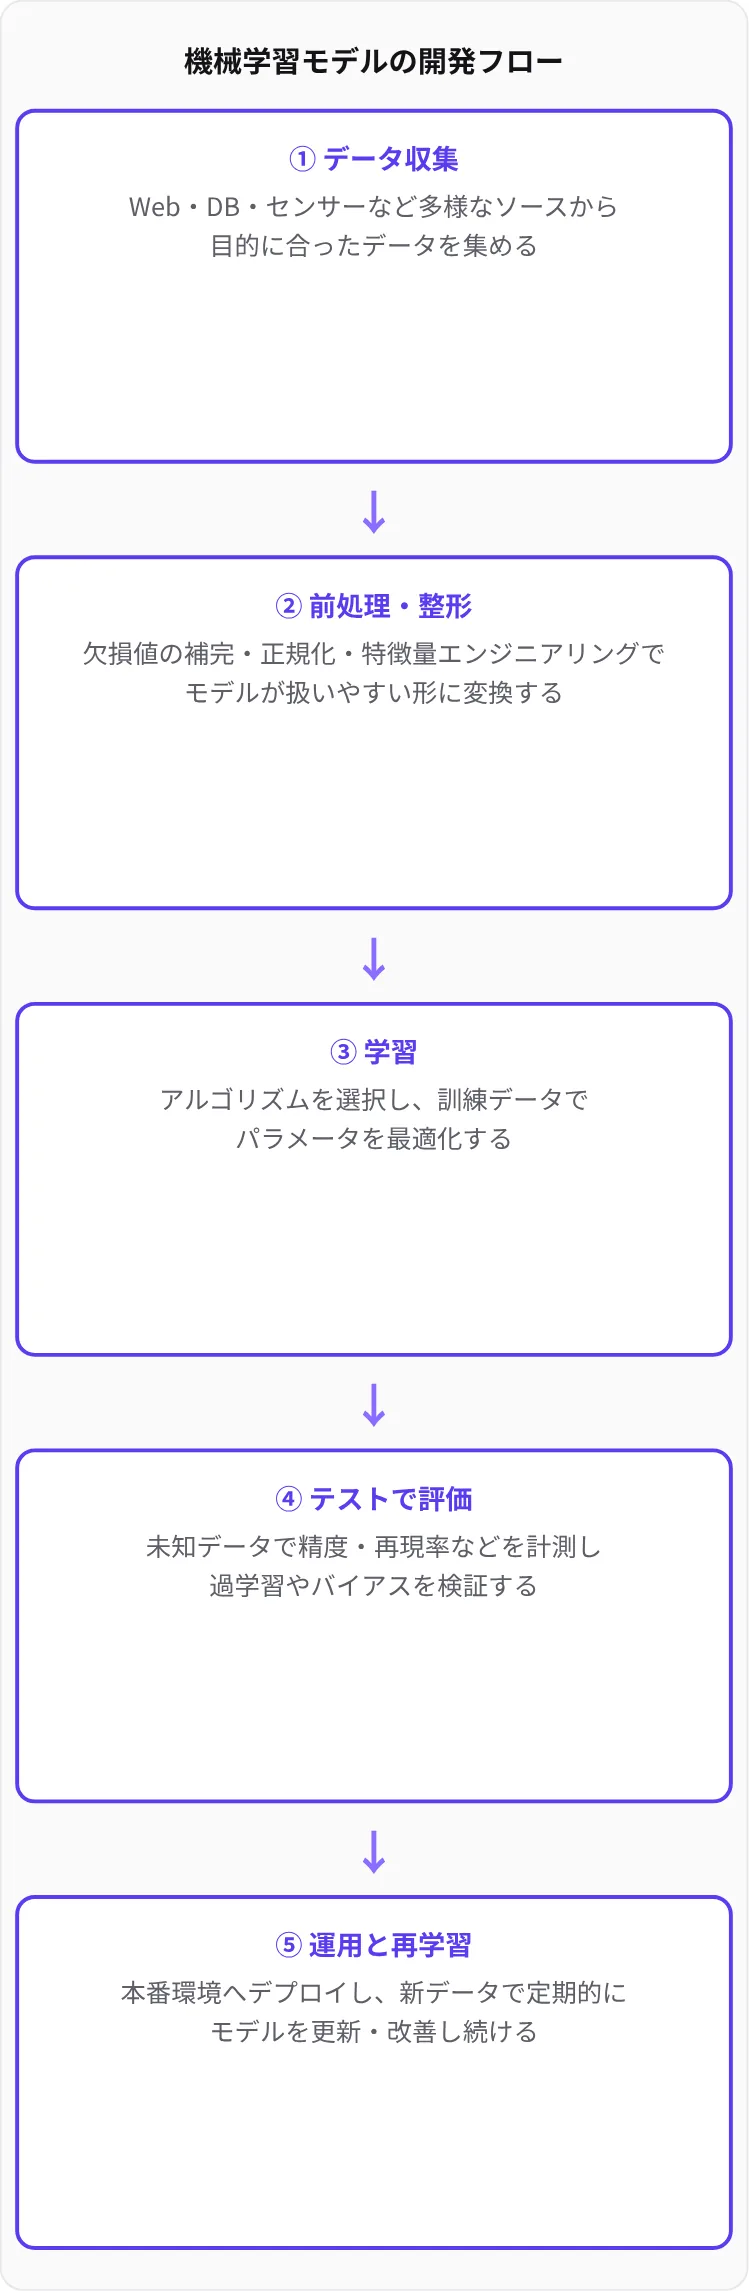
| 段階 | よくある失敗 | 防ぎ方 |
|---|---|---|
| データ収集 | 特定の条件のデータばかり集まり、偏った判断をするモデルになります | 対象とする場面を網羅しているか、集める前に確認します |
| 評価用データの分割 | テスト用のデータが学習に混ざり(データ漏洩)、評価だけ高く本番で当たりません | 学習用・検証用・テスト用を最初に分け、テスト用は最後まで使いません |
| 時系列データの分割 | ランダムに分けたことで「未来のデータ」で過去を当てる形になります | 日付で区切り、過去で学習して未来で評価します |
| 学習 | 学習データを丸暗記してしまい、新しいデータで当たらなくなります(過学習) | 学習データとテストデータの精度の差を確認します |
| 運用 | 世の中の傾向が変わり、時間とともに精度が落ちます | 定期的に精度を測り、必要に応じて再学習します |
ニューラルネットワークとディープラーニングの仕組み
ディープラーニング(深層学習)とは、ニューラルネットワークを何層にも深く重ねた機械学習の手法です。最大の特徴は、「データのどこに注目すべきか(特徴量)」を人間が決めなくても、AIが自動で見つけ出せる点にあります。
ニューラルネットワークの構造:層・重み・活性化関数
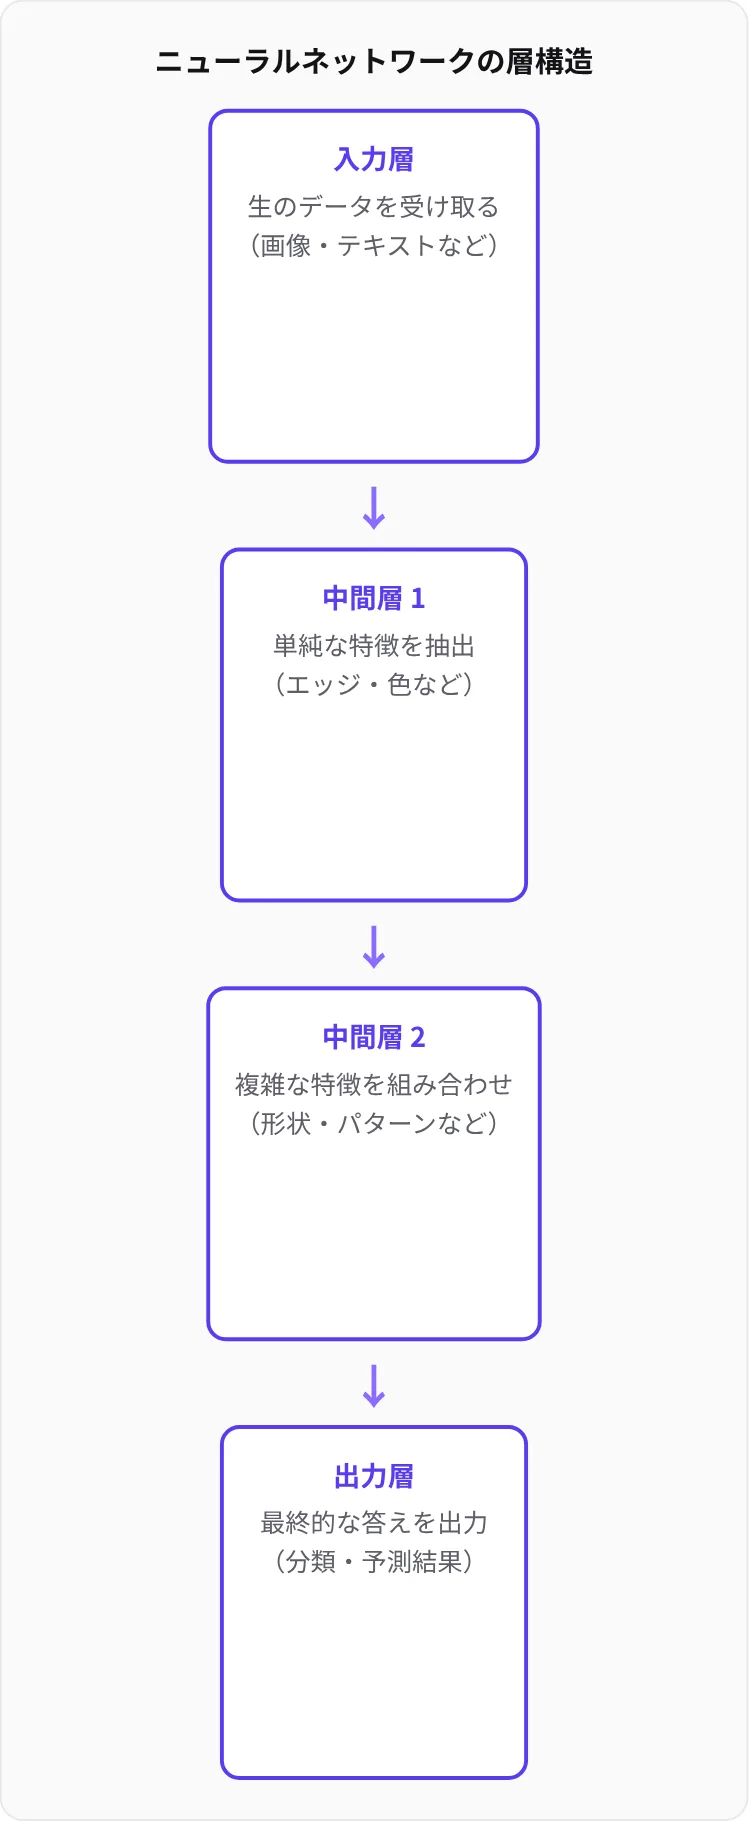
ニューラルネットワークは、数値を受け取って計算し次へ渡す「ノード(ニューロン)」を層状に並べたものです。1つのノードで行われる計算は、次の3ステップだけです。
- 前の層から受け取った各入力に、それぞれの重み(重要度を表す数値)を掛けます。
- 掛けた結果をすべて足し、バイアス(ずらし幅の数値)を加えます。
- 合計を活性化関数に通して、次の層へ渡す値を決めます。代表例は、負の値を0にするReLUや、値を0〜1に収めるシグモイド関数です。
活性化関数があることで、ネットワークは単純な直線の関係だけでなく、曲がりくねった複雑な関係も表現できるようになります。この単純な計算を何万・何億と組み合わせることで、画像や言葉のような複雑なデータを扱えるようになります。
学習の正体は「誤差を減らす方向に重みを少しずつ動かす」こと
学習とは、モデルの出力と正解のずれ(誤差)が小さくなるように、重みを調整する作業です。どの重みをどちら向きにどれだけ動かせば誤差が減るかを、出力側から入力側へさかのぼって計算する方法を誤差逆伝播法、その結果に沿って重みを少しずつ更新する方法を勾配降下法と呼びます。
仕組みを実感するために、重みが1つだけの最小のモデルで手計算してみます。「入力xに重みwを掛けた値を予測とする」モデルに、入力2・正解6のデータを1つ与え、wの初期値を1.0、1回に動かす幅の係数(学習率)を0.05とします。誤差は「(予測−正解)の2乗」で測り、その傾きは「2×(予測−正解)×入力」で求められます。重みは「w −学習率×傾き」で更新します。
| 回数 | 重みwと予測・誤差 | 傾きと更新後のw |
|---|---|---|
| 1回目 | w=1.0、予測2.0、予測−正解=−4.0 | 傾き 2×(−4.0)×2=−16 → w=1.0−0.05×(−16)=1.8 |
| 2回目 | w=1.8、予測3.6、予測−正解=−2.4 | 傾き −9.6 → w=1.8+0.48=2.28 |
| 3回目 | w=2.28、予測4.56、予測−正解=−1.44 | 傾き −5.76 → w=2.28+0.288=2.568 |
回を重ねるごとに予測が正解の6に近づき、wは正解の3に近づいていきます。表計算ソフトにこの3つの式を入れて下へコピーすれば、誰でも学習が進む様子を確かめられます。学習率を大きくしすぎると正解を飛び越えて行き来し、小さすぎると進みが遅くなることも試すとわかります。実際のディープラーニングでは、これと同じ更新を膨大な数の重みに対して同時に行っています。
従来の機械学習とディープラーニングの違い:特徴量の自動抽出
| 比較点 | 従来の機械学習 | ディープラーニング |
|---|---|---|
| 特徴量の設計 | 人間が「色」「形」など注目点を決めて数値化します | 層を重ねる中でAIが自動的に注目点を見つけます |
| 得意なデータ | 表形式の数値データ | 画像・音声・文章など、注目点を言葉で定義しにくいデータ |
| 必要なデータ量・計算量 | 比較的少なくても動きます | 大量のデータと計算資源が必要になりやすいです |
| 説明のしやすさ | 比較的説明しやすいです | 判断根拠が見えにくい「ブラックボックス」になりやすいです |
画像認識の場合、浅い層では線や角のような単純な形、深い層に進むほど目や車輪といった複雑な部品、最終的には「猫」「車」といった全体像に反応するように、特徴が段階的に組み上がっていくと説明されています。
生成AI(ChatGPT)が文章を作る仕組み
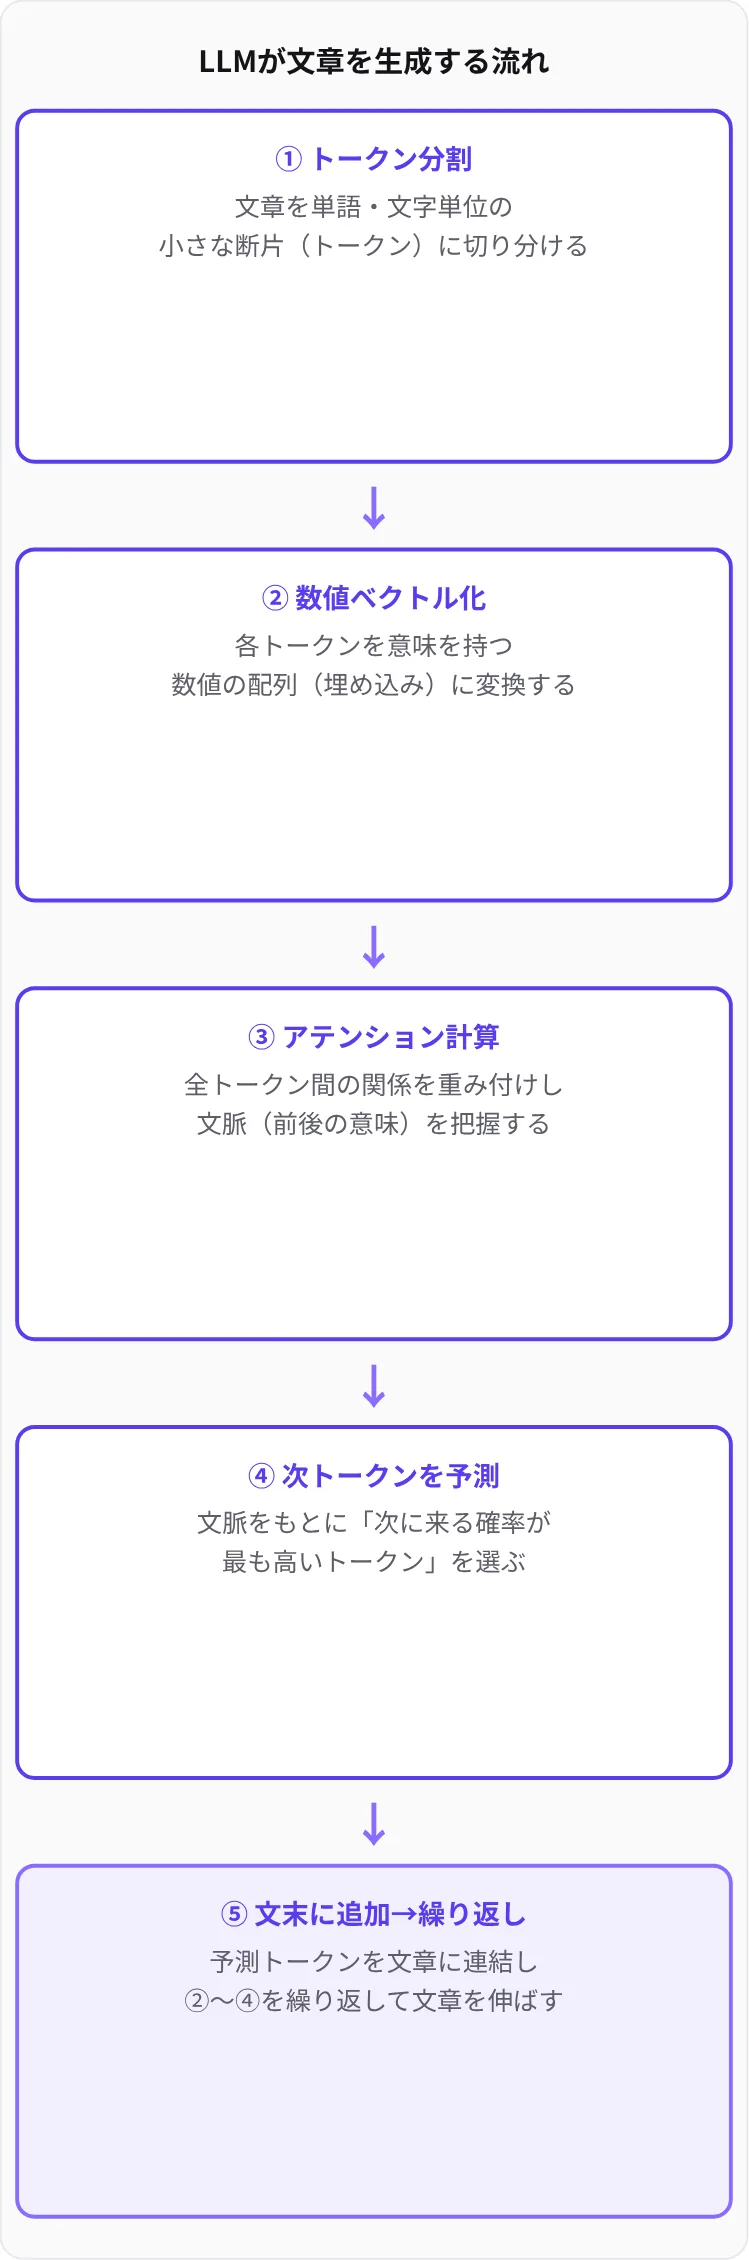
ChatGPTなどの生成AIの中核は、LLM(大規模言語モデル)です。LLMの仕組みを一言で言えば、入力された文章の続きとして「次に来る確率が高いトークン(言葉の断片)」を1つ予測し、それを文末に加えてまた次を予測する、という処理を繰り返して文章を作る仕組みです。
文部科学省のガイドラインでも、生成AIは学習データをもとに確率的にもっともらしい内容を出力するもので、誤りを含む可能性があることを前提に使うよう整理されています(出典:文部科学省「初等中等教育段階における生成AIの利活用に関するガイドライン」https://www.mext.go.jp/content/20241226-mxt_shuukyo02-000030823_003.pdf)。
トークン化と埋め込みベクトル:言葉を数値に変える
コンピュータは文字をそのまま計算できないため、LLMはまず文章をトークンと呼ばれる単位に分割します。トークンは単語そのものとは限らず、単語の一部や数文字のかたまりになることもあります。
次に、各トークンを数百〜数千個の数値の並び(埋め込みベクトル)に変換します。学習を通じて、意味の近い言葉ほど近い数値の並びになるよう調整されるため、「意味の近さ」を計算で扱えるようになります。これを意味の分散表現と呼びます。
Transformerとアテンション:文脈を読み取る仕組み
現在のLLMの多くは、2017年にGoogleの研究者らが発表したTransformerという構造を土台にしています。中心となるのがアテンション(自己注意機構)で、文中の各トークンが他のどのトークンとどれだけ関係しているかを計算し、その重みに応じて情報を混ぜ合わせます。
たとえば「彼は銀行の口座を作るため、川沿いではなく駅前の支店に行った」という文では、「支店」を処理する際に「銀行」への注目度が高くなることで、「銀行」が金融機関の意味だと文脈から判断できます。以前主流だった手法は文を前から順番に処理していましたが、アテンションは文全体を一度に見渡せるため、長い文脈を保ちやすく、並列計算で大量のデータを効率よく学習できるようになりました。
Transformerは、入力文の特徴を読み取るエンコーダと、その特徴をもとに出力文を1トークンずつ生成するデコーダから構成されます。元々は機械翻訳のために考案されましたが、その後は用途に応じて片方だけを使う形も広がりました。
| 構成 | 代表例 | 得意なこと |
|---|---|---|
| エンコーダ+デコーダ | 当初のTransformer(機械翻訳) | ある文を別の文に変換すること(翻訳・要約) |
| エンコーダのみ | BERT(2018年にGoogleが発表) | 文の意味の理解・分類・検索。文中の一部を隠して当てる「マスク言語モデル」で学習します |
| デコーダのみ | GPTシリーズなど多くの対話型LLM | 文章の続きを生成すること。「次のトークン予測」で学習します |
事前学習・ファインチューニング・RLHF:LLMが作られる3段階
| 段階 | やること | 身につく能力 |
|---|---|---|
| ①事前学習 | Webの文章や書籍など膨大なテキストで「次のトークン予測」を繰り返します | 文法・語彙・一般知識・文章の型。ただしこの段階では「文章の続きを書く」だけです |
| ②ファインチューニング(指示チューニング) | 「指示」と「模範回答」のペアで追加学習します | 質問に答える、要約する、といった指示に従う振る舞い |
| ③RLHF(人間のフィードバックによる強化学習) | 複数の回答を人間が評価し、好ましい回答が出やすくなるよう強化学習で調整します | より自然で役に立ち、有害な出力を抑えた応答 |
なお、モデルの規模・学習データ量・計算量を大きくするほど性能が予測可能な形で向上する傾向(スケーリング則)が報告されたことが、LLMの大規模化が進んだ背景の1つとされています。
確率の分布から言葉を選ぶ:同じ質問でも答えが変わる理由
LLMは次のトークンを1つに決め打ちしているのではなく、候補となる全トークンに確率を割り当てた「確率の分布」を出力しています。そこから実際の1語を選ぶ処理をサンプリングと呼びます。
- 常に最も確率の高い候補を選ぶと、答えは安定しますが単調になりやすいです。
- 確率に応じてある程度ばらつかせて選ぶと、表現は豊かになりますが、答えが毎回変わります。
- このばらつきの大きさを調整する設定は「温度(temperature)」と呼ばれ、APIなどで指定できる場合があります。
画像・音声を生成するAIとマルチモーダル
画像生成AIは文章のLLMとは別の仕組みが中心です。代表的な3つの方式は次のとおりです。
| 方式 | 仕組み | 特徴 |
|---|---|---|
| 拡散モデル | 画像に少しずつノイズを加える過程を学び、逆にノイズから少しずつ画像を復元します | 現在の画像生成AIで広く使われている方式です |
| GAN(敵対的生成ネットワーク) | 偽物を作る「生成器」と見破る「識別器」を競わせて学習します | 鮮明な画像を作れる一方、学習が不安定になりやすいです |
| VAE(変分オートエンコーダ) | データを圧縮した特徴の空間を学び、そこから新しいデータを作ります | 学習は安定しやすく、他の方式の部品としても使われます |
また、テキスト・画像・音声などを一つのモデルでまとめて扱う仕組みをマルチモーダルAIと呼びます。画像も音声も細かく区切れば数値の列として表せるため、文章と同じようにトークンとして扱い、写真の内容を説明したり、音声から議事録を作ったりできるようになっています。
AIエージェント:LLMが道具を使って作業する仕組み
AIエージェントは、LLMが質問に答えるだけでなく「目標から計画を立てる → 検索や計算などの外部ツールを呼び出す → 結果を確認して次の行動を決める」というサイクルを繰り返す仕組みです。LLM自体はあくまで次のトークンを予測していますが、その出力を「どのツールをどう使うか」の指示として解釈させることで、複数の手順にまたがる作業をこなせるようにしています。システムを自動で操作するため、権限の範囲を絞る設計が重要になります。
ハルシネーションが起きる理由と対策
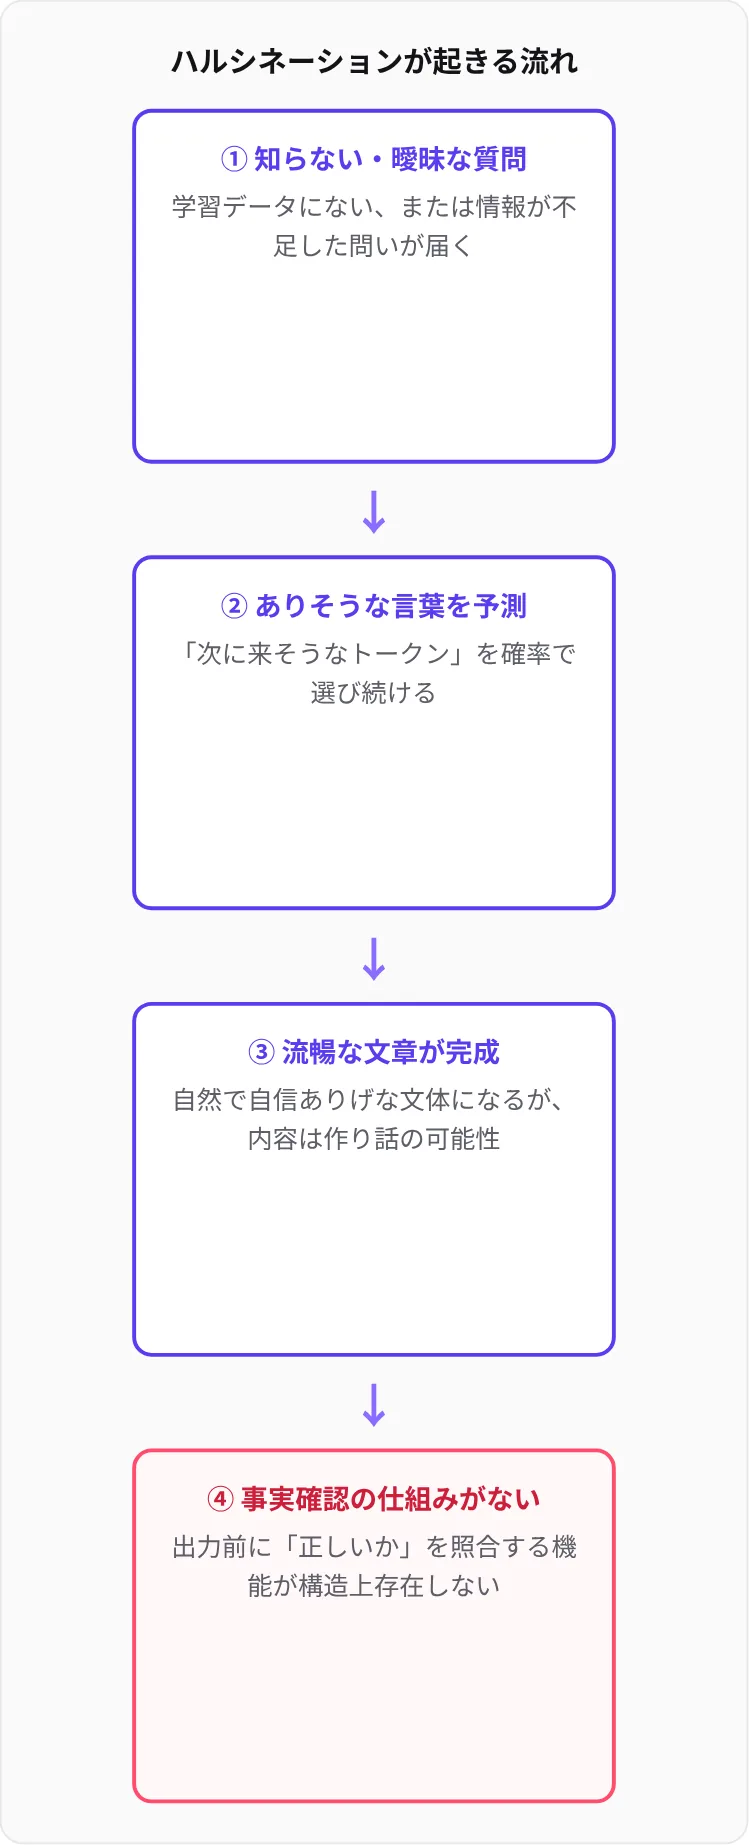
ハルシネーションとは、生成AIが事実と異なる内容をもっともらしく出力する現象です。結論として、LLMは「正しいかどうか」ではなく「文脈上ありそうかどうか」で次のトークンを選んでいるため、仕組み上ハルシネーションを完全になくすことはできません。発生する頻度を示す一次の統計は限られているため、ここでは理由と確かめ方・対策の考え方に絞って解説します。
ハルシネーションが起きる主な理由
- 確率で言葉を選ぶ仕組みであること:もっともらしい続きを生成するため、知らないことでも流暢な文章になります。
- 学習データの限界:学習データに含まれない情報、学習時点より後の情報、誤りを含む情報は正しく答えられません。
- 情報が少ないテーマ:マイナーな人物・地域・社内固有の情報などは、似た別の情報と混ざりやすくなります。
- 「答えること」を優先する調整:指示に従うよう調整されているため、「わかりません」より何らかの回答を出しやすい傾向があります。
ハルシネーションへの対策と、手法の使い分け
総務省の「生成AIはじめの一歩」でも、生成AIの回答には誤りが含まれる可能性があるため、内容を鵜呑みにせず確認することが注意点として示されています(出典:総務省 https://www.soumu.go.jp/use_the_internet_wisely/special/generativeai/)。
対策は「AIに正しい材料を渡す」か「AIの振る舞いを変える」かで整理すると選びやすくなります。代表的な3つの手法の使い分けは次のとおりです。
| 手法 | 仕組みと向いている場面 | 注意点 |
|---|---|---|
| プロンプトの工夫 | 前提条件・参照すべき資料・「不明なら不明と答える」などを指示に書きます。まず最初に試す方法です | モデルが知らない知識は補えません |
| RAG(検索拡張生成) | 質問に関連する文書を検索し、その内容を添えてLLMに回答させます。社内規程や最新情報など「知識が足りない」場合に向いています | 検索で正しい文書が見つからなければ誤答します。元の文書の品質が重要です |
| ファインチューニング(再学習) | 自社の例で追加学習し、文体・出力形式・専門的な言い回しを身につけさせます | 事実知識の追加には向きにくく、学習データの準備と再学習の手間がかかります |
判断の目安は、「答え方」を変えたいならプロンプト、「知識」を足したいならRAG、プロンプトでは揃わない「型」を大量の例から覚えさせたいならファインチューニングです。どの手法でも、重要な数値や固有名詞は出典を開いて人が確認する工程を残すことが前提になります。
生成AIを使うときの主なリスク
| リスク | 起きる理由 | 基本的な対策 |
|---|---|---|
| 情報漏洩 | 入力した内容がサービスの設定によっては学習や保存に使われる場合があります | 個人情報や機密情報を入力しない、利用規約とデータの扱いの設定を確認します |
| 著作権・権利侵害 | 学習データに似た文章や画像が生成される可能性があります | 生成物を公開・商用利用する前に、既存作品との類似を確認します |
| プロンプトインジェクション | 読み込ませた文書やWebページに隠された指示を、AIが本来の指示として実行してしまいます | 外部データを扱うAIの権限を絞り、重要な操作は人が承認する仕組みにします |
| 偏り(バイアス) | 学習データの偏りが出力に反映されます | 人の評価・採用など影響の大きい判断にそのまま使わず、人が最終判断します |
AIの仕組みを体感する:今日できる小さな実験
ここまでの仕組みは、普段使っている対話型の生成AIで実際に確かめられます。結論として、「同じ質問を繰り返す」「存在しないものを聞く」「文字を数えさせる」の3つを試すだけで、LLMの仕組みの特徴がはっきり見えてきます。どれも個人情報や機密情報を使わずにできる実験です。
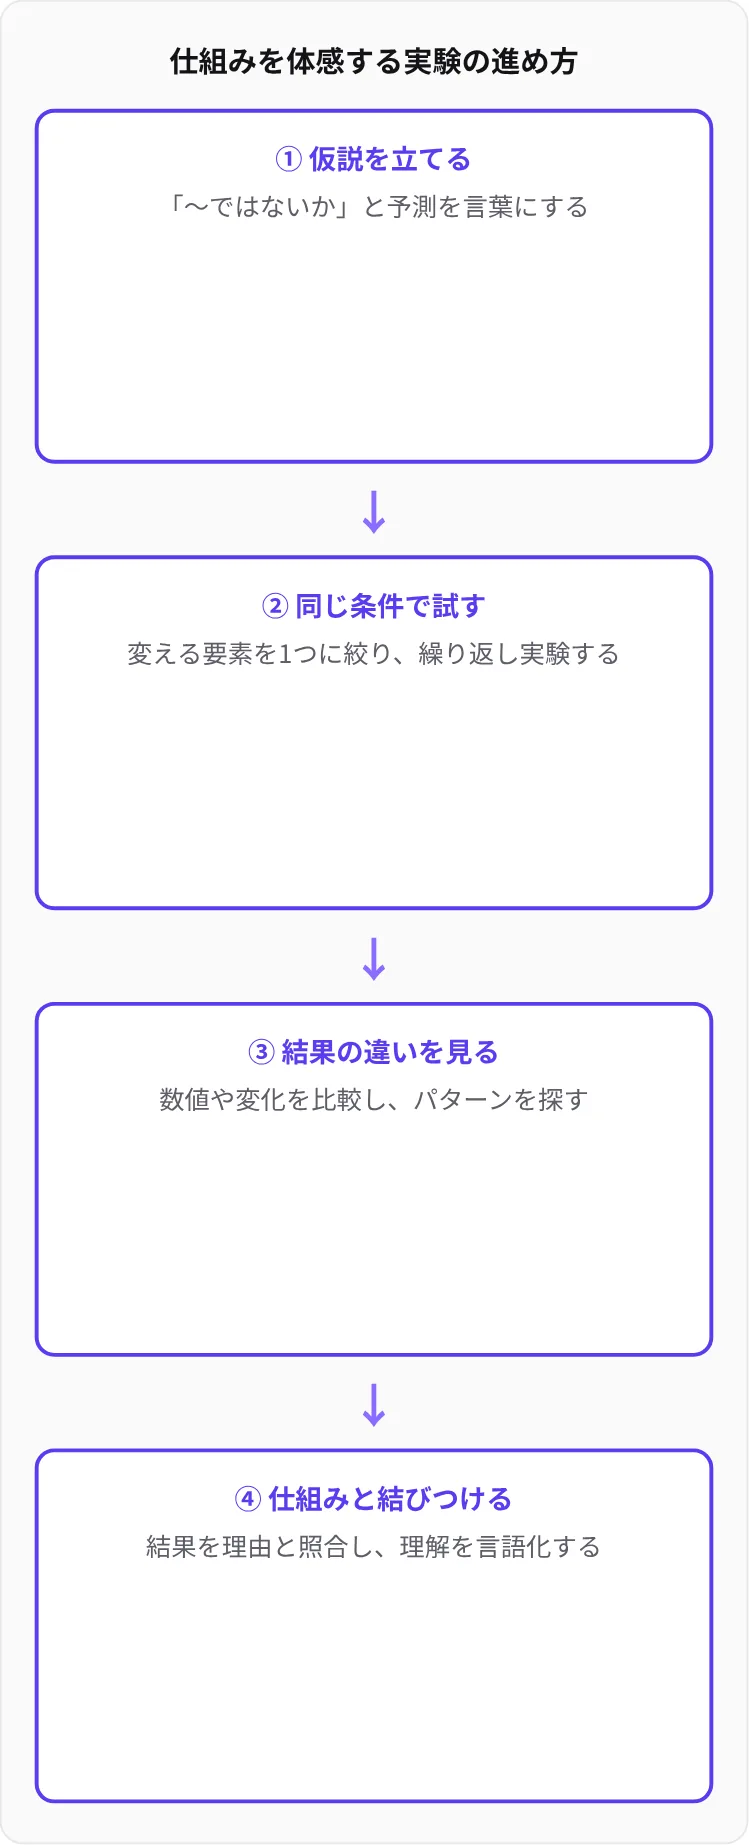
| 実験 | やり方 | 確かめられる仕組み |
|---|---|---|
| 同じ質問を繰り返す | 「新しい文房具の名前を5つ考えて」を、新しい会話で3回送ります | 答えが毎回変わることから、確率の分布から言葉をサンプリングしていることがわかります |
| 架空のものについて聞く | 自分で作った架空の本の題名を挙げ、「この本のあらすじを教えて」と聞きます | 存在しないものでも流暢に説明する場合があり、ハルシネーションの仕組みを体感できます |
| 架空と伝えたうえで聞き直す | 同じ質問に「知らない場合は知らないと答えて」と添えます | プロンプトで答え方が変わることがわかります |
| 文字数を数えさせる | 長めのカタカナ語や英単語の文字数、特定の文字の出現回数を聞きます | 文字ではなくトークン単位で処理しているため、こうした作業を苦手とする場合があることがわかります |
| 資料を貼ってから聞く | 公開されている短い文章を貼り、「この文章だけを根拠に答えて」と質問します | 根拠を渡すと回答が具体的になるという、RAGの基本的な考え方を体感できます |
| 表計算で勾配降下 | 前述の手計算の3つの式を表計算ソフトに入れ、20行ほど下へコピーします | 誤差が減っていく様子と、学習率による違いを目で確かめられます |
なお、生成AIの機能や挙動はサービスやバージョンによって異なるため、結果が上の説明どおりにならない場合もあります。その場合も「なぜこの結果になったのか」を仕組みに結びつけて考えることが、理解を深める近道になります。
AIの活用事例:仕組みごとに見る身近なAIと企業の取り組み
結論として、身近なAIの多くは、ここまで説明した「識別・予測の仕組み」と「生成の仕組み」のどちらか、または両方の組み合わせで動いています。仕組みと結びつけて事例を見ると、自分の業務にどう使えるかを考えやすくなります。
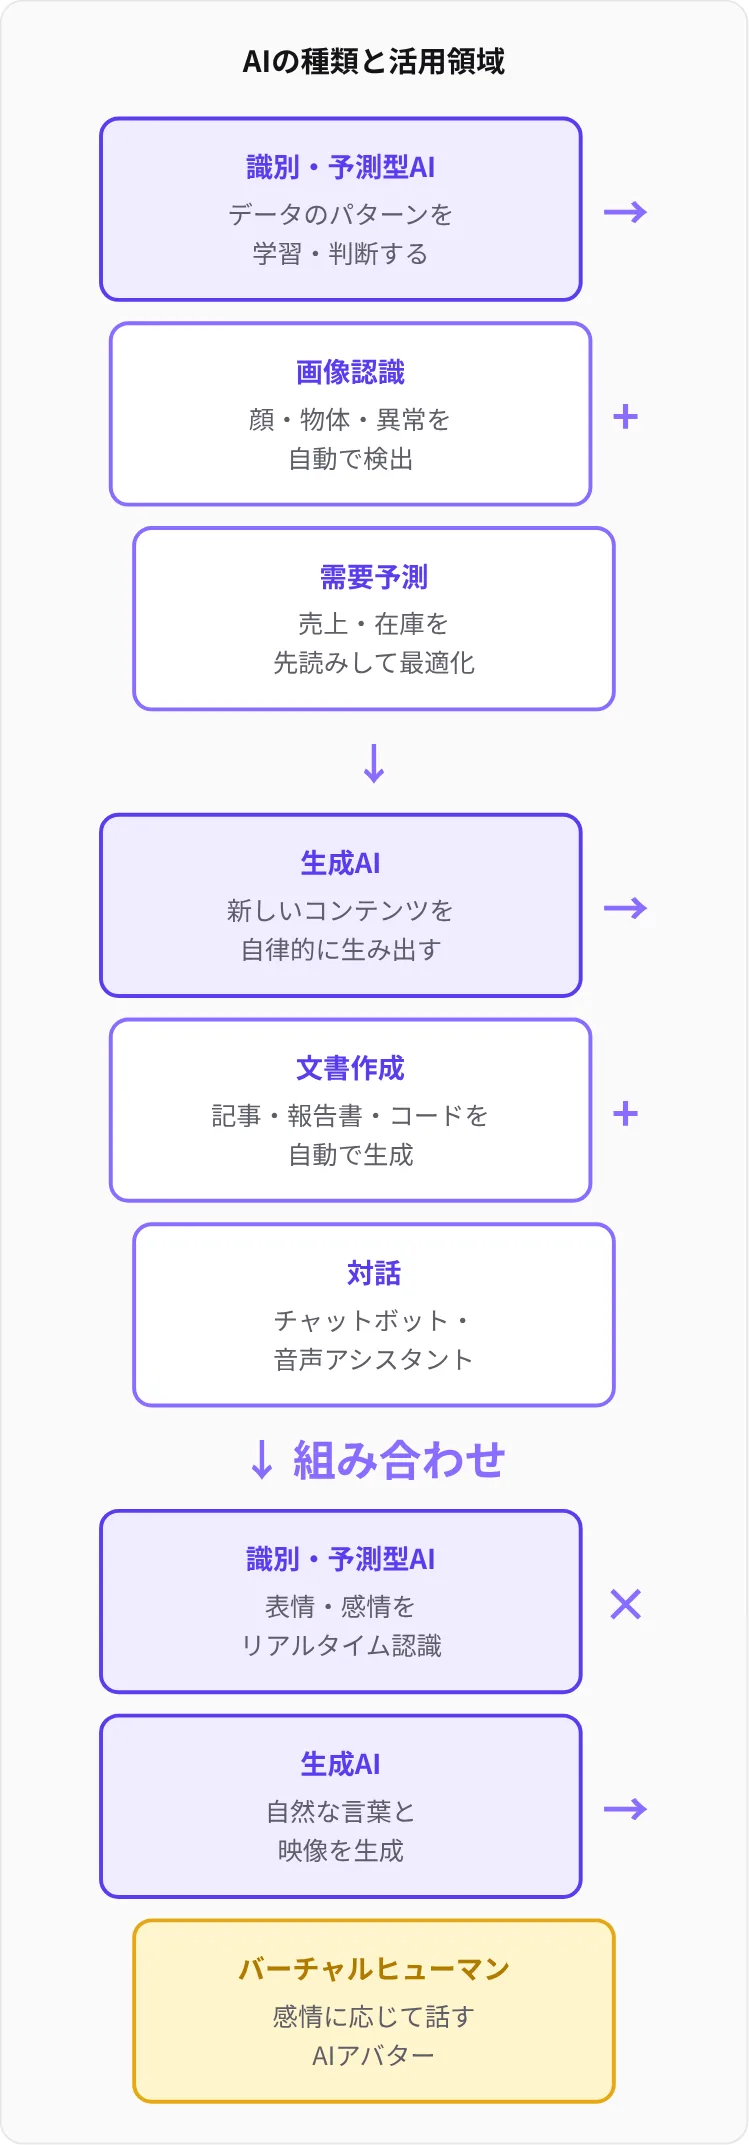
身近なAIと使われている仕組み
| 身近な例 | 使われている主な仕組み | 学習方法・ポイント |
|---|---|---|
| 製造ラインの外観検査 | ディープラーニングによる画像認識 | 良品・不良品の画像で教師あり学習します。不良品の画像が少ない場合は異常検知の考え方も使われます |
| 医療画像の読影支援 | 画像認識(病変らしき箇所の検出) | 最終的な診断は医師が行い、AIは見落とし防止などの補助として使われます |
| 小売・物流の需要予測 | 機械学習による回帰(数値の予測) | 過去の販売実績や天候などから学習し、傾向の変化に合わせて再学習が必要です |
| 動画・商品のおすすめ | レコメンド(利用履歴からの予測) | 似た行動をする利用者のパターンを学習します |
| スマートスピーカー・文字起こし | 音声認識(音声をテキストに変換) | 音の特徴と言葉の並びの両方から、最もありそうな文字列を推定します |
| 社内の問い合わせ対応 | LLM+RAG | 社内文書を検索し、その内容を根拠に回答を生成します |
企業の生成AI活用事例(公的資料より)
経済産業省の生成AI開発支援プロジェクト「GENIAC」の記事では、生成AIを利用する企業の取り組みが紹介されています(出典:経済産業省 GENIAC MAGAZINE https://www.meti.go.jp/policy/mono_info_service/geniac/geniac_magazine/usercompanies_03.html)。
| 企業 | 記事で紹介されている内容 | 仕組みの観点から見たポイント |
|---|---|---|
| アズビル株式会社 | 社員数約9,000人に対し、社内チャットボット等の利用トランザクションが1日あたり3万5,000件程度にのぼっていると紹介されています | 対話型の生成AIが、社内の日常業務で繰り返し使われる段階に入っている例です |
| 中外製薬株式会社 | 2024年に研究から営業まで全社でユースケースを募集し、約900件のアイデアから20〜30件程度を選定して推進しています。従来外注していた数千万円規模のコスト削減につながった事例も出ていると紹介されています | 「どの業務に使うか」を広く集めてから絞り込む進め方の例です |
| 楽天グループ株式会社 | 4,560万人規模の月間アクティブユーザーがおり、サービスを通じてユーザーの反応やフィードバックを得やすい環境があると紹介されています | 利用者のフィードバックが、生成AIの改善(RLHFなどの調整)の材料になるという考え方につながります |
複数の仕組みを組み合わせる例:バーチャルヒューマン
実際の製品では、ここまで紹介した仕組みが1つだけで使われることは少なく、複数のモデルを組み合わせて1つの体験を作ることが一般的です。その一例がバーチャルヒューマン(AIアバター)です。
クリスタルメソッド株式会社が開発する「DeepAI」は、実在の人物の容姿・表情・声・振る舞いをデジタル空間で再現するバーチャルヒューマン/AIアバターのソリューションです。DeepAIは実際に、リップシンク・表情生成・音声合成・対話AIなどを組み合わせており、接客・研修・面接練習・広報などの用途で活用されています。仕組みの観点で分解すると、それぞれ次の技術に対応します。
- 対話AI:この記事で解説したLLMの「次のトークン予測」で応答文を生成する部分です。
- 音声合成:テキストから声の波形を生成する、生成AIの一種です。
- リップシンク・表情生成:音声に合わせて口の動きや表情の映像を生成する部分です。
- 受講者の表情・感情の解析:DeepAIのロープレ・面接練習では、受講者の表情・感情・緊張度を発話タイムラインに沿って解析・可視化します。顔の映像から状態を読み取る、識別型AIの考え方にあたります。
このように、「生成する仕組み」と「識別する仕組み」を組み合わせることで、会話しながら相手の様子も捉えるといった、単体のモデルではできない使い方が実現されています。
まとめ
AIの仕組みは、「データから学習してモデルを作り、そのモデルで推論する」という流れに集約されます。この記事の要点は次のとおりです。
- AIは人間がルールを書く代わりに、データからルールを学ぶ仕組みです。AI ⊃ 機械学習 ⊃ ディープラーニング ⊃ 生成AIという入れ子の関係にあります。
- 機械学習には教師あり・教師なし・強化学習の3つの学び方があり、学習の正体は「誤差が減る方向に重みを少しずつ動かす」ことです。
- ディープラーニングは、層・重み・活性化関数からなるニューラルネットワークを深く重ね、特徴量を自動で見つけ出します。
- ChatGPTなどのLLMは、Transformerのアテンションで文脈を読み取り、次のトークンを予測し続けることで文章を作ります。事前学習・ファインチューニング・RLHFの3段階で作られます。
- 確率で言葉を選ぶ仕組みのため、ハルシネーションは完全には防げません。「答え方」はプロンプト、「知識」はRAG、「型」はファインチューニングで補い、重要な情報は人が出典で確認します。
- 同じ質問を繰り返す、架空のものを聞く、文字を数えさせるといった小さな実験で、仕組みの特徴を自分で確かめられます。
仕組みを理解しておくと、AIが得意なことと苦手なことを見分け、適切な使い方を選べるようになります。まずは身近な生成AIで小さな実験を試し、この記事の内容と結果を照らし合わせてみてください。
参考文献
- 総務省「令和元年版 情報通信白書|AIに関する基本的な仕組み」https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r01/html/nd113210.html
- 総務省「生成AIはじめの一歩~生成AIの入門的な使い方と注意点~」https://www.soumu.go.jp/use_the_internet_wisely/special/generativeai/
- 文部科学省「初等中等教育段階における生成AIの利活用に関するガイドライン」https://www.mext.go.jp/content/20241226-mxt_shuukyo02-000030823_003.pdf
- 経済産業省「GENIAC MAGAZINE」生成AI利用企業の取り組み https://www.meti.go.jp/policy/mono_info_service/geniac/geniac_magazine/usercompanies_03.html
Read next
あわせて読みたい
-
AIの種類とは?特化型・汎用型から生成AIまでわかりやすく解説
AIの種類とは、AI(人工知能)を「どこまでできるか(能力)」「何に使うか(用途)」「どう学ぶか(学習方式)」といった軸で分けた分類のことです。よく使われる分類...
-

ニューラルネットワークとは?仕組みと種類(DNN・RNN)をわかりやすく解説
ニューラルネットワークとは、人間の脳の神経細胞(ニューロン)が信号を伝え合う仕組みを手がかりに作られた、入力から出力への複雑な対応関係(非線形関数)をデータから...
-
CNNとは何か|畳み込みニューラルネットワークの仕組みをわかりやすく解説
CNN(Convolutional Neural Network:畳み込みニューラルネットワーク)とは、画像のような格子状のデータから、小さなフィルターを少しず...