
blog
AIブログ
ニューラルネットワークとは?仕組みと種類(DNN・RNN)をわかりやすく解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
ニューラルネットワークとは、人間の脳の神経細胞(ニューロン)が信号を伝え合う仕組みを手がかりに作られた、入力から出力への複雑な対応関係(非線形関数)をデータから学習する数理モデルです。多数の単純な計算単位を層状につなぎ、つながりの強さ(重み)を学習で調整することで、画像認識や音声認識、自然言語処理などを実現します。
この記事では、入力層・隠れ層・出力層の役割、重み・バイアス・活性化関数の意味を、実際の数値を使った計算例で確かめながら解説します。誤差逆伝播法と勾配降下法による学習の流れ、DNN・CNN・RNNなどの種類、機械学習やディープラーニングとの違い、歴史、活用例まで、機械学習を学ぶ人が次の一歩を踏み出すために必要な内容を1ページにまとめています。
ニューラルネットワークとは?脳のニューロンを模した数理モデル
結論として、ニューラルネットワークは「足し算と掛け算と簡単な変換」を大量につなぎ合わせ、その係数をデータから自動で決める仕組みです。1つ1つの計算は単純ですが、数が集まりネットワークになることで複雑な課題をこなせるようになります。
ウィキペディアの「ニューラルネットワーク」の項目では、ニューラルネットワークを「互いに信号を送り合うニューロンと呼ばれる相互接続された単位の集まり」と説明し、神経科学で扱う生物学的ニューラルネットワークと、機械学習で扱う人工ニューラルネットワークの2種類に分けています。機械学習の文脈では「非線形関数を近似するために用いられる数理モデル」と位置づけられています(出典:Wikipedia「ニューラルネットワーク」 https://ja.wikipedia.org/wiki/ニューラルネットワーク )。
生物のニューロンと人工ニューロンの対応
生物のニューロンは、シナプスを介して隣のニューロンから電気化学的な信号(活動電位)を受け取り、一定の条件で次のニューロンへ信号を送ります。人工ニューロンはこの流れを数式に置き換えたもので、対応関係は次のとおりです。
| 生物の神経系 | 人工ニューラルネットワーク | 役割 |
|---|---|---|
| ニューロン(神経細胞) | ノード(人工ニューロン) | 信号を受け取り、計算して次へ渡します |
| シナプス | ノード間の結合(エッジ) | 信号の通り道です |
| シナプスの伝達効率 | 重み(weight) | 信号をどれだけ強く伝えるかを決めます |
| 発火するかどうか | 活性化関数 | 受け取った値を出力に変換します |
ただし、現代の人工ニューラルネットワークは脳を忠実に再現したものではありません。ウィキペディアでも、パーセプトロンの登場以降は機械学習の応用に使われることが増え、生物学的な対応物との差異が次第に大きくなっていったと説明されています。「脳から着想を得た計算モデル」と理解するのが正確です。
関連記事AIが判断する仕組みとは?学習からデータ・モデル・推論まで解説 / CNNとは何か|畳み込みニューラルネットワークの仕組みをわかりやすく解説
入力層・隠れ層・出力層の構造と各層の役割
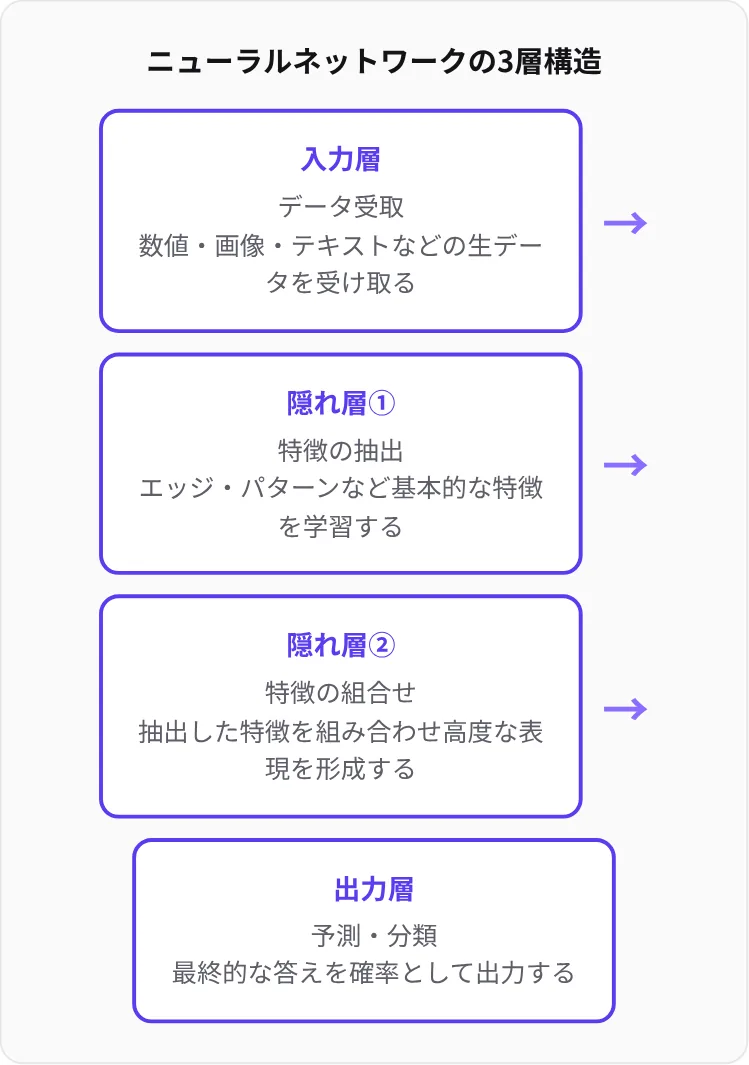
ニューラルネットワークは、データを受け取る入力層、特徴を取り出す隠れ層(中間層)、答えを出す出力層の3種類の層で構成されます。情報は入力層から隠れ層を経て出力層へ一方向に流れるのが基本形です。
| 層 | 役割 | 手書き数字認識での例 |
|---|---|---|
| 入力層 | データを数値として受け取ります。ノード数は入力データの次元数で決まります | 28×28ピクセルの画像なら784個のノードに各ピクセルの明るさを入れます |
| 隠れ層(中間層) | 重みとバイアス、活性化関数で値を変換し、データの特徴を取り出します | 線の向き、丸み、交差などの特徴を表す値を作ります |
| 出力層 | 最終的な予測や分類の結果を出します。ノード数は答えの種類で決まります | 0〜9の10クラスなら10個のノードが、それぞれの数字である確率を出します |
層数とノード数で何が決まるか
入力層と出力層のノード数は、扱うデータと解きたい問題でほぼ自動的に決まります。一方、隠れ層の数と各層のノード数は設計者が決める値(ハイパーパラメータ)です。
- 隠れ層を増やす:単純な特徴を組み合わせて、より抽象的な特徴を段階的に表現できるようになります。
- ノード数を増やす:1つの層で表現できるパターンが増えます。
- 増やしすぎの注意点:パラメータが増えるほど、学習に必要なデータ量と計算量が増え、訓練データだけに過剰に合わせる「過学習」も起きやすくなります。
実務では、小さな構成から始めて検証データでの精度を見ながら層やノードを増減させる方法が一般的です。隠れ層が多ければ必ず精度が上がるわけではない点に注意が必要です。
重み・バイアス・活性化関数:1つのニューロンが行う計算
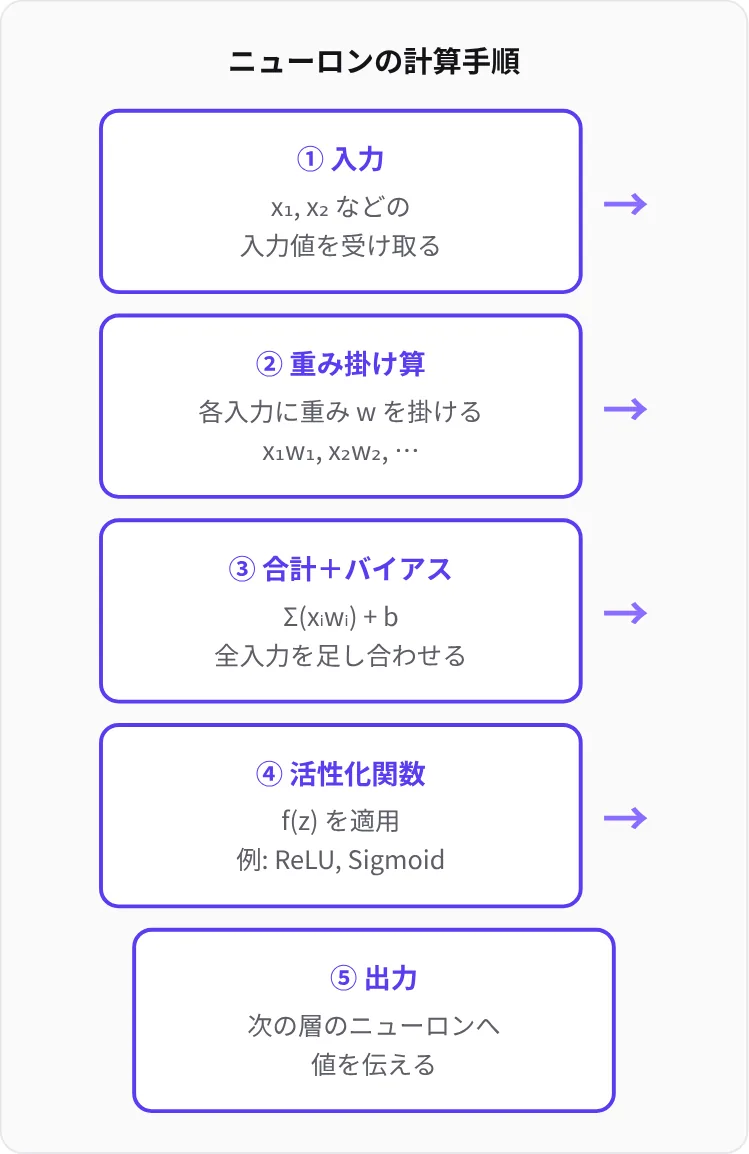
1つのニューロンの計算は「入力×重みの合計+バイアス」を求め、それを活性化関数で変換する」の2段階です。ニューラルネットワークのすべてのノードが、この同じ計算を繰り返しています。
重みとは:各入力をどれだけ重視するか
重み(w)は、ノード同士の結合の強さを表す数値です。コベソフトの解説では、重みを「各入力をどれだけ重視するか」を表す数値とし、y=w×x+b を基本形として説明しています(出典:コベソフト https://kobesoft.co.jp/tech/learn/ai-dnn-basics/03/ )。MathWorksも「重みの増減により、そのニューロンの信号の強度は変化します」と説明しており、重みは学習中に自動で調整されます(出典:MathWorks「ニューラルネットワークとは」 https://jp.mathworks.com/discovery/neural-network.html )。
- 重みが大きい正の値:その入力が出力を強く押し上げます。
- 重みが0に近い値:その入力はほとんど無視されます。
- 重みが負の値:その入力が出力を押し下げます(生物でいう抑制性の働きに近いイメージです)。
バイアスとは:重みとの違い
バイアス(b)は、入力とは無関係にノードが持つ調整用の値です。重みが「入力ごとの効き具合」を決めるのに対し、バイアスは「そのノード全体の出やすさ(基準点)」をずらします。
| 項目 | 重み(w) | バイアス(b) |
|---|---|---|
| 何に付くか | ノード間の結合1本ごと | ノード1つごと |
| 役割 | 各入力の重要度を決めます | 入力が0でも出力を調整できるよう、基準点をずらします |
| y=wx+b での意味 | 直線の傾き | 直線の切片 |
| 学習での扱い | 誤差逆伝播法で更新されます | 同じく誤差逆伝播法で更新されます |
バイアスがないと、すべての入力が0のときに出力も必ず0付近に固定されてしまい、表現できるパターンが狭くなります。
パラメータ数の数え方
コベソフトの解説では、入力2・隠れ3・出力1の構成を例に、入力→隠れの重みが2×3=6本になると説明し、バイアスを含めたパラメータ数を13としています(出典:コベソフト https://kobesoft.co.jp/tech/learn/ai-dnn-basics/03/ )。内訳は次のとおりです。
| 区間 | 重み | バイアス |
|---|---|---|
| 入力層(2)→隠れ層(3) | 2×3=6個 | 隠れ層の3個 |
| 隠れ層(3)→出力層(1) | 3×1=3個 | 出力層の1個 |
| 合計 | 9個 | 4個(総計13個) |
この数え方を使えば、層とノード数からモデルの規模を自分で見積もれます。学習とは、この13個のような値を最適な数値に調整していく作業です。
活性化関数とは:シグモイド・ReLU・Softmax
活性化関数は、「入力×重み+バイアス」の合計値を、次のノードへ渡す出力値に変換する関数です。最大の役割は非線形性を加えることです。活性化関数がない(または線形の)場合、層を何枚重ねても全体は1つの線形変換と同じになり、曲線的な境界や複雑なパターンを表現できません。
| 活性化関数 | 式と出力範囲 | 主な使いどころ |
|---|---|---|
| シグモイド関数 | 1/(1+e−x)、0〜1 | 2値分類の出力層。値を確率のように扱えます |
| ReLU(ランプ関数) | max(0, x)、0以上 | 現在の隠れ層の標準的な選択肢です。計算が軽く、勾配消失が起きにくい特徴があります |
| tanh(双曲線正接) | −1〜1 | 出力の中心を0にしたい隠れ層や、RNNの内部で使われます |
| Softmax関数 | 各出力の合計が1になる確率分布 | 多クラス分類の出力層です |
数値で確かめる:1つのニューロンの計算例
入力が x1=1.0、x2=0.5、重みが w1=0.4、w2=0.6、バイアスが b=0.1 のニューロンを考えます。
| ステップ | 計算 | 結果 |
|---|---|---|
| 1. 入力×重み | 1.0×0.4 と 0.5×0.6 | 0.4 と 0.3 |
| 2. 合計+バイアス | 0.4+0.3+0.1 | 0.8 |
| 3a. ReLUを通す | max(0, 0.8) | 0.8 |
| 3b. シグモイドを通す場合 | 1/(1+e−0.8) | 約0.69 |
このように、ニューロン1つの計算は中学・高校レベルの四則演算と指数関数で表せます。
順伝播:行列で見る計算と出力層の読み方
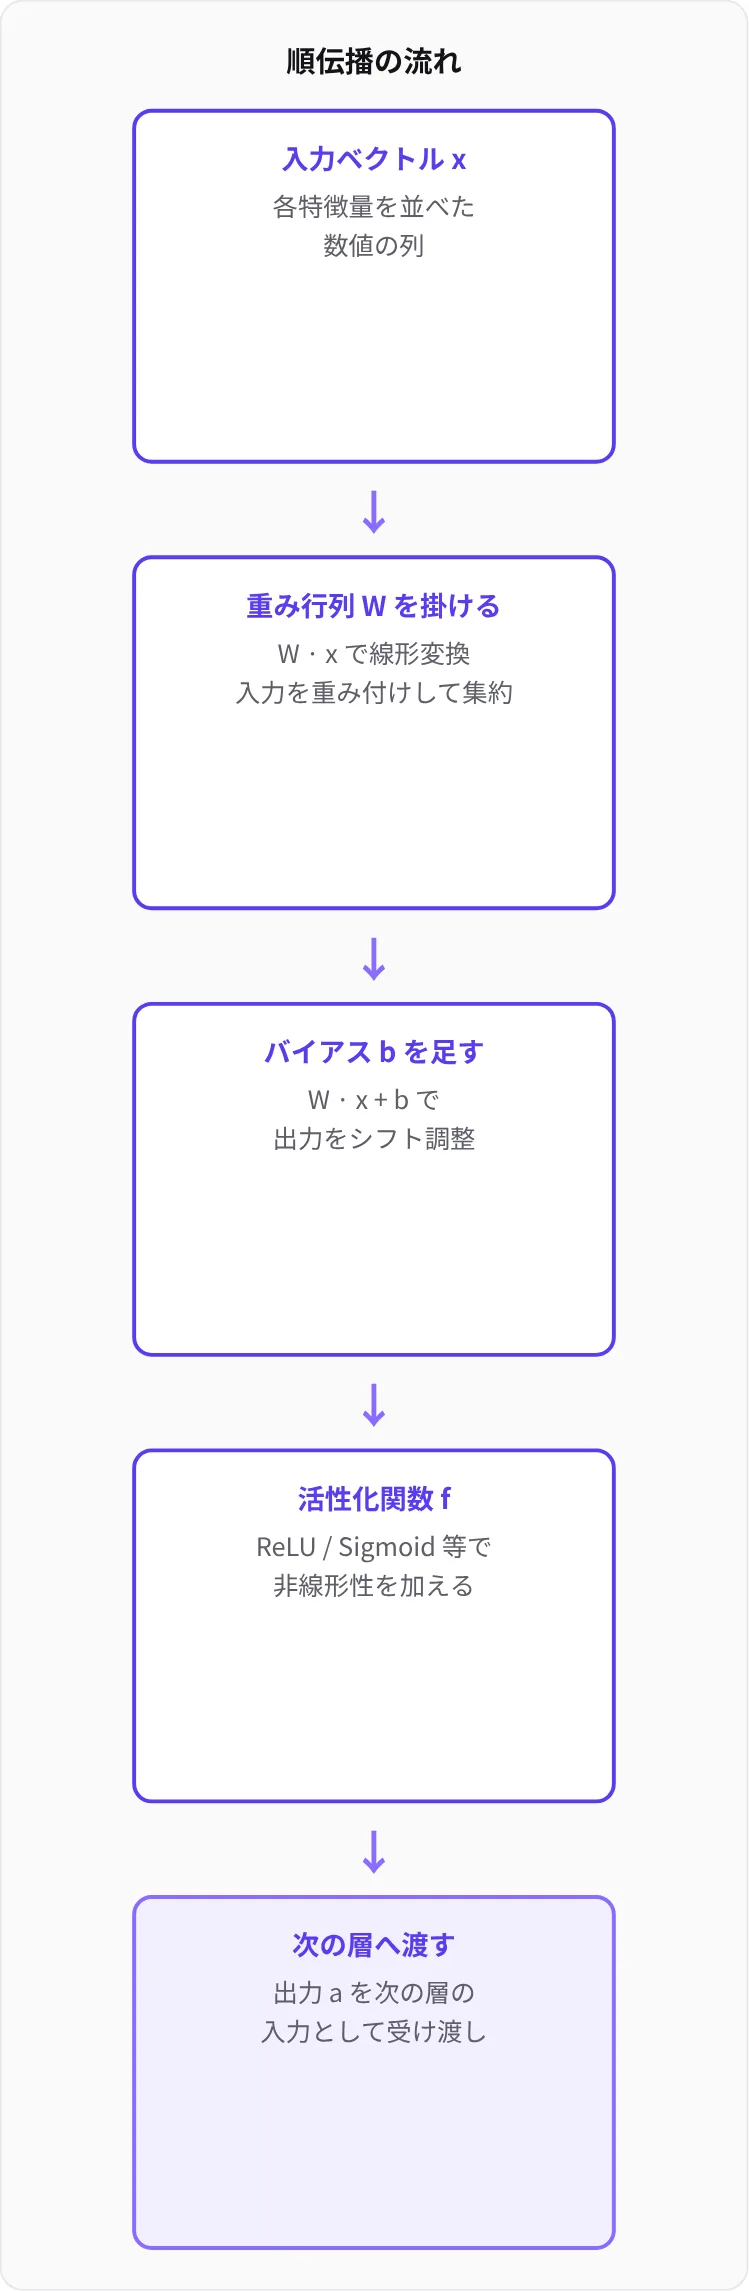
入力層から出力層へ順に計算を進めることを順伝播(フォワードプロパゲーション)といい、層ごとの計算は「行列の掛け算+ベクトルの足し算+活性化関数」でまとめて書けます。
線形変換と非線形変換
MathWorksの全結合層の説明では、「全結合層は、入力ベクトルに重み行列を乗算し、バイアス ベクトルを加算します」とされています(出典:MathWorks「fullyConnectedLayer」 https://jp.mathworks.com/help/deeplearning/ref/nnet.cnn.layer.fullyconnectedlayer.html )。式にすると次のとおりです。
- 線形変換:z = Wx + b(W:重み行列、x:入力ベクトル、b:バイアスベクトル)
- 非線形変換:h = f(z)(f:ReLUなどの活性化関数を要素ごとに適用)
- 次の層:h を新しい入力として、同じ計算を出力層まで繰り返します。
前の層のすべてのノードが次の層のすべてのノードとつながる構造を全結合型、情報が入力から出力へ一方向にだけ流れる構造をフィードフォワード型(順伝播型)と呼びます。最も基本的なニューラルネットワークは、全結合のフィードフォワード型です。行列で表せるため、GPUのような並列計算が得意なハードウェアで高速に処理できます。
Pythonで書く順伝播の例
先ほどの入力2・隠れ3・出力1の構成を、Pythonの数値計算ライブラリNumPyで書くと次のようになります。重みとバイアスの値は説明用の例です。
import numpy as np

def relu(z):
    return np.maximum(0, z)

def sigmoid(z):
    return 1 / (1 + np.exp(-z))

x  = np.array([1.0, 0.5])               # 入力(2個)
W1 = np.array([[0.4, 0.6],
               [-0.3, 0.8],
               [0.5, -0.2]])            # 入力→隠れの重み(3×2=6個)
b1 = np.array([0.1, 0.0, 0.2])          # 隠れ層のバイアス(3個)
W2 = np.array([[0.7, -0.5, 0.3]])       # 隠れ→出力の重み(1×3=3個)
b2 = np.array([0.05])                   # 出力層のバイアス(1個)

h = relu(W1 @ x + b1)                   # 隠れ層の出力
y = sigmoid(W2 @ h + b2)                # 出力(0〜1)
print(h, y)
実務では、PyTorchやTensorFlow(Keras)といったライブラリが、この計算と後述する誤差逆伝播法による勾配計算を自動で行います。ただ、最初に一度NumPyで手書きしておくと、ライブラリが内部で何をしているかを理解しやすくなります。
出力層のノード数と分類確率の読み方
多クラス分類では、出力層に「クラスの数」だけノードを置き、Softmax関数で確率に変換します。例として、「犬・猫・鳥」の3クラス分類で、出力層の値(ロジット)が 2.0、1.0、0.1 だった場合を計算します。
| クラス | ロジット → ex | Softmaxの出力(確率) |
|---|---|---|
| 犬 | 2.0 → 約7.39 | 7.39÷11.21 ≒ 0.66 |
| 猫 | 1.0 → 約2.72 | 2.72÷11.21 ≒ 0.24 |
| 鳥 | 0.1 → 約1.11 | 1.11÷11.21 ≒ 0.10 |
合計は1になり、最も確率が高い「犬(約66%)」が予測結果になります。ただし、この値はあくまでモデルの出力であり、実際に正しい確率を保証するものではありません。学習データに無い種類の画像でも、どれかのクラスに高い値を出してしまう点に注意が必要です。
学習の仕組み:損失関数・誤差逆伝播法・勾配降下法
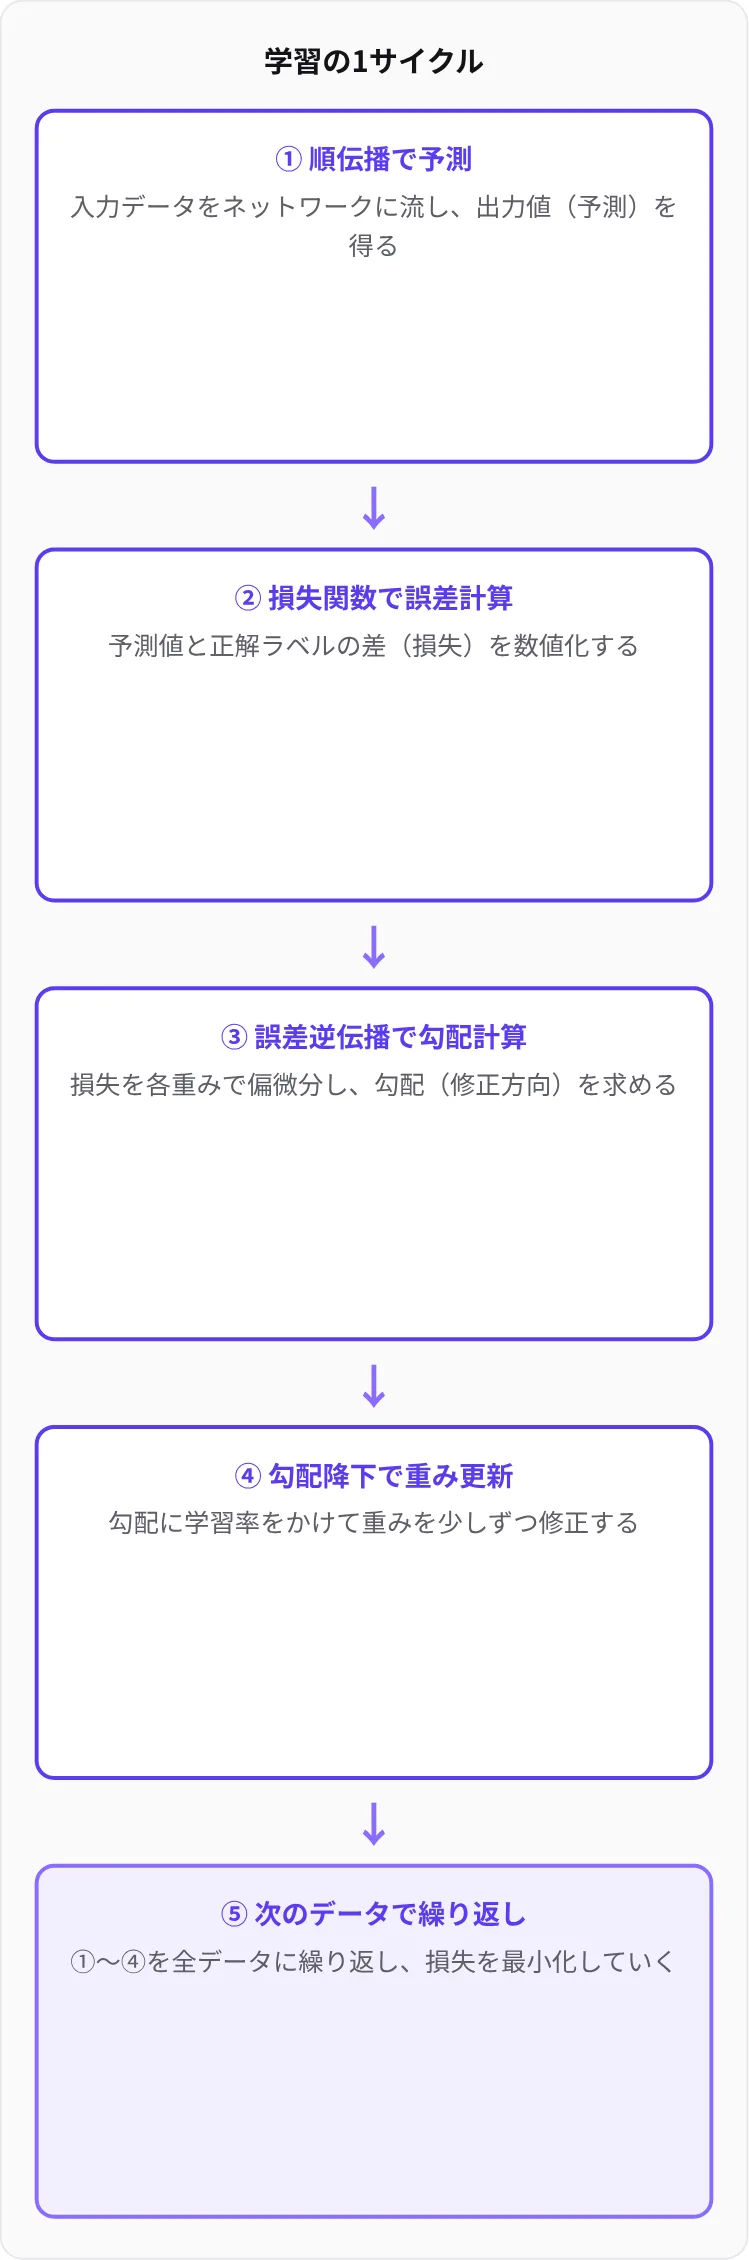
ニューラルネットワークの学習とは、「予測と正解のずれ(損失)が小さくなるように、すべての重みとバイアスを少しずつ修正する作業」を大量のデータで繰り返すことです。その中心となるのが、損失関数・誤差逆伝播法・勾配降下法の3つです。
損失関数:予測のずれを1つの数値にする
| 損失関数 | 使う場面 | 計算例 |
|---|---|---|
| 平均二乗誤差(MSE) | 数値を予測する回帰問題(売上、気温など) | 予測0.8・正解1.0なら、二乗誤差は(1.0−0.8)²=0.04です |
| 交差エントロピー誤差 | 分類問題 | 正解「犬」の予測確率が0.66なら、−ln(0.66)≒0.42です。確率が1に近づくほど0に近づきます |
誤差逆伝播法(バックプロパゲーション)
誤差逆伝播法は、出力層で求めた損失を、出力層から入力層へ逆向きにたどりながら「各重みを少し動かすと損失がどれだけ変わるか(勾配)」を効率よく計算する方法です。数学的には微分の連鎖律(合成関数の微分)を使っています。
- 出力層に近い重みから順に勾配を求めます。
- 途中の計算結果を再利用するため、何百万個の重みがあっても、順伝播と同程度のオーダーの計算量で全勾配を求められます。
- この効率の良さが、多層ネットワークの学習を現実的なものにしました。
勾配降下法と学習率による重みの更新
勾配がわかったら、損失が下がる方向へ重みを動かします。更新式は「新しい重み=今の重み−学習率×勾配」です。
| 項目 | 値 | 説明 |
|---|---|---|
| 今の重み | 0.50 | 更新前の値です |
| 勾配 | 0.20 | 正の値なので、重みを増やすと損失が増えることを意味します |
| 学習率 | 0.1 | 1回にどれだけ動かすかを決めるハイパーパラメータです |
| 新しい重み | 0.50−0.1×0.20=0.48 | 損失が下がる方向へ少し動きました |
学習率が大きすぎると最適な値を飛び越えて損失が発散し、小さすぎると学習がなかなか進みません。
確率的勾配降下法・ミニバッチ・エポック
- 確率的勾配降下法(SGD):全データではなく、ランダムに選んだ一部のデータで勾配を計算して重みを更新します。計算が軽く、大規模データでも学習を進められます。
- ミニバッチ:1回の更新に使うデータのまとまりです。例えば32件や128件ずつ処理します。
- エポック:学習データ全体を1周使い切ることを1エポックと数えます。通常は数エポック〜数百エポック繰り返します。
実際の学習では、SGDを改良したAdamなどの最適化手法もよく使われます。
教師あり学習と教師なし学習
| 学習方法 | 使うデータ | 代表的なタスク |
|---|---|---|
| 教師あり学習 | 「犬」「猫」などの正解ラベル付きデータ | 画像分類、音声認識、需要予測 |
| 教師なし学習 | 正解ラベルのないデータ | クラスタリング、次元削減、異常検知 |
| 強化学習 | 行動の結果として得られる報酬 | ゲームの攻略、ロボット制御 |
損失関数と誤差逆伝播法の仕組み自体はどの学習方法でも共通で、「何を正解として損失を測るか」が異なります。
学習を難しくする課題と対策:勾配消失・過学習・ブラックボックス
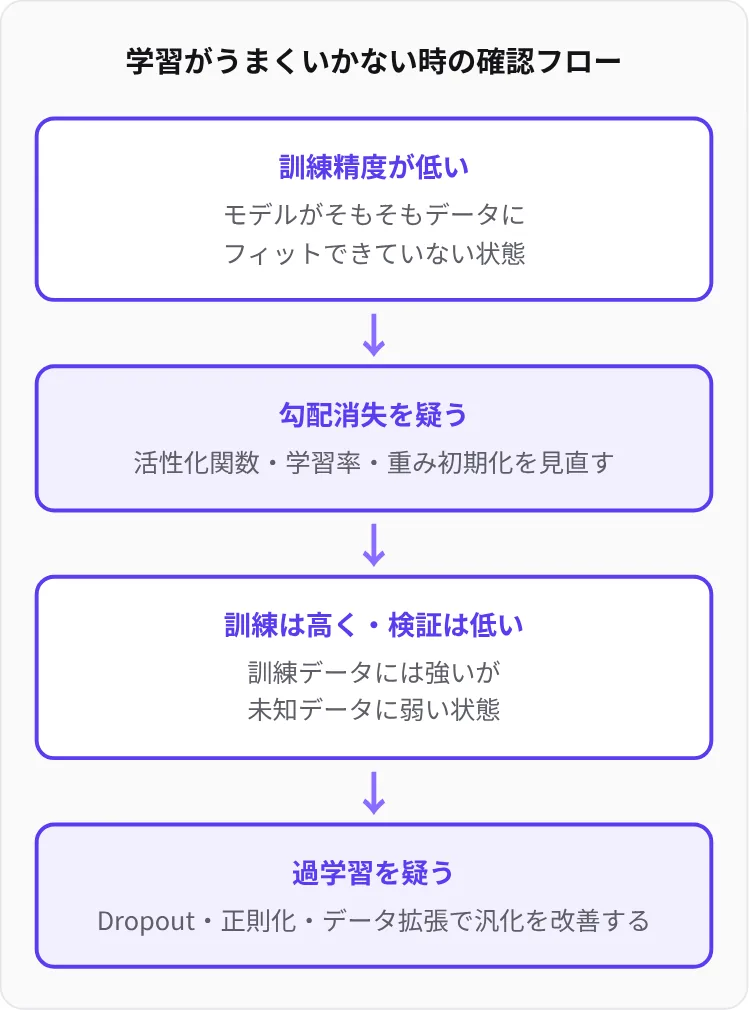
ニューラルネットワークには、層を深くすると学習が進まなくなる勾配消失、訓練データに合わせすぎる過学習、判断理由が見えにくいブラックボックス性という代表的な課題があります。それぞれに対策が研究され、実用化されています。
| 課題 | 何が起きるか | 主な対策 |
|---|---|---|
| 勾配消失問題 | 入力層に近い層ほど勾配が小さくなり、重みがほとんど更新されません | ReLUの採用、適切な重みの初期化、バッチ正規化、残差接続(スキップ接続) |
| 過学習 | 訓練データでは高精度でも、未知のデータで精度が下がります | Dropout、データの増量・水増し、正則化、早期終了 |
| 学習データ・計算資源 | パラメータが多いほど大量のデータとGPUなどの計算資源が必要です | 学習済みモデルの転移学習、モデルの小型化 |
| ブラックボックス問題 | なぜその答えになったかを人が説明しにくくなります | 説明可能なAI(XAI)の手法、判断根拠の可視化 |
勾配消失はなぜ起きるのか
誤差逆伝播法では、層をさかのぼるたびに活性化関数の微分値が掛け算されます。シグモイド関数の微分の最大値は0.25なので、10層分掛け合わせると最大でも0.2510≒0.00000095となり、入力層付近には誤差の情報がほとんど届きません。ReLUは正の領域で微分値が1のため、この減衰が起きにくく、深いネットワークの標準になりました。
Dropout法とは
Dropoutは、学習中に隠れ層のノードをランダムに一時的に無効化する手法です。特定のノードに頼りすぎることを防ぎ、ネットワーク全体で頑健な特徴を学ぶため、過学習を抑えやすくなります。推論(実際に使う)時には全ノードを使います。
ブラックボックス問題
ウィキペディアでは、人工ニューラルネットワークは内部表現の分析が難しいため「ブラックボックス」モデルと呼ばれ、特に高リスクの応用分野で解釈可能性が活発な研究領域になっていると説明されています(出典:Wikipedia「ニューラルネットワーク」)。医療や与信のように判断の根拠が問われる場面では、精度だけでなく説明可能性も評価する必要があります。
ニューラルネットワークの種類:DNN・CNN・RNN・GAN・オートエンコーダ
ニューラルネットワークは、扱うデータの形(画像、時系列、生成など)に合わせて構造を変えた多くの種類があり、代表的なのがDNN・CNN・RNN・GAN・オートエンコーダです。
| 種類 | 構造の特徴 | 得意なデータ・用途 |
|---|---|---|
| ディープニューラルネットワーク(DNN) | 隠れ層を2層以上に重ねた多層構造 | 表形式データ、各種の分類・予測。他の種類の土台です |
| 畳み込みニューラルネットワーク(CNN) | 畳み込み層とプーリング層で局所的な特徴を抽出 | 画像・動画の認識、物体検出 |
| 再帰型ニューラルネットワーク(RNN) | 隠れ層の出力を次の時刻の入力に戻す再帰構造 | 文章、音声、株価などの時系列データ |
| 敵対的生成ネットワーク(GAN) | 生成器と識別器の2つが競い合って学習 | 画像の生成、画像変換 |
| 自己符号化器(オートエンコーダ) | 入力を圧縮して復元する砂時計型の構造 | 次元削減、ノイズ除去、異常検知 |
ディープニューラルネットワーク(DNN)の定義と層数
ウィキペディアでは、深層ニューラルネットワークを「3層を超える層をもつニューラルネットワーク、すなわち典型的には入力層と出力層に加えて少なくとも2つの隠れ層をもつもの」と説明しています(出典:Wikipedia「ニューラルネットワーク」)。つまり、入力層・隠れ層2層以上・出力層の合計4層以上が目安です。現在の画像認識や言語モデルでは、数十〜100層を超える構成も使われています。
畳み込みニューラルネットワーク(CNN)
CNNは、画像の小さな領域にフィルタを少しずつずらしながら当てる「畳み込み演算」で、エッジや模様といった局所的な特徴を取り出します。全結合と違ってフィルタの重みを画像全体で共有するため、パラメータ数を大幅に抑えられます。
- 畳み込み層:フィルタで線・角・模様などの特徴マップを作ります。
- プーリング層:特徴マップを縮小し、位置の小さなずれに強くします。
- 全結合層:抽出した特徴をもとに、最終的な分類を行います。
浅い層では線や色、深い層では目や車輪のような部品、さらに深い層では物体全体というように、層が進むほど抽象的な特徴を学習する傾向があります。
再帰型(リカレント)ニューラルネットワーク(RNN)
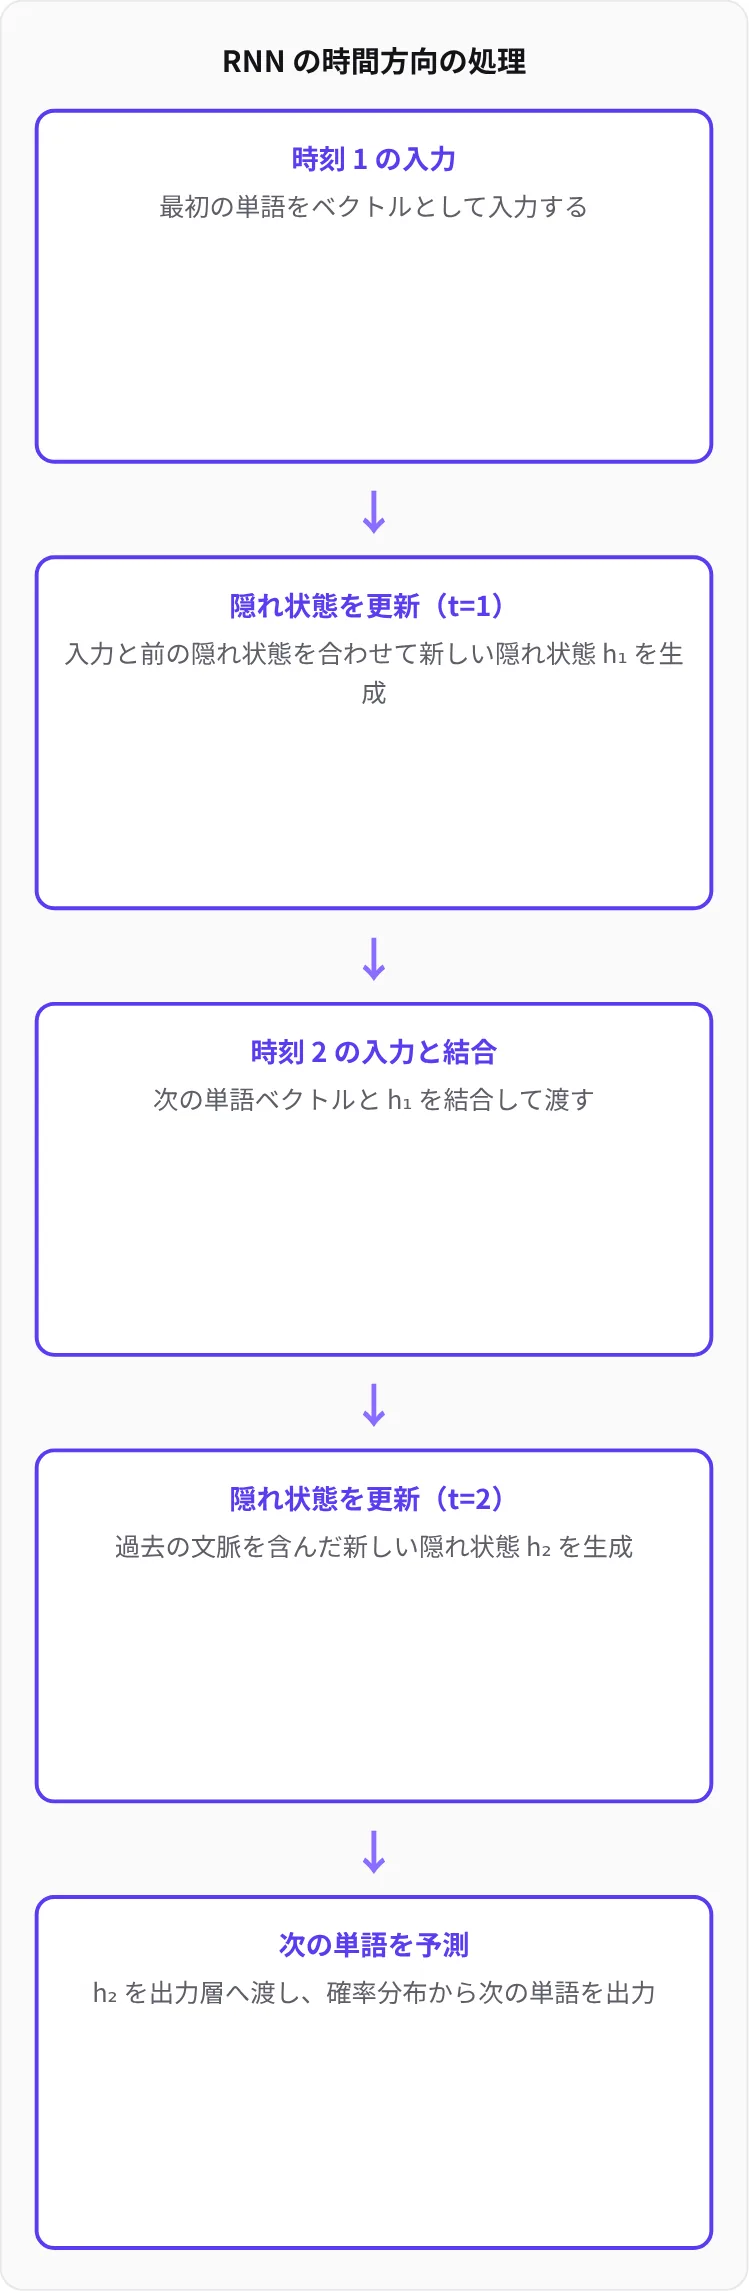
RNNは、ある時刻の隠れ層の状態を次の時刻にも渡すことで、「それまでに何が入力されたか」を記憶しながら処理します。「私は昨日ラーメンを」の次に「食べた」が来やすいと予測するには、前の単語の情報が必要であり、こうした順序のあるデータに向いています。
- 課題:長い系列では、時間をさかのぼるほど勾配が消えやすく、遠い過去の情報を覚えにくくなります。
- 改良版:情報を残す・忘れるを制御する「ゲート」を持つLSTMやGRUが、長期の依存関係を扱えるように開発されました。
- 現在の主流:自然言語処理では、系列全体を並列に処理できるTransformerという構造が主流になり、大規模言語モデルの基盤になっています。一方、RNN系は時系列の仕組みを理解する基本として今も重要です。
GAN・オートエンコーダ・スパイキングニューラルネットワーク
- GAN:生成器が偽のデータを作り、識別器が本物か偽物かを見分けます。両者が競い合うことで、生成器は本物に近いデータを作れるようになります。
- オートエンコーダ:入力より少ないノード数の中間層に情報を圧縮してから復元します。復元に必要な本質的な特徴だけが中間層に残るため、正常データだけで学習し、うまく復元できないデータを異常とみなす異常検知にも使われます。
- スパイキングニューラルネットワーク(SNN):連続値ではなく、生物のニューロンのような離散的な「スパイク(パルス)」のタイミングで情報を伝えるモデルです。省電力な専用ハードウェア(ニューロモーフィックチップ)との組み合わせが研究されていますが、一般的なDNNと比べると学習手法はまだ発展途上の領域です。
機械学習・ディープラーニングとの違い
包含関係で整理すると、「AI(人工知能)⊃ 機械学習 ⊃ ニューラルネットワーク ⊃ ディープラーニング」です。ニューラルネットワークは機械学習の手法の1つであり、その中で隠れ層を多層化したものを使う学習がディープラーニング(深層学習)です。
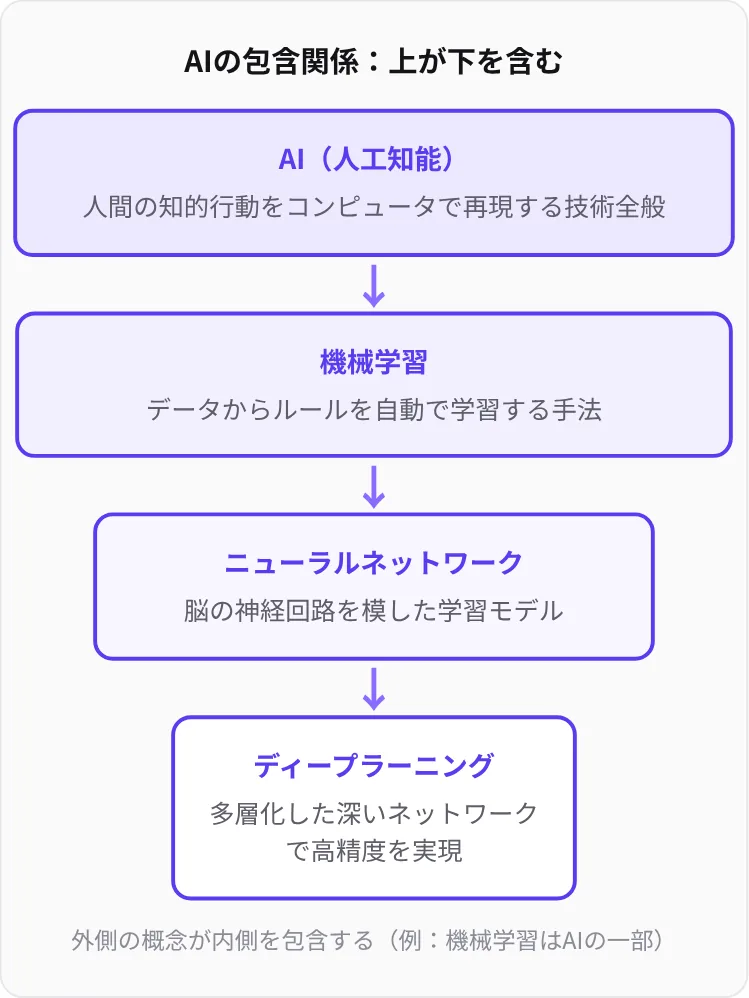
| 比較項目 | 従来の機械学習(決定木、SVMなど) | ディープラーニング(多層ニューラルネットワーク) |
|---|---|---|
| 特徴量の設計 | 人が「どこに注目するか」を設計して与えることが多いです | 生データから特徴そのものをモデルが学習します |
| 得意なデータ | 件数が中程度の表形式データ | 画像・音声・テキストなどの非構造化データ |
| 必要なデータ量 | 比較的少量でも機能します | 大量のデータで性能を発揮しやすいです |
| 計算資源 | 一般的なCPUで十分な場合が多いです | GPUなどの並列計算資源が必要になりやすいです |
| 解釈のしやすさ | 手法によっては判断根拠を説明しやすいです | 内部が複雑で説明が難しい傾向があります |
なお、隠れ層が1層程度の浅いニューラルネットワークは、ディープラーニングとは呼ばないのが一般的です。表形式の少量データでは、従来の機械学習のほうが精度・速度・説明性のバランスで優れる場面も多く、「ニューラルネットワークが常に最良」というわけではありません。
ニューラルネットワークの歴史:形式ニューロンからディープラーニングまで
ニューラルネットワークは、1940年代の数理モデルから始まり、「AIの冬」と呼ばれる停滞期を経て、誤差逆伝播法と計算資源・データの進歩によって再興しました。以下の年代と出来事は、ウィキペディア「ニューラルネットワーク」の歴史の記述に基づいています。
| 年代 | 出来事 | 意味 |
|---|---|---|
| 1943年 | マカロックとピッツが人工ニューロンの数理モデル(形式ニューロン)を提唱 | ニューロンを論理計算として表現できることを示しました |
| 1949年 | ヘッブが「信号がシナプスを通るたびにそのシナプスが強化される」という学習の考え方(ヘッブ則)を提唱 | 重みを学習で変えるという発想の生物学的な根拠になりました |
| 1958年〜1950年代末 | ローゼンブラットがパーセプトロンを発表し、ハードウェアで実装 | データから重みを学習する初期のモデルです |
| 1969年 | ミンスキーとパパートが著書『パーセプトロン』で単層パーセプトロンの限界を分析 | 研究への資金と関心が減退する「AIの冬」につながりました |
| 1980年代 | 誤差逆伝播法で学習する多層ネットワークが開発・普及 | 多層化による表現力の向上で研究が復活しました |
| 2000年代以降 | 大規模データセット、GPUなどの高速ハードウェア、アルゴリズムの進歩 | ディープラーニングの台頭をもたらしました |
パーセプトロンの限界:線形分離不可能な問題
単層パーセプトロンは、データを1本の直線(高次元では平面)で2つに分ける問題しか解けません。代表例がXOR(排他的論理和)です。
| 入力(x1, x2) | XORの出力 | 単層での扱い |
|---|---|---|
| (0, 0) と (1, 1) | 0 | 対角線上に同じ答えが並ぶため、直線1本では0と1を分けられません |
| (0, 1) と (1, 0) | 1 |
隠れ層を1層加え、非線形の活性化関数を使うと、XORは解けるようになります。「隠れ層と非線形性が表現力の源である」ことを示す、最もわかりやすい例です。
ニューラルネットワークの活用例:画像認識・自然言語処理・音声認識ほか
ニューラルネットワークは、人がルールを書き下すのが難しい「見る・聞く・読む・予測する」タスクで特に力を発揮し、現在のAIシステムの多くを支えています。ウィキペディアでも、予測モデリング、適応制御、顔認識、手書き文字認識、汎用ゲームプレイ、生成AIなどへの応用が挙げられています。
| 分野 | 具体例 | 主に使われる構造 |
|---|---|---|
| 画像認識・コンピュータビジョン | 顔認証、自動運転での歩行者・車線の認識、医用画像の診断支援、手書き文字認識 | CNN、Transformer |
| 自然言語処理・機械翻訳 | 文脈を考慮した翻訳、文章の要約、対話AI、文章の分類 | RNN(LSTM)、Transformer |
| 音声認識・音声合成 | スマートフォンの音声アシスタント、会議の文字起こし、自然な読み上げ音声 | RNN、CNN、Transformer |
| 金融・需要予測 | 株価や為替の予測、不正取引の検知、電力・商品の需要予測 | DNN、RNN |
| レコメンデーション | 動画・商品のおすすめ表示 | DNN |
| コンテンツモデレーション | SNSや掲示板の誹謗中傷・不適切投稿の自動検出 | テキスト分類モデル、画像分類モデル |
ただし、株価予測のように将来が多くの外部要因に左右される分野では、ニューラルネットワークを使っても予測が当たり続ける保証はありません。医療や自動運転では、モデルの誤りが重大な結果につながるため、人による確認や安全設計と組み合わせて使われます。
バーチャルヒューマンを支える技術領域
人の容姿や声をデジタル空間で再現する技術も、ニューラルネットワークの応用が進む分野です。DeepAIは実際に、実在の人物の容姿・表情・声・振る舞いをデジタル空間で再現するバーチャルヒューマン/AIアバターのソリューションとして、リップシンク・表情生成・音声合成・対話AIなどを組み合わせ、接客・研修・面接練習・広報などの用途で活用されています。また、DeepAIのロープレや面接練習では、MediaPipeによる顔解析を対話と連動させ、受講者の表情・感情・緊張度を発話タイムラインに沿って解析・可視化します。音声合成や対話AI、顔の解析といった要素技術は、いずれもニューラルネットワークの研究が大きく進めてきた領域です。
ニューラルネットワークを学ぶための数学とPythonの準備
ニューラルネットワークを仕組みから理解するには、線形代数・微分・確率統計の基礎と、PythonおよびNumPyの基本操作があれば十分に始められます。この記事で扱った計算と、必要な知識の対応は次のとおりです。
| 分野 | 必要な範囲 | 使われる場面 |
|---|---|---|
| 線形代数 | ベクトル、行列の積、転置 | 順伝播の z = Wx + b の計算 |
| 微分 | 偏微分、合成関数の微分(連鎖律) | 誤差逆伝播法による勾配の計算 |
| 確率・統計 | 確率分布、対数、平均・分散 | Softmax、交差エントロピー誤差、データの正規化 |
| Python | NumPyの配列操作、関数の定義 | 小さなネットワークの手書き実装 |
おすすめの学習順は次のとおりです。
- 1つのニューロンの計算(重み・バイアス・活性化関数)を手計算で確かめます。
- NumPyで順伝播を書き、パラメータ数を自分で数えます。
- 損失関数と勾配降下法で、1つの重みが更新される様子を追います。
- PyTorchやTensorFlow(Keras)で手書き数字認識などの小さな課題を学習させます。
- CNNやRNNなど、データの種類に合わせた構造へ進みます。
まとめ
- ニューラルネットワークとは、脳のニューロンから着想を得た、入力と出力の複雑な関係をデータから学習する数理モデルです。
- 入力層・隠れ層・出力層で構成され、各ノードは「入力×重みの合計+バイアス」を活性化関数で変換して次へ渡します。
- 重みは各入力の重要度、バイアスは基準点の調整、活性化関数は非線形性を担います。
- 学習は、損失関数でずれを測り、誤差逆伝播法で勾配を求め、勾配降下法で重みを更新する流れを繰り返します。
- 勾配消失・過学習・ブラックボックス性といった課題には、ReLU、Dropout、説明可能なAIなどの対策があります。
- 隠れ層を2層以上重ねたものがDNNで、画像向けのCNN、時系列向けのRNN、生成向けのGAN、圧縮・復元のオートエンコーダなどの種類があります。
- 機械学習の一手法であり、多層化したものを使う学習がディープラーニングです。画像認識、自然言語処理、音声認識、需要予測など幅広い分野で使われています。
まずは1つのニューロンの計算を手で確かめ、NumPyで順伝播を書いてみることが、ニューラルネットワークを「わかったつもり」から「説明できる」へ進める最短の一歩です。
参考文献
- Wikipedia「ニューラルネットワーク」(2026年11月閲覧) https://ja.wikipedia.org/wiki/ニューラルネットワーク
- MathWorks「ニューラルネットワークとは」(2026年11月閲覧) https://jp.mathworks.com/discovery/neural-network.html
- MathWorks「fullyConnectedLayer(全結合層)」(2026年11月閲覧) https://jp.mathworks.com/help/deeplearning/ref/nnet.cnn.layer.fullyconnectedlayer.html
- コベソフト「AI・DNNの基礎 第3回」(2026年11月閲覧) https://kobesoft.co.jp/tech/learn/ai-dnn-basics/03/
Read next
あわせて読みたい
-
AIの種類とは?特化型・汎用型から生成AIまでわかりやすく解説
AIの種類とは、AI(人工知能)を「どこまでできるか(能力)」「何に使うか(用途)」「どう学ぶか(学習方式)」といった軸で分けた分類のことです。よく使われる分類...
-

AIが判断する仕組みとは?学習からデータ・モデル・推論まで解説
AIの仕組みとは、大量のデータから規則性を学んで「モデル」を作り(学習)、そのモデルに新しいデータを入力して答えを出す(推論)という2段階の流れのことです。Ch...
-
CNNとは何か|畳み込みニューラルネットワークの仕組みをわかりやすく解説
CNN(Convolutional Neural Network:畳み込みニューラルネットワーク)とは、画像のような格子状のデータから、小さなフィルターを少しず...