
blog
AIブログ
CNNとは何か|畳み込みニューラルネットワークの仕組みをわかりやすく解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
CNN(Convolutional Neural Network:畳み込みニューラルネットワーク)とは、画像のような格子状のデータから、小さなフィルターを少しずつずらしながら掛け合わせる「畳み込み」で特徴を自動的に取り出し、分類や検出を行うディープラーニングのモデルです。英語圏では「ConvNet」とも呼ばれ、画像認識・物体検出・医療画像診断・自動運転など、コンピュータビジョンの多くの場面で使われています。
この記事では、画像系を学ぶ方やエンジニアの方に向けて、CNNの定義と構造、畳み込み層とプーリング層の計算の中身、学習の方法、代表的なモデル、活用例、他のニューラルネットワークとの違いまでを、数式と具体例を交えて解説します。
CNNとは?定義とディープラーニングの中での位置づけ
結論から言うと、CNNは「ニューラルネットワーク」の一種で、層を深く重ねる「ディープラーニング」の代表的なモデルです。特徴は、畳み込み層とプーリング層という画像向けの専用の層を持つ点にあります。
一般的なニューラルネットワークは、入力のすべての値を次の層のすべてのニューロンにつなぐ「全結合」で構成されます。これに対してCNNは、画像の中の近い画素どうしの関係(エッジ・色の変化・模様など)に注目し、狭い範囲ごとに同じフィルターを当てて特徴を取り出します。この「畳み込み」を主な処理とすることから、畳み込みニューラルネットワークと呼ばれます。
| 用語 | 意味 | CNNとの関係 |
|---|---|---|
| 人工知能(AI) | 人の知的な働きをコンピュータで実現する技術の総称 | 最も広い枠組み |
| 機械学習 | データから規則やパターンを学習する手法 | CNNは機械学習の一手法 |
| ニューラルネットワーク | 脳の神経回路を模した計算モデル | CNNはその一種 |
| ディープラーニング | 多数の層を重ねたニューラルネットワーク | CNNは代表的なモデル |
| CNN(ConvNet) | 畳み込みとプーリングで特徴を抽出するモデル | 画像・格子状データに強い |
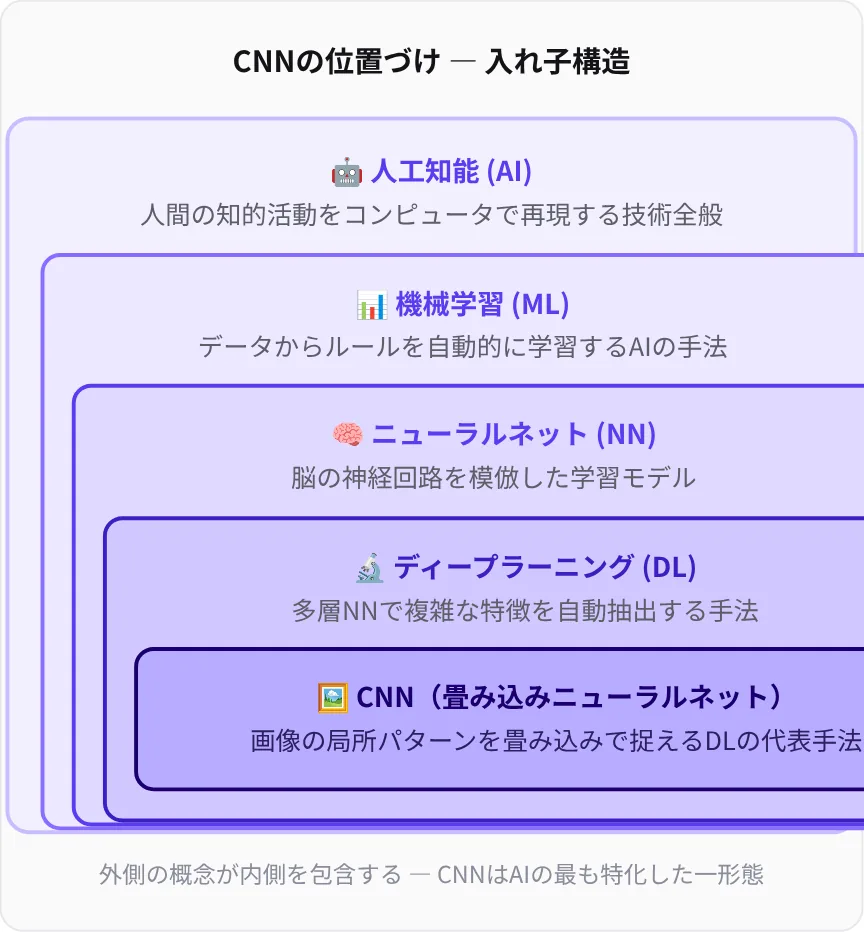
- 正式名称:Convolutional Neural Network(畳み込みニューラルネットワーク)
- 略称:CNN、ConvNet
- 得意なデータ:画像、動画のフレーム、音声のスペクトログラム、時系列信号など、近い位置どうしに意味のつながりがあるデータ
- 主な用途:画像分類、物体検出、セグメンテーション、医療画像診断、自動運転の周辺認識など
関連記事AIが判断する仕組みとは?学習からデータ・モデル・推論まで解説 / ニューラルネットワークとは?仕組みと種類(DNN・RNN)をわかりやすく解説
なぜCNNが必要なのか:全結合層と手作業の特徴抽出の弱点
CNNが生まれた理由は、画像をそのまま全結合のネットワークに入れると「パラメータが多すぎる」「位置がずれると認識できない」という2つの問題が起きるためです。CNNはこの両方を、局所的な結合と重み共有によって解決します。
問題1:パラメータ数が膨大になる
たとえば縦224×横224画素のカラー画像(RGBの3チャンネル)は、224×224×3=150,528個の数値でできています。これを1次元に並べて、1,000個のニューロンを持つ全結合層につなぐと、重みだけで150,528×1,000=約1億5,000万個になります。
一方、3×3の大きさのフィルターを64枚使う畳み込み層なら、重みは3×3×3(入力チャンネル)×64=1,728個、バイアス64個を加えても1,792個で済みます。画像の大きさが変わってもフィルターの数は変わらないため、大きな画像でも現実的な計算量で学習できます。
| 比較項目 | 全結合層 | 畳み込み層 |
|---|---|---|
| 結合の範囲 | 入力のすべての画素 | フィルターが覆う狭い範囲だけ |
| 重みの扱い | 位置ごとに別の重み | 画像全体で同じ重みを共有 |
| 224×224×3入力の例 | 約1億5,000万(1,000ユニット) | 1,792(3×3フィルター64枚) |
| 位置のずれへの強さ | 弱い | 強い |
問題2:物体の位置がずれると別物として扱ってしまう
全結合層では、画像の左上の画素と右下の画素にそれぞれ別の重みが割り当てられます。そのため、画像の左上に猫が写った写真で学習したモデルは、同じ猫が右下に写った写真を同じように認識できるとは限りません。画素の位置と重みが一対一で結びついているためです。
CNNは、同じフィルターを画像全体にずらしながら当てるため、猫の耳の形を検出するフィルターは、耳が画像のどこにあっても反応します。さらにプーリング層で細かな位置の情報をまとめることで、多少の位置ずれがあっても同じ特徴として扱えるようになります。この性質は「移動不変性(位置不変性)」と呼ばれます。
手作業による特徴抽出との違い
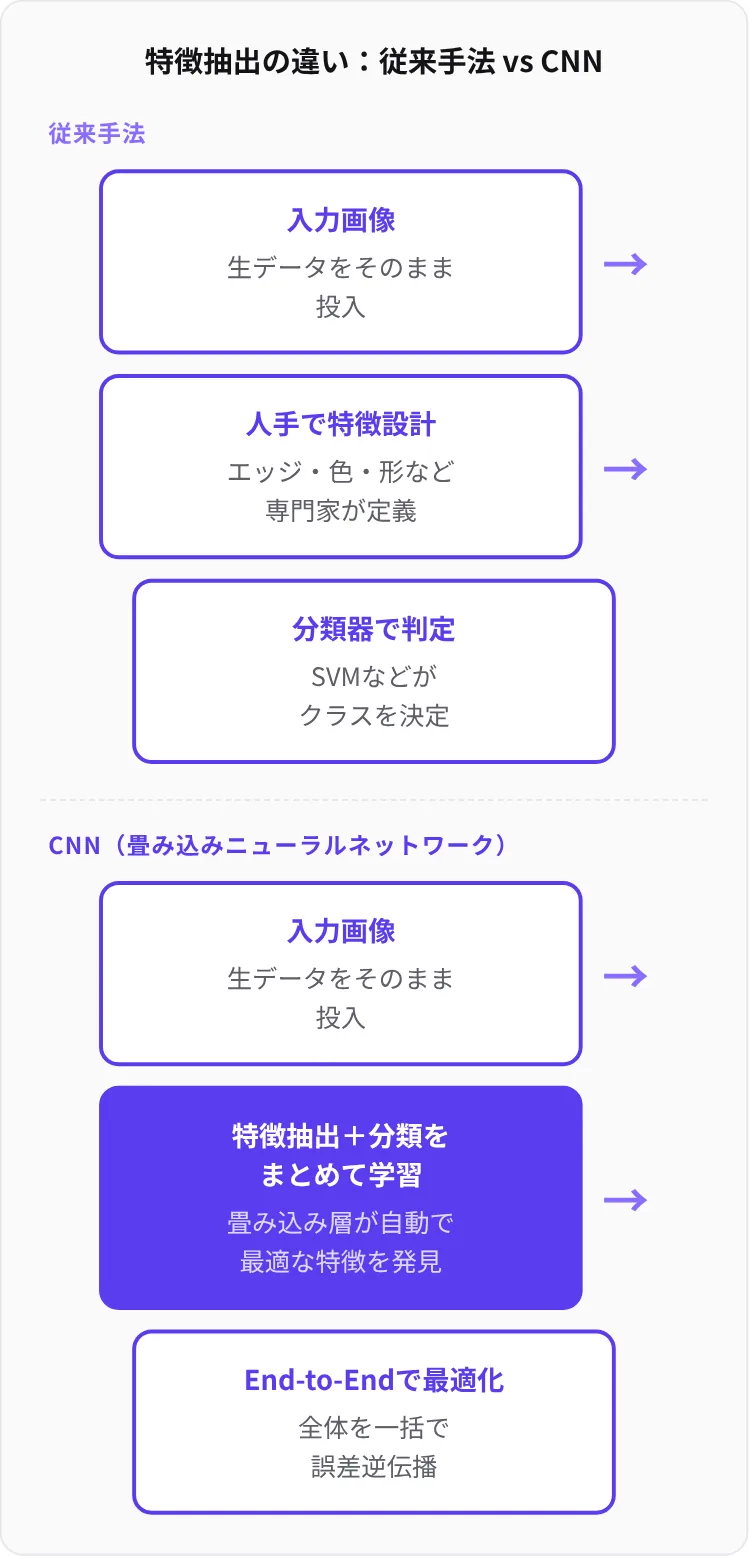
CNNが普及する前の画像認識では、エッジの向きの分布を数えるHOG特徴量や、回転・拡大に強い特徴点を求めるSIFTなど、人が設計した特徴量を画像から計算し、それをSVMなどの分類器に渡す方法が主流でした。この方法では、どの特徴が認識に効くかを人が考える必要があり、対象が変わるたびに設計をやり直す手間がかかりました。
CNNは、フィルターの値そのものをデータから学習します。「何を特徴とみなすか」をモデルが自分で見つけるため、特徴の設計と分類を一つのネットワークでまとめて最適化できます。
CNNの基本構造:入力から出力までの流れ
CNNは、入力層・畳み込み層・プーリング層・全結合層・出力層を順に重ねた構造をしています。前半の畳み込み層とプーリング層が「特徴を取り出す部分」、後半の全結合層と出力層が「取り出した特徴から答えを決める部分」です。
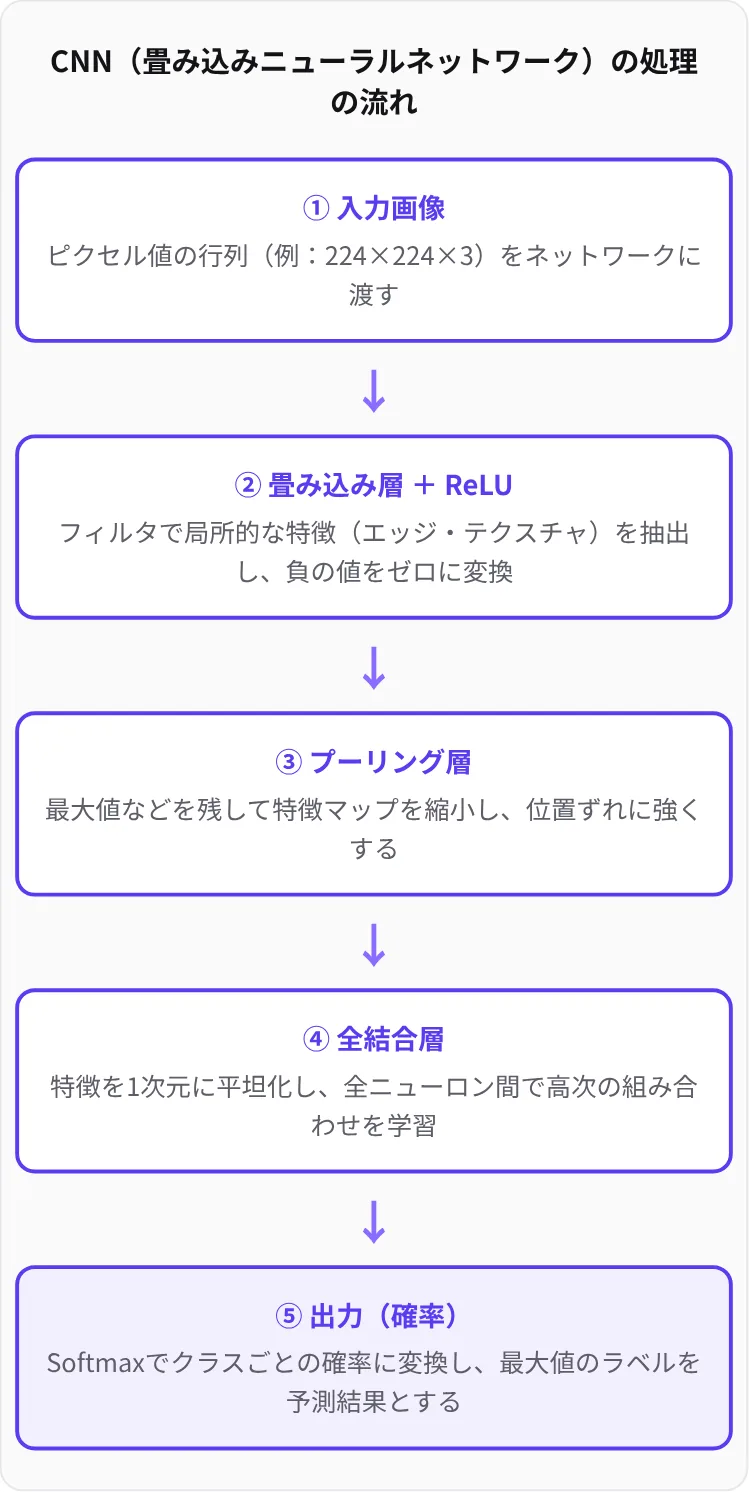
| 層 | 役割 | 出力されるもの |
|---|---|---|
| 入力層 | 画像を数値の配列として受け取る | 高さ×幅×チャンネルの配列 |
| 畳み込み層 | フィルターで局所的な特徴を抽出する | 特徴マップ |
| 活性化関数(ReLU) | 負の値を0にして非線形性を加える | 活性化された特徴マップ |
| プーリング層 | 特徴マップを縮小し、位置ずれに強くする | 縮小された特徴マップ |
| 全結合層 | 特徴を組み合わせてクラスごとの得点を出す | クラス数ぶんの数値 |
| 出力層(ソフトマックス) | 得点を確率に変換する | 各クラスの確率(合計1) |
実際のモデルでは、「畳み込み→ReLU→プーリング」の組み合わせを何度も繰り返してから全結合層へ進むのが一般的です。繰り返すほど特徴マップは小さく、チャンネル数(特徴の種類)は多くなっていきます。
畳み込み層の仕組み:カーネル・積和演算・特徴マップ
畳み込み層では、「カーネル(フィルター)」と呼ばれる小さな重みの行列を画像の上でずらしながら、重なった部分の画素とカーネルの値を掛けて足し合わせます(積和演算)。その結果を並べたものが「特徴マップ」です。
積和演算の具体例
5×5の画像に、縦のエッジ(左が明るく右が暗い境目)に反応する3×3のカーネルを当てる例で考えます。
| 項目 | 値 | 説明 |
|---|---|---|
| カーネル(1行目) | 1 0 −1 | 左列を足し、右列を引く |
| カーネル(2行目) | 1 0 −1 | 同上 |
| カーネル(3行目) | 1 0 −1 | 同上 |
| 画像の一部(各行) | 9 9 0 | 左が明るく右が暗い領域 |
| 計算 | (9×1+9×0+0×−1)×3行 | =27 |
明るさが変わらない平らな領域(例:すべて9)に同じカーネルを当てると、9−9=0が3行分で結果は0になります。つまりこのカーネルは、縦の境目がある場所でだけ大きな値を出します。CNNでは、このようなカーネルの値を人が決めるのではなく、学習によって自動的に求めます。
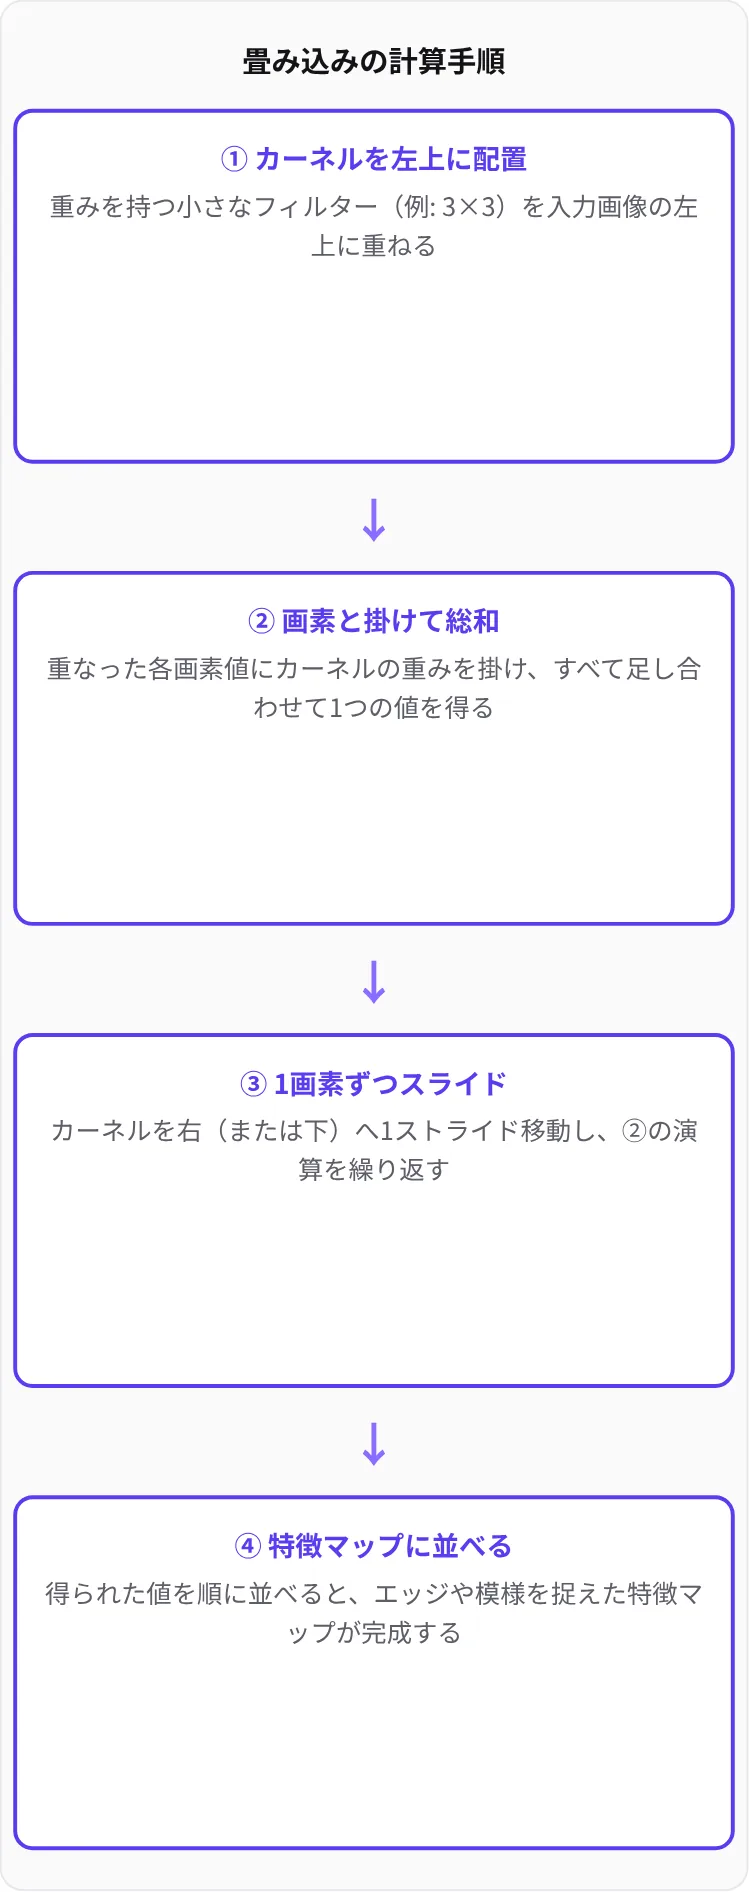
局所受容野と重み共有
- 局所受容野:特徴マップの1つの値が、入力画像のどの範囲から計算されたかを指します。3×3のカーネルなら、1つの出力は入力の3×3の範囲だけを見ています。層を重ねると、深い層の1つの値が見る範囲は広がっていきます。
- 重み共有(パラメータ共有):同じカーネルを画像のすべての位置で使い回すことです。パラメータ数が大幅に減るうえ、同じ特徴を画像のどこにあっても検出できるようになります。
チャンネルとフィルター数
カラー画像はR・G・Bの3チャンネルを持つため、カーネルも3×3×3のように入力チャンネル数に合わせた奥行きを持ちます。1枚のカーネルから1枚の特徴マップが得られるので、カーネルを64枚使えば出力は64チャンネルになります。カーネルごとに「縦線」「斜め線」「特定の色の塊」など異なる特徴を担当するイメージです。
ストライドとパディング
| ハイパーパラメータ | 意味 | よく使われる設定 |
|---|---|---|
| カーネルサイズ | フィルターの縦横の大きさ | 3×3、5×5など |
| フィルター数 | 出力チャンネル数(特徴の種類) | 16、32、64…と層ごとに増やす |
| ストライド | カーネルを動かす間隔 | 1(細かく)または2(縮小を兼ねる) |
| パディング | 画像の周囲に値を足して大きさを調整 | 周囲を0で埋めるゼロパディング |
パディングをしないと、畳み込みのたびに出力が小さくなり、画像の端の画素は計算に使われる回数が少なくなります。周囲を0で埋めるゼロパディングを使うと、出力の大きさを入力と同じに保てます。深層学習のフレームワークでは、パディングなしを「valid」、出力サイズを入力と揃える設定を「same」と呼ぶことがあります。
出力サイズの計算式
入力の高さをH、カーネルサイズをK、パディングをP、ストライドをSとすると、出力の高さは次の式で求められます(幅も同じ式です)。
出力サイズ =(H + 2P − K)÷ S + 1(割り切れない場合は切り捨て)
- H=28、K=5、P=2、S=1 のとき:(28+4−5)÷1+1=28(大きさが保たれます)
- H=28、K=5、P=0、S=1 のとき:(28−5)÷1+1=24
- H=28、K=3、P=1、S=2 のとき:(28+2−3)÷2+1=13.5+1→14
モデルを自作するときは、この式で各層の出力サイズを手計算しておくと、全結合層の入力数の設定ミスを防げます。
活性化関数ReLUとプーリング層の役割
畳み込みの後には、活性化関数とプーリングが続きます。ReLUは「学習を速く安定させる」、プーリングは「特徴マップを小さくして計算量を減らし、位置ずれに強くする」役割を持ちます。
ReLU(正規化線形ユニット)
ReLUは、入力が0以下なら0、0より大きければそのまま出力する関数です(f(x)=max(0, x))。畳み込みは掛け算と足し算だけの線形な処理なので、そのまま重ねても1層分の表現力しか持てません。ReLUのような非線形の関数をはさむことで、複雑な形のパターンを表現できるようになります。
従来よく使われたシグモイド関数は、入力が大きくなると傾きがほぼ0になり、深い層まで学習の信号が伝わりにくくなる問題(勾配消失)がありました。ReLUは正の範囲で傾きが常に1なので、深いネットワークでも学習が進みやすく、計算も単純です。
プーリング層
プーリング層は、特徴マップを小さな領域(例:2×2)に区切り、各領域を1つの値にまとめる処理です。2×2・ストライド2のプーリングなら、縦横がそれぞれ半分になり、データ量は4分の1になります。プーリングには学習するパラメータがありません。
| 種類 | 処理 | 特徴 |
|---|---|---|
| 最大プーリング(Max Pooling) | 領域内の最大値を取り出す | 最も強く反応した特徴を残す。画像認識で広く使われる |
| 平均プーリング(Average Pooling) | 領域内の平均値を取る | 領域全体の傾向をなめらかに残す |
| グローバル平均プーリング | 特徴マップ全体の平均を1つの値にする | 全結合層の代わりに使われ、パラメータを減らせる |
例えば2×2の領域の値が「1, 3, 2, 8」なら、最大プーリングの結果は8、平均プーリングの結果は3.5です。特徴の位置が領域内で1画素ずれても最大値は変わらないため、小さな位置ずれに強くなります。
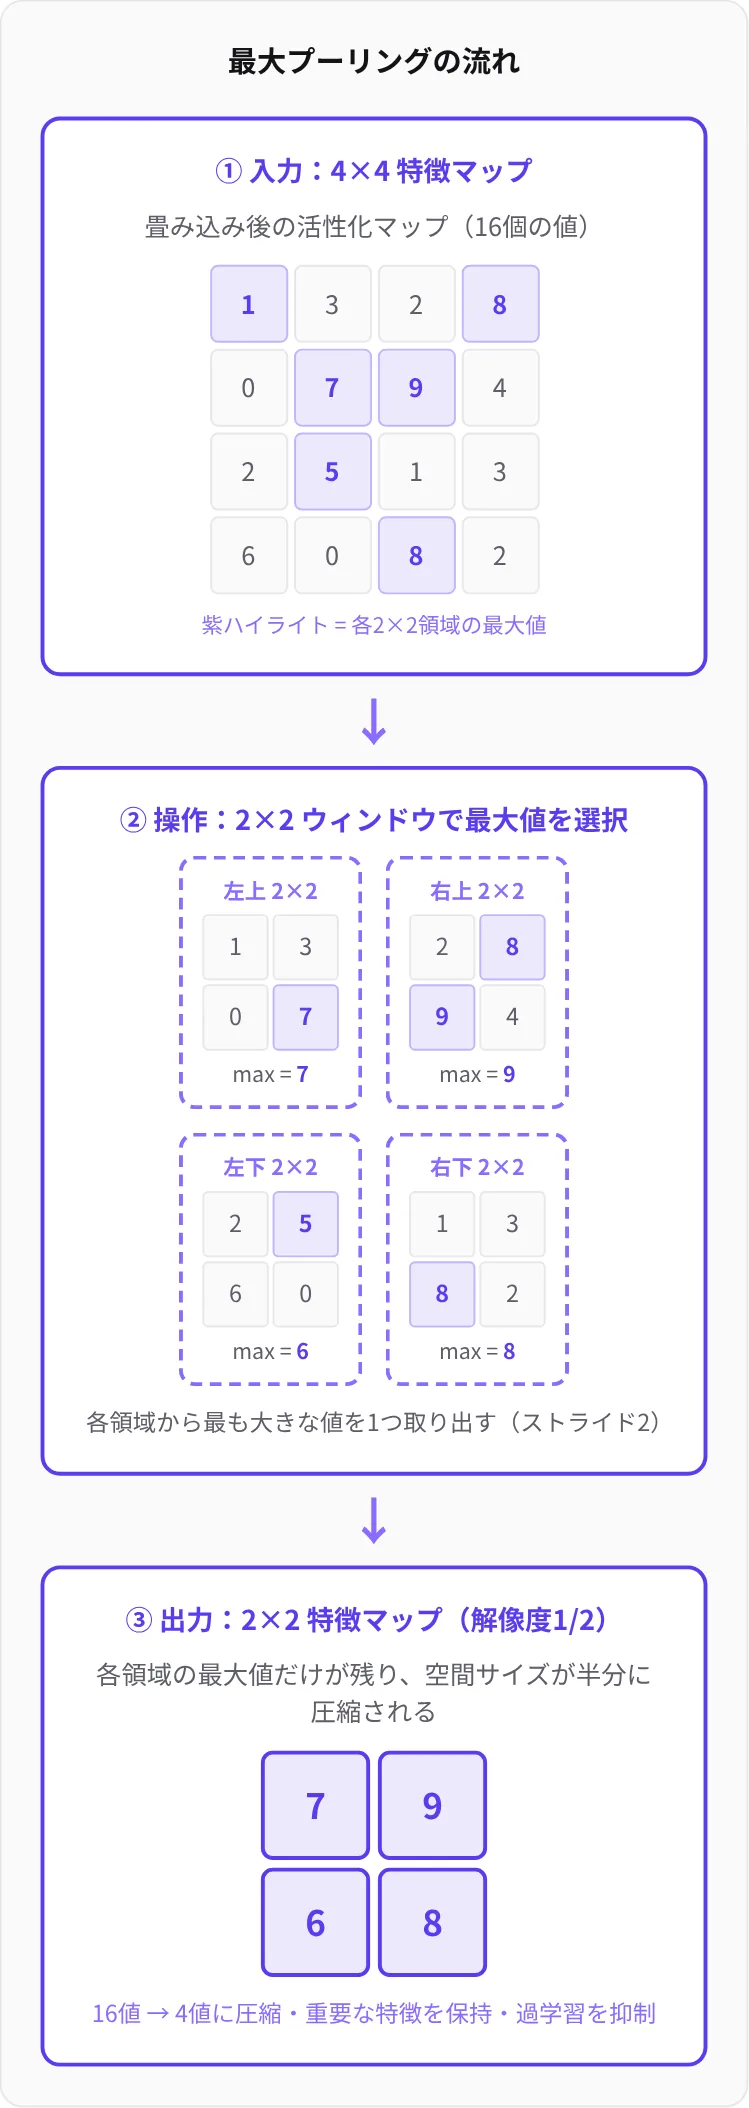
プーリングのメリットとデメリット
- メリット:計算量とメモリの削減、小さな位置ずれへの耐性、後段の層が見る範囲(受容野)を広げやすい
- デメリット:細かな位置情報が失われるため、画素単位の位置が重要なセグメンテーションなどでは工夫が必要になる
近年のモデルでは、プーリングの代わりにストライド2の畳み込みで縮小する設計もよく見られます。縮小の仕方そのものも学習させたい場合の選択肢です。
全結合層と出力層:特徴から答えを決める仕組み
畳み込みとプーリングで取り出した特徴は、最後に全結合層でまとめられ、出力層のソフトマックス関数で「各クラスである確率」に変換されます。
平坦化と全結合層
最後のプーリング層の出力(例:7×7×32の配列)を1列に並べ直す処理を「平坦化(Flatten)」と呼びます。7×7×32なら1,568個の数値になります。全結合層はこの数値すべてを組み合わせ、「丸い形と耳の形が両方あれば猫らしい」といった特徴の組み合わせを学習します。最後の全結合層は、分類したいクラスの数(例:手書き数字なら10)だけの値を出力します。
ソフトマックスによる確率出力
全結合層の出力は「ロジット」と呼ばれる得点で、合計も範囲もばらばらです。ソフトマックス関数は、各得点の指数をとって全体の合計で割ることで、0〜1の範囲で合計が1になる確率に変換します。
| クラス | 全結合層の得点 | ソフトマックス後の確率 |
|---|---|---|
| 猫 | 2.0 | 約0.66(66%) |
| 犬 | 1.0 | 約0.24(24%) |
| 鳥 | 0.1 | 約0.10(10%) |
この例では「猫」の確率が最も高いため、モデルは猫と判定します。分類したいクラスが多い場合でも、仕組みは同じです。
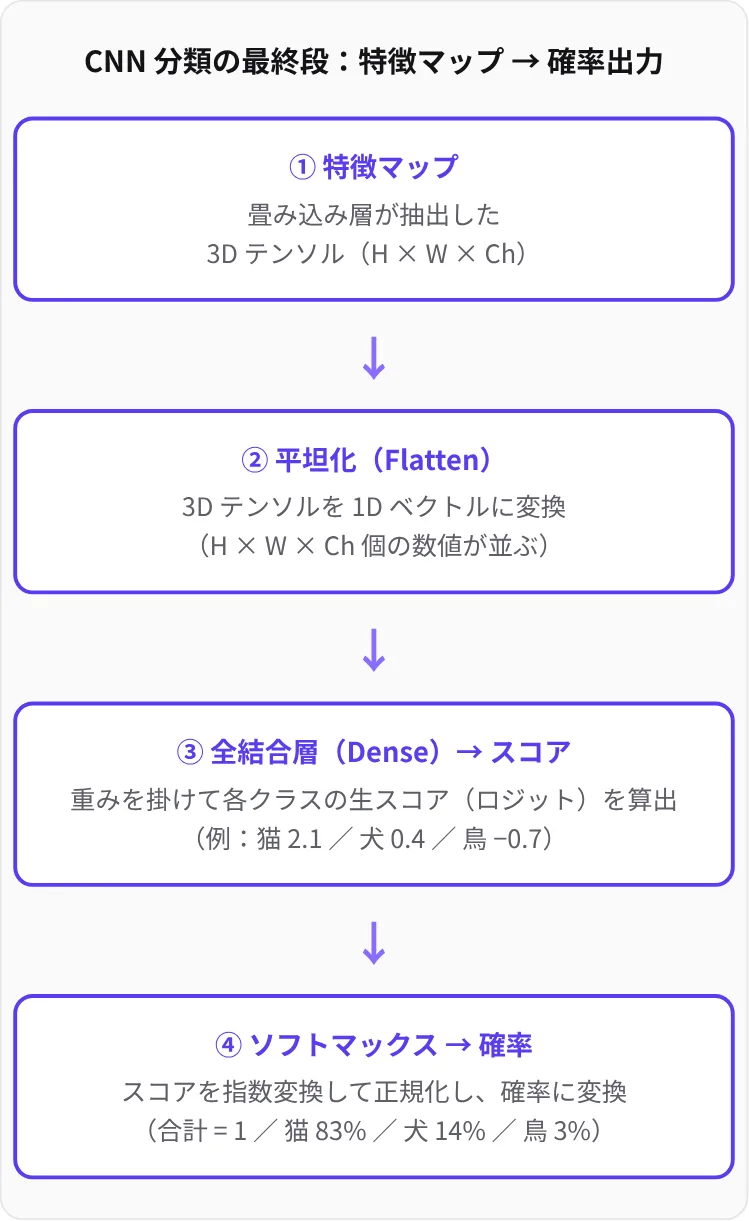
層を重ねると何が起きるか:手書き数字で見る層ごとの処理
CNNは、浅い層ほど単純な特徴、深い層ほど複雑な特徴をとらえるように学習が進みます。浅い層ではエッジや明るさの変化、中間の層では模様や角、深い層では「目」「車輪」のような物体の部品や全体の形に反応するフィルターが現れることが知られています。
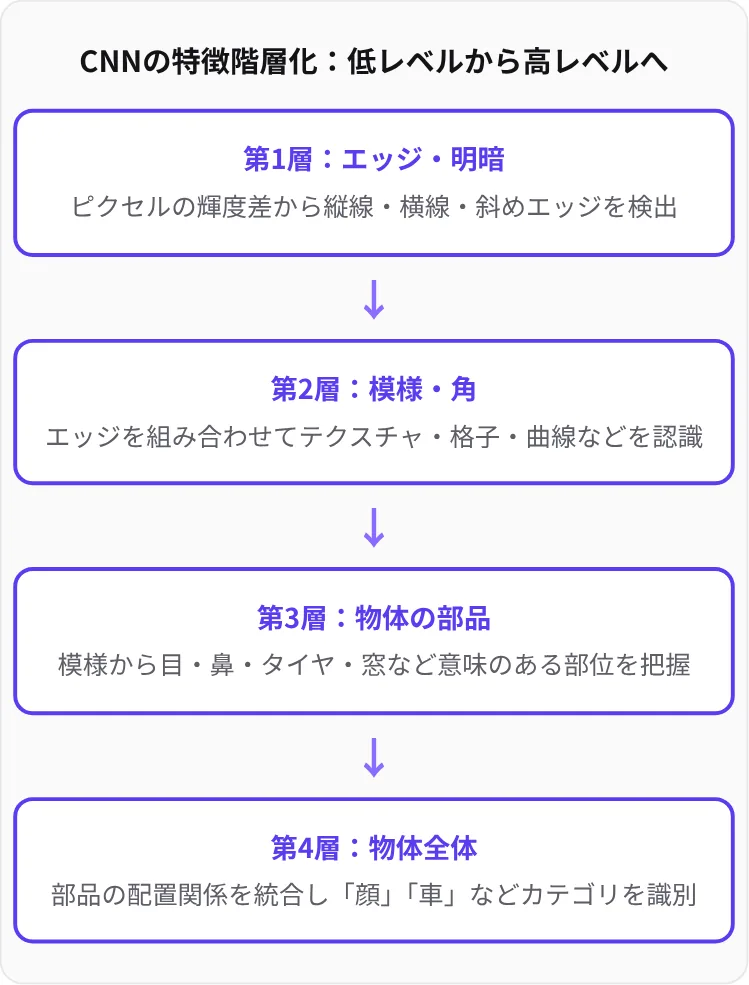
具体的に、28×28画素・白黒(1チャンネル)の手書き数字画像を、畳み込み2回・プーリング2回・全結合2層の小さなCNNで分類する場合、データの形は次のように変わります(カーネル5×5・パディング2・2×2の最大プーリングの場合)。
| 処理 | 出力の形(高さ×幅×チャンネル) | この段階で起きていること |
|---|---|---|
| 入力 | 28×28×1 | 手書き数字の濃淡 |
| 畳み込み1(16枚)+ReLU | 28×28×16 | 線の向きや端などの単純な特徴 |
| 最大プーリング | 14×14×16 | 縮小して位置ずれに強くする |
| 畳み込み2(32枚)+ReLU | 14×14×32 | 線の交差や曲がり具合などの組み合わせ |
| 最大プーリング | 7×7×32 | さらに縮小 |
| 平坦化 | 1,568 | 1列に並べ直す |
| 全結合層+ReLU | 128 | 特徴の組み合わせを学習 |
| 全結合層+ソフトマックス | 10 | 0〜9それぞれの確率 |
画像の大きさは28→14→7と小さくなる一方、チャンネル数は1→16→32と増えています。「どこに何があるか」という位置の情報を少しずつ手放しながら、「どんな特徴があるか」という情報を豊かにしていく流れが、CNNの基本的な設計思想です。
CNNの学習方法:誤差逆伝播・損失関数・最適化
CNNのカーネルや全結合層の重みは、正解付きの画像を大量に与え、予測と正解のずれが小さくなるように少しずつ調整することで学習されます。基本の流れは他のニューラルネットワークと同じです。
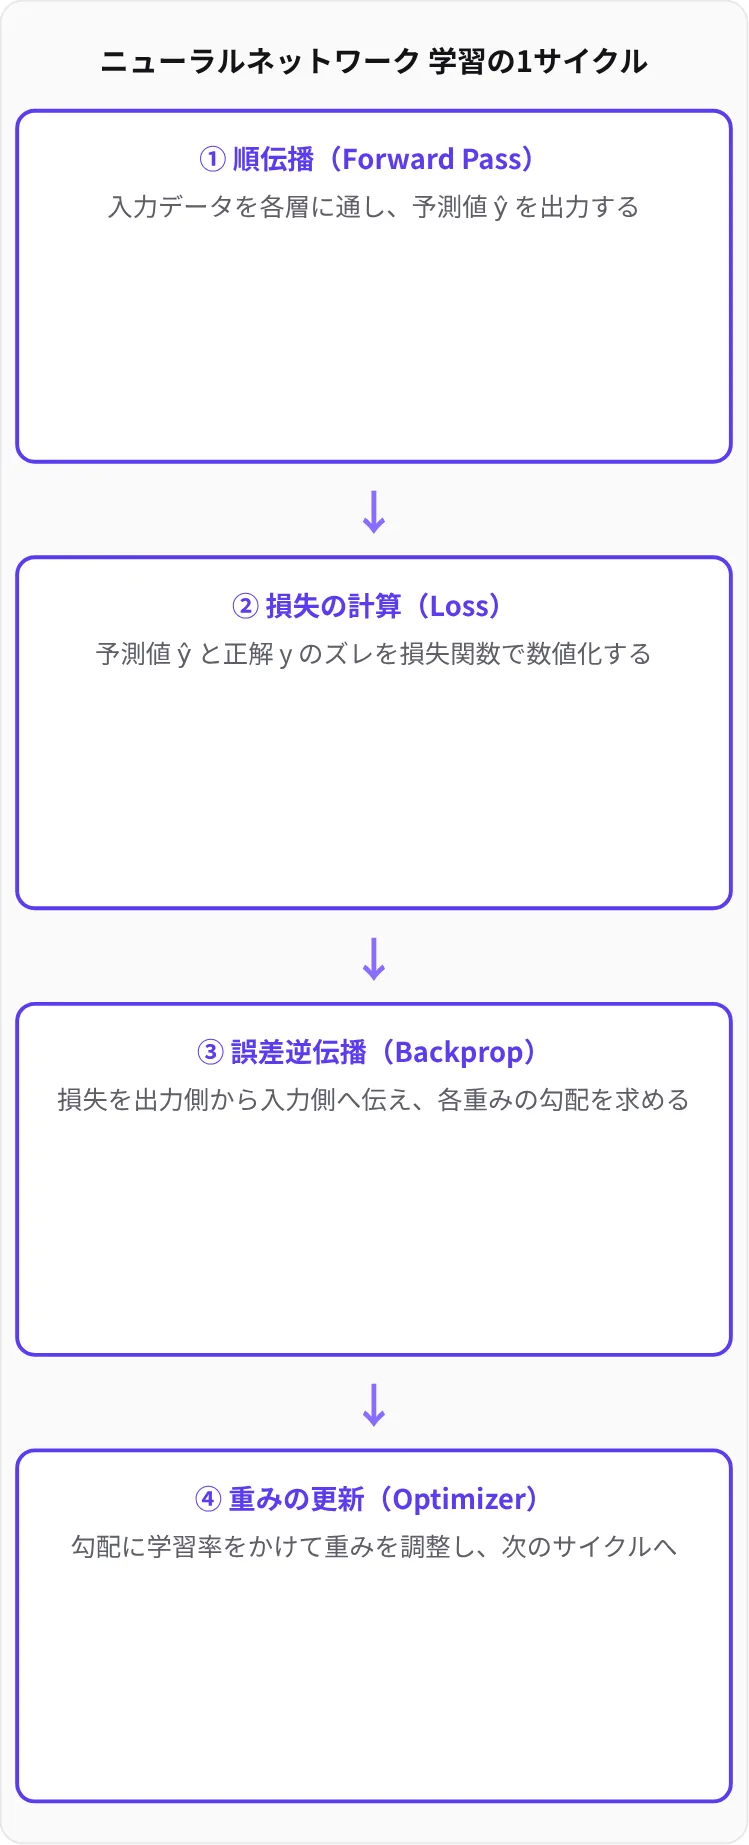
| 要素 | 内容 | よく使われるもの |
|---|---|---|
| 損失関数 | 予測と正解のずれを数値化する | 分類では交差エントロピー誤差 |
| 誤差逆伝播法 | 出力側から入力側へ、各重みの勾配を計算する | フレームワークが自動計算 |
| 最適化手法 | 勾配を使って重みを更新する | SGD(確率的勾配降下法)、モメンタム付きSGD、Adam |
| ミニバッチ・エポック | 数十枚単位で更新し、全データを何周も学習する | バッチサイズ32〜256程度がよく使われる |
交差エントロピー誤差は、正解クラスに割り当てた確率が高いほど小さくなる値です。先ほどの例で正解が「猫」なら、猫の確率0.66に対して損失は−log(0.66)≒0.42になります。猫の確率が0.99まで上がれば損失は約0.01まで下がります。
PyTorchによる実装例
前の章の手書き数字(MNIST)用CNNを、PyTorchで定義すると次のようになります。
import torch.nn as nn
import torch.nn.functional as F

class SimpleCNN(nn.Module):
    def __init__(self):
        super().__init__()
        self.conv1 = nn.Conv2d(1, 16, kernel_size=5, padding=2)   # 28x28x1 → 28x28x16
        self.conv2 = nn.Conv2d(16, 32, kernel_size=5, padding=2)  # 14x14x16 → 14x14x32
        self.fc1 = nn.Linear(32 * 7 * 7, 128)
        self.fc2 = nn.Linear(128, 10)

    def forward(self, x):
        x = F.max_pool2d(F.relu(self.conv1(x)), 2)  # → 14x14x16
        x = F.max_pool2d(F.relu(self.conv2(x)), 2)  # → 7x7x32
        x = x.flatten(1)                            # → 1568
        x = F.relu(self.fc1(x))
        return self.fc2(x)  # ソフトマックスは損失関数側で計算

# 学習時の設定例
# criterion = nn.CrossEntropyLoss()
# optimizer = torch.optim.SGD(model.parameters(), lr=0.01, momentum=0.9)PyTorchのnn.CrossEntropyLossは内部でソフトマックスを含んで計算するため、モデルの最後にソフトマックスを重ねて書かないのが一般的です。予測結果を確率として見たいときだけ、推論時にF.softmaxをかけます。
手を動かしながら学びたい場合は、神戸高専の深層学習コース教材「CNNで画像を分類する」(https://www.kobe-kosen.ac.jp/~fujimoto/extra/deep_learning_course/cnn.html)のように、教育機関が公開している教材も参考になります。
精度を上げるための代表的な工夫
- データ拡張:画像の反転・回転・切り抜き・明るさ変更などで学習データを水増しし、過学習を抑えます。
- バッチ正規化:層ごとに値の分布を整え、学習を安定させます。
- ドロップアウト:学習中に一部のニューロンをランダムに無効にし、特定の特徴への依存を防ぎます。
- 転移学習:大規模な画像データで事前学習済みのモデルを出発点にし、自分のデータで最後の層だけ、または全体を微調整します。少ないデータと計算資源で高い精度を狙いやすい方法です。
GPUが必要とされる理由
畳み込みは、同じ形の積和演算を画像中の膨大な位置で繰り返す処理です。GPUは多数の単純な計算を同時に実行するのが得意なため、CNNの学習時間を大幅に短縮できます。小さなMNIST程度ならCPUでも学習できますが、高解像度の画像を数万枚以上扱う場合は、GPUの利用がほぼ前提になります。推論(学習済みモデルで判定する処理)については、スマートフォンや組み込み機器に搭載されたNPU(ニューラル処理専用のプロセッサ)で動かすエッジAIの用途も広がっています。
CNNの歴史と代表的なアーキテクチャ
CNNの考え方は、動物の視覚野の研究に端を発し、1980年代の日本の研究を経て、2010年代のディープラーニングの急速な発展の中心となりました。
出発点の一つは、ヒューベルとウィーゼルによるネコの視覚野の研究です。視覚野には、特定の向きの線など局所的な特徴に反応する「単純型細胞」と、その特徴の位置が多少ずれても反応する「複雑型細胞」があることが示されました。CNNの畳み込み層は単純型細胞、プーリング層は複雑型細胞の働きに対応づけて説明されることがよくあります。
| 年 | モデル・出来事 | ポイント |
|---|---|---|
| 1980年 | ネオコグニトロン(福島邦彦) | 単純型・複雑型細胞を模した層を交互に重ねる構造を提案。CNNの原型とされる |
| 1998年 | LeNet-5(LeCunら) | 誤差逆伝播で学習するCNNを手書き文字認識に適用 |
| 2012年 | AlexNet | 大規模画像認識コンテストILSVRCで従来手法を大きく上回り、ディープラーニングが注目される契機に。GPUとReLUを活用 |
| 2014年 | VGG | 3×3の小さなカーネルを深く重ねるシンプルな設計 |
| 2014年 | GoogLeNet(Inception) | 異なる大きさのフィルターを並列に使うInceptionモジュール |
| 2015年 | ResNet | 入力を出力に足し合わせる「残差接続」で、100層を超える深いネットワークの学習を可能に |
| 2020年 | Vision Transformer(ViT) | 畳み込みを使わず、Transformerの注意機構で画像を扱うモデルが登場 |
ResNetの残差接続は、層が深くなるほど学習がかえって難しくなる問題を和らげる工夫で、その後の多くのモデルに取り入れられています。
CNNの活用例:自動運転・医療・音声から画像生成まで
CNNは画像を扱う多くのタスクの土台になっており、さらに音声・時系列・テキストなど、画像以外のデータにも応用されています。
画像タスクの3つの基本形
| タスク | 出力 | 例 |
|---|---|---|
| 画像分類 | 画像全体に1つのラベル | 写真が「犬」か「猫」かを判定 |
| 物体検出 | 物体ごとの位置(矩形)とラベル | 道路画像の中の歩行者・車・標識の位置を特定 |
| セグメンテーション | 画素ごとのラベル | 画像のどの画素が道路・歩道・空かを塗り分ける |
自動運転での活用
自動運転や運転支援では、車載カメラの映像から周囲の状況を理解するためにCNNが使われています。代表的な用途は次のとおりです。
- 物体検出:前方の車両・歩行者・自転車などの位置と種類を、映像のフレームごとに検出します。
- 標識・信号の認識:道路標識の種類や信号の色を分類します。
- 走行可能領域・車線の把握:セグメンテーションで、画素単位に道路・車線・歩道などを区別します。
自動運転では、遅れの少ない判定が求められるため、車載の専用プロセッサ上で効率よく推論できるよう、計算量を抑えた軽量なCNNの設計が重視されます。また、夜間・雨天・逆光など条件の悪い映像にも対応する必要があるため、多様な状況を含む学習データの確保が大きな課題になります。カメラだけでなくLiDARやレーダーなど他のセンサーと組み合わせて判断する構成も一般的です。
医療画像診断での活用
X線・CT・MRI・内視鏡・病理標本などの医用画像から、病変の候補を見つけたり、領域を切り出したりする用途でCNNが研究・活用されています。医用画像のセグメンテーションでは、縮小した特徴を元の解像度まで戻しながら位置情報を補うU-Netと呼ばれる構造が広く知られています。医療分野では、最終的な判断は医師が行い、AIはその支援に位置づけられるのが一般的です。
顔画像の解析
顔認証や表情の分析も、画像から特徴を取り出す技術が活用される分野です。たとえばバーチャルヒューマン/AIアバターのソリューションであるDeepAIは、面接練習やロールプレイで、受講者の表情・感情・緊張度を発話タイムラインに沿って解析・可視化する機能を備えています。このように、顔の画像解析は認証だけでなく、コミュニケーションの振り返りといった用途にも広がっています。
画像以外のデータへの応用
| データ | CNNの使い方 | 用途の例 |
|---|---|---|
| 音声 | 音を時間×周波数の画像(スペクトログラム)に変換して2次元畳み込み | キーワード検出、音の種類の分類 |
| 時系列・センサー信号 | 時間方向に1次元の畳み込み | 振動データの分類、心電図の解析 |
| テキスト | 単語ベクトルの並びに1次元の畳み込み | 文書分類、感情分類(現在はTransformerが主流) |
| 画像生成 | 生成器・識別器にCNNを使う | GANによる画像生成、スタイル変換、学習用の合成データ作成 |
このほか、小売店の棚の画像から商品を認識する用途や、製造業での外観検査など、カメラ映像を使う業務の多くでCNNが基盤技術として使われています。
CNNと他のニューラルネットワークの違い・使い分け
CNNは「近い位置どうしの関係」をとらえるのが得意なモデルです。順番に意味がある系列データにはRNN、データの生成にはGAN、離れた位置どうしの関係まで広くとらえたい場合にはTransformerと、目的によって使い分けたり組み合わせたりします。
| モデル | 得意なこと | CNNとの関係 |
|---|---|---|
| CNN | 画像など格子状データの局所的な特徴抽出 | ― |
| RNN(LSTMなど) | 文章や音声など順序のある系列データ | 動画では「CNNで各フレームの特徴→RNNで時間変化」と組み合わせることがある |
| GAN | 本物らしいデータの生成 | 生成器・識別器の中身にCNNを使う構成が多い |
| Transformer(ViTなど) | 注意機構で画像全体・文章全体の関係をとらえる | 大量データでは高い性能を示す。CNNと組み合わせた構成もある |
CNNを使うべき場面
- 画像や映像など、近い位置どうしに意味のつながりがあるデータを扱うとき
- 学習データが比較的少なく、画像向けの構造をもともと持つモデルの方が学習しやすいとき
- スマートフォンや組み込み機器など、計算資源の限られた環境で推論したいとき
- 事前学習済みモデルを転移学習で活用し、短期間で精度を確保したいとき
Vision Transformerの登場以降も、CNNは計算効率の良さや少ないデータでの学習しやすさから実務で広く使われています。Transformerの注意機構とCNNの畳み込みを組み合わせた構成も研究されており、両者は対立するものではなく、目的に応じて選ぶ技術と考えるのが実際的です。
CNNに関するよくある質問
CNNとDNN(ディープニューラルネットワーク)は何が違いますか?
DNNは層を深く重ねたニューラルネットワーク全般を指す言葉で、CNNはその中の一種です。全結合層だけで構成したDNNと比べ、CNNは畳み込み層とプーリング層を持つ点が異なります。
畳み込み層とプーリング層の違いは何ですか?
畳み込み層は、学習するフィルターで特徴を取り出す層です。プーリング層は学習するパラメータを持たず、特徴マップを縮小して計算量を減らし、位置ずれに強くする層です。
カーネルとフィルターは同じものですか?
ほぼ同じ意味で使われます。厳密には、2次元の重み行列1枚をカーネル、入力チャンネルぶんのカーネルをまとめたものをフィルターと呼び分けることもあります。
CNNはどれくらいの画像データがあれば学習できますか?
必要な枚数は、タスクの難しさやクラス数、画像のばらつきによって大きく変わるため、一律には決まりません。データが少ない場合は、事前学習済みモデルを使う転移学習やデータ拡張を組み合わせるのが一般的な方法です。
CNNは画像以外にも使えますか?
使えます。音声はスペクトログラムに変換して2次元の畳み込み、センサー信号や時系列データは1次元の畳み込みで扱えます。テキスト分類に使われた例もあります。
まとめ
CNN(畳み込みニューラルネットワーク)は、カーネルによる畳み込みで画像の局所的な特徴を取り出し、プーリングで縮小と位置ずれへの耐性を加え、全結合層とソフトマックスで最終的な判定を行うディープラーニングのモデルです。
- 局所的な結合と重み共有により、全結合層よりはるかに少ないパラメータで画像を扱えます。
- 層を重ねるほど、エッジから物体全体へと複雑な特徴をとらえるようになります。
- 学習は交差エントロピー誤差・誤差逆伝播・SGDなどの最適化で行い、GPUや転移学習が実務を支えています。
- 自動運転、医療画像、顔画像の解析、音声・時系列、画像生成まで、応用範囲は画像認識にとどまりません。
まずは出力サイズの計算式を使いながら小さなCNNを手元で動かし、各層でデータの形がどう変わるかを確かめると、仕組みの理解が一気に深まります。
参考文献
- 神戸市立工業高等専門学校 FUJIMOTO LAB 深層学習コース「CNNで画像を分類する」https://www.kobe-kosen.ac.jp/~fujimoto/extra/deep_learning_course/cnn.html
- CiNii(国立情報学研究所)収録文献 https://ci.nii.ac.jp/naid/130007422320
- 一般財団法人 家電製品協会 関連資料 https://www.aeha.or.jp/assessment/kz/htm/sen/sen01.htm
Read next
あわせて読みたい
-
AIの種類とは?特化型・汎用型から生成AIまでわかりやすく解説
AIの種類とは、AI(人工知能)を「どこまでできるか(能力)」「何に使うか(用途)」「どう学ぶか(学習方式)」といった軸で分けた分類のことです。よく使われる分類...
-

AIが判断する仕組みとは?学習からデータ・モデル・推論まで解説
AIの仕組みとは、大量のデータから規則性を学んで「モデル」を作り(学習)、そのモデルに新しいデータを入力して答えを出す(推論)という2段階の流れのことです。Ch...
-
ニューラルネットワークとは?仕組みと種類(DNN・RNN)をわかりやすく解説
ニューラルネットワークとは、人間の脳の神経細胞(ニューロン)が信号を伝え合う仕組みを手がかりに作られた、入力から出力への複雑な対応関係(非線形関数)をデータから...