
blog
AIブログ
AIエンジニアとは?仕事内容と必要なスキルをわかりやすく解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
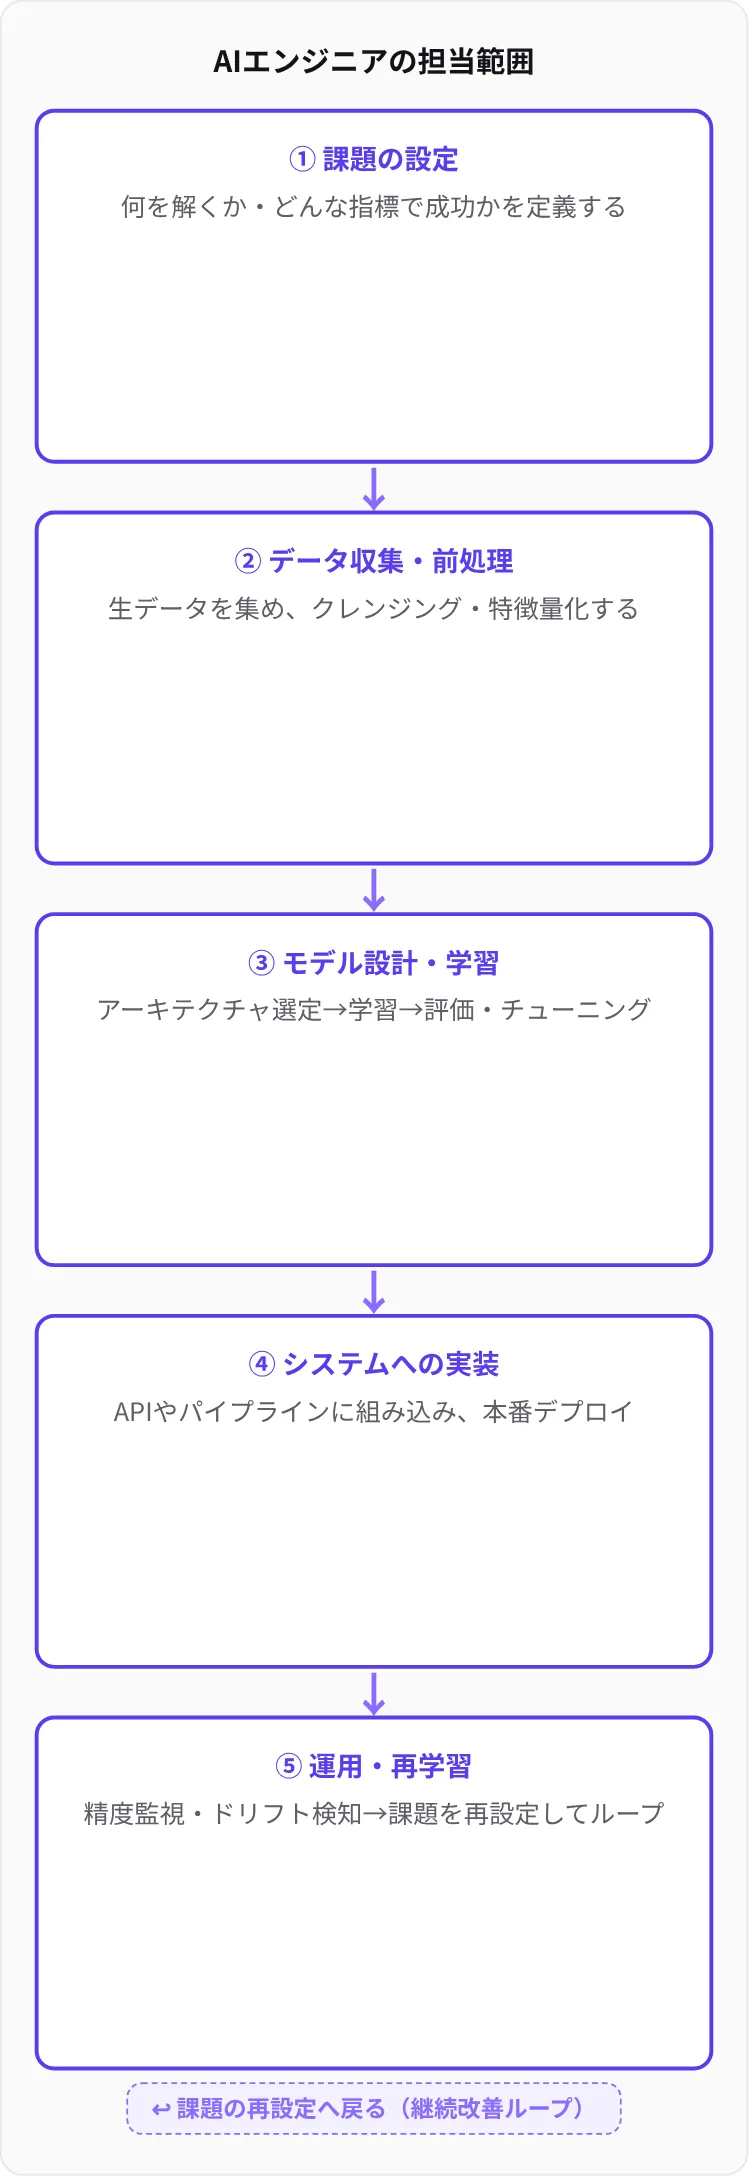
AIエンジニアとは、機械学習やディープラーニングなどのAI技術を使い、データの収集・整備からAIモデルの設計・学習、システムへの組み込み、運用後の改善までを担う技術職です。従来のソフトウェア開発が「人が書いたルールどおりに動く仕組み」を作るのに対し、AIエンジニアは「データから規則性を学ぶ仕組み」を作り、その精度を運用中も保ち続けることに責任を持ちます。
この記事では、AIエンジニアを目指す人と、AIエンジニアを採用・評価する担当者の両方に向けて、仕事内容を工程ごとに分け、各工程で何をするのか、どのスキルがなぜ必要なのかを具体的に解説します。将来性や需要の根拠データ、資格の位置づけ、目指し方もあわせて整理します。
AIエンジニアとは:定義と担当範囲
AIエンジニアは、AIを「作る」だけでなく「業務で使える状態にして保つ」までを担当する職種です。担当範囲は所属先によって異なりますが、中心にあるのは「データ」と「モデル」と「それを動かすシステム」の3つです。
KDDIのビジネス向けコラム(biz.kddi.com)は、AIエンジニアの仕事を「データ収集・分析」「AIモデル開発」「システムへの実装」「運用・改善」の4フェーズに整理しています。上位の解説記事の多くも同様の流れで説明しており、この一連の工程に一気通貫で関わる点が、AIエンジニアの基本的な特徴といえます。
ITエンジニア・プロンプトエンジニア・データサイエンティストとの違い
AIエンジニアは近い職種と混同されやすいため、担当の中心がどこにあるかで区別すると理解しやすくなります。
| 職種 | 主な担当 | AIエンジニアとの違い |
|---|---|---|
| ITエンジニア(ソフトウェア・インフラ) | Webシステムや業務システム、サーバー・ネットワークなどの設計・構築・保守 | 仕様どおりに動くことが目標です。AIエンジニアは「データで学習した結果の精度」も品質として扱います |
| プロンプトエンジニア | 生成AIへの指示文(プロンプト)の設計と、出力の評価・調整 | 既存の生成AIの使い方を設計します。AIエンジニアはモデルの学習・組み込み・運用基盤まで扱います |
| データサイエンティスト | 統計・分析によるビジネス上の示唆の発見と意思決定の支援 | 分析結果を「判断材料」として出すのが中心です。AIエンジニアは結果を「動くシステム」として届けます |
実際の現場では境界が重なることも多く、小規模な組織では1人がデータ分析からシステム実装まで兼ねる場合もあります。一方、ITエンジニアとAIエンジニアには、問題解決能力やチームでの開発、最新技術を学び続ける姿勢が求められる点で共通点もあります。
関連記事AIが判断する仕組みとは?学習からデータ・モデル・推論まで解説 / ニューラルネットワークとは?仕組みと種類(DNN・RNN)をわかりやすく解説
AIエンジニアの仕事内容(工程別)
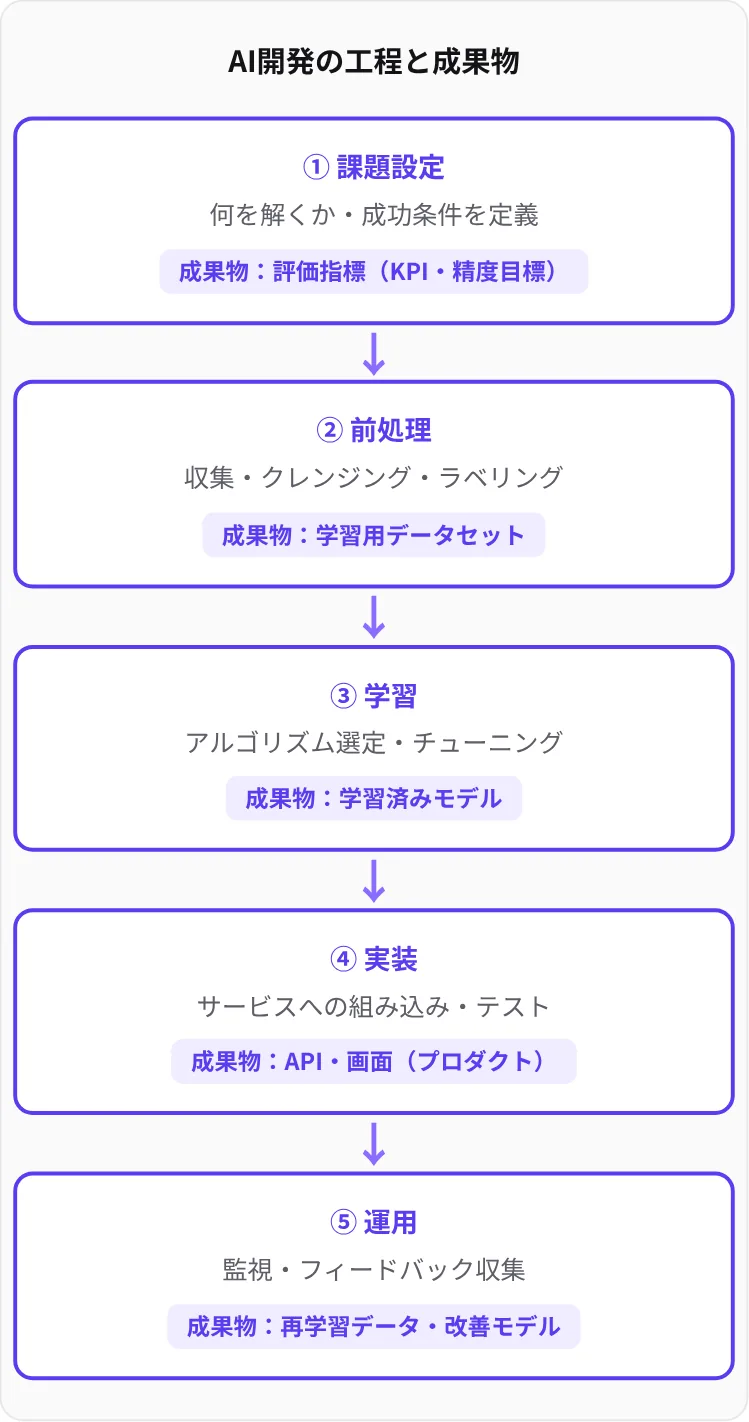
AIエンジニアの仕事は、「何を予測・判定させるか決める」→「学習に使えるデータを整える」→「モデルを作り評価する」→「システムに組み込む」→「精度を保つ」という工程で進みます。工程ごとに求められる判断が異なるため、順に見ていきます。
1. 課題設定とPoC(概念実証)
最初の仕事は、業務課題を「AIが解ける問い」に置き換えることです。たとえば「問い合わせ対応を楽にしたい」という要望は、そのままではモデルを作れません。「問い合わせ文を種類ごとに分類する」「回答候補を提示する」など、入力と出力が決まった問いに分解する必要があります。
- 入力と出力の定義:何のデータを入れて、何を返すのかを決めます
- 評価指標の決定:何をもって「使える精度」とするかを、業務側と合意します
- PoCでの検証:小さなデータでモデルを試作し、実用に届く見込みがあるかを確認します
- 中止の判断基準:期待した水準に届かない場合の撤退条件もあらかじめ決めておきます
この段階でAIを使わない方が合理的と判断することも、AIエンジニアの重要な仕事です。ルールで書ける処理を無理にAI化すると、精度管理の手間だけが増えるためです。
2. データ収集・前処理・クレンジング
モデルの精度は、学習に使うデータの質に大きく左右されます。そのため、AIエンジニアの作業時間の多くはデータを集めて整える工程に費やされます。業務ログ、センサー値、画像、音声、テキストなど、目的に応じて複数の情報源からデータを集め、学習に使える形へ加工します。
| 作業 | 内容 | 怠ったときに起きること |
|---|---|---|
| 欠損値の処理 | 空欄の行を除くか、平均値・中央値などで補完します | 学習が止まる、または特定の傾向に偏ります |
| 外れ値・誤記の除去 | 入力ミスや異常な値を検出して扱いを決めます | 少数の誤ったデータに予測が引きずられます |
| 表記ゆれの統一 | 全角・半角、単位、日付形式、カテゴリ名をそろえます | 同じものが別物として学習されます |
| 正規化・標準化 | 数値の大きさの差をそろえます | 値の大きい項目だけが過剰に重視されます |
| ラベル付け(アノテーション) | 画像や文章に正解を付けます。基準書を作り、付け方のばらつきを抑えます | 正解自体が不正確になり、精度の上限が下がります |
| データの分割 | 学習用・検証用・評価用に分け、評価用は最後まで使いません | 評価が甘くなり、本番で精度が落ちます |
特に注意が必要なのが「データリーク」です。予測の時点では本来手に入らない情報(たとえば結果が出た後に記録される項目)が学習データに混ざると、検証では高精度に見えても本番では役に立ちません。どの項目がいつ記録されるのかを業務側に確認する作業も、前処理の一部です。
3. AIモデルの設計・開発・学習
整えたデータを使い、分類・予測・生成などを行うモデルを作ります。ここでの仕事は、手法を選び、学習させ、評価し、改善するという試行錯誤の繰り返しです。
- 手法の選定:表形式のデータなら決定木系の手法(勾配ブースティングなど)、画像・音声・文章のように複雑なデータならディープラーニングというように、データの種類と求める精度・説明しやすさで選びます
- ベースラインの作成:最初は単純なモデルで基準となる精度を出し、複雑な手法がそれを上回るかを確かめます
- 特徴量の設計:生データから予測に効く項目を作ります(曜日、前回からの経過日数など)
- ハイパーパラメータの調整:学習率や木の深さなど、学習の設定値を検証用データで調整します
- 過学習の確認:学習データでは精度が高いのに検証データで下がる状態を見つけ、正則化やデータ追加で対処します
Pythonでは、機械学習にscikit-learn、ディープラーニングにPyTorchやTensorFlowといったライブラリが広く使われています。評価では、目的に合った指標を選ぶことが欠かせません。
| 指標 | 意味 | 重視する場面 |
|---|---|---|
| 正解率 | 全体のうち正しく判定できた割合です | 各クラスの件数が同程度のとき |
| 適合率 | 「該当」と判定したもののうち本当に該当だった割合です | 誤検知のコストが高いとき |
| 再現率 | 本当に該当するもののうち見つけられた割合です | 見逃しのコストが高いとき |
| 平均絶対誤差など | 予測した数値と実際の値のずれの大きさです | 需要量や売上など数値を予測するとき |
たとえば不正利用の検知のように、該当するデータがごく少ない問題では、正解率が高くても見逃しが多いことがあります。指標の選び方を誤ると「数字は良いのに現場で使えないモデル」になるため、業務の損失構造から指標を決める視点が求められます。
4. システムへの実装
モデルは、業務システムやアプリから呼び出せて初めて価値を生みます。入力データを受け取り、モデルで処理し、結果を画面や他システムへ返す一連の流れを設計します。
| 実装方式 | 概要 | 選ばれる主な理由 |
|---|---|---|
| Web API化 | モデルをAPIとして切り出し、アプリ側から呼び出します | モデルの差し替えや再学習後の更新がアプリ改修なしで行いやすくなります |
| クラウドの推論基盤 | AWS・Microsoft Azure・Google Cloudなどの機械学習サービス上で動かします | 利用量に応じて処理能力を増減しやすくなります |
| オンプレミス | 社内ネットワーク内のサーバーで動かします | 機密データを外部に出せないなど、セキュリティ要件が厳しい場合に向きます |
| エッジ | 工場設備、カメラ、スマートフォンなどの端末内で推論します | 通信の遅れを避けたいリアルタイム処理や、通信できない環境に向きます |
実装では、応答時間、同時アクセス数、障害時の代替動作(AIが応答しないときにどう処理するか)も設計対象になります。モデル単体の精度だけでなく、システム全体として安定して動くことが求められます。
5. 運用・改善(MLOps・データドリフト)
AIシステムは、公開した時点の精度が永続するわけではありません。季節の変化、商品構成の変更、利用者層の変化などで入力データの傾向が変わると、予測がずれていきます。この現象をデータドリフトと呼びます。
- 監視:入力データの分布と予測結果を定期的に確認し、学習時とのずれを検知します
- 再学習:新しいデータを加えて学習し直し、評価用データで旧モデルと比較してから切り替えます
- バージョン管理:どのデータ・どの設定で学習したモデルかを記録し、問題があれば前のモデルに戻せるようにします
- 自動化:学習・評価・デプロイを一連のパイプラインとして管理します。この考え方をMLOps(Machine Learning Operations)と呼びます
MLOpsの実践では、実験管理にMLflow、パイプラインの実行にクラウド各社のサービスやKubernetesなどが使われます。運用工程まで設計できるかどうかは、実務経験のあるAIエンジニアとそうでない人の差が出やすい部分です。
6. 生成AI・LLMを組み込む開発
近年は、自社でゼロからモデルを学習するだけでなく、大規模言語モデル(LLM)などの生成AIを業務システムに組み込む仕事が増えています。この場合の中心的な作業は次のとおりです。
- 社内データとの連携:社内文書を検索して回答の根拠として渡す仕組み(RAG:検索拡張生成)を設計します
- 出力の評価:回答の正確さ・根拠の有無を評価する質問セットを作り、変更のたびに確認します
- ハルシネーション対策:根拠のない回答を抑えるため、参照元の提示、回答範囲の制限、人による確認の工程を組み込みます
- コストと応答速度の管理:利用量に応じた費用と応答時間を見積もり、モデルの使い分けを判断します
プロンプトの設計もこの中に含まれますが、AIエンジニアはそれに加えて、データの取り込み・権限管理・評価の仕組みまでシステムとして作り込む点が異なります。
AIエンジニアの種類と、開発されるAIの身近な例
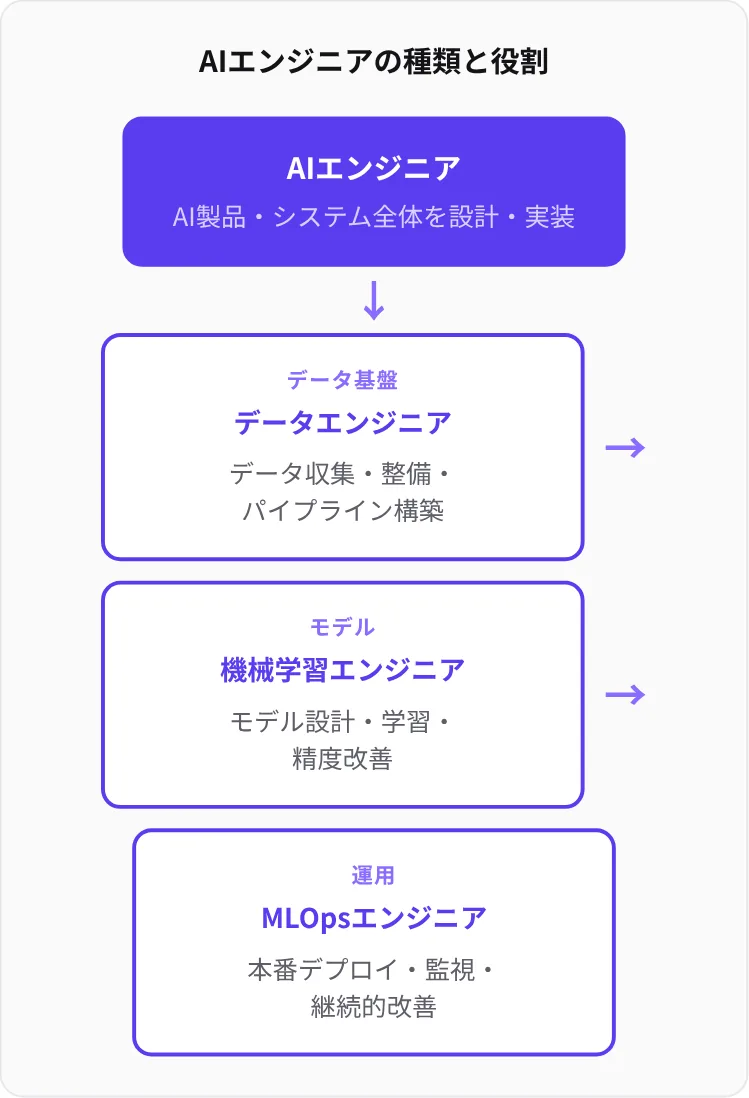
「AIエンジニア」は、AIに関わる技術職の総称として使われることが多い言葉です。求人では、担当する工程や扱うデータの種類によって、より細かい職種名で募集されることがあります。
| 職種名 | 主な担当 | 特に必要なスキル |
|---|---|---|
| 機械学習エンジニア | モデルの設計・学習・評価 | 機械学習の理論、Python、評価設計 |
| データエンジニア | 大量データを集めて蓄積・加工する基盤の構築 | SQL、データパイプライン、クラウド |
| MLOpsエンジニア | 学習・デプロイ・監視の自動化と運用 | コンテナ、CI/CD、監視の設計 |
| NLP・LLMエンジニア | 文章を扱うAIや生成AIの組み込み | 自然言語処理、RAG、出力評価 |
| コンピュータビジョンエンジニア | 画像・映像を扱うAIの開発 | 画像処理、ディープラーニング、エッジ実装 |
| AI研究者・リサーチエンジニア | 新しい手法の研究と検証 | 数学、論文の読解と再現実装 |
データサイエンティストやデータアナリスト、データアーキテクトをAI関連職種に含めて紹介する解説もあります(東京ITプログラミング&会計専門学校仙台校の解説など)。どこまでを「AIエンジニア」と呼ぶかは企業によって異なるため、求人では職種名よりも業務内容の記載で判断するのが確実です。
AIエンジニアが作るAIの身近な例
AIエンジニアが関わるシステムは、日常の中にも多くあります。
- 音声認識:スマートフォンやスマートスピーカーの音声入力
- 画像認識:自動運転の研究開発における歩行者・標識の認識、医療画像の読影支援
- 不正検知:クレジットカードの利用パターンから外れた取引の検知
- 需要予測:販売実績や季節要因から入荷量・生産量を見積もる仕組み
- レコメンド:通販や動画配信での「おすすめ」表示
複数のAI技術を組み合わせる製品もあります。たとえばDeepAIは、実在の人物の容姿・表情・声・振る舞いをデジタル空間で再現するバーチャルヒューマン/AIアバターのソリューションで、リップシンク・表情生成・音声合成・対話AIなどを組み合わせ、接客・研修・面接練習・広報などの用途で活用されています。DeepAIのロープレ・面接練習では、受講者の表情・感情・緊張度を発話タイムラインに沿って解析・可視化します。このように、音声・映像・言語の各技術をつなぎ、利用者の体験として成立させるシステム設計も、AIエンジニアが担う仕事の一例です。
AIエンジニアに必要なスキル
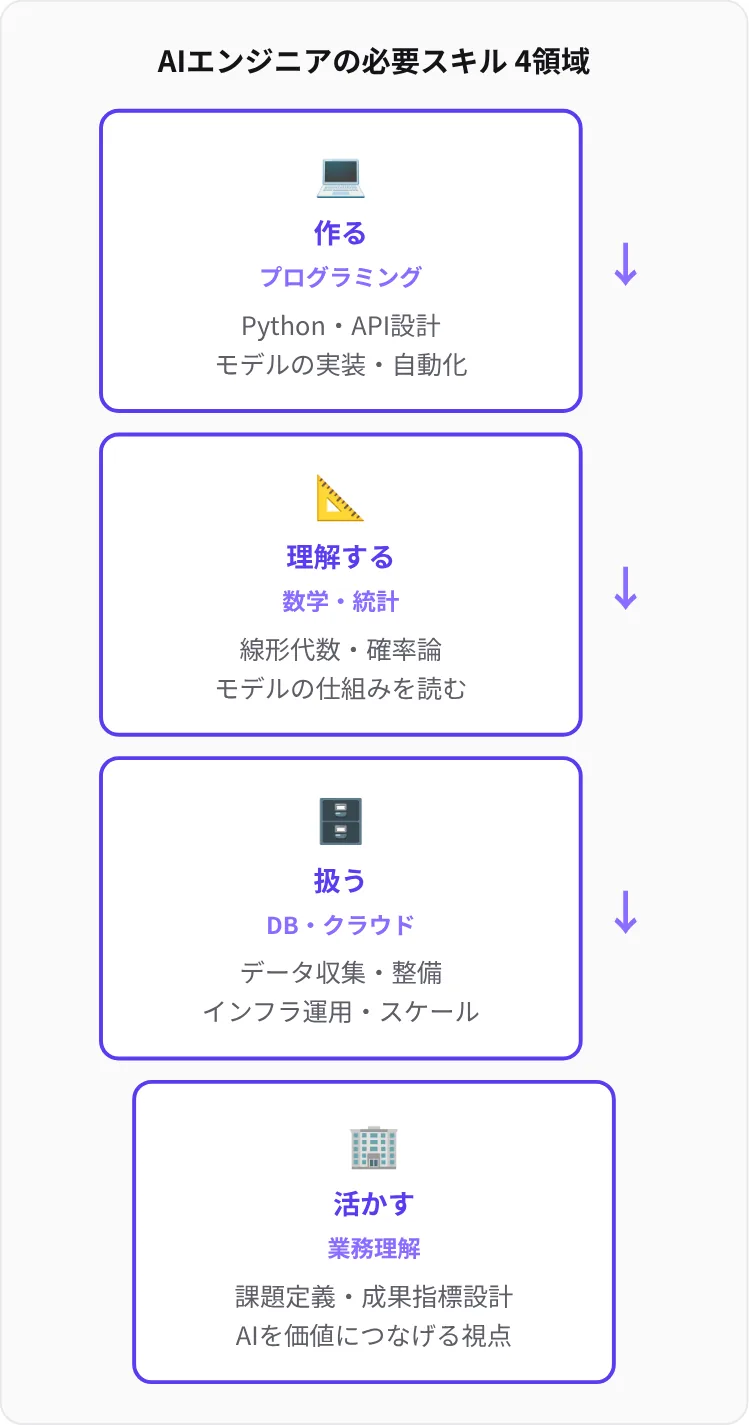
AIエンジニアに必要なスキルは、「作る力(プログラミング)」「理解する力(数学・統計・機械学習)」「扱う力(データベース・クラウド)」「活かす力(ビジネス理解・コミュニケーション)」の4つに分けて考えると整理しやすくなります。すべてを最初から高い水準で持つ必要はなく、担当する工程によって重点が変わります。
プログラミング言語(Python・R・C++など)
AI開発で最も広く使われている言語はPythonです。機械学習・ディープラーニング・データ処理のライブラリが充実しており、試作から実装まで一つの言語で進めやすいためです。ただし、用途によって他の言語も使われます。
| 言語 | 主な用途 | 代表的なライブラリ・特徴 |
|---|---|---|
| Python | データ処理、モデル開発、API実装 | pandas、NumPy、scikit-learn、PyTorch、TensorFlow |
| R | 統計解析、研究用途の分析 | 統計手法のパッケージが豊富です |
| SQL | データベースからのデータ抽出・集計 | 学習データの準備でほぼ必ず使います |
| C++ | 高速な推論、組み込み機器での実装 | 処理速度やメモリ効率が求められる場面で使います |
| Java・Go など | 既存の業務システムとの連携 | 組み込む先のシステムの言語に合わせます |
Pythonを書けるだけでなく、読みやすいコードを書く、テストを書く、Gitでバージョン管理するといった、ソフトウェア開発の基本も実務では欠かせません。
数学・統計(線形代数・微分積分・確率統計)
数学は、ライブラリを「使う」だけなら直接計算することは少ないものの、モデルがうまく動かないときに原因を考えるために必要になります。各分野がAI開発のどの場面で使われるかを押さえておくと、学ぶ範囲を絞り込めます。
| 分野 | AI開発で使う場面 | まず押さえたい内容 |
|---|---|---|
| 線形代数 | データやモデルの重みは行列・ベクトルで表されます | ベクトル、行列の積、次元、固有値の考え方 |
| 微分積分 | モデルは誤差を小さくする方向へ重みを少しずつ動かして学習します(勾配降下法) | 微分の意味、偏微分、連鎖律 |
| 確率 | 分類モデルの出力は「どれくらいの確からしさか」を表します | 確率分布、条件付き確率、ベイズの考え方 |
| 統計 | データの傾向把握、モデルの比較、効果の検証に使います | 平均・分散、相関、仮説検定、サンプリングの偏り |
どの程度の深さが必要かは職種によって大きく異なります。研究寄りの職種では論文の数式を読み解く力が求められ、実装・運用寄りの職種では「なぜこの指標が悪化したのか」を統計的に説明できる力が重視されます。自分の到達度を確かめるには、学習の仕組み(損失関数を微分して重みを更新する流れ)を、ライブラリを使わずに簡単なコードで再現できるかを試すのが効果的です。
データベース・SQL
学習に使うデータの多くは、企業のデータベースやデータウェアハウスに蓄積されています。そのため、必要なデータを自分で抽出・集計するSQLのスキルはほぼ必須です。
- 基本操作:SELECT、WHERE、JOIN、GROUP BYで目的のデータを取り出します
- 集計・加工:ウィンドウ関数などを使い、「直近30日の利用回数」のような特徴量をSQLで作ります
- データ設計の理解:テーブル同士の関係を理解し、重複や抜け漏れのない抽出を行います
- NoSQL・大規模データ:ログや非構造データを扱う場合は、NoSQLや分散処理基盤の知識も役立ちます
機械学習・ディープラーニングの知識
教師あり学習・教師なし学習・強化学習の違い、回帰と分類、学習と推論の関係、過学習とその対策といった基礎は、どの職種でも共通して求められます。ディープラーニングでは、画像に使われる畳み込みニューラルネットワークや、文章処理で中心的なTransformerの仕組みを理解しておくと、手法選択の判断がしやすくなります。
クラウド・コンテナ(AWS・Azure・Google Cloud・Docker)
学習には大量の計算資源が必要になることが多く、GPUを使える環境をクラウドで用意するのが一般的です。また、開発環境と本番環境の差による不具合を避けるため、Dockerなどのコンテナ技術でモデルの実行環境をまとめて扱います。
- クラウドの機械学習サービスでの学習・デプロイ
- Dockerによる実行環境のコンテナ化
- Kubernetesなどでの運用とスケーリング
- 権限管理やネットワーク設定などのセキュリティの基本
生成AI・LLM関連技術の理解
生成AIを業務に組み込む案件が増えていることから、LLMの得意・不得意の理解、RAGの設計、出力評価の方法、利用コストの見積もりといった知識の重要度が高まっています。モデルの世代交代が速い分野のため、特定の製品の使い方よりも、評価の仕組みを作って比較できる力の方が長く役立ちます。
ビジネス理解・コミュニケーション能力
AIエンジニアは、業務部門・経営層・システム部門など、立場の異なる関係者と仕事をします。そのため、次のような力が求められます。
- 業務の流れを理解し、AIをどこに組み込めば効果が出るかを考える力
- 「AIは100%正しくはない」ことを前提に、誤りが出たときの業務の流れを一緒に設計する力
- 精度や評価指標を、専門用語を使わずに説明する力
- 個人情報の扱いやAIに関する法規制・社内ルールを確認し、関係部門と調整する力
AIエンジニアの将来性と需要
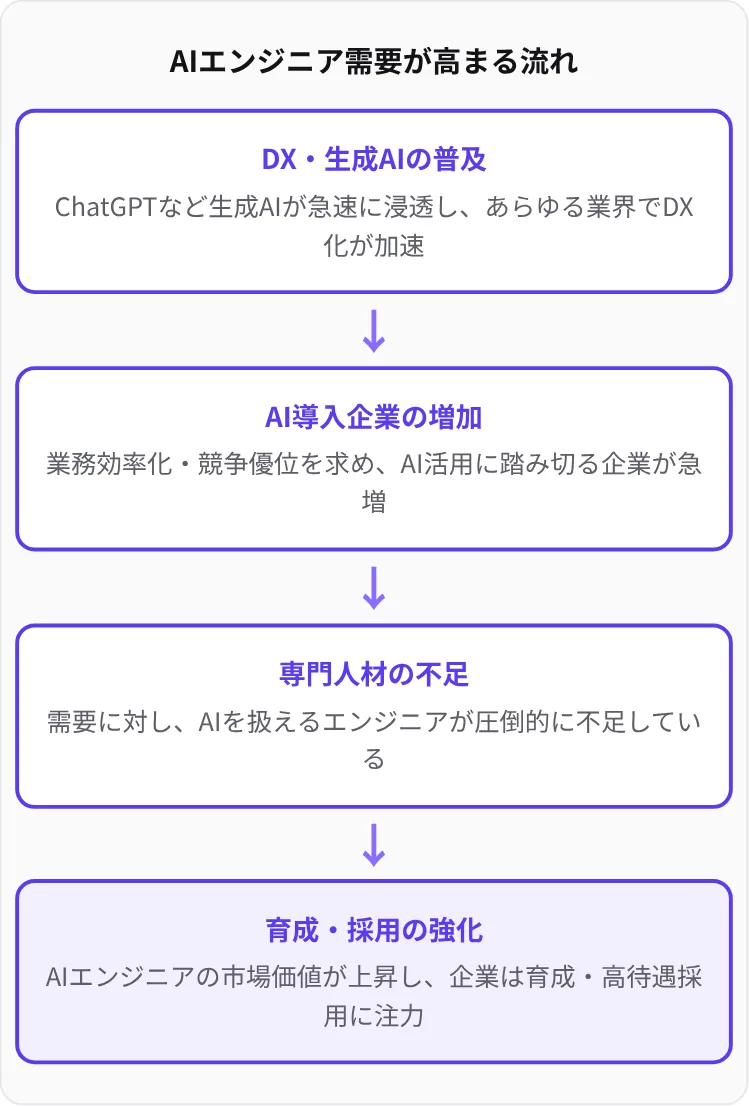
AIエンジニアは、需要に対して人材の供給が追いついていない職種とされています。DX推進や生成AIの普及によりAIを導入する企業が増える一方、データ・モデル・運用まで扱える人材の育成には時間がかかるためです。
需要と人材不足を示すデータ
エンジニア転職サービスのメイテックネクスト(m-next.jp)の解説では、次の公的データが紹介されています。
| 項目 | 内容 | 元データ |
|---|---|---|
| IT関連の職業の有効求人倍率 | 2025年3月時点(東京)で約3.69倍。全職種平均の1.53倍を大きく上回る | 厚生労働省「職種別有効求人・求職状況(一般常用)」 |
| AI導入企業の人材課題 | AI導入を進める企業のうち62.4%が「AI人材の不足」を課題に挙げている | 情報処理推進機構(IPA)「DX動向2024」 |
有効求人倍率は「IT関連の職業」全体の数値で、AIエンジニアだけの値ではない点に注意が必要です。最新の数値は、厚生労働省・IPAの公表資料で確認してください。また、AIの活用はIT業界にとどまらず、自動車・製造・物流・医療・介護など多くの業界に広がっていることも、需要を支える要因とされています。
「AIエンジニアの仕事はなくなる」は本当か
生成AIによって、コードのひな形作成、デバッグの補助、定型的な分析など、AIエンジニアの作業の一部は自動化が進んでいます。簡単な画像分類であれば、ノーコードツールで作れる場面も増えました。
一方で、次のような判断は自動化しにくく、むしろ重要度が高まっています。
- 業務課題をAIで解ける問いに落とし込み、評価指標を決めること
- データの偏りやリークを見抜き、本番で使える精度かを判断すること
- 誤りが出た場合の影響を見積もり、人による確認を含めた業務の流れを設計すること
- 運用中の精度低下を検知し、再学習の要否を判断すること
つまり、「コードを書く作業」は減っても、「AIを業務で安全に機能させる設計と判断」の仕事は残り、生成AIを道具として使いこなせるAIエンジニアの価値は高まると考えられます。
「やめとけ」と言われる理由と実際
| 言われる理由 | 実際のところ | 確かめ方 |
|---|---|---|
| 学ぶ範囲が広く難しい | 数学・プログラミング・機械学習を並行して学ぶ必要があり、習得に時間がかかります | 担当したい工程を決め、必要なスキルから順に学びます |
| 試行錯誤が多く負荷が高い | 前処理や再学習は一度で終わらないことが多いです。負荷は企業の体制で大きく異なります | 選考時に開発体制・運用体制を質問します |
| 技術の変化が速い | 手法やツールの入れ替わりが速く、学び続ける必要があります | 基礎理論を固めると、新しい技術の理解が速くなります |
資格・目指し方・採用時の確認ポイント
AIエンジニアになるために必須の資格はありません。採用では、資格よりも「実際に何を作り、どう評価したか」が重視される傾向があります。ただし、資格は体系的に学ぶための道しるべになり、未経験者にとっては基礎知識を示す材料にもなります。
学習の目安になる資格
| 資格 | 主催 | 確認できる知識 |
|---|---|---|
| G検定(ジェネラリスト検定) | 日本ディープラーニング協会(JDLA) | ディープラーニングの基礎知識と、活用・法律・倫理の理解 |
| E資格(エンジニア資格) | 日本ディープラーニング協会(JDLA) | ディープラーニングの理論と実装の力。受験にはJDLA認定プログラムの修了が必要です |
| 統計検定 | 日本統計学会公式認定(統計質保証推進協会) | 統計の知識と活用力(級・区分ごと) |
| 基本情報技術者試験 | 情報処理推進機構(IPA) | ITエンジニアとしての基礎知識 |
| Python 3 エンジニア認定試験(基礎・データ分析など) | Pythonエンジニア育成推進協会 | Pythonの文法や、データ分析ライブラリの基礎 |
| クラウド各社のAI・機械学習関連認定 | AWS・Microsoft・Google | 各クラウドでのAI・機械学習サービスの活用。名称や区分は改定されるため各社公式で確認が必要です |
AIエンジニアになるルート
- 大学・大学院:情報科学・数理・統計などを専攻し、研究経験を積むルートです。研究開発職では大学院での研究経験を求める求人もあります
- 専門学校:AI関連の学科・専攻で、プログラミングと開発実習を中心に学ぶルートです
- 職種転換:ソフトウェアエンジニアやデータ分析職から、社内のAI案件に関わって移るルートです。開発や運用の経験がそのまま生かせます
- 独学・講座:オンライン教材や講座で学び、作品を作って応募するルートです
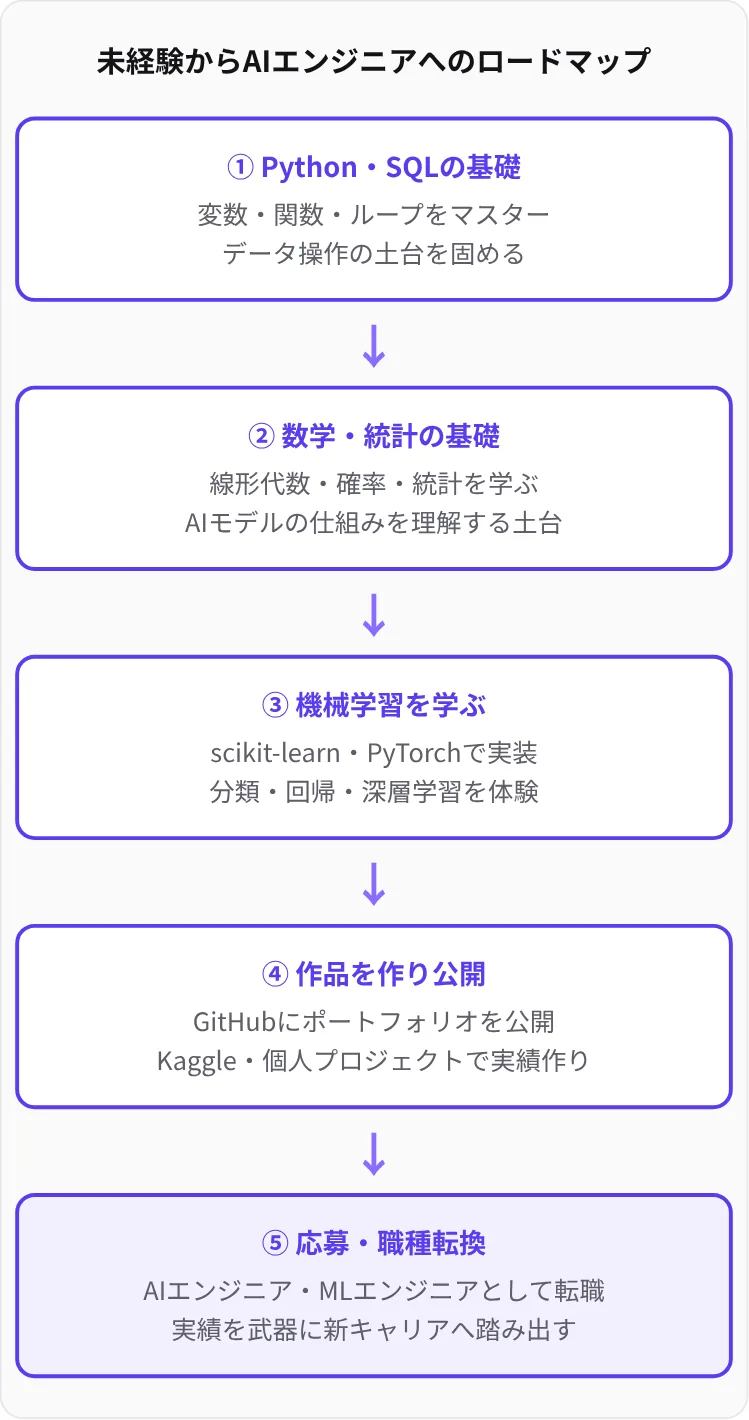
未経験から目指す場合は、スキルを示す実績づくりが重要です。公開データを使って「課題設定→前処理→モデル作成→評価→改善」までを一通り行い、その過程と判断理由をGitHubなどで公開すると、採用担当者が実力を判断しやすくなります。Kaggleなどのデータ分析コンペティションへの参加も、実践経験の場として活用できます。
向いている人の特徴
- 新しい技術に関心を持ち、継続して学べる人
- うまくいかない原因を仮説を立てて一つずつ検証できる人
- 地道なデータ確認・整備の作業を丁寧に進められる人
- 技術の内容を相手に合わせて説明できる人
年収は、担当工程・経験年数・業界・地域によって大きく異なります。目安を知りたい場合は、厚生労働省の職業情報提供サイト(job tag)や、実際の求人票に記載された条件を複数比較して確認する方法が確実です。
採用担当者が確認したいポイント
AIエンジニアの採用では、扱えるツール名の数よりも、工程ごとの判断経験を確認すると、実務での力を見極めやすくなります。
| 確認する工程 | 面接での質問例 | 見るべき点 |
|---|---|---|
| 課題設定 | 評価指標をどう決めましたか | 業務上の損失と指標を結びつけて説明できるか |
| データ前処理 | データで最も苦労した点は何ですか | 欠損・偏り・リークへの具体的な対処を語れるか |
| モデル開発 | その手法を選んだ理由は何ですか | ベースラインとの比較や、他の手法を退けた理由があるか |
| 実装・運用 | 公開後に精度が落ちたらどうしますか | 監視・再学習・切り戻しの手順を考えられるか |
求人票を作る際も、「AIエンジニア」という職種名だけでなく、担当する工程(データ基盤・モデル開発・運用・生成AIの組み込みなど)と使用する環境を具体的に書くと、応募者とのミスマッチを減らしやすくなります。
まとめ
- AIエンジニアとは、データの整備からモデルの設計・学習、システムへの実装、運用中の精度維持までを担う技術職です。
- 仕事は「課題設定・PoC」「データ収集・前処理」「モデル開発・学習」「実装」「運用・改善(MLOps)」の工程で進み、近年は生成AI・LLMの組み込みも重要な業務になっています。
- 必要スキルは、Python・SQLなどのプログラミング、線形代数・微分積分・確率統計、機械学習・ディープラーニング、クラウド・コンテナ、そしてビジネス理解とコミュニケーションです。
- IT関連職の高い求人倍率やAI人材不足を課題とする企業の多さが示すように需要は高く、生成AIで作業が自動化されても、設計と判断を担う役割は残ります。
- 資格は必須ではありませんが、学習の道しるべになります。実務では「何を作り、どう評価し、どう改善したか」を説明できることが最も重視されます。
参考文献
- KDDI 法人のお客さま「AIエンジニアとは?仕事内容やスキル、将来性まで徹底解説」(2026年1月15日)https://biz.kddi.com/
- メイテックネクスト「AIエンジニアに将来性はある? やめとけといわれる理由や需要を解説」https://www.m-next.jp/
- 東京ITプログラミング&会計専門学校仙台校「AIエンジニアは何をする職業?仕事の全貌やITエンジニアとの違い」https://www.sendai-itkaikei.ac.jp/
- 大阪コミュニケーションアート専門学校「仕事図鑑 AIエンジニア」https://www.oca.ac.jp/
- 厚生労働省(職種別有効求人・求職状況)https://www.mhlw.go.jp/
- 厚生労働省 職業情報提供サイト(job tag)https://shigoto.mhlw.go.jp/
- 独立行政法人 情報処理推進機構(IPA)「DX動向2024」/情報処理技術者試験 https://www.ipa.go.jp/
- 日本ディープラーニング協会(G検定・E資格)https://www.jdla.org/
- 統計検定 https://www.toukei-kentei.jp/
- Pythonエンジニア育成推進協会 https://www.pythonic-exam.com/
Read next
あわせて読みたい
-
AIの種類とは?特化型・汎用型から生成AIまでわかりやすく解説
AIの種類とは、AI(人工知能)を「どこまでできるか(能力)」「何に使うか(用途)」「どう学ぶか(学習方式)」といった軸で分けた分類のことです。よく使われる分類...
-

AIが判断する仕組みとは?学習からデータ・モデル・推論まで解説
AIの仕組みとは、大量のデータから規則性を学んで「モデル」を作り(学習)、そのモデルに新しいデータを入力して答えを出す(推論)という2段階の流れのことです。Ch...
-
ニューラルネットワークとは?仕組みと種類(DNN・RNN)をわかりやすく解説
ニューラルネットワークとは、人間の脳の神経細胞(ニューロン)が信号を伝え合う仕組みを手がかりに作られた、入力から出力への複雑な対応関係(非線形関数)をデータから...