
blog
AIブログ
デジタルヒューマンとは?仕組み・活用を分かりやすく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
デジタルヒューマンとは、人間と見分けがつきにくいリアルな見た目をCGで作り、AI(大規模言語モデルや音声認識・音声合成)で自然に会話までできるようにした「人型のAI」です。見た目だけで会話できないものは、高品質な3Dキャラクターであってデジタルヒューマンとは呼びません。受付・接客・教育・広報などで使われ、制作費は用途によって大きく変わります(目安は後述の表)。
実在の人物を再現する場合は、本人の同意と権利処理が前提になります。
AIアバター・デジタルヒューマンの定義や仕組みの全体像は → こちらの専門記事にまとめています。
デジタルヒューマンの定義を正確に理解する
デジタルヒューマンを正確に定義するには、「見た目」と「知性」の両軸を分けて考えることが重要です。
外見的リアリティの軸
人間の肌・髪・目・表情筋の動きを物理ベースのレンダリング(PBR)で再現し、見た目の上で人間と区別がつきにくいレベルに近づいた表現を指します。この領域では「アンキャニーバレー(不気味の谷)」をいかに越えるかが長年の技術課題でした。
知性・対話能力の軸
大規模言語モデル(LLM)や音声認識・合成(TTS/ASR)、感情分析AIを組み合わせ、人間の問いに自然に返答する能力を持たせます。この軸を持たないものは「ハイクオリティ3Dキャラクター」であり、デジタルヒューマンとは呼びません。
整理:デジタルヒューマンの位置づけ
| 名称 | 外見リアリティ | 自律的対話 | リアルタイム応答 |
|---|---|---|---|
| チャットボット | なし | テキストのみ | △ |
| 3Dアバター | 中〜高 | 限定的 | ○ |
| バーチャルインフルエンサー | 高 | 人間が操作 | ×(収録) |
| デジタルヒューマン | 高〜超高 | AI自律応答 | ◎ |
| ディープフェイク映像 | 超高(実在人物) | なし(生成物) | ×(後処理) |
このように、デジタルヒューマンは「高い外見リアリティ」と「AI自律応答」が同時に成立している点で、他のカテゴリと明確に区別されます。
国内外の現場でどんな場面に使われているかは、デジタルヒューマン事例で解説しています。
デジタルヒューマンを構成する5つの中核技術
デジタルヒューマンは単一の技術ではなく、複数の先端技術が統合されて初めて成立します。実際の開発現場では、以下の5レイヤーをそれぞれ設計・チューニングし、パイプラインとして繋ぎ合わせる作業が中心となります。
フォトグラメトリ・ニューラルレンダリングで人間の外見を忠実に再現。皮膚の透過感(サブサーフェススキャタリング)も計算。
音声波形に合わせてリップシンクを生成。感情パラメータに連動して眉・目・口が自然に動く。
ニューラルTTS(テキスト→音声)とASR(音声→テキスト)を低遅延で接続。声のクローンも可能。
GPT系・Gemini系等のLLMが文脈を理解し、自然な返答を生成。RAGで専門知識を付与可能。
Unreal Engine / Unity等でリアルタイム描画。GPU性能とクラウドストリーミングで遅延を最小化。
処理フロー:ユーザーの発話から応答映像まで
音声→テキスト
意図理解・返答生成
テキスト→音声
音声→口形生成
出力
実装上のポイントは全体の合計遅延を200〜300ms以内に抑えることです。どこか一つのモジュールがボトルネックになると「口パクがずれる」「返答が不自然に遅い」という体験劣化が起き、没入感が一気に失われます。TTS→リップシンク間の同期精度が最も品質に影響する箇所であり、ここのバッファリング設計が肝となります。
次に読む:デジタルヒューマンを無料で作る方法は?
リップシンクと表情生成の技術詳細
デジタルヒューマンの「人間らしさ」を決定づける最大の要素が、リップシンク(口形同期)と表情アニメーションの自然さです。
リップシンクの主要アプローチ
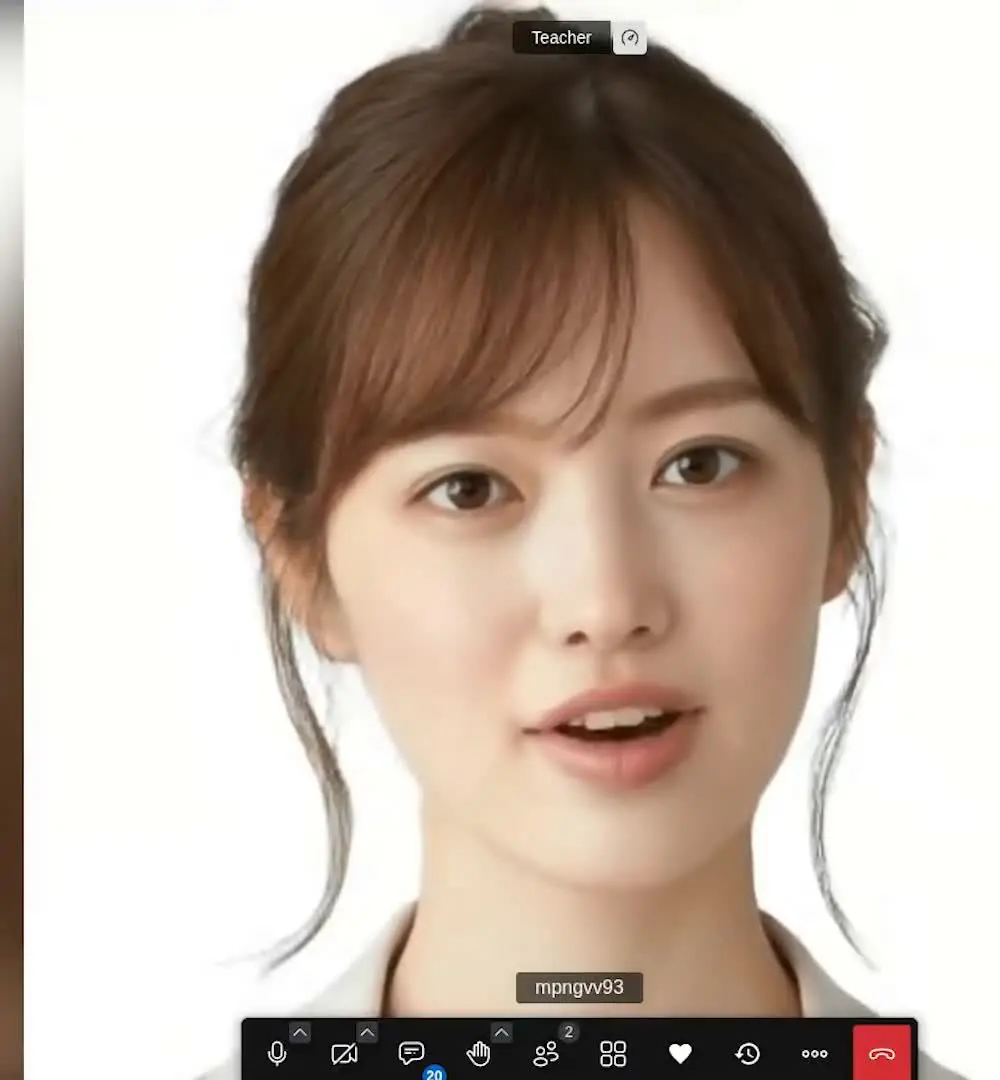
- 音素ベース:音声を音素に分解し、各音素に対応した口の形(ビセーム)を割り当てる古典的手法。計算コストが低いが不自然さが残りやすい。
- ニューラル音声駆動:音声波形を直接ニューラルネットワークに入力し、顔の変形パラメータ(ブレンドシェイプ)をリアルタイム予測する。Wav2Lipや、NVIDIAのAudio2Faceなどがこの系統。精度が大幅に向上している。
- ビデオベース(ディープフェイク型):実在する人物の顔映像に対して音声を合わせ込む方式。実在人物の複製が可能な反面、倫理・権利上の厳格な管理が必須。
表情の「感情連動」設計
口の動きだけでなく、眉・目・頬・首の微動作を連動させることで「感情が読み取れる表情」が生まれます。実装では感情パラメータ(喜び・驚き・困惑など)をLLMの出力から推定し、それをブレンドシェイプの重み付けに反映させる設計をとります。この感情→表情の写像テーブルの精度が、キャラクターの「感情豊かさ」の知覚に直結します。
ディープフェイクとデジタルヒューマンの関係
ディープフェイクはデジタルヒューマンの技術ファミリーに属しますが、用途と倫理的文脈が大きく異なります。
ディープフェイクは主に実在する特定人物の顔・声を生成・置換する技術であり、映像制作(俳優のデジタルスタント、故人の再現など)や詐欺・フェイクニュースの温床として両義的な存在です。一方、デジタルヒューマンは多くの場合、架空のキャラクターや本人同意の上での「デジタル分身」として設計されます。
デジタルヒューマンの開発現場では、実在人物をベースにした制作に際して必ず本人の書面同意・肖像権の権利処理・利用目的の明確化を契約条件に含めています。技術的には同じパイプラインを使えても、使用目的と同意の有無が倫理上の分水嶺です。
主要な活用領域と事例
カスタマーサポート・接客
銀行・保険・小売の窓口にデジタルヒューマンを配置し、24時間対応の「顔のある」接客を実現します。テキストチャットより信頼感・エンゲージメントが高く、親しみやすい接点を作れる点が期待されています。Unreal EngineのMetaHumanに自社のLLMを連携させる構成がよく使われます。
教育・研修
医療系教育機関では、患者役のデジタルヒューマンと対話する問診トレーニングが実用化されています。同じシナリオを何度でも繰り返せる・感情的な変化を演じさせられる点が強みです。語学学習の会話相手としても活用が広がっています。 クリスタルメソッドでは、精神的・知的障害のある方が通う就労支援施設「カーケル」(運営:オリエンタルブルーム株式会社)にて、就労模擬体験をAIで実施する取り組みを行っている。人前で緊張しやすい利用者でも、誰でも気兼ねなく繰り返し練習できる環境を実現した例である。
銀行・金融の窓口、観光・施設の案内
銀行や保険の窓口では、口座や手続きの案内を、顔のあるデジタルヒューマンが画面越しに行う使い方が考えられます。最終的な審査や契約の判断は人が行い、デジタルヒューマンは受付と一次案内を担当する分担が現実的です。観光案内や施設の案内では、来訪者の言語に合わせて話し、多言語に対応できる点が活かされます。どちらも、答えられない質問は有人に引き継ぐ設計が前提になります。
エンターテインメント・バーチャルインフルエンサー
Lil Miquela(米)、imma(日本)などのバーチャルインフルエンサーはデジタルヒューマン技術の早期実用例です。近年はSNS投稿だけでなく、ライブ配信でリアルタイム対話するインタラクティブ型に進化しています。
医療・ヘルスケア
メンタルヘルス分野では、AIセラピストとしてのデジタルヒューマンが研究段階を越え、一部で実用展開されています。「人間に話しにくいことをデジタルヒューマンには話せる」という心理的安全性が評価されています。 クリスタルメソッドでは、国立病院と連携し、病気と闘う患者の痛み緩和ケアを目的とした対話AIのPoCを実施している。医師・看護師へ共有する問診サポートAIとしての活用も検証中である。
企業の広報・ブランド活動
CEOや広報担当者の「デジタル分身」を作り、多言語対応の映像メッセージやWebサイトの案内役として活用する企業が増えています。一度制作すれば更新コストが低く、スケールしやすい点が採用理由として挙げられます。 クリスタルメソッドでも、企業の社長をバーチャルヒューマン化する「社長AI」を、大手SIer・大手建設会社・芸能プロダクションなどに向けて制作した実績があります。
文化財・歴史的人物の再現
博物館・テーマパークで歴史上の人物をデジタルヒューマンとして再現し、来館者と対話させる展示が国内外で登場しています。史実に基づくスクリプト管理と、誤情報を語らせないRAG設計が技術的課題です。 クリスタルメソッドでも、故人をデジタルヒューマンとして復元した実例がある。俳優・梅宮辰夫氏のDeepAIを制作し、2023年5月に関西テレビの企画で妻のクラウディア梅宮氏との束の間の再会を実現した(関西テレビ制作・放送)。過去の映像・音声データから人物を情報空間に復元する技術は、文化財・歴史的人物の再現と根を同じくする応用例である。
クリスタルメソッドが手がけたタレントAI
デジタルヒューマン技術の応用例として、実在の著名人をデジタルヒューマン化する「タレントAI」制作にも取り組んできた。吉村崇氏(お笑いコンビ・ノブコブ)を起点に、蛍原徹氏、田村淳氏、林修氏、関口宏氏、由美かおる氏、和田アキ子氏、Paledusk・カイト氏など、ジャンルを横断した実績がある。いずれもご本人・権利者の許諾を得たうえで制作しており、田村淳氏のAIはTikTok(@crystalmethod.jp)で楽曲を歌う様子が公開されている。国内タレントに加え、テレビ番組向けにイーロン・マスク氏のAI映像を制作した実績もある。地上波・BS・NHKや国際イベントでの露出実績もあり、日本テレビ「教科書で学べない今そこにある危機」(2021年5月)、フジテレビ「世界の何だコレ⁉ミステリー」(2022年9月)、テレビ朝日「ワイドスクランブル」(2023年1月)など、複数の番組で紹介されている。
デジタルヒューマンのメリット・デメリット
導入を考える前に、メリットとデメリットを並べて確認しておきます。
| メリット | デメリット・注意点 | |
|---|---|---|
| 体験 | 顔と声のある相手と話せるため、文字だけのチャットより親しみやすく、表情で気持ちも伝えられる | 不気味の谷(人間に近いほど小さな違和感が目立つ現象)が起きると、かえって不信感につながる |
| 運用 | 同じ品質で何度でも、時間を問わず対応できる。多言語にも対応しやすい | 音声認識・応答生成・音声合成の処理で遅延が出ると、会話がぎこちなくなる |
| コスト | 一度作れば、案内や説明の繰り返しを人手に頼らずに済む | 制作費に加え、クラウドの描画費用やLLMの利用料が運用中に続く |
| リスク | 台本や知識源を管理すれば、案内内容をそろえやすい | LLM由来の誤回答、実在人物を使う場合の肖像権・同意、AIであることの明示が必要 |
メリットは「いつでも同じ品質で、顔のある対応ができること」、デメリットは「作って終わりではなく、遅延・誤回答・権利への配慮を続ける必要があること」に集約されます。用途ごとの判断軸は、後半の「用途で変わる『求められる仕様』」で整理しています。
デジタルヒューマンが会話する様子を動画で見る
文章だけでは自然さが伝わりにくいため、自社のAI面接ロープレの動画を載せます。AIアバターが質問し、回答を受けて深掘りしていく流れを確認できます。リップシンクや間の取り方、応答の速さを見るときの参考にしてください。
デジタルヒューマン制作のプロセス
デジタルヒューマンの制作は、以下のフェーズで進行します。フェーズごとに必要な専門職と技術スタックが異なるため、ワンストップで対応できる体制を持つかどうかが品質に大きく影響します。
| フェーズ | 主な作業 | 主要技術・ツール |
|---|---|---|
| ①要件定義 | キャラクター設定・用途・インタラクション設計 | ブランドガイドライン、ペルソナ設計 |
| ②外観制作 | フォトグラメトリまたはフルCGでモデリング | MetaHuman Creator, ZBrush, Wrap3 |
| ③音声クローン | 声優・本人の音声収録→TTSモデル学習 | ElevenLabs, StyleTTS2, 独自学習 |
| ④LLM統合 | プロンプト設計・RAG構築・会話フロー設計 | GPT系, Gemini, LangChain |
| ⑤アニメーション統合 | リップシンク・表情・ボディランゲージの統合 | Unreal Engine, Unity, Audio2Face |
| ⑥配信基盤構築 | ストリーミング、クラウドレンダリング設定 | AWS/GCP, WebRTC, Pixel Streaming |
| ⑦QA・調整 | 遅延テスト・感情精度検証・ユーザーテスト | 主観評価・MOS評価・A/Bテスト |
実制作において品質の差が出やすいのは②の外観と⑤のアニメーション統合です。特に「アンキャニーバレーを越えているか」の判定は数値指標だけでは不十分で、人間の目によるレビューを複数回重ねることが不可欠です。
バーチャルヒューマン・AIアバターの業務活用をご検討の方は、DeepAIアバターを自社開発するクリスタルメソッドの無料相談をご利用ください。
コスト・開発期間の目安
デジタルヒューマンの開発コストは用途・品質レベル・インタラクション要件によって大きく異なります。以下はあくまで市場における目安感です(2025〜2026年時点)。
| グレード | 品質・機能 | 開発費用感 | 制作期間 |
|---|---|---|---|
| エントリー | 既存プラットフォーム活用・限定対話 | 数十〜数百万円 | 1〜2ヶ月 |
| スタンダード | カスタム外観・LLM統合・基本感情表現 | 数百〜1,000万円台 | 3〜6ヶ月 |
| ハイエンド | フォトリアル・声クローン・高度RAG・多言語 | 数千万〜1億円超 | 6〜18ヶ月 |
運用フェーズでは、クラウドレンダリング費用とLLM APIコストが継続的に発生します。同時接続数が増えるほどこのランニングコストが支配的になるため、スケール設計を初期から考慮することが重要です。
倫理的課題と法規制の動向
デジタルヒューマンの普及に伴い、以下の倫理・法的論点が重要度を増しています。
① 同意・肖像権・ディープフェイク悪用
実在人物をベースにするケースでは、本人の明示的同意なき生成は肖像権・パブリシティ権の侵害に該当し得ます。欧州のAI Act(2024年に発効し、段階的に適用)では、AIと対話していることや、ディープフェイクなどAI生成コンテンツであることの表示義務(第50条)が2026年8月2日から適用されており、日本でも不正競争防止法・プロバイダ責任制限法の文脈で議論が進んでいます。
② 「AIであること」の開示義務
消費者保護の観点から、対話相手がデジタルヒューマン(AI)であることを明示する義務が法制化される動きが複数の国・地域で見られます。医療・金融など高リスク分野では特に厳しい規制が予想されます。
③ 差別・偏見の埋め込みリスク
LLMの学習データに含まれるバイアスがデジタルヒューマンの応答に反映されるリスクがあります。外見デザインにおいても、特定の民族・ジェンダー表現への偏りが指摘されることがあります。
④ 労働・経済への影響
コールセンター・接客・教育など人手に依存してきた職種への代替が進む可能性があり、社会的議論が必要です。現時点では「補完ツール」として設計されるケースが多いですが、中長期的な影響を軽視することはできません。
アンキャニーバレーと「人間らしさ」の設計
アンキャニーバレー(Uncanny Valley)とは、ロボットやCGが人間に近づくにつれ、ある閾値で逆に「不気味さ」が急増する現象です。グラフで表すと、そこだけ好感度が谷のように落ち込むことからこう呼ばれます。
現代のデジタルヒューマンはこの谷を越えるか、意図的に回避するかの2つの戦略をとります。
- 超高精度リアリズム路線(谷を越える):Epic GamesのMetaHuman、NVIDIAのACEなどが目指す方向。皮膚の微細テクスチャ・瞳の反射・産毛・毛細血管まで再現し、物理的に「人間と区別できない」レベルに到達する。
- スタイライズ路線(谷を回避する):あえてアニメ調・抽象化されたキャラクターデザインにすることで、見る側が「人間のようなもの」ではなく「親しみやすいキャラクター」として認識するよう誘導する。Vtuberや一部のサービスアバターが採用。
実制作での経験では、目の動きと「まばたきのランダム性」が不気味の谷感覚に最も強く影響します。一定間隔でまばたきするだけでも十分な違和感があり、微小なランダム性と、会話の文脈に応じた自然な視線移動を実装することで大幅に改善されます。
主要プラットフォーム・ツールの比較
| プラットフォーム | 強み | 向いている用途 | 難易度 |
|---|---|---|---|
| Unreal Engine + MetaHuman | フォトリアル品質、柔軟な拡張性 | 映像制作・高品質インタラクティブ | 高 |
| NVIDIA Omniverse + ACE | Audio2Face等AI統合が強力 | エンタープライズ・リアルタイムAI | 高 |
| HeyGen / Synthesia | 低コスト・短期間・非技術者でも操作可 | 動画生成・ナレーター代替 | 低 |
| Unity + Convai | ゲーム連携・NPC AI対話に強い | ゲーム・VR/ARシミュレーション | 中〜高 |
| Soul Machines(2026年2月に管財手続きに入り、その後AppDirectが買収したと報じられています。導入前に提供状況の確認が必要) | 感情AI・エンタープライズ向けSaaS | カスタマーサポート・金融・ヘルスケア | 中(API統合) |
デジタルヒューマンの将来展望
2026年以降、デジタルヒューマン技術は以下のベクトルで進化すると考えられます。
ガウシアンスプラッティング・NeRFによる外観生成の革新
従来のポリゴンモデリングに代わり、3D Gaussian Splattingやニューラルラジアンスフィールド(NeRF)が実用段階に入りつつあります。スマートフォンで撮影した短時間の映像から高品質な3Dキャラクターを生成する時代が現実のものになりつつあり、制作コストと期間の劇的な圧縮が期待されます。
マルチモーダルLLMとの深化
テキスト・音声だけでなく、視覚情報(相手の表情・環境)を理解するマルチモーダルLLMとの統合が進むことで、「相手の表情を読んで応答を変える」デジタルヒューマンが実用化されます。
デジタルツイン(個人の分身)の普及
特定個人の知識・話し方・判断パターンをモデル化した「デジタルツイン」が、会議の代理出席や遺言映像の代替として使われる可能性があります。倫理・法的整備が追いつくかどうかが普及速度を左右します。
エッジ処理による完全ローカル動作
現在クラウド依存が多いレンダリング・LLM推論がエッジデバイス上で動作するようになることで、オフライン環境・低遅延・プライバシー保護の観点から利用シーンが大幅に拡大します。
デジタルヒューマンの実装で直面しやすい論点
ここまでは一般的な定義と技術を整理してきましたが、最後に、デジタルヒューマンの実装で直面しやすい論点を共有します。クリスタルメソッドは「実在の人物を情報空間に復元する」というテーマでデジタルヒューマンの研究開発を続けてきました。発明者・河合継のもとで取得した特許は16件にのぼり、その中核にはマルチモーダルな人物再現(特許番号JP6260979B1・2017年)やAIによる問診対話(特許番号JP7676075B1・2025年)が含まれます。以下は、実装で直面しやすい論点を教科書的な説明とは別の角度から整理したものです。
「人間らしさ」は単一技術では作れない——統合設計の難しさ
外見・音声・対話のどれか一つだけが高品質でも、デジタルヒューマンは破綻します。たとえば音声合成エンジン「SakuraSpeech」で自然な発話を実現できても、リップシンク(口の動き)の同期がわずかにずれるだけで違和感、いわゆるアンキャニーバレーが一気に立ち上がります。各要素の絶対品質よりも要素間の同期と一貫性こそが体験の質を決める、という点が重要です。
状況に応じた応答の再現——RAGで「らしさ」を担保する
対話の自然さは、流暢な文章生成だけでは足りません。「AIActor」では、状況を表すテキストから近い実データ(過去の発話・振る舞い)を検索し、それを土台に応答を再構成するRAG(検索拡張生成)型のアプローチを採っています。汎用LLMに丸投げするのではなく、本人の発話資産を検索して根拠にすることで、その人物「らしい」反応へ近づける——これが実在人物の再現で重要になる設計判断です。
ブラウザ完結のリアルタイム描画という制約
商用導入では「専用GPUサーバーを常時動かす」コストが障壁になりがちです。クライアント(ブラウザ)側で完結するリアルタイム描画を実機で検証すると、描画負荷・遅延・端末ごとのGPU性能差が現実的な壁になります。クラウドでの高品質生成と、エッジ/ブラウザでの軽量動作の間でどう折り合いをつけるかは、用途ごとに最適点が変わります。導入を検討する際は、この品質と動作環境のトレードオフを最初に押さえておくことをおすすめします。
よくある質問(FAQ)
Q. デジタルヒューマンとアバター・バーチャルヒューマンの違いは何ですか?
デジタルヒューマンは「人間と区別がつきにくい外見リアリティ」と「LLM等による自律的な対話能力」の両軸を備えたものを指します。自律対話を持たないものは高品質な3Dキャラクターであり、デジタルヒューマンとは呼びません。より広義の分身概念は「アバターとは(基礎解説)」を参照してください。
Q. ディープフェイクとは何が違うのですか?
ディープフェイクは実在する特定人物の顔・声を生成・置換する技術で、同意の有無が倫理上の分水嶺です。デジタルヒューマンは多くの場合、架空キャラクターまたは本人同意のうえでのデジタル分身として設計されます。実在人物ベースの制作時には、本人の書面同意・肖像権処理・利用目的の明確化を契約条件に含めることが一般的です。
Q. 制作費用はどのくらいかかりますか?
用途・品質レベル・インタラクション要件で大きく変動します。既存プラットフォーム活用のエントリーグレードで数十〜数百万円からが市場の目安感です(2025〜2026年時点)。詳細は本文「コスト・開発期間の目安」の表を参照してください。
Q. どのような手順で作りますか?
①要件定義(キャラクター設定・用途・インタラクション設計)→②外観制作(フォトグラメトリまたはフルCG)→③音声クローン(収録とTTSモデル学習)と進みます。フェーズごとの技術スタックは本文「デジタルヒューマン制作のプロセス」を参照してください。
「不自然さ」はどこから生まれるか──品質を見極める技術チェックポイント
デジタルヒューマンの評価で最初に難所となるのが、実在の人間に近づけるほど、わずかな崩れが違和感(いわゆる不気味の谷)として表れやすい点です。導入を検討する立場では「見た目のリアルさ」だけでなく、動き・音声・応答のどこで自然さが崩れるかを分解して確認できると、デモを正しく評価できます。ここでは実務でチェックしたい観点を、仕組みの側から整理します。
自然さを左右する4つのレイヤー
- 造形・レンダリング:肌の質感、髪や瞳のハイライト、影の付き方。静止画では自然でも、動いた瞬間に破綻しないかを動画で確認する。
- 表情・微細動作:まばたき、視線移動、口以外の顔全体の連動、呼吸に伴う体のわずかな揺れ。無表情の「待機状態」がロボット的に固まらないかが分かれ目になりやすい。
- リップシンク(口形と音声の同期):発話音と口の形がずれないか。特に日本語の母音や無音区間で口が開きっぱなしにならないかを見る。
- 応答レイテンシ:対話型では「音声認識→意図理解→応答生成→音声合成→口の動き」という処理連鎖があり、その合計時間が長いほど会話がぎこちなく感じられやすい。
デモで確認したい質問
- リアルタイム生成か、事前収録した動画の再生か(後述の用途設計に直結する)
- 想定する設置環境(Web/サイネージ)の回線・端末性能でも同等の品質・速度が出るか
- 横顔や大きな首振り、長い沈黙など「崩れやすい局面」を見せてもらえるか
- 日本語特有の抑揚・固有名詞でリップシンクや音声合成が破綻しないか
ポイントは、正面・短い一言・理想的な回線という「良い条件のデモ」だけで判断しないことです。実運用は横からの視線、雑音、長い応答、混雑時の遅延といった条件が重なりやすく、そこで自然さを保てるかが体験の質を左右します。仕組みを4レイヤーに分けて見ることで、「どこにコストと技術が効いているのか」「自社の用途ではどのレイヤーが最重要か」を切り分けて判断しやすくなります。
用途で変わる「求められる仕様」──導入設計の判断軸
デジタルヒューマンは「何をさせたいか」で必要な仕組みが大きく変わります。同じ見た目でも、一方的に情報を伝える用途と、その場で対話する用途とでは求められる技術も運用体制も異なります。ここでは、企画段階で仕様を固めるための判断軸を、用途タイプごとに整理します。まず最初に決めたいのは「双方向性の有無」と「設置チャネル」です。
双方向性で分ける2つの型
- 一方向(収録・生成した動画を再生):会社案内、商品説明、館内サイネージなど。台本が固定でよいため品質を作り込みやすく、レイテンシの問題が起きにくい。更新時は作り直しが必要になる点を運用計画に織り込む。
- 双方向(リアルタイム対話):受付、問い合わせ一次対応、接客など。応答速度・聞き取り精度・想定外の質問への対処が体験を左右する。裏側の応答ロジックや知識源(社内情報との連携)の設計が本体になる。
用途タイプ別の設計チェック
| 用途タイプ | 双方向性 | 特に重要な仕様 | 運用上の論点 |
|---|---|---|---|
| 案内・説明サイネージ | 一方向中心 | 映像品質・多言語ナレーション | 内容更新の頻度と作り直しコスト |
| 受付・一次対応 | 双方向 | 低レイテンシ・聞き取り精度 | 回答できない時の有人エスカレーション |
| Web接客・FAQ | 双方向 | 社内情報との連携・応答の正確さ | 誤回答時の責任範囲と免責の明示 |
情報管理とセキュリティの確認
顧客の相談内容や、社内の知識をデジタルヒューマンに連携させる場合は、情報の扱いを事前に確認します。ベンダーには、ISMS(ISO/IEC 27001)やプライバシーマークなどの認証の有無、入力された会話や音声データの保存期間と利用目的、学習に使われないかどうか、データの保存場所を確認するとよいでしょう。認証があるかどうかはベンダーごとに異なるため、見積もりの段階で書面で確認します。
企画時に決めておきたいこと
- 設置チャネル(Web/アプリ/サイネージ/キオスク)ごとの端末・回線条件
- 対応言語と、それぞれの音声・表情の品質担保
- 対話型なら「答えられない質問」をどう扱うか(有人切替・定型返答)
- コンテンツや知識の更新をだれが・どの頻度で行うかの運用主体
この判断軸を先に固めると、ベンダー選定やデモ評価の基準がぶれにくくなり、「見た目は良いが自社の用途には過剰/不足」というミスマッチを避けやすくなります。デジタルヒューマンは導入して終わりではなく、内容と応答を育て続ける前提で設計するのが、活用を定着させる近道です。
まとめ
デジタルヒューマンとは、高精度な3D外観と AI自律応答を統合した「インタラクティブな人型AIエージェント」です。3D外観生成・リップシンク・音声合成・LLM・リアルタイムレンダリングの5技術が連動して成立し、カスタマーサポート・教育・医療・エンターテインメントなど幅広い分野での実用化が進んでいます。
制作上の肝は遅延の最小化・アンキャニーバレーの回避・感情表現の自然さの3点にあり、それぞれの設計判断が最終的なユーザー体験の質を決定します。一方で、実在人物への同意管理・AI開示義務・ディープフェイク悪用防止という倫理・法的課題への対処も不可欠です。
ガウシアンスプラッティングやマルチモーダルLLMの進化により、今後2〜3年でデジタルヒューマンの制作コストと品質の両面が劇的に変化すると予想されます。技術の進化と社会的議論の両輪を追い続けることが、この領域に関わるすべての人に求められています。
関連記事
バーチャルヒューマン・AIアバターの業務活用をご検討の方へ
クリスタルメソッドは、リアルタイムに会話・応対するバーチャルヒューマン(DeepAIアバター)を自社開発しています。受付・接客・研修・面接などの業務にAIアバターを組み込みたい、自社の人物モデルでアバターを作りたい、といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
デジタルヒューマン事例|国内外の最新活用と実装の勘所
デジタルヒューマン事例:国内外の最新活用と実装の勘所 デジタルヒューマンは、AIと3DCG・リップシンク技術を組み合わせた「人間そっくりの仮想人物」であり、接客...
-
デジタルヒューマンを無料で作る・試す完全ガイド
デジタルヒューマンを無料で作る・試す完全ガイド 「デジタルヒューマンを無料で使いたいけれど、どのツールを選べばいいのかわからない」——そんな疑問を持つ方は多いは...
-
VOICEVOX 使い方|インストールから音声生成まで【2026】
VOICEVOXは無料?商用利用・クレジット表記の結論 VOICEVOXは、商用・非商用を問わず無料で使える音声合成ソフトです。ただし「VOICEVOXを利用し...