
blog
AIブログ
ElevenLabs(イレブンラボ)とは?使い方・料金・商用利用をわかりやすく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
「ナレーションを自分で録音するのは大変」「AI音声って、どこまで自然になったの?」——この記事は、そんな方に向けてAI音声サービスElevenLabs(イレブンラボ)の正体・できること・料金・始め方を、専門用語をできるだけ避けてやさしく解説します。無料プランから試せるので、読み終わる頃には今日から使い始められます。
この記事の要点(2026年10月14日に公式ページで確認した内容)
- ElevenLabsは、文章から人間の声に近い音声を作るAI音声サービスです。ブラウザだけで使えます。
- 最新の音声モデルはEleven v4(2026年9月28日に公開)で、90以上の言語に対応します。日本語も使えます。
- 無料プランは月1万クレジット(公式の目安で約10分)。商用利用はStarter(月6ドル)以上の有料プランからです。
- 自分の声を元にした音声(ボイスクローン)は、本人の同意がある声だけが対象です。
ElevenLabsを選ぶべきか — 用途別の判断早見
ElevenLabsは「表現力のある自然な合成音声」に強みを持つツールですが、すべての音声用途で最適とは限りません。ここでは導入前に自分の用途に合うかを見極めるための判断軸を、向く場面・向かない場面・他サービスとの使い分けの3点で整理します。定義や機能一覧ではなく、「使うかどうか」を決めるための情報です。
ElevenLabsが向く場面(3つ)
- 感情や抑揚が成果を左右するナレーション — オーディオブック、YouTube解説、ドラマ仕立てのポッドキャストなど、棒読みでは離脱される用途。ElevenLabsの強みである表現力がそのまま質に直結します。
- 1つの声を作り込んで反復利用したいとき — キャラクターボイスやブランドの「専用ナレーター」を用意し、後から同じ声で追加台本を読ませたい制作フロー。
- 多言語で同一トーンの音声を量産したいとき — 同じコンテンツを複数言語に展開する動画・eラーニング。ダビング機能で声質の一貫性を保ちやすい用途です。
ElevenLabsが向かない場面(3つ)
- 固有名詞・専門用語・数値の読みを厳密に固定したい業務 — 日本語では固有名詞や漢字の読み違いが起こり得るため、金融・医療の定型アナウンスなど「読み間違いが許されない」用途では、読みを辞書登録で制御できる国産エンジンの方が運用しやすい場合があります。
- アニメ調・キャラクター声を無償〜低コストで量産したいとき — 日本語のキャラクターボイス用途は、無料で使えるVOICEVOX等の方が目的に合うことがあります。
- 低頻度・少量の単発利用 — たまに数十文字を読ませるだけなら、月額前提の有料プランはコスト効率が悪くなりがちです。用途の量から先に見積もるのが安全です。
他の主要サービスとの1行使い分け
- ElevenLabs:表現力・声のクローン・多言語ダビングを重視するなら第一候補。
- OpenAI TTS / Google Cloud TTS:既存のアプリやワークフローに音声を組み込む、他AI機能と一体で使いたい開発用途に噛み合う。
- VOICEVOX(国産・無料):日本語キャラクターボイスを無料で使いたい個人制作向け。
- 読み辞書を持つ国産商用エンジン:固有名詞・数値の読みを厳密に管理したい業務アナウンス向け。
選び方の3つの軸
- 表現力 vs 読みの制御性 — 抑揚の自然さを取るか、読み間違いゼロの制御を取るか。両立は難しいため用途で優先度を決めます。
- 利用量(文字数・頻度) — 月あたりどれだけ生成するかを先に見積もると、無料枠で足りるか有料プランが要るかが判断できます。
- 組み込み方法 — 画面上で手動生成すれば足りるのか、自社サービスへAPI連携するのか。連携前提なら開発者向け機能の充実度も比較軸になります。
迷った場合は、まず無料枠で自分の実際の台本(特に日本語の固有名詞を含む一文)を読ませて音を聴き比べるのが最短の判断方法です。仕様表よりも、あなたの用途の実音を聴くほうが確実です。
月あたりの利用量に応じて選ぶ料金プランは、ElevenLabsの料金プラン一覧で説明しています。
ElevenLabsとは?ひとことで言うと「文章を渡すだけでプロ級の音声を作ってくれるAI」
ひとことで言うと、ElevenLabsは「テキストを貼り付けるだけで、人間そっくりの読み上げ音声を作ってくれるサービス」です。マイクも収録スタジオも不要で、ブラウザだけで完結します。
ElevenLabsは、2022年に創業されたAI音声合成スタートアップであり、高品質な音声生成・音声クローン技術を提供するプラットフォームとして知られています。テキストを入力するだけで人間の声に近い自然な音声を生成できる技術は、コンテンツ制作・教育・ゲーム・カスタマーサービスなど多様な領域に革新をもたらしています。本記事では、ElevenLabsの概要・主要機能・料金プラン・競合比較・活用シーンから注意点まで、公式ページで確認できた内容をもとに解説します。

次に読む:ElevenLabsは無料でどこまで使える?
🔥 ElevenLabsを使うとこんなに変わる(before → after)
ふだんの音声づくりがどう変わるか、具体的に並べてみます。
- 動画のナレーション:今まで=静かな環境を確保して録音・噛んだら撮り直し → テキストを貼って声を選ぶだけ。修正も文字の書き直しだけ
- 社内研修・マニュアルの音声化:今まで=ナレーター手配や自前収録でコストと日数 → 資料のテキストからすぐ音声化
- 多言語コンテンツ:今まで=言語ごとに話者を手配 → 多言語対応モデルで同じコンテンツを複数言語の音声に展開
- 自分の声の活用:今まで=毎回自分で読み上げ → 自分の声をクローンして、テキストから「自分の声」で生成(※本人の同意がある声のみ・後述の規約参照)
「あの音声づくり、任せられそう」と思えたら、まず無料プランで試すのが近道です(無料プランでできること)。
ElevenLabsの概要と背景
ElevenLabsは、ポーランド出身のMati StaniszewskiとPiotr Dabkowskiによって2022年に設立されたAI企業です。本社はニューヨークに置き、2024年には評価額10億ドルを超えるユニコーン企業となりました。Google・Palantir出身のエンジニアが中核を担い、深層学習ベースのTTS(Text-to-Speech)モデルを独自開発しています。
創業のきっかけは、既存の音声合成ツールが映画や吹き替えの品質に全く追いつけないという問題意識でした。「人間のナレーターと区別できない音声AIをつくる」というビジョンのもと、感情表現・抑揚・息継ぎまで再現するモデルを開発し、短期間で業界標準的な存在へと成長しました。
公式の会社紹介ページ(elevenlabs.io/about・2026年10月20日に確認)には、2026年9月30日付で「評価額が220億ドルに上がった」という見出しがあり、出資者としてAndreessen Horowitz・ICONIQ・Sequoia・NEAなどのロゴが並んでいます。設立年・創業者・資金調達の各回の金額は、このページには書かれていません。
2026年10月14日時点で、最新のTTSモデルEleven v4は90以上の言語に対応し(出典:公式ドキュメントのモデル一覧)、音声認識(STT)のScribe v2も90以上の言語に対応しています。日本語は公式のモデル一覧でv4・v3・Multilingual v2・Flash v2.5のいずれも「対応」と記載されています。自然なイントネーションの日本語音声を生成できる点が国内での注目を集めています。
ElevenLabsの主要機能
テキスト読み上げ(Text to Speech)
最も基本的な機能が、テキストを入力して音声に変換するText to Speech(TTS)です。ElevenLabsのTTSが他サービスと一線を画す理由は、感情・話速・抑揚をコンテキストから自動判断して再現する点にあります。単に文字を読み上げるだけでなく、疑問文では語尾を上げる、感嘆符では興奮気味のトーンになるといった自然な変化が自動で加わります。
ウェブブラウザ上のエディタから直接操作でき、生成した音声はMP3・WAV形式でダウンロード可能です。APIを通じてアプリケーションやワークフローに組み込むことも容易で、開発者向けの利用も非常に多い機能です。
音声クローン(Voice Cloning)
ElevenLabsの中でも特に注目を集めるのが音声クローン機能です。数十秒〜数分程度の音声サンプルをアップロードするだけで、その声の特徴を学習したカスタム音声モデルを作成できます。クローンした音声はTTS機能と組み合わせて、任意のテキストをその「声」で読み上げさせることができます。
音声クローンには2種類あります。
- Instant Voice Cloning(即時クローン):2分未満の短いサンプル音声からすぐに音声モデルを生成(公式ドキュメント)。Eleven v4の公式発表では、10秒の音声から作れるとされています。
- Professional Voice Cloning(プロフェッショナルクローン):長めの学習用音声を使って、より忠実な声を作る方式。Creatorプラン以上で作成できます(公式ドキュメント)。本人の声であることはボイスキャプチャ(voice-captcha)で確認されます。
ElevenLabs公式は、Eleven v4が第三者の評価サイトArtificial Analysisで1位、ブラインドテストで約75%の聴き手に選ばれたと発表しています(公式ブログの記載で、独立した検証ではありません)。実際の声の再現度は、自分の用途の音声で聴き比べて判断してください。ただし後述する倫理的配慮も非常に重要です。
音声デザイン(Voice Design / Voice Lab)
Voice Lab機能では、実在しない「架空の声」を一から設計できます。性別・年齢・アクセント・声のトーン(温かみのある声、権威ある声など)をパラメータで指定することで、完全にオリジナルの音声キャラクターを作成できます。
この機能はゲームキャラクターのボイス設計、バーチャルアシスタント、ブランドボイスの構築などに活用されています。バーチャルヒューマン領域でも、キャラクターごとに個性ある声を設計するプロセスでこうしたアプローチは非常に有効です。
音声翻訳・ダビング(Dubbing)
動画・音声ファイルを別の言語に自動翻訳し、さらに元の話者の声質を保ったまま別言語で再生成するダビング機能です。多言語版の音声を生成できるため、コンテンツのグローバル展開コストを大幅に削減できます。
公式の料金ページによると、ダビングの消費クレジットは自動ダビングで1分あたり2,000〜3,000、Dubbing Studioで1分あたり5,000〜10,000です(透かしの有無で変わります)。無料枠の1万クレジットでは、長い動画をすべて吹き替えるのは難しいと考えてください。
音声エージェント(Eleven Agents)
リアルタイムで会話できるAI音声エージェントを構築できる機能です。LLM(大規模言語モデル)と自社の音声合成エンジンを組み合わせ、低遅延で自然な会話応答を実現します。カスタマーサポートbot、音声インターフェースを持つAIアシスタント、教育用の対話AIなどに活用されています。
ElevenLabsの機能一覧と、機能ごとのクレジット消費
ElevenLabsはテキスト読み上げ以外にも、音声に関する機能をまとめて提供しています。消費するクレジットの目安は公式の料金ページの記載です(2026年10月14日に確認)。
| 機能 | できること | クレジットの目安 |
|---|---|---|
| Text to Speech | 文章を音声にする | 1文字あたり約1 |
| Speech to Text(Scribe) | 音声を文字にする(文字起こし) | 1分あたり330 |
| Voice Changer | 録音した音声を、別の声に変える。元の抑揚や感情を保てる(1回の音声は最長5分) | 1分あたり1,000 |
| Voice Isolator | 音声から声だけを取り出す | 1分あたり1,000 |
| Sound Effects | 文章の指示から効果音を作る | 1回あたり200 |
| Eleven Music | 文章の指示から音楽を作る(日本語を含む言語に対応) | 1分あたり900 |
| Dubbing | 動画・音声を別の言語に吹き替える | 1分あたり2,000〜10,000 |
Voice Changerの説明は公式ドキュメントの記載です。Dubbingの詳しい違いや、各機能の使い方は、必要になったときに公式ドキュメントで確認してください。
ElevenLabsの機能別の詳細(公式ドキュメントの上限と条件)
機能ごとの上限や条件は、公式ドキュメント(elevenlabs.io/docs/overview/capabilities・2026年10月19日に確認)の記載です。仕様は変わるため、利用前に公式で確認してください。
| 機能 | 公式に記載されている内容 |
|---|---|
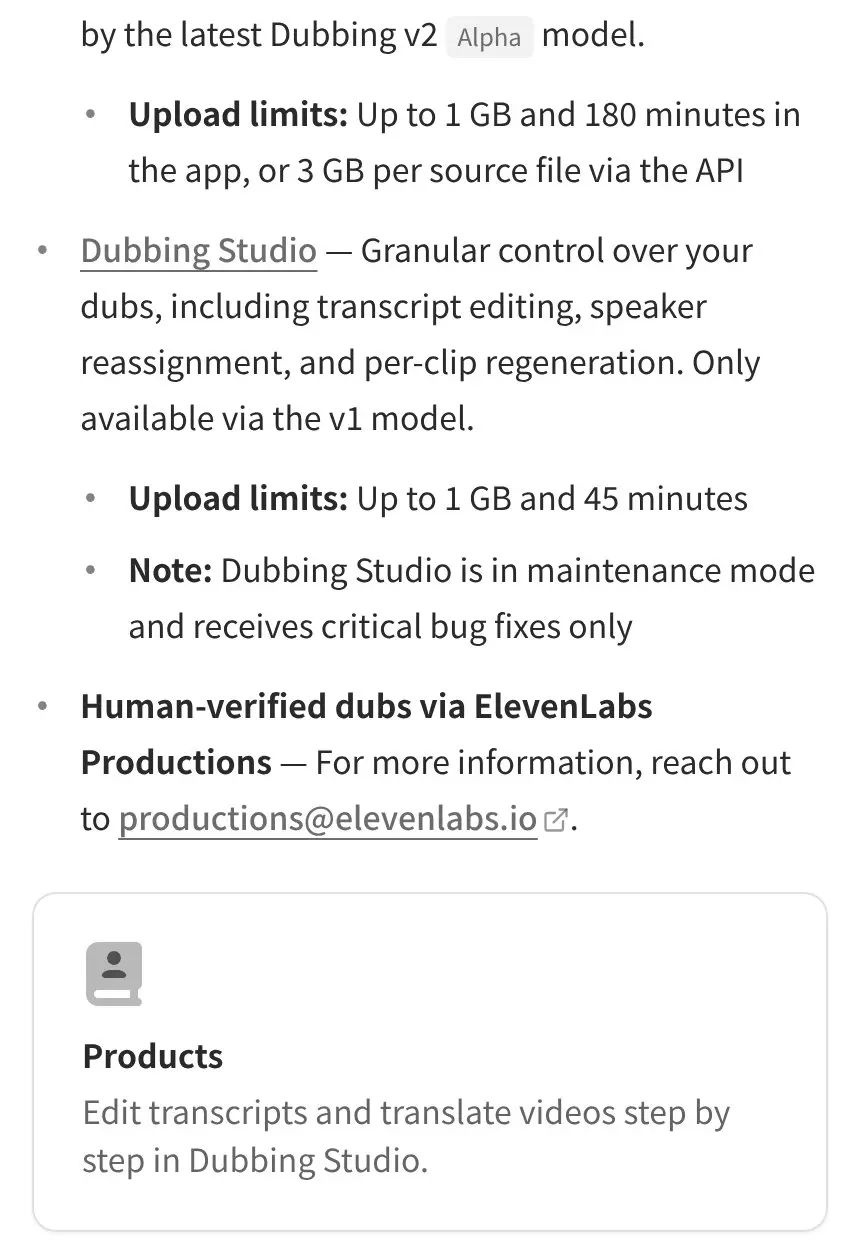
| Dubbing(吹き替え) | 音声・動画を90以上の言語に翻訳し、話者ごとの感情・タイミング・トーンと背景音を保ちます。自動吹き替えは1GB・180分まで(APIは1ファイル3GBまで)。Dubbing Studioは書き起こしの編集や話者の割り当て直し、クリップ単位の再生成ができ、上限は1GB・45分です。Studioは公式に「保守モード」(重大な不具合の修正のみ)とされています。1ファイル最大32人の話者、リアルタイムの吹き替えは非対応です。 |
| Speech to Text(Scribe) | Scribe v2は90以上の言語を文字起こしし、最大32人の話者分離、笑い声などの音の注記、単語ごとのタイムスタンプ、65種類の固有表現の検出に対応します。ファイルは3GB・10時間まで。Scribe v2 Realtimeは約150msの遅延でリアルタイムに文字起こしし、Scribe v2 Medicalは医療の音声向けに調整されたモデルです。 |
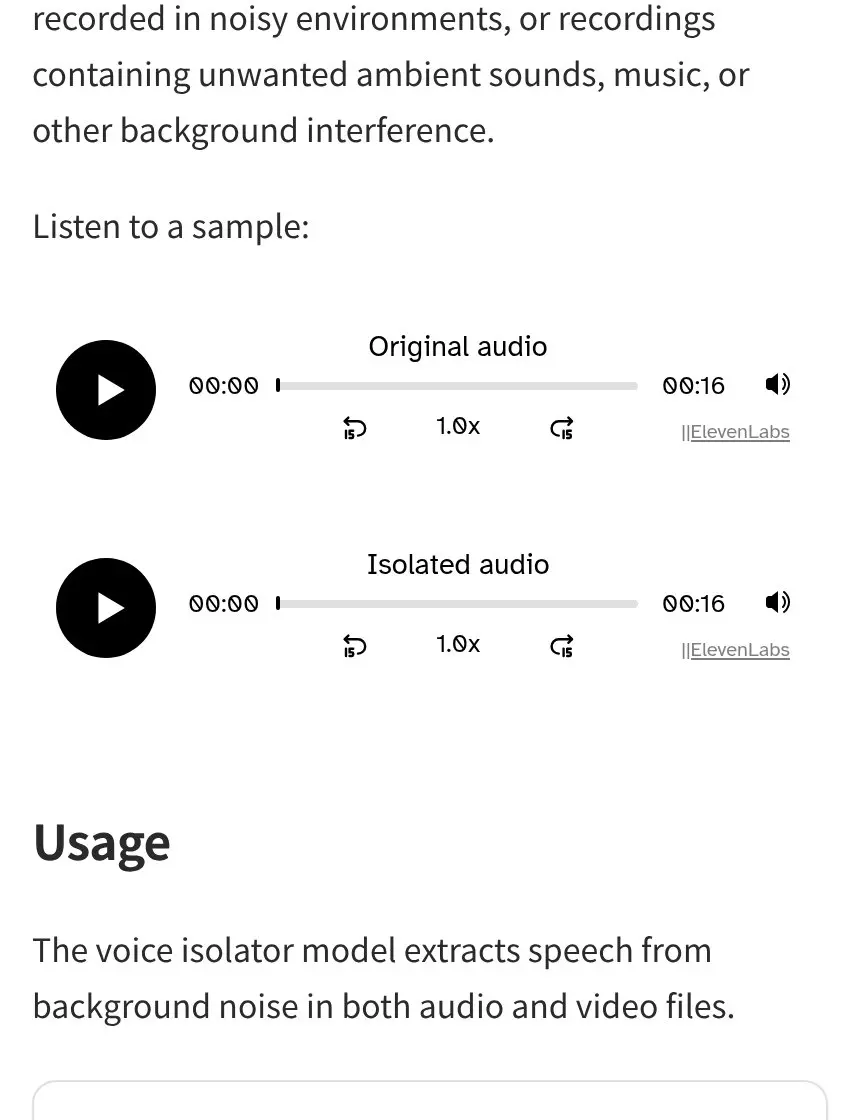
| Voice Isolator(ノイズ除去) | 雑音の多い録音から声だけを取り出します。音声・動画ファイルに使え、500MB・1時間まで、消費は1分あたり1,000クレジットです。公式は、音楽から歌声だけを取り出す用途には特化していないと書いています。 |
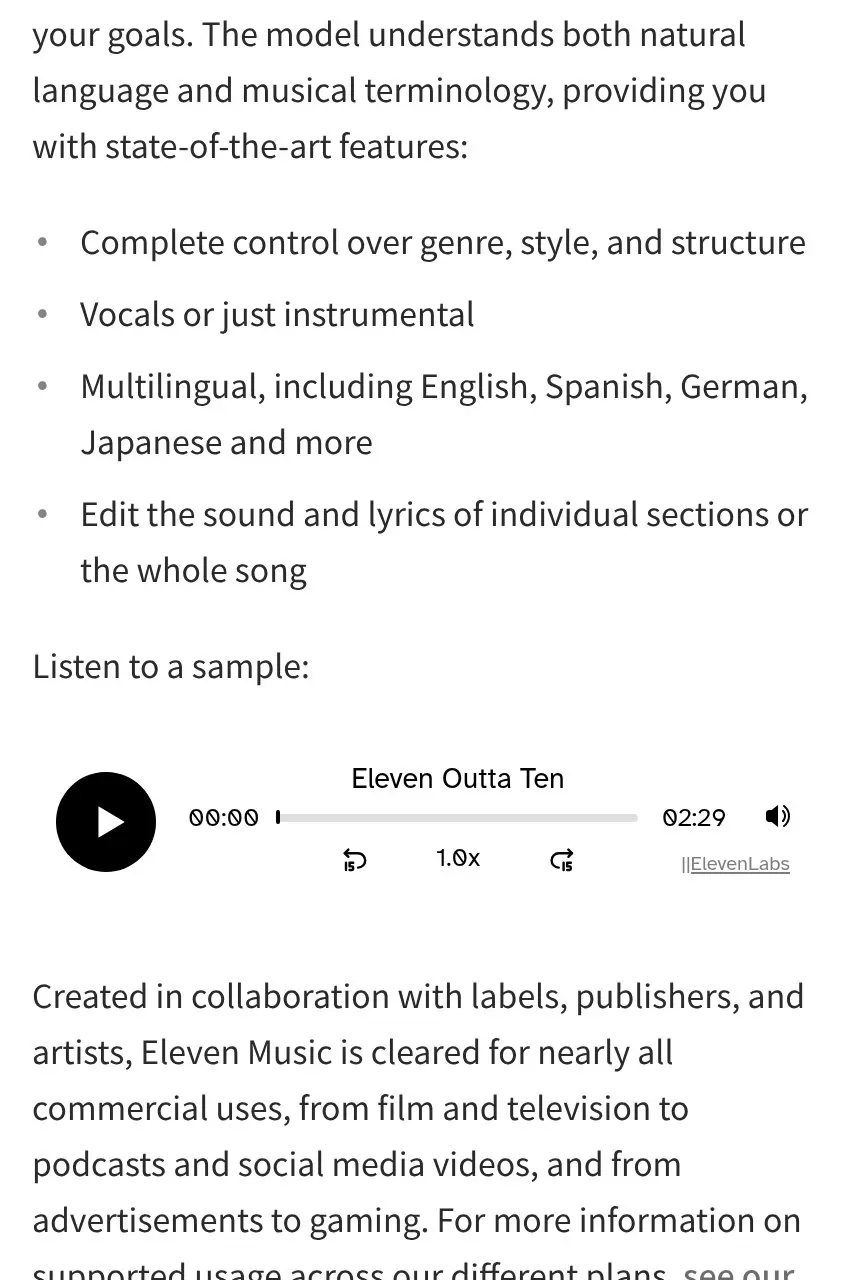
| Eleven Music | 文章の指示から音楽を作ります。日本語を含む複数の言語で、歌入りもインストも指定でき、長さは3秒〜5分、形式はMP3とWAVです。区間ごとの音や歌詞の編集もできます。商用利用は「ほぼすべての商用利用で権利処理済み」と公式が説明し、プランごとの条件は音楽の利用規約で確認する形です。Music APIは有料プランの利用者が対象です。 |
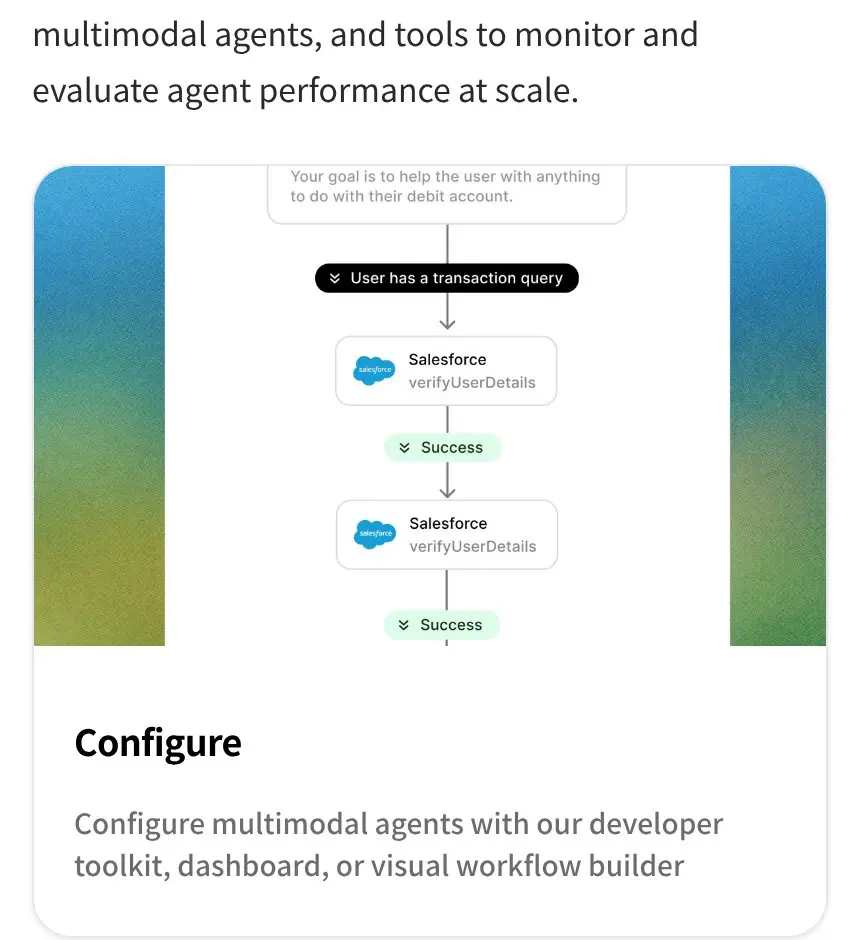
| ElevenAgents | 音声認識・言語モデル・音声合成・話すタイミングの判断を組み合わせた、会話型の音声エージェントを作る基盤です。ビジュアルのワークフロー作成、外部APIを呼ぶツール、資料をアップロードして答えの根拠にする知識ベース、Twilio連携とSIPによる電話、ウェブ埋め込み、iOS・Android向けSDKに対応します。 |
公式ドキュメントの実際の画面(スマホ幅)
表の内容は、公式ドキュメントの各ページに書かれています。スマホ幅で開いたときの画面を、必要な部分だけ切り出して載せます(ログインが要らない公開ページです)。
音声の安定性と類似性の設定
Text to Speechには、声の一貫性を調整する「Stability」と「Similarity」の設定があります。公式ドキュメントは、感情は主に文章そのものの手がかりから決まり、Stabilityの設定が決めるわけではないと説明しています。抑揚をつけたい場合は、設定をいじる前に台本の書き方(句読点や言い回し)を調整するのが近道です。
ElevenLabsのスマホアプリ(iOS・Android)と提供サービスの全体像
ElevenLabsはブラウザ版のほかに、iOS・Android向けの公式アプリもあります。アカウントはウェブ版と共通です。公式ヘルプセンター(2026年10月19日に確認)では、アプリで使える機能とウェブ版だけの機能が次のように分かれています。
| 区分 | 公式に記載されている機能 |
|---|---|
| アプリで使える | Text to Speech/Instant Voice Cloning/Voice Library/Voice Changer/Voice Isolator/Voice Design/Image & Video/再生 |
| ウェブ版のみ | Professional Voice Cloning/Studio/Dubbing/Eleven Music/Agents platform |
ナレーションの長い編集やダビングはパソコンのブラウザで、思いついた一文をすぐ読み上げさせたいときはアプリで、と使い分けられます。
公式ドキュメントの紹介ページでは、サービス全体が次の区分で整理されています。ブラウザで音声・音楽・吹き替えを作る「ElevenCreative」、会話型の音声エージェントを作る「ElevenAgents」、プログラムから使う「ElevenAPI」、中小企業向けのAI電話受付「Reception AI」、音声認識の「Scribe」(Scribe v2・Scribe v2 Realtime・医療向けのScribe v2 Medical)です。出典:elevenlabs.io/docs/overview/intro(2026年10月19日確認)。
ElevenLabsの主要モデル一覧
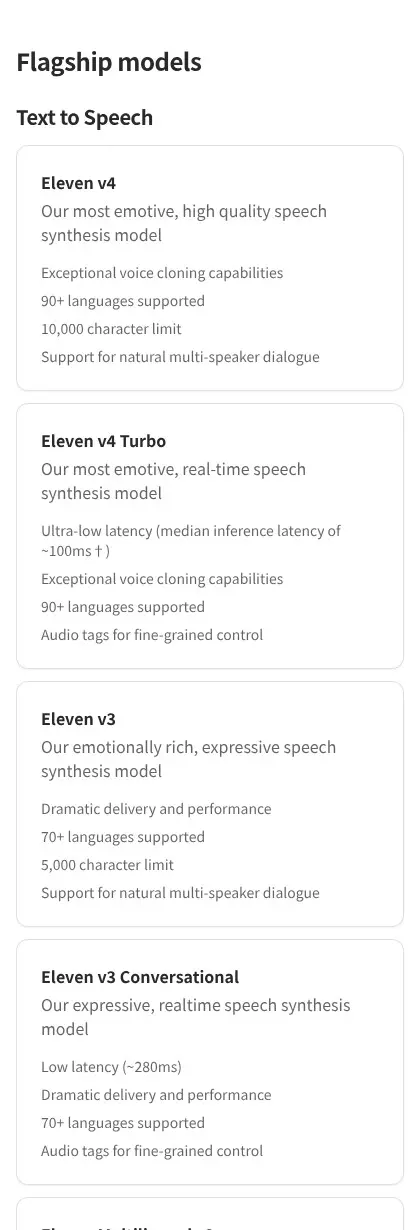
ElevenLabsは複数の音声生成モデルを提供しており、用途に応じて使い分けられます(出典:elevenlabs.io/docs/overview/models・2026年10月14日時点)。
| モデル名 | 特徴 | 主な用途 | 遅延 |
|---|---|---|---|
Eleven v4(eleven_v4) |
最新の表現力重視TTS。90+言語対応・1回10,000文字まで。ボイスクローンに強い | ナレーション・長尺の音声コンテンツ | 公式に記載なし |
Eleven v4 Turbo(eleven_v4_turbo) |
v4のリアルタイム版。90+言語対応。オーディオタグ対応 | 音声エージェント・対話アプリ | 中央値で約100ms |
Eleven v3(eleven_v3) |
v4の前の世代の表現力重視TTS。70+言語対応・1回5,000文字まで | 映画・高品質ナレーション・コンテンツ制作全般 | 公式に記載なし |
| Eleven Multilingual v2 | 長尺で最も安定するとされる定番モデル。29言語対応・1回10,000文字まで | 多言語ナレーション・コンテンツ制作 | 標準 |
| Eleven Flash v2.5 | リアルタイム向け超高速(約75ms)。32言語対応・1回40,000文字まで | リアルタイム会話・音声エージェント・大量生成 | 最低遅延 |
| Scribe v2 / v2 realtime | 音声認識(STT)。90+言語対応 | 文字起こし・リアルタイム音声認識 | — |
選び方の目安は次のとおりです。表現力を最優先するならEleven v4、長い文章を安定して読ませたいならMultilingual v2、リアルタイムの応答が必要ならEleven v4 TurboかFlash v2.5です。なお、公式ドキュメントではeleven_turbo_v2_5・eleven_turbo_v2・scribe_v1が「deprecated(非推奨)」と記載されているため、新規利用は避けてください(Turbo v2.5の後継はFlash v2.5、Scribe v1の後継はScribe v2)。
料金プランの詳細
ElevenLabsは月額課金のサブスクリプションモデルを採用しており、生成できる音声の文字数(クレジット)によってプランが分かれています。2026年10月14日時点の主要プランは以下のとおりです(詳細・変動は公式pricingページ参照)。
| プラン名 | 月額費用(USD) | 主な特典 |
|---|---|---|
| Free | $0 | 月1万クレジット(公式の目安で約10分)。Text to Speech・Speech to Text・Sound Effects・Voice Designなどを試せる。商用ライセンスは含まれない |
| Starter | $6(約900円) 公式表示:2026年10月18日まで初月$1 |
月3万クレジット(約30分)・商用ライセンス・Instant Voice Cloning・Dubbing Studio |
| Creator | $22(約3,300円) 公式表示:初月$11 |
月12.1万クレジット(約121分)・Professional Voice Cloning・追加クレジットの購入 |
| Pro | $99(約15,000円) | 月60万クレジット・APIで44.1kHz PCM出力・192kbpsの音質 |
| Scale | $299(約45,000円) | 月180万クレジット・3席・プロフェッショナルボイスクローン3つ |
| Business | $990(約149,000円) | 月600万クレジット・10席・プロフェッショナルボイスクローン10つ・低遅延TTSは1分5セント〜 |
| Enterprise | 要問い合わせ | DPA・SLAなどの個別条件・カスタムSSO・HIPAA向けBAA・優先サポート(公式の記載) |
日本語でのナレーション制作を個人で試すならFreeプランから始めるのが現実的です。ただしFreeプランで生成した音声の商用利用には制限があるため、ビジネス用途にはStarterプラン以上が必要です。大量のコンテンツを自動生成するシステムに組み込む場合はAPI利用料金(文字数ベースの従量課金)も加算されるため、実際の費用は公式pricingページで最新の条件を確認の上、試算することをお勧めします。円換算は「約」であり、為替・キャンペーンにより変動します(詳しくは料金プランの解説)。
クレジットの仕組み(公式の料金ページより)
ElevenLabsの料金は、全機能で共通のクレジットを使います。Text to Speechは1文字あたり約1クレジット(Multilingual v2の場合。Flash/Turbo系のAPI利用は0.5〜1クレジット)、Speech to Textは1分あたり330クレジット、Eleven Musicは1分あたり900クレジット、Sound Effectsは1回あたり200クレジット、Voice ChangerとVoice Isolatorは1分あたり1,000クレジットです。
毎月の枠は契約日から1か月ごとに更新され、有料プランでは使い切れなかった分を最大2か月分まで繰り越せます(無料プランは繰り越しなし)。年払いは「月額×10か月分」で、2か月分お得になります。
無料プランで作った音声を公開する場合は、公式ヘルプセンターで「タイトルに elevenlabs.io または 11.ai を入れて出典を示す」ことが条件とされています。商用目的では使えません。ビジネスや収益化には、Starter以上の商用ライセンスが必要です。
ElevenLabsの活用シーン
動画・ポッドキャスト・オーディオブックのナレーション
最も一般的な用途です。YouTube動画のナレーション、ポッドキャストの補助音声、オーディオブックの制作において、プロのナレーターに依頼するコストと時間を大幅に削減できます。ElevenLabsの音声は感情表現が豊かなため、長尺コンテンツでも聴衆が違和感を覚えにくいという特徴があります。
ゲーム・インタラクティブコンテンツのキャラクターボイス
インディゲームからAAA規模まで、NPCボイスや物語ナレーションへの活用が急増しています。Voice Lab機能でキャラクターごとに個性ある声を設計し、生成した音声をゲームエンジンに実装するワークフローが普及しています。
eラーニング・教育コンテンツ
講義動画・語学学習教材・マニュアル動画のナレーションを低コストで量産できます。多言語ダビング機能と組み合わせることで、日本語で制作したコンテンツを短期間で複数言語展開することも可能です。
カスタマーサービス・音声IVR
電話自動応答システムや案内音声に、従来の棒読みTTSではなく自然な音声を導入するケースが増えています。Eleven Agents機能を使えば、リアルタイムで会話できる音声ボットの構築も可能です。
バーチャルヒューマン・アバター連携
アバターや2D/3Dキャラクターに音声を付与するバーチャルヒューマン領域での活用も広がっています。バーチャルヒューマンへの音声合成統合において高品質TTS技術の選定は重要な検討要素であり、Eleven v3のような表現力豊かなエンジンはキャラクターの「リアル感」を高める上で大きな貢献を果たします。
競合サービスとの比較
ElevenLabsは多数のAI音声合成サービスの中でどのような位置づけにあるのでしょうか。主要な競合と比較します。
| サービス | 音声品質 | 日本語対応 | 音声クローン | API | 料金感 | 特徴 |
|---|---|---|---|---|---|---|
| ElevenLabs | ◎ 表現力重視 | ○ | ◎ Instant/Pro | ○ | 中〜高 | 感情表現・クローン精度が突出 |
| OpenAI TTS | ○ 高品質 | ○ | △ 限定的 | ○ | 低〜中 | GPTと統合しやすい・低コスト |
| Google Cloud TTS | ○ | ◎ 自然 | △ | ◎ | 低 | スケーラビリティ・安定性が強み |
| Microsoft Azure TTS | ○ | ◎ | ○ | ◎ | 低〜中 | エンタープライズ向け・SSML対応 |
| Play.ht | ○ | ○ | ○ | ○ | 中 | 多様な音声ライブラリ |
| VOICEVOX(日本製) | ○ 日本語特化 | ◎ | × | ○ | 無料 | 日本語特化・無料・ローカル実行可 |
ElevenLabsが競合に比べて優位なのは感情表現の豊かさ・音声クローンの精度・多言語対応の質の三点です。一方で日本語特化の場合はVOICEVOXやAzure TTSの方がより自然な場合もあります。また大量生成・コスト最適化が優先のシステム用途ではGoogle CloudやAzureの安定性と低単価が魅力です。
実運用では「最高品質が必要な表向きコンテンツにElevenLabs、大量バッチ処理にGoogleやAzure」というように使い分けるアプローチが合理的です。
音声合成の業務導入や自社サービスへの組み込みをご検討の方は、日本語特化AI音声合成「SakuraSpeech」を開発するクリスタルメソッドの無料相談をご利用ください。
ElevenLabsを使い始める手順
アカウント登録
elevenlabs.ioにアクセスし、メールアドレスまたはGoogleアカウントで無料登録
音声を選択
用途別(ナレーション・キャラクター・会話など)に並ぶ音声から選ぶ。日本語の音声も選べる
テキストを入力
Text to Speech画面の入力欄にテキストを貼り付け、モデルを選ぶ(任意でStability・Similarity・Speedを調整)
生成・確認
「Generate」を押して音声生成。履歴からMP3(128kbps)またはWAVでダウンロード
API連携(任意)
API Keyを発行してPython/Node.jsなど好みの言語で自動化・システム統合
手順ごとの実際の画面(公式ページ)
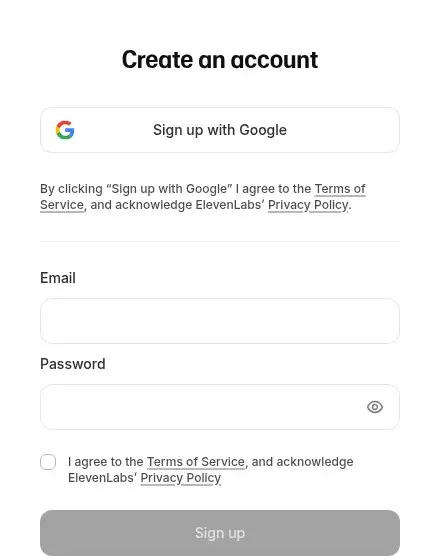
①アカウント登録。公式のアカウント作成画面です。Googleアカウントで登録するか、メールアドレスとパスワードを入れて利用規約に同意し、「Sign up」を押します。
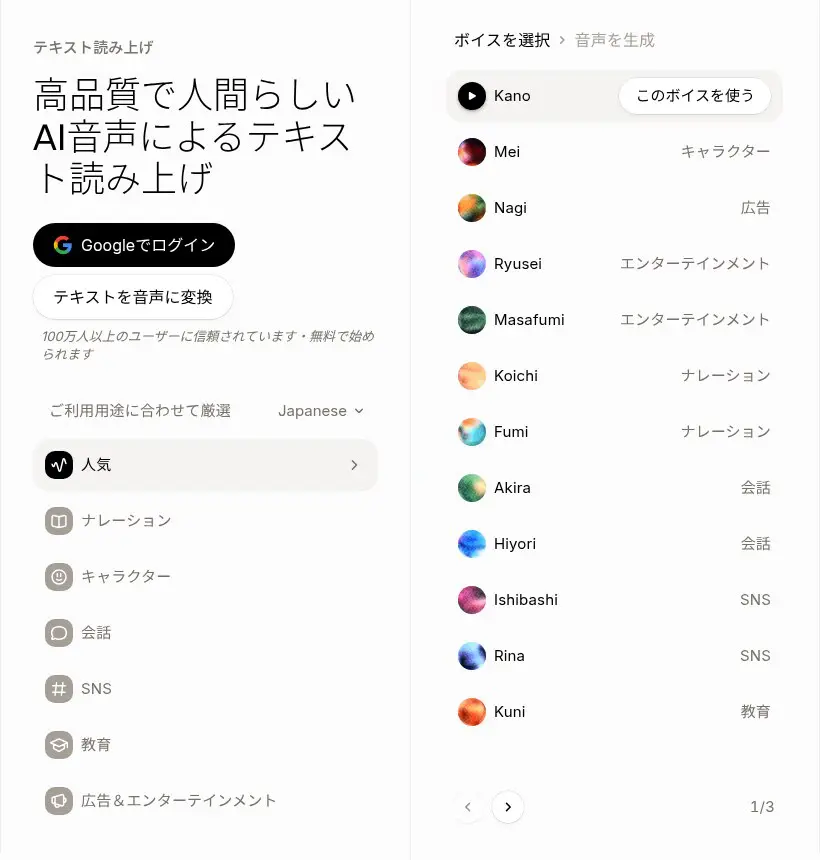
②音声を選ぶ。公式サイトの日本語版では、用途別に日本語の音声が並びます(17,000以上の音声から探せると表示されています)。気になる音声の再生ボタンで試し聴きし、「このボイスを使う」で選びます。
③〜④テキストを入れて生成。登録後のText to Speech画面で、テキストを入力し、モデルを選んで「Generate」を押します(公式ドキュメントの手順)。StabilityとSimilarityは任意の調整です。Stabilityを下げると感情の幅が広がり、上げると安定して落ち着いた読みになります。生成後は履歴からMP3(128kbps)かWAVを保存できます(Advancedを開くと192kbps・256kbpsのMP3、M4A、FLACも選べます)。登録後の画面は、公式ドキュメントのText to Speechの使い方で確認できます。
無料プランでまず試せるため、まず体験してみることをお勧めします。日本語のテキストを入力する場合、公式のモデル一覧ではEleven v4・v3・Multilingual v2・Flash v2.5がいずれも日本語に対応しています。
生成設定の調整(Stability・Similarity・Speedなど公式の目安)
Text to Speechの仕上がりは、公式ドキュメント(elevenlabs.io/docs/creative-platform/playground/text-to-speech・2026年10月20日に確認)によると「ボイスの選択が最も重要で、次にモデル、その次に設定」の順に効きます。設定のスライダーは出力を決め打ちにするものではなく、生成ごとのばらつきの幅を決めるものです。公式が最も一般的としている値は、Stabilityが50前後、Similarityが75前後、Styleは0のままで、そこからの変更は最小限にする使い方です。
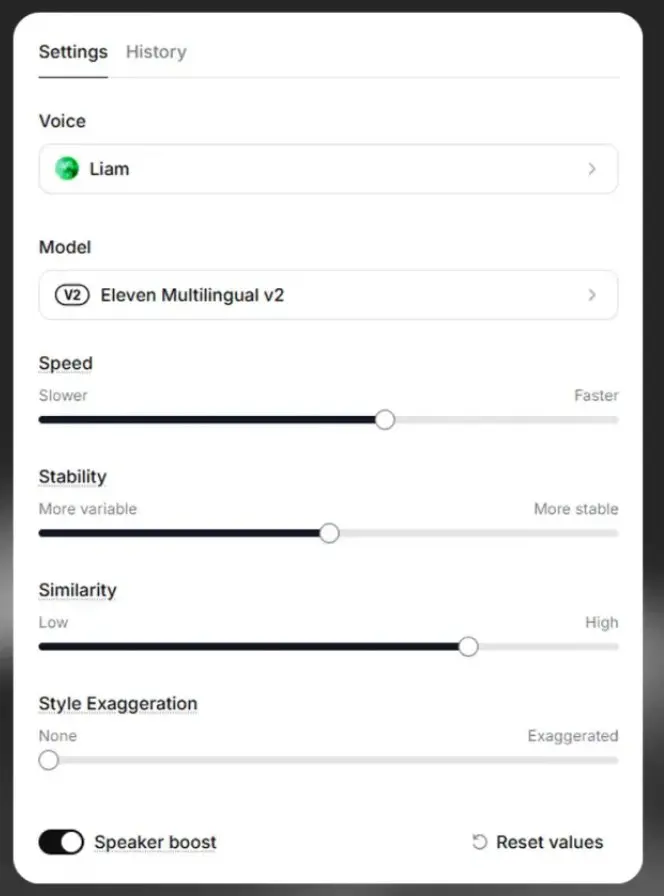
| 設定 | 公式に記載されている内容 |
|---|---|
| Speed | 既定値は1.0(調整なし)。1.0より小さいと遅く(下限0.7)、大きいと速く(上限1.2)なります。極端な値は音質に影響することがあります。Eleven v3では使えません。 |
| Stability(安定性) | 生成ごとのばらつきの大きさを決めます。下げると感情の幅が広がりますが、下げすぎると不自然にばらつき、話すのが速くなりすぎることがあります。上げすぎると抑揚の少ない単調な声になります。公式は、生き生きした演技にしたいときは低めにして数回生成して選び、落ち着いた読み上げにしたいときは高めにする、と案内しています。 |
| Similarity(類似性) | 元のボイスにどれだけ近づけるかを決めます。元の録音の質が悪いときに高くしすぎると、元音声のノイズや雑音まで再現することがあります。Eleven v3では使えません。 |
| Style exaggeration | 元の話者の話し方の特徴を強調します。0以外にすると計算量が増えて遅延が増え、出力がやや不安定になるため、公式は常に0を推奨しています。 |
| Speaker Boost | 元の話者への類似度を上げます。計算量が増えて遅延が増え、違いは比較的わずかとされています。Eleven v3では使えません。 |
同じ設定でも結果は毎回少し変わります。公式のFAQでは、一貫性が必要なときは任意のseedパラメータを使う方法が案内されています(それでも細かな差は出ます)。また、同じ内容・同じ設定での再生成は1つの生成につき2回まで無料で、テキストや設定を変えると新しい生成として扱われます。
オーディオタグと複数話者の会話(Eleven v4・v3)
Eleven v4と v3では、テキストの中にカッコ付きの指示(オーディオタグ)を入れて、読み方や効果音を操作できます。公式ブログ(Eleven v4の紹介)には、[laughs](笑う)、[light rain](小雨の音)、[phone buzzing](スマホの振動音)などの例が載っています。タグの書き方は公式ドキュメントに一覧があります。タグの代わりに、読み方を自然な言葉で説明する方法も使えます。
公式のモデル一覧では、v4とv3は「自然な複数話者の会話(multi-speaker dialogue)」に対応しています。2人以上の掛け合いを1本の音声として作りたい場合は、Text to Dialogue機能が使えます。Eleven v4のTurbo版もオーディオタグに対応しています。
日本語で使うときは、まず短い台本で試して、読み間違いがないかを聴いて確かめるのが確実です。読み間違いはひらがなで書き直すと直ることがあります(後述の「日本語対応の実際」を参照)。
倫理的配慮・利用規約上の注意点
ElevenLabsの音声クローン機能は強力であるがゆえに、倫理・法務面での理解が不可欠です。
同意なき他者の声のクローンは禁止
ElevenLabsの利用規約では、本人の明示的な同意なく他者の声をクローンすることを明確に禁止しています。Voice Cloningを利用する際は、自分自身の声か、書面で同意を得た声のみを使用してください。芸能人・著名人の声を無断でクローンした事例が社会問題化した背景もあり、プラットフォーム側も不正利用への監視を強化しています。
フェイク音声・ディープフェイクへの悪用禁止
詐欺・なりすまし・虚偽情報の拡散を目的とした音声生成は利用規約違反であり、アカウント停止や法的責任の対象となります。特にボイスフィッシング(音声を使った詐欺)への悪用は各国で法的規制が強まっています。
商用利用時のプラン確認
Freeプランで生成した音声をYouTube収益化動画・広告・販売コンテンツに使用することは規約上認められていません。商用利用にはStarter以上のプランへのアップグレードが必要です。
生成AIコンテンツの開示
プラットフォームや国によっては、AI生成音声を使ったコンテンツにその旨を明示する義務が生じつつあります。欧州AI規制法(EU AI Act)などの動向を踏まえ、透明性の確保は今後ますます重要になります。

ElevenLabsのAPI活用と開発者向け機能
ElevenLabsはWebインターフェースだけでなく、RESTful APIとSDKを通じてプログラムから呼び出せる仕組みを提供しています。公式SDKはPython・TypeScript(JavaScript)向けが提供されており、シンプルなコードで音声生成を組み込めます。
APIで利用できる主な機能は以下のとおりです。
- テキスト読み上げ(TTS):テキストと音声IDを指定してMP3/PCMなどの形式でストリーミングまたはバッファ取得
- Voice Cloning API:音声ファイルをアップロードしてカスタム音声モデルを作成
- Speech-to-Speech:既存の音声ファイルを別の声に変換
- Websocketストリーミング:リアルタイム音声生成・低遅延でのEleven Agents構築
- 音声一覧取得・管理:登録済み音声の取得・削除・メタデータ管理
音声合成機能をサービスに組み込む際に重要なのが、レイテンシとストリーミング対応の設計です。ElevenLabsのFlash v2.5モデルはストリーミング配信に対応しており(遅延約75ms)、テキストが生成されながらリアルタイムで音声再生が始まるため、会話AIや読み上げアシスタントに組み込む際のユーザー体験が大きく向上します。
ElevenLabsの日本語対応の実際
日本語については、Eleven Multilingual v2以降のモデルおよびEleven v3で正式対応しています。発音・イントネーション・長音・促音(っ)の処理など、日本語特有の課題にある程度対応できており、ビジネスナレーションや教育コンテンツ用途では実用レベルに達しています。
ただし以下の点は現状の制約として把握しておく必要があります。
- 固有名詞(人名・地名・製品名)の読みが不自然になることがある
- 漢字の読み誤りが発生する場合があり、ひらがなや読みがなで補正が有効
- 英語混じりの文章で英単語の発音がカタカナ的になることがある
- VOICEVOX等の日本語特化モデルと比較すると、日本語の自然さで劣ることもある
実務では、日本語テキストを入力する前に重要な固有名詞をひらがなや読み仮名で置き換えるか、SSML(Speech Synthesis Markup Language)的な工夫をするプリプロセスを挟むことで品質が安定します。
ElevenLabsの日本での展開
ElevenLabsは2025年4月14日、日本法人「イレブンラボジャパン合同会社(ElevenLabs Japan G.K.)」の設立を公式ブログで発表しました。所在地は東京都千代田区丸の内、日本・韓国のゼネラルマネージャーは田村元氏と記載されています。目的は、日本市場向けのサポートと、日本語の言語・文化に合わせたローカライズです。
同じ発表では、パートナーとしてDOCOMO Innovations(NTTドコモの米国R&D子会社)、TBS、韓国のMBC C&I、LLSOLLUの名前が挙がっています(出典:ElevenLabs公式ブログ)。公式サイトにも日本語版(elevenlabs.io/ja)があり、日本語の音声を選んで試せます。
2025年以降のElevenLabsの動向
ElevenLabsは急速に機能を拡張しており、2025年前後から以下の進化が確認されています。
| 機能・動向 | 概要 |
|---|---|
| Eleven v3リリース | 演技的な感情表現・ウィスパー・笑いなど多様な表現が可能になったモデル。70+言語対応(現在はv4の前の世代) |
| Eleven v4 / v4 Turboリリース(2026年9月28日) | 90+言語対応。[laughs]のようなインラインのオーディオタグで読み方や効果音を指示できる。Instant Voice Cloneは10秒の音声から作成(公式ブログ) |
| Eleven Agents強化 | 独自のエージェントフレームワーク提供でLLM統合が容易に。リアルタイム会話AIを低遅延で構築可能 |
| Eleven Music・Sound Effects生成 | テキストで音楽・効果音を生成する機能を追加 |
| Projects機能 | 長尺コンテンツ(オーディオブック等)を章立て管理・一括生成する機能 |
| Scribe v2リリース | 90+言語対応の高精度音声認識(STT)。リアルタイム版も提供 |
| 声帯同意フローの整備 | 声のオーナーが同意した音声のみ他ユーザーが商用利用できる仕組みの整備 |
特にEleven v3モデルの登場によって、感情表現の次元が大きく引き上げられています。従来モデルでは難しかった「笑いながら話す」「息を呑む演技」「感極まった声」といった表現が可能になり、映画・ドラマ・インタラクティブフィクションへの応用可能性が広がっています。
公式の音声サンプルと紹介動画を聴ける場所
音声サービスは、文章で読むより聴いたほうが早く分かります。次の公式ページでは、ログインなしで音声の試し聴きや紹介を見られます。音声ファイルは公式のものなので、当サイトでは転載せず、リンクで紹介します。
- 公式サイト日本語版のテキスト読み上げ:用途別の日本語の音声を、再生ボタンで試し聴きできます。
- Eleven v4の公式ブログ:表現タグの例や、実際の声とv4の音声の聴き比べのプレーヤーが載っています。
- ElevenAPIのクイックスタート:「Get started with ElevenLabs Text to Speech」という公式の紹介動画があります(英語)。
聴き比べるときは、自分が使う予定の文章(人名・社名・数字を含む一文)で試してください。
まとめ
ElevenLabsは、テキストから人間に近い自然な音声を生成する技術において、広く使われているAI音声プラットフォームのひとつです。無料プランで手軽に試せる間口の広さと、エンタープライズ向けAPIまで対応する拡張性を兼ね備えており、個人クリエイターから大企業まで幅広い用途に対応しています。
主要なポイントをまとめると以下のとおりです。
- テキスト読み上げ・音声クローン・ダビング・音声エージェント・音楽/効果音生成など多彩な機能を統合的に提供
- 最新のTTSモデルEleven v4は90+言語(日本語含む)、STTのScribe v2も90+言語に対応(2026年10月14日時点)
- 無料プランあり、商用利用はStarterプラン($6/月〜、約900円〜・2026年10月14日時点)から可能
- APIとSDKで開発者によるシステム統合が容易
- 音声クローンには本人同意が必須であり、フェイク音声への悪用は規約・法律の両面で厳禁
- 2026年9月にEleven v4が公開されるなど、モデルの更新が速い(最新の仕様は公式ドキュメントで確認)
AI音声技術の民主化を進めるElevenLabsの登場によって、これまでプロのナレーターや音響スタジオが必要だった音声制作が、誰でも低コスト・短時間で実現できる時代になりました。ElevenLabsを正しく理解し、倫理的配慮を持って活用することで、コンテンツ・プロダクト・コミュニケーションの可能性を大きく広げることができます。
ElevenLabsに関するよくある質問
- Q1. 無料で使えますか?
- 使えます。無料プランは月1万クレジット(公式の目安で約10分)で、商用ライセンスは含まれません。詳しくは無料プランの解説と料金プランの解説をご覧ください。
- Q2. 日本語に対応していますか?
- 対応しています。公式のモデル一覧では、Eleven v4・v3・Multilingual v2・Flash v2.5のいずれも日本語に対応と記載されており、ビジネスナレーション用途では実用レベルです。固有名詞の読みなど注意点は本文「日本語対応の実際」で解説しています。
- Q3. 商用利用はできますか?
- 公式の料金ページでは、商用ライセンスはStarter(月6ドル)以上のプランに含まれ、Freeには含まれません。細かい条件は公式規約で確認が必要です。本文「倫理的配慮・利用規約上の注意点」と公式規約を確認してください。
- Q4. 自分の声をクローンできますか?
- できます(Voice Cloning機能)。ただし利用規約で本人の明示的な同意のない他者の声のクローンは禁止されています。自分の声か、書面で同意を得た声のみ使用してください。
- Q5. どうやって始めればいいですか?
- elevenlabs.ioでメールアドレスまたはGoogleアカウントで登録すれば、ブラウザだけで使い始められます。手順は本文「使い始める手順」をご覧ください。
- Q6. 最新のモデルは何ですか?
- 2026年9月28日に公開されたEleven v4です。リアルタイム向けにEleven v4 Turboもあります。一覧は本文「主要モデル一覧」をご覧ください。
- Q7. ボイスクローンはどのプランで使えますか?
- 公式の料金ページと公式ドキュメントでは、Instant Voice CloningはStarter以上、Professional Voice CloningはCreator以上と記載されています。
参考文献
関連記事
AIの業務活用をご検討の方へ
クリスタルメソッドは、バーチャルヒューマンをはじめAIの開発・業務導入を支援しています。生成AI・AIエージェントの活用や、自社業務へのAI導入をご検討の際は、お気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
ElevenLabsの料金プラン一覧|クレジット消費とプラン選び【2026年版】
無料で使う方法 → こちらの記事で解説しています。 ElevenLabsの料金プラン一覧(2025年最新) ElevenLabsの料金体系は月額サブスクリプショ...
-
ElevenLabsの無料プランでできること・できないことを徹底解説
「無料プランで足りるか」を業務要件から逆算する判断早見 ここまでで無料プランの機能・制限は把握できたはずです。最後に、機能一覧ではなくあなたの業務要件から逆算し...
-
ElevenLabsを他社と徹底比較|音質・機能・料金・日本語対応まで網羅
見落とされがちな選定軸:「音声データをクラウドに送っていいか」で最終的に絞り込む 音質・日本語・料金・料金でほぼ横並びになったとき、業務での最終判断を分けるのは...