
blog
AIブログ
stable diffusion とは?仕組み・使い方・商用利用を解説【入門ガイド】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
結局、Stable Diffusionはあなたに向くのか——導入前の判断早見
Stable Diffusionは「無料で高性能」と語られがちですが、実際の向き不向きは使えるGPU・カスタマイズの必要度・商用時の権利リスク許容度・運用を回せる体制で決まります。仕組みや使い方の詳細は本文の各章に譲り、ここでは検討者が「自分は選ぶべきか」を即断するための判断材料だけをまとめます。
向いているケース(3つ)
- 独自スタイルや特定キャラを再現したい:LoRAや追加学習でモデルを自分好みに寄せられる。既製サービスでは出せない絵柄を狙う人に最適。
- 大量生成・自動化を業務に組み込みたい:ローカル/API運用で枚数課金に縛られず、生成をパイプラインに組み込める。
- データを外に出したくない:ローカル完結でプロンプトや生成物を社外送信せずに扱える(機密案件・社内利用向き)。
向いていないケース(3つ)
- とにかく今すぐ数枚ほしいだけ:環境構築の手間に見合わない。ブラウザ完結の生成サービスの方が速い。
- GPU搭載マシンを用意できない:快適なローカル生成には相応のGPU(VRAM)が要る。非力な環境ではクラウド課金前提になり「無料」の利点が薄れる。
- 権利面のリスクを一切取りたくない:学習データ由来の懸念を避けたい商用案件では、権利をクリアにした別サービスの方が説明責任を果たしやすい。
用途別の判断早見
| あなたの目的 | Stable Diffusionの適性 | 判断のポイント |
|---|---|---|
| 特定の絵柄・キャラを量産 | ◎ 最有力 | LoRA/追加学習が効く。ここが最大の強み |
| 社内システムへ画像生成を組み込む | ◎ 有力 | ローカル/APIで自動化・原価管理しやすい |
| 機密・非公開データを扱う | ◎ 有力 | 外部送信なしのローカル運用が可能 |
| 広告・納品物で権利を明確にしたい | △ 要確認 | ライセンスと学習データの扱いを自分で精査する前提 |
| 初心者が手軽に試したい | △ 条件付き | まずWeb版で体験→本格運用でローカル検討 |
| 指示文(プロンプト)の言語理解の高さ重視 | ○ 場合による | 複雑な文章指示は対話型サービスが得意なことも |
他の主要サービスとの1行使い分け
- Midjourney:構築不要で”整った高品質絵”を最短で得たいとき。反面カスタマイズや自動化は不得手。
- DALL·E 3(現在はChatGPTの画像生成):長い文章指示をそのまま絵にしたい/ChatGPT上で完結させたいとき。OpenAIの公式モデルページでは、DALL·E 3はAPIから削除済みで、後継にGPT-Image-2.5 Sunburstが案内されています(2026年10月14日確認)。
- Adobe Firefly:商用の権利面をなるべくクリアにして納品したいとき。既存デザインワークフローとの接続も容易。
- にじジャーニー等のアニメ特化サービス:学習や構築をせず、アニメ調を手軽に出したいとき。
- Stable Diffusion:上記が一長一短でも、自分でモデルを作り込む・ローカルで回す・大量自動化するならこれ。「作り込みと運用の自由度」で選ぶ。
選ぶ前に自分で確認したい4つの軸
- GPU(VRAM)は足りるか:ローカル快適運用の前提。無ければクラウド費用込みで再計算する。
- どこまで作り込むか:既製の絵柄で足りるならSDの強みは活きない。LoRA/ControlNet活用が視野にあるかで価値が変わる。
- 商用時の権利をどう担保するか:使うモデルのライセンスと学習データの扱いを、公開・納品前に必ず自分で確認する。
- 運用を継続できる体制か:モデル更新・環境保守・プロンプト管理を回せるか。単発ならサービス利用の方が総コストが低いことも多い。
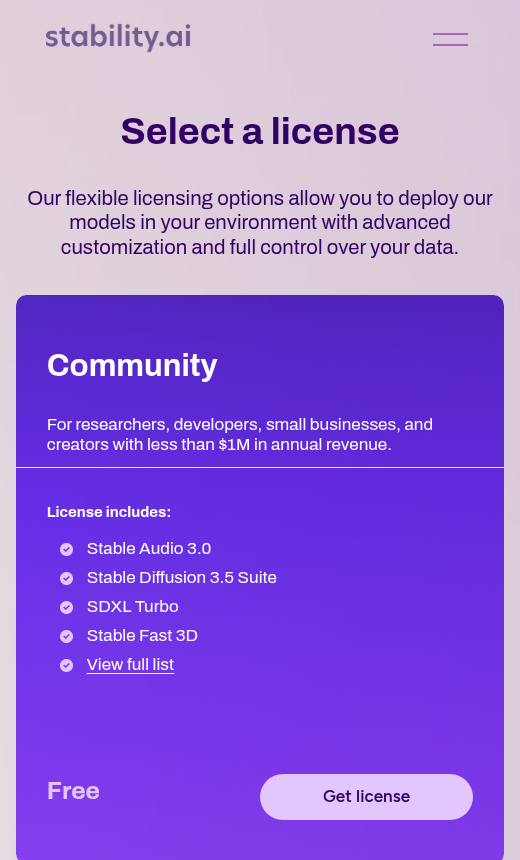
商用で使えるかは、Stability AI公式のライセンス選択ページで確認できます(2026年10月14日に撮影)。Communityライセンスは年間収益100万ドル未満の研究者・開発者・小規模事業者向けで無料、Enterpriseは年間収益100万ドルを超える事業者向けと説明されています。
迷ったら——「作り込みと自動化に投資する価値があるか」がYesならStable Diffusion、Noなら既製サービス、が最初の分岐点です。
関連記事Stable Diffusionのインストール方法は? / Stable Diffusionを無料で使う方法は? / Stable Diffusionの無料・有料プランの違いは?
Stable Diffusionとは?仕組みから使い方・活用事例まで徹底解説
Stable Diffusion(ステーブル・ディフュージョン)は、テキストや画像を入力するだけで高品質な画像を自動生成できる、オープンソースのAI画像生成モデルです。2022年8月の公開以降、世界中のクリエイター・エンジニア・企業に急速に普及し、画像生成AIのデファクトスタンダードとして定着しています。「どんな仕組みで動いているのか」「無料で使えるのか」「商用利用はできるのか」といった疑問を持つ方に向けて、本記事では基礎知識から実践的な使い方、最新モデルの動向まで、必要な情報をすべてこの一記事で解説します。
2026年の導入・インストール手順は正本で解説しています。本記事はStable Diffusionの仕組みと基礎(とは)に特化します。
Stable Diffusion(ステイブルディフュージョン)とは?一言でいうと何ができるAI?
Stable Diffusionとは、書いた文章(プロンプト)からイラストや写真のような画像を自動で作れる画像生成AIです。2022年にStability AI社が公開し、誰でも無料で使えるオープンソースとして広まりました。
- 文章を入れるだけ:「夕暮れの海辺を歩く猫」のように作りたい絵を言葉で指示すると、AIがその画像を描き出します。専門的な絵の技術は不要です。
- 自分のPCでも動かせる:クラウド上でしか使えないサービスと違い、条件を満たしたパソコン(画像処理用のGPUを積んだPC)があれば手元で無料で動かせるのが大きな特徴です。
- 仕組みは「ノイズを消していく」:砂嵐のようなノイズだらけの状態から、指示に合わせて少しずつノイズを取り除き、絵を浮かび上がらせる「拡散モデル」という方式を使っています。
今から始めるなら:いきなり自分のPCに導入するのは準備が大変なため、まずはブラウザ上で試せるWebサービス版から触ってみて、本格的に使い込みたくなったらPCへの導入を検討する、という順番が挫折しにくい進め方です。
Stable Diffusionの基本定義と開発背景
Stable Diffusionは、ドイツのミュンヘン大学(LMU)を中心とした研究グループ「Runway ML」と「CompVis」が開発した潜在拡散モデル(Latent Diffusion Model:LDM)です。資金提供と商業展開はStability AIが担い、2022年8月に一般公開されました。最大の特徴はモデルの重みデータを完全公開(オープンソース)していること。同時期に公開されたDALL·E 2やMidjourneyがAPIや専用サービスとしてクローズドに提供されたのとは対照的に、誰でも無料でダウンロードし、自分のマシンで動かせる設計になっています。
開発の出発点となった論文「High-Resolution Image Synthesis with Latent Diffusion Models」(Robin Rombach et al., 2022)は、ピクセル空間ではなく低次元の潜在空間で拡散処理を行うことで、当時の画像生成AIが抱えていた「高解像度生成に膨大なGPUメモリが必要」という課題を突破しました。この設計思想が、コンシューマーGPU(例:NVIDIA RTX 3060以上)での動作を可能にし、個人開発者・クリエイターへの普及を加速させた最大の要因です。
なお、Stability AIは財務・経営の変化という困難な時期を経ましたが、近年は資金調達や大手企業との提携などを通じて事業を継続しており、モデル開発・エコシステムの維持も続いています。
Stable Diffusionの仕組み:拡散モデルとは何か
Stable Diffusionの動作原理を理解するには、まず「拡散モデル(Diffusion Model)」という概念を把握する必要があります。拡散モデルは「ノイズを段階的に取り除く逆拡散プロセス」によって画像を生成する深層学習モデルです。
拡散プロセスの2段階
ノイズを段階的に除去
潜在空間処理の役割
通常の拡散モデルはピクセル空間(例:512×512=262,144次元)で処理を行うため計算コストが膨大です。Stable DiffusionはVAE(Variational Autoencoder)を使って画像を64×64程度の潜在空間に圧縮し、その低次元空間で拡散処理を実施します。生成後、再びVAEのデコーダーで元の解像度に復元します。これにより、処理コストを約48分の1に削減しながら高解像度出力を実現しています。
テキスト条件付けの仕組み(CLIP)
「どんな画像を生成するか」を指定するテキスト(プロンプト)の処理には、OpenAIが開発したCLIPテキストエンコーダーが使われます。テキストをベクトルに変換し、そのベクトルをU-Netと呼ばれるノイズ除去ネットワークに「クロスアテンション」機構で注入することで、テキストの意味に沿った画像が徐々に形成されます。なお、SD 3.5などの新世代モデルではU-Netに代わってDiffusion Transformer(DiT)アーキテクチャが採用されており、テキスト理解力と構図精度がさらに向上しています。
主要コンポーネント一覧
| コンポーネント | 役割 | 詳細 |
|---|---|---|
| VAEエンコーダー | 画像→潜在空間圧縮 | 入力画像を低次元ベクトルに変換 |
| CLIPテキストエンコーダー | テキスト→条件ベクトル変換 | プロンプトの意味を数値化 |
| U-Net/Diffusion Transformer | ノイズ除去の中核処理 | クロスアテンションでテキスト条件を反映。SD 3.5はDiTを採用 |
| VAEデコーダー | 潜在空間→画像復元 | 潜在ベクトルをピクセル画像に戻す |
| スケジューラー | ノイズ除去ステップの管理 | DDPM/DDIM/DPM++など複数方式 |
Stable Diffusionの主要バージョンと進化
Stable Diffusionは公開以来、複数の世代にわたって進化を続けています。バージョンによって生成品質・必要スペック・ライセンスが異なるため、目的に合ったモデル選択が重要です。
| バージョン | 公開時期 | 主な特徴 | ベース解像度 |
|---|---|---|---|
| SD 1.4 / 1.5 | 2022年8〜10月 | 初期版。最も多くのLoRA/ファインチューニングモデルが存在。コミュニティ資産が豊富 | 512×512px |
| SD 2.0 / 2.1 | 2022年11月〜 | OpenCLIPに移行。768px対応。ただし既存LoRAとの互換性が低く、普及は限定的 | 768×768px |
| SDXL 1.0 | 2023年7月 | 二段階生成(Base+Refiner)で1024px対応。細部品質が大幅向上。現在も多くの現場でワークホースとして利用される | 1024×1024px |
| SDXL Turbo | 2023年11月 | 蒸留技術でステップ数を1〜4に削減。リアルタイムに近い生成速度を実現 | 512×512px |
| SD 3.5 Large / Large Turbo / Medium | 2024年10月〜 | Stability AIの現行主力オープンモデル。Diffusion Transformerアーキテクチャを採用し、テキスト理解力・構図精度・文字描画が大幅向上。コンシューマ向けハードウェアで動作し、ComfyUI・LoRA・ControlNetのエコシステムに対応。Largeは最高品質、Large Turboは高速化版、Mediumは軽量版の三系統を提供 | 1024px以上 |
| Flux.1(Black Forest Labs) | 2024年8月 | SD開発者らが新設した会社によるモデル。Rectified Flowベースで高品質。SD系エコシステムと互換 | 可変 |
2026年時点では、Stability AIが提供するSD 3.5(Large / Large Turbo / Medium)が同社の主力オープンモデルとして位置づけられています。並行してSDXLも依然として幅広い現場で実用されており、豊富なLoRAやカスタムモデル資産を持つワークホースとして根強い支持を集めています。さらに、SD開発者らが立ち上げたBlack Forest LabsのFlux.1も多くのプラットフォームで採用が進んでいます。
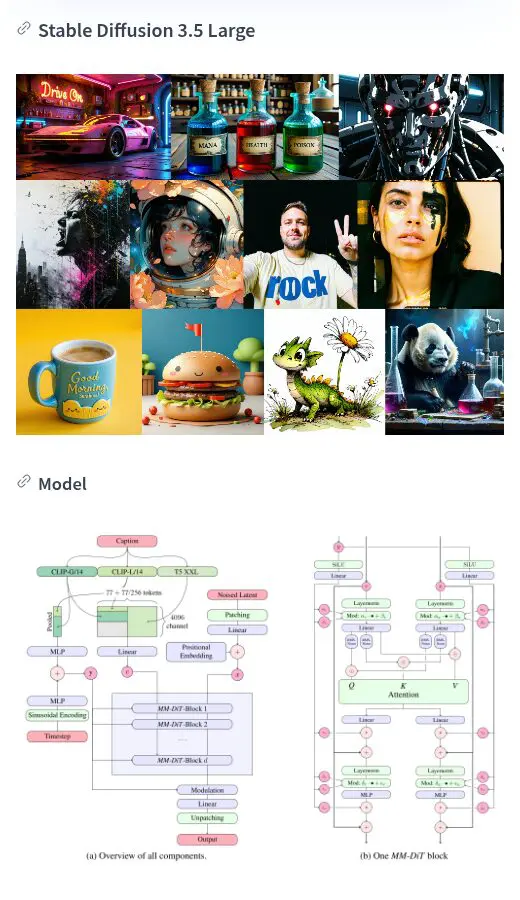
公式のモデルカード(Hugging Face、2026年10月14日確認)で確認できる内容は次のとおりです。SD 3.5 Largeは約80億パラメータ(8B)のMMDiT(Multimodal Diffusion Transformer)で、SD 3.5 Mediumは20億パラメータ(2B)のMMDiT-Xです。どちらも3種類のテキストエンコーダを使います。SDXL 1.0のライセンスは公式モデルカードでCreativeML Open RAIL++-Mと表示されており、SDXLはベースモデル単体でも使えると書かれています(Refinerは最終のノイズ除去に特化した別モデル)。
Stable Diffusionの使い方:環境と主要ツール
Stable Diffusionを使うには、大きく分けて「ローカル環境に導入する方法」と「クラウド・Webサービスで使う方法」の2つがあります。それぞれ特徴が異なるため、目的とスキルレベルに応じた選択が重要です。
ローカル環境での導入
自分のPCにインストールして動かす場合、最もよく使われるのが以下のGUIツールです。
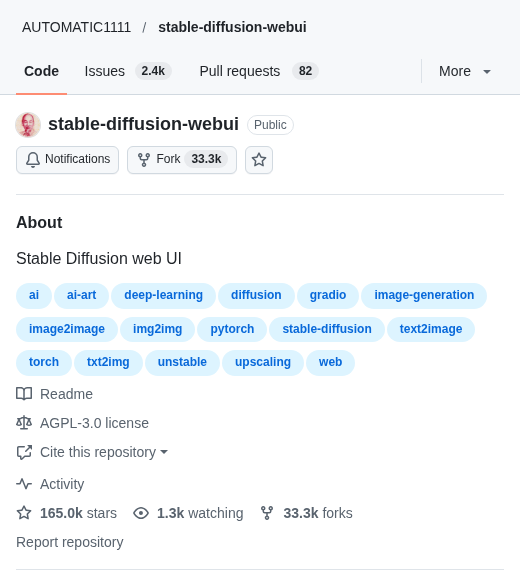
- AUTOMATIC1111(Stable Diffusion Web UI):長く使われてきたWebベースのGUIです。拡張機能(Extension)が豊富で、img2img・インペインティング・ハイレゾ化など多様な機能をブラウザから操作できます。導入にはPythonとGitの基礎知識が必要です。公式リポジトリの既定ブランチの最終コミットは2024年7月です(2026年10月14日にGitHubで確認)。SD 3.5など新しいモデルを使う場合は、次のComfyUIを選ぶ方が情報を探しやすい状況です。
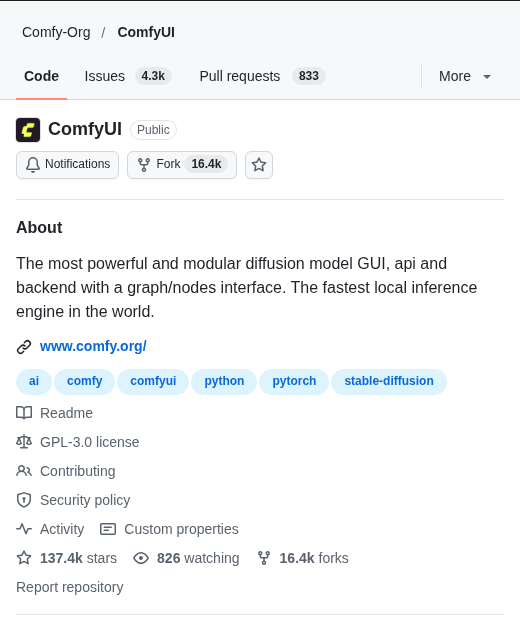
- ComfyUI:ノードベースのワークフロー型GUI。処理の流れを視覚的に組み立てられ、高度なカスタマイズに適する。SD 3.5・Flux.1への対応も早く、プロユーザーに人気が高い。SD 3.5 Mediumの公式モデルカード(Hugging Face)は、ローカルで使うUIとしてComfyUIを推奨しており、サンプルのワークフローも用意されています。
- Fooocus:Midjourneyライクな操作感を目指したシンプルなUI。設定項目を最小化し、プロンプトを入力するだけで高品質な画像を生成できる。初心者に適している。
- InvokeAI:クリエイター・プロ向けに洗練されたUI。キャンバス機能・インペインティング・アウトペインティングに強み。
ローカル動作に必要な推奨スペックの目安は以下の通りです。
| モデル | 最低VRAM | 推奨VRAM | 備考 |
|---|---|---|---|
| SD 1.5 | 4GB | 6〜8GB | fp16利用でさらに軽量化可 |
| SDXL | 8GB | 12〜16GB | Refinerモデル使用時はさらに必要 |
| SD 3.5 Medium | 8GB | 10〜12GB | コンシューマ向けハードウェアで動作。三系統中で最も省メモリ |
| SD 3.5 Large / Large Turbo | 10GB | 16〜24GB | 量子化版で省メモリ化可。Large Turboは速度優先 |
| Flux.1(dev/schnell) | 8GB(量子化版) | 16〜24GB | GGUF量子化モデルで省メモリ化可 |
上の表のVRAMは、コミュニティでよく挙げられる目安です。SD 3.5の公式モデルカードには必要なVRAMの数値が書かれておらず、量子化(NF4)でVRAM使用量を抑える方法が紹介されています。実際の動作は、使うUI・解像度・量子化の有無で変わります。
クラウド・Webサービスで使う方法
GPU非搭載のPCでも手軽に試したい場合、以下のサービスが利用できます。
- Google Colab:無料枠のGPUでAUTOMATIC1111やComfyUIを起動できるノートブックが多数公開されている。無料版は連続利用時間に制限あり。
- Stability AI公式のサービス(Stable Assistant・Stability AI API):Stability AIの公式ページ(2026年10月14日確認)には、Webで使える「Stable Assistant」と、自社アプリに組み込む「Stability AI API(Platform API)」が載っています。以前この記事で紹介していた「DreamStudio」は、現在の公式の画像モデルのページに記載がありません。料金は公式ページで確認してください。
- Civitai:コミュニティ投稿モデルのダウンロードサイトとして有名だが、オンライン生成機能(Civitai Generate)も提供。多様なカスタムモデルをブラウザ上で試せる。
- Replicate・fal.ai:APIベースのクラウドGPUサービス。開発者向けに各種SDモデルをAPIで呼び出せる。従量課金制。
Stable Diffusion 3.5を使い始めるまでの流れ(公式ページの画面つき)
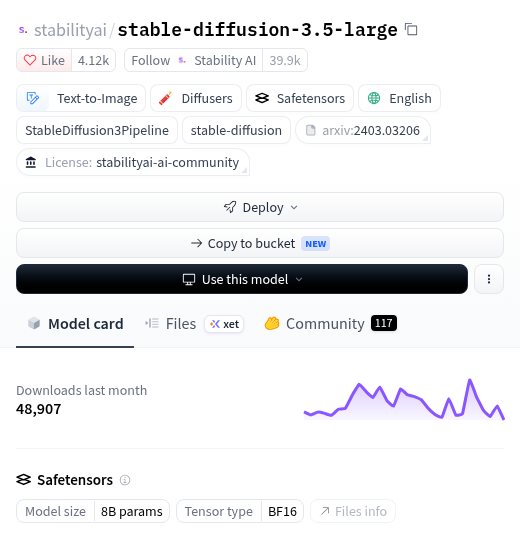
ここでは、Stable Diffusion 3.5を自分のPCで使い始めるときに、公式の公開ページで実際に確認する場所を順番に示します。画面はすべて、2026年10月14日に公式の公開ページを撮影したものです。モデルを実際に動かす画面は、この記事の筆者の環境(GPUなし)では撮れていないため載せていません。導入の手順そのものはStable Diffusionの導入・インストール手順で詳しく解説しています。
手順1:公式のモデルカードでライセンスを確認する
モデルの配布元は、Hugging Faceにある公式のモデルカードです(例:stabilityai/stable-diffusion-3.5-large)。ページ上部の「License」の欄でライセンスを確認します。SD 3.5 LargeとMediumはStability Community Licenseで、年間の総収益が100万ドル未満の組織・個人は、研究・非商用・商用のいずれも無料で使えます。年間収益が100万ドルを超える場合は、Stability AIにEnterprise Licenseを問い合わせる必要があります(Stability AIのライセンスページ、2026年10月14日確認)。モデルのファイルを取得するには、ページ下部で連絡先の共有とライセンスへの同意が必要です。
手順2:使うUIを選ぶ(ComfyUIまたはAUTOMATIC1111)
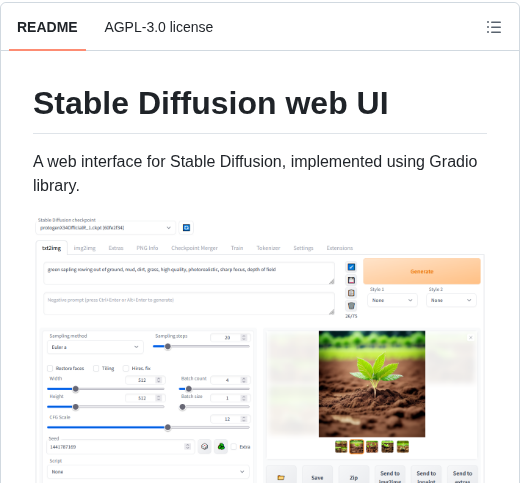
モデルを動かすUIは、公式のGitHubリポジトリから入手します。ComfyUIは「diffusion model GUI, api and backend with a graph/nodes interface」と説明されており、ライセンスはGPL-3.0です。AUTOMATIC1111のstable-diffusion-webuiはAGPL-3.0で、プロンプト欄・ネガティブプロンプト欄・サンプリング設定・生成結果が1つのブラウザ画面にまとまっています。
手順3:最初の1枚を作る設定の目安
最初の1枚は、公式モデルカードの例に近い設定から始めると比べやすくなります。SD 3.5 Largeの例はステップ数28・ガイダンススケール3.5、SD 3.5 Mediumの例はステップ数40・ガイダンススケール4.5です(どちらもdiffusersの例)。生成した画像の扱いは、使ったモデルのライセンスと、Stability AIのAcceptable Use Policy(自分のPCで動かす場合も対象)に従います。
プロンプトの書き方:良い画像を生成するコツ
Stable Diffusionで意図した画像を生成するためには、プロンプト(指示テキスト)の書き方が品質を大きく左右します。基本的なルールを理解するだけで、生成結果は飛躍的に向上します。
ポジティブプロンプトの構成要素
例:a serene Japanese garden in autumn, maple trees with red leaves, stone lantern, koi pond, golden hour lighting, 8K, photorealistic, sharp focus, depth of field
- 主題・シーン(何を描くか):例 “a serene Japanese garden in autumn”
- 構成要素(具体的なオブジェクト):例 “maple trees, stone lantern, koi pond”
- 照明・雰囲気:例 “golden hour lighting”
- 品質・スタイル修飾語:例 “8K, photorealistic, sharp focus, depth of field”
ネガティブプロンプトの活用
Stable Diffusionには「生成してほしくない要素」を指定するネガティブプロンプトがあります。SD 1.5系では特に効果的で、以下のような定番ネガティブプロンプトを使うことで品質が上がります。
ugly, blurry, low quality, deformed, extra limbs, bad anatomy, watermark, text, signature, cropped
SDXLやSD 3.5、Flux.1ではネガティブプロンプトの効果が薄れる場合がありますが、依然として破綻防止に有効です。特にSD 3.5はテキスト理解力が高いため、ポジティブプロンプトの記述精度を高める方向で調整するのが効果的です。
CFGスケールとステップ数の目安
- CFGスケール(Guidance Scale):プロンプトへの追従度。SD 1.5では7〜9が標準。高すぎると過彩色・不自然な画像になりやすい。SDXLでは5〜7が目安です。SD 3.5はHugging Faceの公式モデルカードの例で、Largeが3.5(ステップ数28)、Mediumが4.5(ステップ数40)と、SD 1.5より低い値が示されています。
- サンプリングステップ数:20〜30ステップで品質と速度のバランスが取れる。DPM++ 2M Karrasなどの高効率スケジューラーでは20ステップでも十分な品質が得られる。SD 3.5 Large Turboはより少ないステップ数での高品質生成を実現している。
動画・画像生成AIの業務活用をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
次に読む:Stable Diffusionのインストール方法は?
主要な応用技術:img2img・LoRA・ControlNetなど
Stable Diffusionの真価は、テキストから画像を生成する「txt2img」にとどまりません。多彩な拡張技術との組み合わせにより、プロフェッショナルなワークフローに対応できます。SD 3.5はComfyUI・LoRA・ControlNetのエコシステムに対応しており、以下の応用技術を継続して活用できます。
img2img(画像to画像)
既存の画像とプロンプトを入力として、元画像の構図・色調を活かしつつ新しい画像を生成する手法です。ラフスケッチをリアルなイラストに変換したり、写真のスタイルを変えたりする用途で広く使われます。「デノイズ強度(Denoising Strength)」パラメータで元画像への追従度を調整します。
インペインティング・アウトペインティング
インペインティングは画像の一部をマスクして、その部分だけを再生成する機能です。人物の顔を修正したり、背景の不要な物体を消したりする用途に有効です。アウトペインティングは逆に画像の外側を延伸・拡張する技術で、構図を後から広げるときに使われます。
LoRA(Low-Rank Adaptation)
ベースモデルに対して少ないパラメータで特定のスタイル・キャラクター・被写体を追加学習させる軽量ファインチューニング手法です。数十〜数百枚の学習画像とGPUがあれば個人でも作成可能で、CivitaiなどにはコミュニティによるLoRAが大量に公開されています。SD 3.5もLoRAによるファインチューニングに対応しており、エコシステムの拡充が進んでいます。
ControlNet
ポーズ・エッジ・深度マップ・法線マップなど、さまざまな「構造情報」を条件として画像生成を制御する拡張機能です。例えば、人物のポーズ情報(OpenPose)を入力すれば、そのポーズを忠実に再現したキャラクターを生成できます。コンセプトアートや商業デザインの現場で特に重宝されます。SD 3.5向けのControlNet対応も進んでいます。
Textual Inversion(Embedding)
特定のコンセプト・スタイル・人物などをテキストトークンとして学習させ、プロンプトに組み込んで使う手法です。LoRAより軽量ですが表現の自由度はやや低めです。
ハイレゾ化(Upscale)
生成した画像を、Real-ESRGAN・ESRGAN・Tile Upscaleなどのアルゴリズムで2〜4倍に高解像度化する処理です。SD 3.5はもともと高解像度出力に対応していますが、印刷や大型ディスプレイ向けにさらなる拡大が必要な場合にも有効です。
Stable Diffusionの活用事例
Stable Diffusionは、個人の趣味的な利用から企業の業務プロセスへの組み込みまで、幅広いシーンで活用されています。
クリエイティブ・コンテンツ制作
- ゲーム・アニメのコンセプトアート:世界観・キャラクターデザインのアイデア出しを数分単位に短縮。最終的な仕上げは人手で行いながらも、初期ラフの大量生成をAIが担う。
- マンガ・イラスト背景の補助生成:人物は手描きで、背景やオブジェクトをAIで生成して組み合わせるハイブリッドワークフロー。
- 映像制作のプリビズ・ストーリーボード:撮影前の映像イメージをプロンプトで素早くビジュアル化し、監督・クライアントとの合意形成に活用。
マーケティング・広告
- 商品のバリエーション別バナー画像を自動生成し、A/Bテストの素材コストを削減。
- SNS向けビジュアルコンテンツの量産。テキストだけでトンマナを統一した複数パターンを一括生成。
- ECサイトの商品背景差し替え(img2img+インペインティング活用)。
プロダクト・UI設計
- アプリのUIワイヤーフレームをControlNetでビジュアルに変換し、デザインプロトタイプを素早く作成。
- 建築・インテリアの内装イメージを複数スタイルで生成し、クライアント提案資料に活用。
企業・開発者向けAPI統合
- SaaS製品のAI画像生成機能としてReplicate・fal.ai経由でAPIに組み込み、エンドユーザー向けのパーソナライズ画像生成を提供。
- バーチャルヒューマンやアバターの外観生成・衣装変更への応用。
ライセンスと商用利用のルール
Stable Diffusionのライセンスはバージョンによって異なるため、商用利用の前に必ず確認が必要です。
| モデル | ライセンス | 商用利用 | 主な制限 |
|---|---|---|---|
| SD 1.4 / 1.5 | CreativeML Open RAIL-M | 条件付き可 | 違法コンテンツ・誤情報の生成禁止など使用制限条項あり |
| SD 2.x | CreativeML Open RAIL++-M | 条件付き可 | ほぼ同上 |
| SDXL 1.0 | Open RAIL++-M | 条件付き可 | 同上 |
| SD 3.5 Large / Large Turbo / Medium | Stability AI Community License | 年間収益100万ドル未満なら無料で商用可 | 大企業はエンタープライズ契約が必要 |
| Flux.1 [dev] | FLUX.1 [dev] Non-Commercial License | 非商用のみ | 商用利用は別途ライセンス契約が必要 |
| Flux.1 [schnell] | Apache 2.0 | 商用利用可 | 品質はdevより若干劣る |
生成した画像の著作権については、日本では「AIを道具として使った創作物は人間の創作的寄与があれば著作権が認められる可能性がある」との見解が示されています(文化庁、2024年)。ただし法解釈は現在も議論中であり、最新の法的動向を継続的に確認することを推奨します。また、学習データに含まれる可能性がある既存作品との類似問題については、特定スタイルの再現を意図的に求めるプロンプト使用時に注意が必要です。
【2026年7月3日時点】規約の最新動向——Acceptable Use Policyの改定
Stability AIはAcceptable Use Policy(AUP)を改定しています。2026年10月14日に公式ページを開くと、現行のAUPは「Effective: September 30, 2026」(2026年9月30日発効)の版でした。以前の版(2025年7月31日付)で明確になった点は、適用範囲です。非商用・研究・商用利用のすべてに加え、自己ホスト(ローカル実行)にも同ポリシーが適用されることが書かれており、現行の版にも「including self-hosting Stability AI code or weights」と記載があります。
禁止事項として明示されているのは、非同意の性的画像(NCII)、違法なポルノコンテンツ、性行為・性的暴力に関するコンテンツ、児童性的虐待資料(CSAM)などです。このほか法律違反、知的財産権侵害、差別・暴力扇動、ディープフェイクなど詐欺的利用、セーフガード回避行為も禁止対象とされています(2025年7月31日付の版の内容。2026年9月30日発効の版での変更点は、この記事では確認できていません)。
ローカルで動かしているから規約の枠外、という理解は誤りです。自己ホスト利用者も同じ規約の対象になる点を導入前に確認しておいてください(出典: Stability AI Acceptable Use Policy、2026年10月14日に再確認)。
なお画像生成の分野では、SD開発者らが設立したBlack Forest LabsもFLUX.2シリーズ(FLUX.2/FLUX.2 Max/FLUX.2 Klein等)へと更新を続けており、Flux.1以降も現役でモデルが刷新されています(出典: Black Forest Labs公式、2026年7月3日確認)。
Stable DiffusionとMidjourney・DALL·E 3の比較
| 項目 | Stable Diffusion | Midjourney | DALL·E 3(ChatGPT)※ |
|---|---|---|---|
| オープンソース | ✅ はい | ❌ クローズド | ❌ クローズド |
| ローカル動作 | ✅ 可能 | ❌ 不可 | ❌ 不可 |
| 無料利用 | ✅ 基本無料(ハード費用のみ) | △ 有料プランが必要(公式ドキュメント) | △ プランによる(OpenAIの公式ヘルプで確認) |
| カスタマイズ性 | ✅ 非常に高い(LoRA・ControlNetなど) | △ 限定的 | △ 限定的 |
| 操作の容易さ | △ 導入に学習コストあり | ✅ WebサイトまたはDiscordから使える | ✅ チャットから自然言語で使える |
| プロンプト精度 | ✅ 細かい制御が可能(SD 3.5でテキスト理解力が大幅向上) | △ 独自解釈が入りやすい | ✅ 自然言語理解が優秀 |
| 商用利用 | ✅ ライセンス条件内で可 | ✅ 有料プランで可 | ✅ 利用規約内で可 |
※DALL·E 3は、OpenAIの公式モデルページ(2026年10月14日確認)で「APIから削除済み」と案内されており、後継としてGPT-Image-2.5 Sunburstが推奨されています。表のDALL·E 3の列は、ChatGPTで使える画像生成を指すものとして読んでください。Midjourneyは公式ドキュメントで、Webサイトでも Discord でも使え、画像を作るにはプランへの加入が必要と案内されています。
Stable Diffusionはカスタマイズ性・コスト・プライバシー(ローカル処理)の面で他ツールを大きく上回る一方、初期セットアップの敷居が高い点が課題です。MidjourneyやDALL·E 3は手軽さを重視するユーザー向けです。業務への本格統合や特定スタイルへの特化を求めるならStable Diffusionが有力な選択肢となります。
よくある質問
Stable Diffusionは完全無料で使えますか?
モデルのダウンロード・ローカル実行は基本的に無料です。ただし、動作に必要なGPUのハードウェアコストは自己負担となります(必要なVRAMはモデルごとに異なり、SD 3.5の公式モデルカードには必要量の記載がありません。本文の表はコミュニティでよく挙げられる目安です)。Google ColabなどのクラウドGPUを使う場合も、無料枠内で動作しますが利用制限があります。
Mac(Apple Silicon)でも動きますか?
はい、AUTOMATIC1111やComfyUIはApple SiliconのMetalバックエンドに対応しており、M1以降のMacで動作します。パフォーマンスはNVIDIA GPU比で劣りますが、実用的な速度で使えます。
生成した画像は著作権フリーですか?
生成画像の著作権帰属は国・法解釈・生成のプロセスによって異なります。日本では人間の創作的関与の度合いが考慮されます。商用利用前に最新の法的ガイドラインと利用するモデルのライセンスを確認してください。
NSFW(成人向けコンテンツ)の生成はできますか?
デフォルトではNSFWフィルターが有効です。一部のコミュニティモデルではフィルターが無効化されているものもありますが、利用する地域の法律・モデルのライセンス条件を厳守する必要があります。違法コンテンツの生成はすべてのライセンスで明示的に禁止されています。
まとめ
Stable Diffusionは、潜在拡散モデルという革新的なアーキテクチャによって「高品質・低コスト・オープン」という三拍子を実現した画像生成AIです。テキストから画像を生成するtxt2imgを基本として、img2img・LoRA・ControlNetといった拡張技術により、クリエイターから企業の開発現場まで幅広いユースケースをカバーします。
2026年現在、Stability AIの主力オープンモデルはStable Diffusion 3.5(Large / Large Turbo / Medium)です。Diffusion Transformerアーキテクチャを採用し、テキスト理解力・構図精度・文字描画が従来世代から大幅に向上しています。コンシューマ向けハードウェアで動作し、ComfyUI・LoRA・ControlNetのエコシステムをそのまま活用できる点も強みです。並行して、豊富なコミュニティ資産を持つSDXLが依然ワークホースとして広く使われており、SD開発者らによるFlux.1も選択肢の一つです。なお、Stability AI 自体は財務難を経つつも、近年の資金調達や提携を通じて開発体制を継続しています。
AUTOMATIC1111やComfyUIを使ってローカルで無料起動できる点はMidjourneyやDALL·E 3にない最大の強みです。ライセンスはモデルごとに異なるため、商用利用時は必ず原文ライセンスを確認してください。
まず試す場合は、Google ColabでComfyUIを起動するか、FooocusをローカルPCにインストールするのがスムーズな入門経路です。プロンプトの書き方・パラメータ調整・LoRAの活用を積み上げることで、AIが生み出す表現の可能性を着実に広げていくことができます。
関連記事
監修
河合 継(クリスタルメソッド株式会社 代表取締役)
AI・ディープラーニングに関する特許16件の発明者。過去、国立がん研究センターとの共同研究や、テレビ番組でのAI解説実績を持つAI研究者として、AIの研究開発を主導している。
運営会社について | 編集方針
動画・画像生成AIの業務活用をご検討の方へ
クリスタルメソッドは、動画・画像を生成するAIやAIアバターの開発と業務導入を支援しています。「広告・研修動画の制作を効率化したい」「自社サービスに画像・動画生成を組み込みたい」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
Stable Diffusion導入完全ガイド|インストールから画像生成まで丁寧に解説
Stable Diffusion 導入完全ガイド|インストールから画像生成まで丁寧に解説 Stable Diffusionは、テキストや画像から高品質な画像を生...
-
Stable Diffusionを無料で使う方法|導入手順と注意点
Stable Diffusionは本当に無料で使えるの? はい、完全に無料で使えます。Stable Diffusionはオープンソースで公開されており、モデル本...
-
Stable Diffusionの料金を徹底解説|無料・有料プランの違いと最安の使い方
Stable Diffusion の料金を徹底解説|無料・有料プランの違いと最安の使い方 「Stable Diffusion は無料で使えるの?」「クラウド版と...