
blog
AIブログ
福袋抽選AIで需要予測する方法:EC担当者のための在庫・アクセス対策
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
gelato pique(ジェラート ピケ)が2027年向け福袋「HAPPY BOX 2027」の抽選受付を2026年11月2日12:00から11月5日23:59まで実施すると発表した(MANTANWEB)。全3種・5点入り・13,200円〜15,400円(税込)という構成で、マッシュ公式アプリ「MASH STORE」とECデパートメントストア「USAGI ONLINE」のみで受け付ける。抽選は先着順ではなく、結果は11月18日18:00以降にメールおよびプッシュ通知で通知される(トラベル Watch)。店頭販売はなく、決済はクレジットカードのみという設計だ(宮崎日日新聞DIGITAL)。
このニュースが浮き彫りにするのは、ブランド固有の話ではない。年末年始の福袋シーズンに抽選販売を採用するECサイトが構造的に直面する問題を、ひとつの事例が凝縮している。以下では、その課題をAI需要予測の観点から整理し、EC担当者が今から取れる実務的な一手を示す。
福袋抽選販売でEC担当者が直面する需要予測の三つの課題
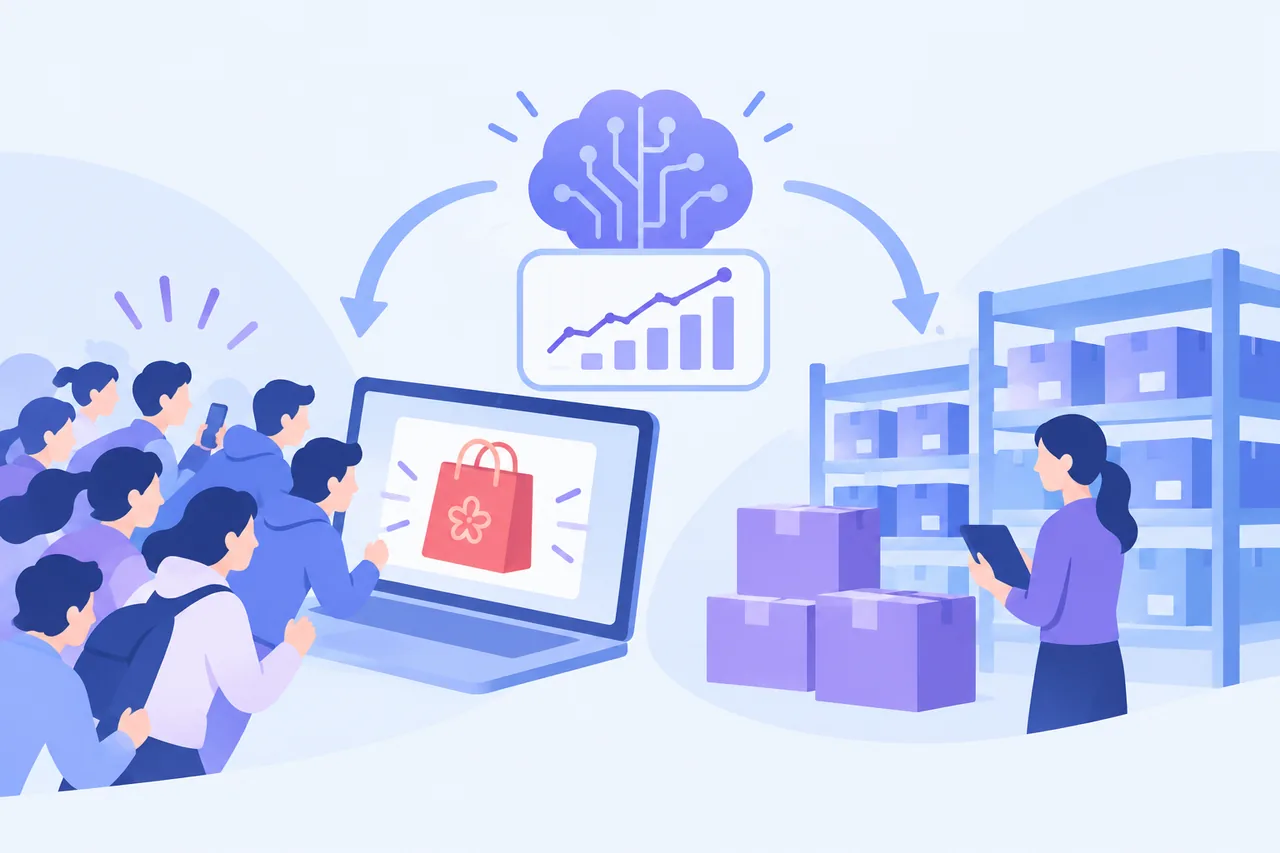
抽選販売は先着順の過負荷問題を回避する手段として定着しつつあるが、それ自体が新たな運営負荷を生む。主に三つの課題に集約される。
応募数の予測困難性。抽選受付期間中にどれだけの応募が集中するかは、受付開始前の段階では見えない。サーバー増強・在庫確保・当選枠設計のいずれも、この不確実性に正面から向き合う必要がある。受付前後のアクセス集中がインフラ障害やUX劣化を招けば、ブランド毀損に直結する。
キャンセル・補欠繰り上げの連鎖処理。当選後に決済エラーや辞退が発生すると、補欠処理と在庫の再割り当てが連鎖する。gelato piqueの事例では送料320円(税込)、プラチナ・ダイヤモンド会員は無料という会員属性別の条件差も存在し(premium.gamepedia.jp)、キャンセル率の読み方に複数変数が絡む。この連鎖が手動対応のままだと、カスタマーサポートへの負荷が短期間に集中しやすい。
翌年以降の在庫・価格設計へのフィードバック不足。「何人が応募し、何人が当選を辞退し、どのラインアップが人気だったか」が次の商品企画や在庫計画に活かされなければ、毎年同じ試行錯誤が繰り返される。年次イベントであるがゆえに、データを蓄積せずに終わるとサイクルが改善されない。
三つの課題は互いに連鎖するため、単発の対処ではなく、データを起点にした需要予測の仕組みとして整備することが有効だ。
ほかの業界では需要予測にAIをどう使っているのかは、製造業界における需要予測のAI活用事例で解説しています。
関連記事ChatGPT試着機能のEC活用で判断すべき論点は?
AI需要予測が福袋抽選の各課題に対してできること
需要予測の文脈でAIが指すのは、主に時系列予測モデル・機械学習による分類・自然言語処理(NLP)によるテキスト分析の三系統だ。それぞれが福袋抽選のどの課題に対応するかを整理する。
応募数・アクセス集中の事前予測
過去の福袋シーズンのアクセスログ・応募数・SNSメンション数・メルマガ配信タイミングを特徴量として、時系列予測モデル(Meta社のProphetや長短期記憶ネットワークLSTMなど)を使うと、受付開始後の最初の数時間の応募数を確率分布として推定できる。これにより「最大何件の同時接続を想定し、クラウドのオートスケーリング上限をいつ設定するか」という意思決定が、感覚値ではなく数値根拠で行えるようになる。
SNSでのブランドメンション急増を検知するソーシャルリスニングツールとの組み合わせは、需要の先行指標として機能しやすい。ただし予測はあくまで確率的な推定であり、過去データに含まれない突発的な拡散には追従しにくい点は前提として置く必要がある。
キャンセル予測と補欠管理の自動化
当選者が決済を完了しないリスクは、会員の購買履歴・過去の当選・辞退パターン・会員ランク・登録からの経過日数などを特徴量にした二値分類モデルで推定できる。「キャンセル確率が高い当選者」を事前にフラグ立てしてリマインドメールを自動送信したり、補欠順位の繰り上げタイミングを自動トリガーで管理したりする仕組みは、既存のCRMプラットフォームやメール配信システムのAPI連携で実装可能なものが増えている。
ただし分類モデルの精度はデータ量に依存する。福袋シーズンは年1回しかなく、学習データが数シーズン分しかない場合は予測精度に限界がある。過剰な自動化は想定外のキャンセル連鎖を拡大しうる点にも注意が必要だ。
在庫配分・価格設計への機械学習フィードバック
抽選応募から発送完了までのデータ(応募属性・当選率・辞退率・問い合わせ内訳)を構造化して蓄積すると、翌年の在庫数・商品構成・価格帯の設計に活用できるようになる。レコメンデーション系のモデルを用いて「どの会員セグメントがどのラインアップに集中するか」を予測することは、会員データの規模がある程度あれば技術的に実現可能だ。この積み重ねが、毎年の「勘と経験」依存を段階的に減らしていく。
次に読む:ShipBob AIの物流自動化は日本企業にどう関係する?
福袋需要予測のAI活用アプローチ比較
EC担当者がAIを活用して福袋の需要を予測・管理しようとする場合、どのアプローチを選ぶかは組織の技術力・データ量・予算によって変わる。主な選択肢を以下の表に整理する。
| アプローチ | 主な技術・ツール例 | 必要なデータ量 | おおよその初期コスト | 向いているEC規模 | 主な限界 |
|---|---|---|---|---|---|
| クラウドMLプラットフォーム(内製) | Google Vertex AI、AWS SageMaker | 大(数万件以上の履歴) | 従量課金+データサイエンティスト人件費 | 中規模〜大規模 | 専門人材の確保が必要。年1回のイベントには過剰投資になりやすい |
| AutoML・BIツール(内製簡易) | BigQuery ML、DataRobot | 中(数千件から) | 月額SaaS費用(数万〜数十万円台) | 中小規模 | 精度に上限あり。カスタマイズは限定的 |
| 需要予測特化SaaS | 国内外の需要予測サービス各種 | 小〜中(提供仕様による) | 初期費用+月額(サービスにより異なる) | 小規模〜中規模 | ECシステムとの連携工数が必要。福袋特有の抽選ロジックに対応していない場合がある |
| 統計的手法(非AI) | 移動平均、季節調整、回帰分析 | 小(過去3〜5シーズン程度) | 低(Excelレベルでも実施可) | 全規模 | 突発的な需要変動への追従が弱い。SNS拡散などの非線形変化を捉えにくい |
この比較が示すのは、AIを導入すれば即座に需要予測が解決するわけではなく、自組織のデータ基盤の整備状況が前提条件になるという点だ。過去の応募・購買・問い合わせデータが体系的に蓄積されていなければ、どのアプローチを選んでも予測精度は上がらない。小規模ECの場合、複雑なAIシステムより統計的手法の方が費用対効果が高い局面も多い。
AI活用の注意点と現実的な限界
福袋抽選にAI需要予測を導入する際に直面しやすいリスクと限界を四点挙げる。
年1回しかない学習データの希少性。福袋シーズンは年次イベントであり、モデルの学習に使える過去データは多くても数十回分程度だ。ブランド人気の急変・SNSでの想定外の拡散・競合他社の動向など、過去データに含まれない要因による需要変動に対してモデルは脆弱になりやすい。汎用的なEC購買データで補完する手法は存在するが、福袋の抽選という特殊な行動ファネルへの適合度は限定的だ。
個人情報・プライバシー規制への対応。会員の行動データや決済情報をモデルの学習に用いる場合、プライバシーポリシーの更新・利用目的の明示・個人情報保護法への準拠が前提になる。「AI予測のために行動データを使う」という利用目的が利用規約に明記されていなければ、法的リスクが生じる可能性がある。
予測結果の過信によるオペレーション判断ミス。AIの需要予測はあくまで確率的な推定であり、外れる。予測値を絶対視せず、シナリオ幅(上限・下限)を設定し、その幅に対してオペレーションの余裕を持たせる設計が実務的には重要だ。「AIが出した数値だから」という根拠でサーバー増強を絞りすぎると、障害発生時の責任帰属も曖昧になる。
導入・運用コストと効果の試算。需要予測システムの構築には初期費用だけでなく、モデルの継続的なメンテナンス・精度監視・データパイプラインの維持コストが継続的に発生する。福袋シーズンのみの短期的な課題解決のために大規模な投資をすることが合理的かどうかは、EC全体の年間売上規模と照らして判断する必要がある。
EC担当者が今すぐ取れる次の一手
高度なAIシステムを構築しなくても、今シーズンの福袋対策として着手できる実務的なステップがある。
まずデータの棚卸しから始める。過去の福袋シーズンの応募数・当選率・辞退率・問い合わせ件数・問い合わせ内容をひとつのスプレッドシートに集約する。この作業だけで「どこに予測のボトルネックがあるか」が可視化されることが多い。gelato piqueの事例のように会員ランク別の条件差がある場合は、ランク別の辞退率も分けて集計する。
次にSNSモニタリングの自動化を設定する。Google アラートや無料のソーシャルリスニングツールを使い、自社ブランド名と「福袋」「抽選」のメンション数を受付前後で追跡する体制を整える。これは需要の先行指標として機能し、サーバー増強判断のトリガーにもなる。
キャンセル対応フローの文書化と自動化の検討。現状の補欠繰り上げ手順を文書化し、既存のメール配信システムやCRMのオートメーション機能で代替できる部分を洗い出す。完全なAI導入の前に、ルールベースの自動化だけで解決できる部分は小さくない。「当選メール送信後72時間以内に決済未完了の場合、自動リマインドを送り、さらに24時間後に補欠繰り上げを実行する」というルールは、機械学習なしでも多くのメール配信基盤で実装できる。
これらのステップは機械学習の専門知識がなくても実行できる。データを蓄積し、オペレーションを可視化することが、本格的なAI需要予測導入の土台になる。
参考文献
- MANTANWEB(まんたんウェブ) https://mantan-web.jp/prtimes/article/20261026prt00m200000515a.html
- トラベル Watch https://travel.watch.impress.co.jp/docs/news/2151219.html
- 宮崎日日新聞DIGITAL https://www.the-miyanichi.co.jp/pressrelease/prtimes/1202321.html
- premium.gamepedia.jp https://premium.gamepedia.jp/shopping/archives/68989
Read next
あわせて読みたい
-
第6回「製造業界における需要予測のAI活用事例とは?」
製造業において「販売計画をどう精度よく立てるか」は、在庫過多・欠品・生産ロスを左右する根幹の課題です。近年、AIを活用した需要予測が販売計画の精度を飛躍的に高め...
-
AI物流自動化で越境EC効率化:ShipBob AIが示す日本企業への実務的含意
ShipBobのAI統合発表——何が起きたか 2026年8月4日、米フルフィルメントプラットフォームのShipBob(本社:シカゴ、2014年創業、CEO:Dh...
-
ChatGPT 試着機能のEC活用——日本のアパレル企業が今判断すべき5つの論点
ChatGPT 試着機能のEC活用が浮上した背景 2026年10月1日(木)、OpenAIはChatGPTにバーチャル試着機能のグローバルロールアウトを開始した...