
blog
AIブログ
ファインチューニングの方法|手順・手法・ハイパーパラメータ調整まで解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
ファインチューニングの方法:全体の流れと、選べる4つのやり方
先に結論です。ファインチューニングは「目的と評価方法を決める → 学習データ(JSONL)を用意する → 手法とベースモデルを選ぶ → 学習を実行する → 学習に使っていないデータで評価する」の順で進めます。実行のやり方は、クラウドの学習サービス(Google Cloud の Vertex AI、Amazon Bedrock)を使うか、Hugging Face の PEFT と TRL で自分の環境(GPU)で学習するかの2系統です。OpenAI のファインチューニングは、新規の利用者には提供されていません(2026年10月29日に公式ドキュメントで確認)。
ファインチューニングとは何か、プロンプトやRAGとの違いはファインチューニングとは(総合ガイド)で説明しています。この記事は、実際に手を動かす人のために、データの用意・設定値・各基盤の手順・評価に絞って解説します。
作業の全体像(5つの作業)
| 作業 | やること | この記事の節 |
|---|---|---|
| 1. 目的と評価方法を決める | 何を良くしたいのかを一言で決め、学習に使わない評価用データと、良し悪しの見方を先に用意する | この節へ |
| 2. 学習データを用意する | 「入力」と「望ましい出力」の組をJSONLで作り、学習用と検証用に分ける | この節へ |
| 3. 手法とベースモデルを選ぶ | フル・LoRA・QLoRA のどれで学習するか、どのモデルを土台にするかを決める | この節へ |
| 4. 学習を実行する | クラウドの学習サービスか、PEFT+TRL で自分の環境から実行する | この節へ |
| 5. 評価して直す | 学習前後の出力と損失を比べ、データと設定を直して回す | この節へ |
やり方は4つ:どれで始めるか
2026年10月29日時点の公式ドキュメントで確認できる内容を、基盤ごとに並べました。
| やり方 | 向いている人 | 用意するもの | 公式の記載(要点) |
|---|---|---|---|
| Google Cloud の Vertex AI(教師ありチューニング) | Google のGeminiを自分の用途に合わせたい人 | Google Cloud のプロジェクトと、Cloud Storage に置いたJSONL | 対象モデルは Gemini 3.5 Flash-Lite・3.5 Flash・3.1 Flash-Lite・2.5 Pro・2.5 Flash-Lite・2.5 Flash。まず100件程度から始めるよう案内されています |
| Amazon Bedrock(教師ありファインチューニング) | AWS上で、Amazon Nova・Llama・Claude 3 Haiku などを調整したい人 | AWSアカウントと、S3 に置いたJSONL | 学習費は「学習データのトークン数 × エポック数」と、モデルの保存料(月額) |
| Hugging Face の PEFT + TRL(自分の環境) | GPUを自分で用意でき、公開モデルを調整したい人 | GPU環境、Python、公開モデル、JSONL | PEFT は追加した少数のパラメータだけを学習するライブラリ。TRL の SFTTrainer が教師あり学習を担当 |
| OpenAI のファインチューニング | (新規の人は始められません) | — | 「ファインチューニングのプラットフォームを終了する」「新規ユーザーは利用できない」と記載。既存の利用者は 2027年1月6日まで学習ジョブを作成できる(ただしベースモデルが先に終了する場合を除く) |
出典:Vertex AI「About supervised fine-tuning」、Amazon Bedrock「Customize your model」、PEFT Quicktour、OpenAI「Model optimization」、OpenAI「Supervised fine-tuning」(いずれも2026年10月29日確認)。
これから始めるなら、データを手元に置いたまま試したい・費用を抑えたい場合は PEFT+TRL、GPUを持たず、運用までクラウドで済ませたい場合は Vertex AI か Bedrock が出発点です。OpenAI の古い解説にある「GPT-4o mini や GPT-3.5 Turbo をファインチューニングする」手順は、いま新しく始めることはできません。
学習や利用にかかる費用は実際どれくらいなのかは、ファインチューニングの料金で解説しています。
ファインチューニングとは:学習の前に押さえる仕組み
ファインチューニング(fine-tuning)は、すでに大量のデータで学習されたモデル(事前学習済みモデル)を土台にして、手元の「入力と望ましい出力」の例でさらに追加学習し、モデルの重み(パラメータ)を更新する方法です。ゼロから作るより、少ないデータと計算資源で、口調・出力形式・特定タスクの振る舞いを変えられます。
| 段階 | やること | 得られるもの |
|---|---|---|
| 1. 事前学習 | 大規模な汎用データで、言語の構造や知識を学習する(公開・提供されているモデルは、この段階が済んでいる) | 汎用の土台モデル |
| 2. ファインチューニング | 手元の例(入力と望ましい出力の組)で追加学習し、重みを少しだけ動かす | 用途に合わせて振る舞いが変わったモデル |
| 3. 評価 | 学習に使っていないデータで、学習前後の出力を比べる | 追加学習が効いたかの確認 |
学習中は「入力を与える → モデルが出力する → 望ましい出力との差(損失、loss)を測る → 差が小さくなる方向に重みを少し動かす」を、データの件数ぶん何周(エポック)か繰り返します。重みの動かし幅が学習率です。この仕組みは転移学習の一種で、全体像はファインチューニングとは(総合ガイド)で説明しています。
次に読む:ファインチューニングを無料で始めるには?
プロンプト・RAGとの違いと、始める前に決めること
ファインチューニングは、データ作りと評価の手間がかかります。何を変えたいかで、より軽い手段から選びます。
| 観点 | プロンプトの工夫 | RAG(検索拡張生成) | ファインチューニング |
|---|---|---|---|
| 変えるもの | 指示文・例(モデルは変えない) | 参照させる資料(モデルは変えない) | モデルの重みそのもの |
| 得意なこと | 指示や形式の調整 | 最新情報や大量の社内文書への回答 | 口調・出力形式・特定タスクの振る舞いの定着 |
| 知識の更新 | 指示文を書き換える | 資料を更新する | 再学習が必要(頻繁な更新には不向き) |
| 必要なもの | 文章力と試行錯誤 | 検索できる形の資料と検索の仕組み | 入力と望ましい出力のデータ、学習環境 |
| 試す順番 | 1番目 | 2番目 | 3番目(上の2つで足りないとき) |
OpenAI の公式ドキュメントも、ファインチューニングは「正解の例を示してモデルの振る舞いを導く」手段で、分類・翻訳の言い回し・特定の形式での出力・指示に従えない失敗の修正に向くとしています。「評価(evals)を整えてから投資する」ことが前提です(OpenAI「Supervised fine-tuning」、2026年10月29日確認)。
ファインチューニングのメリット
- 口調・出力形式を安定させられます:毎回長い指示や例を付けなくても、決まった口調・形式で出力させやすくなります。そのぶんプロンプトが短くなり、トークンの消費も抑えられます。
- 特定タスクの精度を上げやすくなります:分類・抽出・決まった形式への変換など、正解が決まる仕事で、例を学習させて安定させられます。
- 小さなモデルで済ませられる場合があります:仕事を絞って学習させれば、小型のモデルでも目的のタスクで使えることがあります。
- 自社の用語や判断基準を反映できます:対応履歴や社内文書など、手元のデータを「振る舞い」としてモデルに取り込めます。自分の環境で学習するなら、データを外部サービスに渡さずに済みます。
向かない場合と、起きやすいリスク
- 向かない場合:最新の知識を参照させたい用途(RAGが向きます)、評価用データを用意できない用途、学習データに機密情報が混ざる場合です。
- リスク:元の能力が落ちる破滅的忘却、学習データへの過学習、データの偏りがあります(対処は、後半の「うまくいかないときの原因と対処」に整理しました)。
- RAGとの併用:知識はRAGで補い、口調や出力形式はファインチューニングで整える、という組み合わせもできます。
産業別の活用例はファインチューニングの事例にまとめています。
学習の前に決めること:目的と評価方法
学習の前に、次の3点を決めます。ここが曖昧だと、学習が終わっても「良くなったのか」を判断できません。
- タスク:分類・要約・質問応答・文体の変換・JSONでの抽出など、モデルにさせたい仕事を一言で書ける形に絞ります
- 評価の方法:正解が決まるタスクなら正答率やF1、文章生成なら人が見る基準(口調が合っているか・事実が変わっていないか)を、学習前に決めておきます
- 評価用データ:学習に使わない例を、先に取り分けておきます。OpenAI の公式ドキュメントも、取り分けたデータは評価の「対照群」として使うと説明しています
学習前のモデル(ベースモデル)の出力を、評価用データで先に記録しておくと、学習後との比較ができます(評価の節)。
学習データの作り方:JSONL形式・件数・分け方
教師ありファインチューニングの学習データは、1行に1件の例を書いたJSONL(JSON Lines)で用意します。1件は「入力」と「望ましい出力」の組です。各基盤が決めている書式を、2026年10月29日に公式ドキュメントで確認しました。
基盤ごとのデータ形式
| 基盤 | 1行の形(要点) | 置き場所 | 出典 |
|---|---|---|---|
| PEFT+TRL(SFTTrainer) | 会話形式の messages(role と content)。このほか prompt と completion の組、text だけの形式にも対応 |
手元のファイル、またはHugging Faceのデータセット | TRL「SFT Trainer」 |
| Amazon Bedrock | 会話でない仕事は prompt と completion。会話は Converse API 形式(schemaVersion・system・messages)。Claude 3 Haiku は system と messages |
S3 | Bedrock「Prepare data」 |
| Vertex AI | 各行が1件。任意の systemInstruction と、role・parts を持つ contents の配列 |
Cloud Storage | Vertex AI「Prepare your data」 |
| OpenAI(既存の利用者のみ) | messages(role と content)を1行に1つ |
ファイルをアップロード | OpenAI「Supervised fine-tuning」 |
どの基盤でも、会話の形(ユーザーの発言と、望ましい返答)を1件にそろえておけば、書式の違いは変換スクリプトで吸収できます。PEFT+TRL向けの1行の例は次のとおりです(TRL公式の「conversational language modeling」形式です)。
{"messages": [
  {"role": "user",
   "content": "案内文を丁寧にしてください。来月から送料が上がります。"},
  {"role": "assistant",
   "content": "来月より送料が改定となります。"}]}
上の例は読みやすいように改行していますが、実際のファイルでは1件を1行に書きます。
何件必要か:公式が示している件数
必要な件数に決まった正解はありません。各基盤の公式ドキュメントに書かれている最小値と推奨の出発点は次のとおりです。
| 基盤・モデル | 公式に書かれている件数 | 出典 |
|---|---|---|
| Vertex AI | 「まず100件から始め、必要なら数千件まで増やす」。「データの質は量よりもはるかに重要」 | Prepare your data |
| OpenAI(既存の利用者) | 最小10件。「よく練った50件から始めて結果を評価する」ことを推奨 | Supervised fine-tuning |
| Amazon Bedrock(Llama 3.1・3.2・3.3) | 学習用と検証用の合計が100件以上、10,000件まで(クォータ申請で調整可) | Prepare data for fine-tuning |
| Amazon Bedrock(Claude 3 Haiku) | 最小32件、学習用は最大10,000件 | Prepare data for fine-tuning |
つまり、最初の1回は数十〜100件程度の質の高い例で試し、結果を見て増やすのが、公式の案内に沿った進め方です。
データを整えるときの確認項目
- 形式をそろえる:同じ仕事の例は、指示の書き方・出力の形をそろえます(バラバラだと、学習後の出力も不安定になります)
- 重複と矛盾を取り除く:同じ入力に別の出力が付いている例は、どちらかに統一します
- 長さを確認する:基盤ごとに1件あたりのトークン上限があります(たとえば Bedrock の Llama 3.1 は入力と出力の合計16,000トークン)。Bedrock の公式ドキュメントは、文字数からトークン数を見積もるときの目安として「1トークンあたり約6文字」を挙げています
- 学習用・検証用・評価用に分けます:学習に使うデータ、学習中に損失を見る検証データ、最後に学習前後を比べる評価データ(テストデータ)です。Vertex AI の公式ドキュメントは、チューニングの効果を測るため検証用データセットを用意することを強く推奨しています。公式に決まった比率はなく、一例として学習用8:検証用1:評価用1に分けます。件数が少ないときは、検証・評価に使う分も最低限の件数を確保してください
- 機密情報を入れません:個人情報や社外秘が学習データに混ざると、出力から引き出される恐れがあります
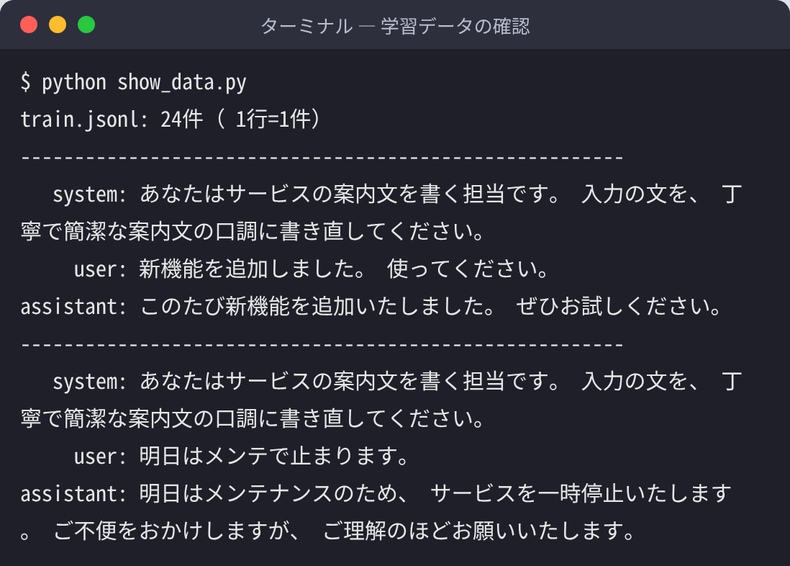
図は、この記事のために作った例(案内文を丁寧な口調に直す)の学習データの最初の2件です。system・user・assistant の3役割で1件を構成しています。
手法とベースモデルの選び方
手法:フル・LoRA・QLoRA のどれで学習するか
| 手法 | 学習するもの | 特徴 | 公式・論文の記載 |
|---|---|---|---|
| フルファインチューニング | モデルの全パラメータ | 表現力は高いが、必要なGPUメモリと保存容量が大きい | — |
| LoRA(PEFT の代表的な手法) | 元の重みは固定し、追加した小さな行列だけ | 学習するパラメータが少なく、結果(アダプタ)は小さく保存できる | LoRA論文は、Adamで調整するGPT-3 175Bと比べ、学習するパラメータ数を1万分の1、GPUメモリを3分の1にできると述べています(arXiv:2106.09685) |
| QLoRA | ベースモデルを4ビットに量子化して固定し、LoRAを学習 | 同じGPUで、より大きなモデルを扱える | QLoRA論文は、65Bパラメータのモデルを1枚の48GB GPUで調整できると述べています(arXiv:2305.14314) |
PEFT の公式ドキュメントは、PEFT の手法を「追加した少数のパラメータだけを学習するので、計算と保存の負担を大きく減らしながら、全体を調整したモデルに近い性能が得られる」ものと説明しています(PEFT、2026年10月29日確認)。まず自分の環境で試すなら、LoRA か QLoRA から入るのが現実的です。クラウドの学習サービスを使う場合は、手法の選択はサービス側が担います。
教師あり以外の調整方法:選好チューニング・強化学習
ここまでの「入力と望ましい出力」の組で学ぶ方法は、教師ありファインチューニング(SFT)です。回答の好みを教える方法もあります。RLHF(人のフィードバックによる強化学習)は、人が複数の回答を比べたデータから「回答の良さ」を予測する報酬モデルをつくり、その報酬が高くなるようにモデルを調整する方法です。DPO(Direct Preference Optimization)は、「良い回答と悪い回答」の比較データから、報酬モデルを介さずに直接調整します。各基盤が提供している方式は次のとおりです。
| 基盤 | 提供されている方式(公式の記載) |
|---|---|
| Vertex AI | 教師ありファインチューニング・プリファレンスチューニング・強化学習ファインチューニング |
| Amazon Bedrock | 教師ありファインチューニング・強化学習ファインチューニング(Lambda で報酬関数を定義)・蒸留(大きなモデルの出力で小さなモデルを学習) |
| OpenAI(既存の利用者のみ) | 教師あり(gpt-4.1 系)・ビジョン(gpt-4o-2024-08-06)・DPO(gpt-4.1 系)・強化学習(o4-mini) |
最初は教師ありで十分なことが多く、好みの調整は、教師ありで基本の振る舞いを整えたあとの選択肢です。出典:Vertex AI、Amazon Bedrock、OpenAI(2026年10月29日確認)。
ベースモデルの選び方
| 観点 | 確認すること |
|---|---|
| 言語 | 日本語のタスクなら、日本語を学習に含むモデルを選ぶ(例:Llama-3.1-Swallow、llm-jp-3、sarashina2.2、Qwen など。2026年10月13日にHugging Face上での公開を確認) |
| 大きさ | 使えるGPUメモリに収まるか。収まらないときはQLoRA、または小さなモデルに替える |
| ライセンス | 商用利用の可否を、モデルのライセンスで必ず確認する(Apache 2.0、MIT、Llama Community License など) |
| Base と Instruct | 指示に従わせたいならInstructモデル、独自の会話形式を一から作るならBaseモデル |
| クラウドの場合 | 基盤が対応しているモデルから選ぶ。Bedrock の対象は Amazon Nova・Claude 3 Haiku・Llama 3.1/3.2/3.3 など(Nova 2 Lite、Nova Micro/Lite/Pro、Llama 3.1 8B/70B ほか)、Vertex AI は上の表のGeminiの各モデル |
学習の実行方法:基盤別のやり方とコード
データが用意できたら、基盤ごとに学習を実行します。2026年10月29日時点の公式ドキュメントの内容に沿って説明します。
Google Cloud の Vertex AI で学習する
- JSONLを Cloud Storage のバケットにアップロードします(公式は、チューニングを行うのと同じ Google Cloud プロジェクトのバケットを推奨)
- コンソールの Agent Studio で「Create tuned model」を選び、名前・ベースモデル・リージョンを決めます(公式のコンソール手順は Gemini 2.5 以前向けと明記されており、Gemini 3.5 の例は SDK で示されています)
- エポック数・アダプタサイズ・学習率の倍率を設定します(エポック数は未設定なら推奨値が使われ、学習率の倍率の既定値は1)
- 必要なら検証用データセットのパスを指定し、「Start Tuning」で開始します
SDK では client.tunings.tune(...) でジョブを作成します(公式の例は base_model="gemini-3.5-flash")。アダプタサイズの選択肢は、Gemini 3.5・3.1・2.5 の Flash 系で 1・2・4・8・16、Gemini 2.5 Pro で 1・2・4・8 です。出典:Vertex AI「Tune Gemini models with supervised fine-tuning」、About supervised fine-tuning(2026年10月29日確認)。
Amazon Bedrock で学習する
- JSONLを S3 に置きます。Bedrock がS3のファイルを読めるよう、モデルカスタマイズ用のサービスロール(IAM)を用意します
- コンソールまたは
CreateModelCustomizationJobAPI でジョブを作成し、ベースモデルと、エポック数などのハイパーパラメータを指定します - ジョブが完了したら、評価用データでカスタムモデルの出力を確認します
料金は、学習データのトークン数にエポック数を掛けた量に対する学習費と、モデルの保存料(月額)です。Bedrock で調整できるモデルの一覧は、公式ドキュメントの表(Amazon Nova・Claude 3 Haiku・Llama 3.1/3.2/3.3 など)で確認できます。出典:Bedrock「Customize a model with fine-tuning」、Customize your model(2026年10月29日確認)。
学習にかかる費用の見積り方
クラウドの学習サービスは、学習データの量に応じた従量課金です。Bedrock の公式ドキュメントは「学習データのトークン数 × エポック数」で学習費が決まると説明しています(Vertex AI もトレーニングトークン数を学習データの総トークン数 × エポック数で数えます)。見積りの手順は次のとおりです。
- 学習データ全体のトークン数を数えます(Bedrock の公式は、文字数からの目安として1トークンあたり約6文字を挙げています)
- エポック数を掛けます。たとえば、学習データが合計10万トークン、エポック数が3なら、学習で処理するトークン数は30万トークンです(数字は計算の例です)
- その合計に、各社の料金ページにある単価を掛けます。単価は変わるので、実行の前に最新の料金ページで確認してください
- Bedrock では、これとは別にモデルの保存料(月額)がかかります
エポック数を増やすと、そのぶん費用も増えます(Bedrock の公式ドキュメントも、エポック数で費用が増えると明記)。料金の詳細はファインチューニングの料金にまとめています。
OpenAI で学習する(既存の利用者のみ)
OpenAI の公式ドキュメントでは、ファインチューニングのプラットフォームを終了する方向で、新規ユーザーは利用できないと書かれています。既存の利用者は、2027年1月6日まで(ベースモデルが先に終了しない限り)学習ジョブを作成でき、学習済みモデルはベースモデルが廃止されるまで推論に使えます。案内されている方式は、教師あり(gpt-4.1 系)・ビジョン(gpt-4o-2024-08-06)・DPO(gpt-4.1 系)・強化学習(o4-mini)です。これから新しく始める手順としては書けません(Model optimization、Supervised fine-tuning、2026年10月29日確認)。
自分の環境で学習する:PEFT+TRL の最小コード
Hugging Face の PEFT と TRL を使うと、LoRA の学習を数十行で書けます。TRL の公式ドキュメントは、SFTTrainer に peft_config を渡すだけでアダプタの学習になると説明しています。まずデータを読み込みます。
from datasets import load_dataset

dataset = load_dataset(
    "json",
    data_files={"train": "train.jsonl", "validation": "valid.jsonl"},
)
次に、LoRA の設定と学習の設定を作り、学習します。
import torch
from peft import LoraConfig
from trl import SFTConfig, SFTTrainer

peft_config = LoraConfig(
    r=16,
    lora_alpha=32,
    target_modules=["q_proj", "v_proj"],
    task_type="CAUSAL_LM",
)

training_args = SFTConfig(
    output_dir="./output",
    num_train_epochs=3,
    learning_rate=1e-4,   # アダプタは1e-4前後
    per_device_train_batch_size=4,
    gradient_accumulation_steps=4,  # 実効16
    max_length=2048,   # 既定は1024
    eval_strategy="epoch",
    save_strategy="epoch",
    logging_steps=10,
    model_init_kwargs={"dtype": torch.bfloat16},
)

trainer = SFTTrainer(
    model="Qwen/Qwen2.5-0.5B-Instruct",
    args=training_args,
    train_dataset=dataset["train"],
    eval_dataset=dataset["validation"],
    peft_config=peft_config,
)
trainer.model.print_trainable_parameters()
trainer.train()
モデルIDは、使うベースモデルのものに置き換えます。
上のコードは、TRL・PEFT の公式ドキュメント(2026年10月29日確認)の書き方に沿って組んだ最小の例で、このコードそのものをGPUで実行した結果は載せていません。実際に動かした結果は、次の節で別の例として示します。引数の意味は次のとおりです。
| 引数 | 意味 | 公式ドキュメントの記載 |
|---|---|---|
LoraConfig(r=...) |
更新行列のランク。小さいほど学習するパラメータが減る | PEFT「LoRA」:ランクを下げると更新行列が小さくなり、学習するパラメータが減る |
lora_alpha |
LoRAのスケーリング係数 | 既定では lora_alpha / r でスケーリングされる |
target_modules |
LoRAを適用する層 | モデルの構造によって層の名前が違うので、使うモデルに合わせて指定する |
learning_rate |
学習率 | TRL の SFTConfig の既定は 2e-5。アダプタの学習では 1e-4 前後を使うとの案内がある |
max_length |
1件あたりの最大トークン数 | TRL の SFTConfig の既定は 1024 |
num_train_epochs |
データを何周するか | TRL の SFTConfig の既定は 3.0 |
assistant_only_loss=True |
assistant の発言にだけ損失を計算する(会話形式のデータ向け) | チャットテンプレートの対応が必要。対応モデルでは自動で補われる |
QLoRA にするときは、4ビットの設定を作って quantization_config に渡します(TRL の公式ドキュメントは、peft_config と組み合わせるとQLoRAの学習になると説明しています)。
import torch
from transformers import BitsAndBytesConfig

bnb_config = BitsAndBytesConfig(
    load_in_4bit=True,
    bnb_4bit_quant_type="nf4",
    bnb_4bit_compute_dtype=torch.bfloat16,
)

trainer = SFTTrainer(
    model="ベースモデルのID",
    args=training_args,
    train_dataset=dataset["train"],
    eval_dataset=dataset["validation"],
    peft_config=peft_config,
    quantization_config=bnb_config,
)
QLoRA は quantization_config に4ビット設定を渡すだけで、LoRA の設定(peft_config)はそのまま使えます。
出典:TRL「SFT Trainer」、PEFT Quicktour、PEFT「LoRA」(2026年10月29日確認)。TRL は更新が速く、古い解説にある tokenizer=・max_seq_length=・evaluation_strategy= は、現行では processing_class=・max_length=・eval_strategy= に変わっています。解説記事のコードをそのまま貼る前に、使うバージョンの公式ドキュメントで引数名を確認してください。
実際に動かした例:小さなモデルでLoRA学習(2026年10月13日)
Qwen2.5-0.5B-Instruct に、LoRA(r=16・alpha=32・q/k/v/o_proj)を、学習データ24件・4エポック・バッチ4・学習率2e-4で追加学習しました。学習データは「案内文を丁寧な口調に直す」例を、この記事用に作ったものです。なお、この例はTRLではなく、Transformers+PEFTの素朴な学習ループで動かしています。
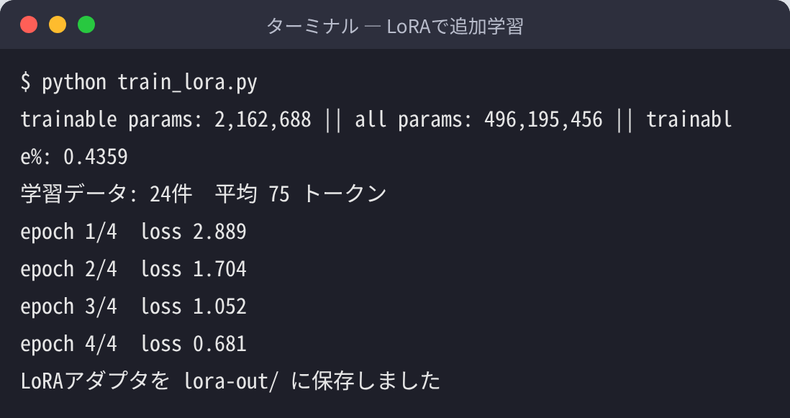
学習対象のパラメータは全体の約0.44%で、損失は2.889から0.681まで下がりました。ただし、損失が下がることと、出力が正しいことは別です。学習前後の出力の比べ方は、次の「評価のしかた」で示します。
ハイパーパラメータの決め方:まず公式の既定値から始める
ハイパーパラメータとは、学習の進め方を決める設定値です。決まった最適値はなく、各基盤が示す既定値から始めて、評価の結果を見て動かすのが基本です。Bedrock の公式ドキュメントも「既定のハイパーパラメータから始めることを推奨する」と書いています。主な設定の意味と、公式ドキュメントに書かれている既定値・範囲は次のとおりです。
| 設定 | 意味 | 公式ドキュメントの数値 |
|---|---|---|
| エポック数 | 学習データを何周するか。増やすほど学習データへの当てはまりが進み、過学習のリスクも上がる | TRL の既定は3.0。Bedrock は Nova が1〜5(既定2)、Llama 3.1/3.2 が1〜10(既定5)、Claude 3 Haiku が1〜10(既定2)。Bedrock は「小さなデータセットほど多くのエポックが必要、大きなデータセットでは少なくてよい」と説明 |
| 学習率 | 1回の更新で重みをどれだけ動かすか。大きすぎると不安定、小さすぎると進まない | TRL の既定は2e-5(アダプタの学習では1e-4前後を案内)。Bedrock は Nova が1e-6〜1e-4(既定1e-5)、Llama 3.1/3.2 が5e-6〜0.1(既定1e-4)。Vertex AI は「推奨値に掛ける倍率」で指定し、既定は1。Bedrock の Claude 3 Haiku も倍率で、既定1(0.1〜2) |
| バッチサイズ | 何件ずつまとめて更新するか。GPUメモリが足りないときは、小さくして勾配累積で補う | TRL の per_device_train_batch_size の既定は8、gradient_accumulation_steps の既定は1。Bedrock の Claude 3 Haiku は既定32(4〜256)、Llama 3.1/3.2 は1 |
| ウォームアップ | 学習の最初に、学習率を少しずつ上げていく区間 | Bedrock の Nova は0〜100ステップ(既定10)。公式は、学習データが少ないときに大きなウォームアップを指定すると学習率が設定値に届かない恐れがあると注意 |
| LoRAのランク(r) | 追加する行列の大きさ。大きいほど表現力が上がるが、学習するパラメータも増える | PEFT の公式ドキュメントに推奨値の記載はなく、例では r=8(PEFT Quicktour)や r=16(PEFT「LoRA」)が使われている |
| 早期終了 | 検証データの損失が改善しなくなったら学習を止める | Bedrock の Claude 3 Haiku では、改善幅の閾値(既定0.001)と許容回数(既定2)を指定できる |
出典:TRL「SFT Trainer」、Bedrock「Custom model hyperparameters」、Vertex AI「Tune Gemini models」、PEFT Quicktour、PEFT「LoRA」(2026年10月29日確認)。
学習率だけを変えて比べた例
学習率だけを変えて、実際に比べました(2026年10月20日・Qwen2.5-0.5B-Instruct・LoRA r=16・学習データ24件・4エポック・実効バッチ4。表示の損失は学習データでの平均です)。小さなモデルと少ないデータでの例で、他のモデルにそのまま当てはまる数値ではありません。
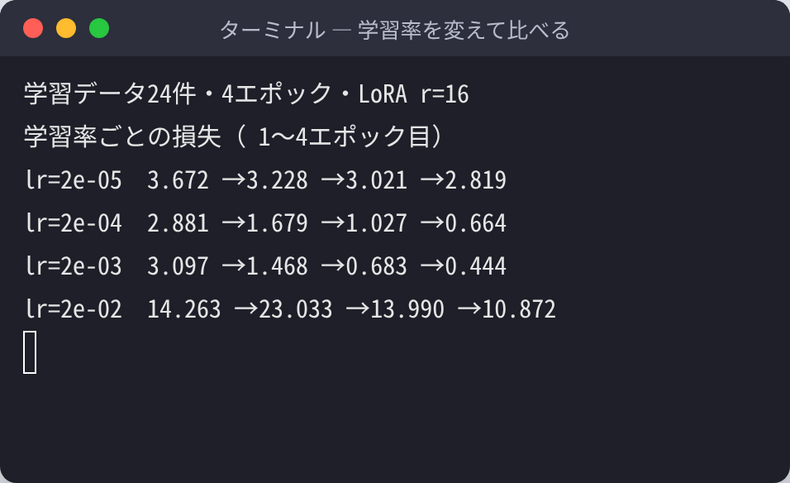
- 2e-5(低すぎる):3.672から2.819までしか下がらず、4エポックでは学習が進みきりません。
- 2e-4(出発点):2.881から0.664まで順調に下がりました。
- 2e-3:0.444とさらに下がりますが、これは学習データへの当てはまりが進んだだけです。評価データで確かめていないので、良いとは言えず、過学習の恐れがあります。
- 2e-2(高すぎる):14.263から23.033へ上がるなど、上下して下がらず、学習が不安定になりました。
損失が小さいほど良いとは限りません。評価データでの出力を見て選ぶのが基本です。
評価のしかた:学習前後を比べて、データと設定を直す
学習が終わったら、最初に取り分けた評価用データで確かめます。見るのは次の3点です。
- 学習前後の出力を並べて比べます:OpenAI の公式ドキュメントも、ファインチューニング済みモデルがもとのモデルより良いかを、取り分けたデータで比べるよう案内しています
- 検証データの損失を見ます:学習データの損失は下がり続けても、検証データの損失が上がり始めたら過学習のサインです。Vertex AI は検証用データセットを指定すると学習中に検証の指標が得られ、OpenAI(既存の利用者)はエポックごとのチェックポイントに検証損失(
full_valid_loss)などの指標が付きます。TRL はeval_strategyを指定すると、評価用データでの損失を記録します - 元の能力が落ちていないか確かめます:学習した仕事以外の簡単な質問でも出力を見ておきます(破滅的忘却の確認)
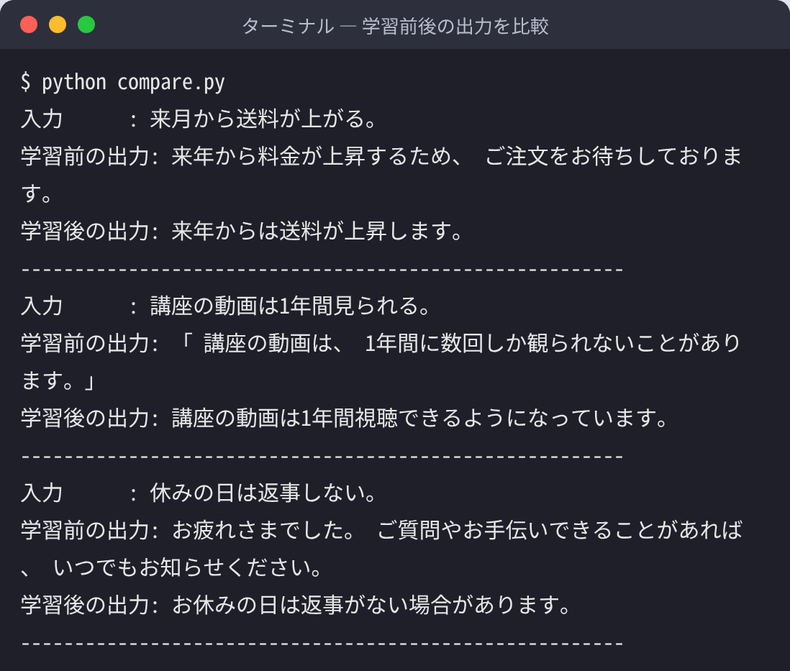
上の図は、前の節の小さなLoRA学習の評価です。学習後は口調が揃いましたが、元の文の意味が変わった例(「来月から送料が上がる」が「来年からは送料が上昇します」)もありました。小さなモデルと少ないデータで動かした例なので、口調の学習はできても内容の正確さまでは保証されません。損失だけを見ずに、出力を読んで確かめる理由がここにあります。
結果が良くなければ、まずデータを見直します(形式のばらつき、矛盾、件数の不足)。それから学習率とエポック数を動かします。一度に動かすのは1つの設定にして、評価データで同じ見方を続けてください。
保存と、ベースモデルへのマージ
PEFT で学習した結果は、追加した部分(アダプタ)だけが保存されます。PEFT の公式ドキュメントでは、LoRA を適用した facebook/opt-350m の例で、アダプタの重みのファイルは約6.3MBで、モデル全体の重み(約700MB)よりずっと小さいと説明されています。
# アダプタだけを保存
trainer.model.save_pretrained("./lora_adapter")

# ベースモデルにアダプタを重ねる
from peft import PeftModel
from transformers import AutoModelForCausalLM

base_model = AutoModelForCausalLM.from_pretrained("ベースモデルのID")
peft_model = PeftModel.from_pretrained(base_model, "./lora_adapter")

# 1つのモデルに統合して保存
merged_model = peft_model.merge_and_unload()
merged_model.save_pretrained("./merged_model")
merge_and_unload() は、アダプタの重みをベースモデルに合わせて、単独のモデルとして使えるようにする関数です。PEFT の公式ドキュメントは、遅延をなくすにはこの関数でマージするとしています(PEFT「LoRA」、Quicktour、2026年10月29日確認)。一般に、QLoRA で学習したアダプタをマージするときは、量子化していないベースモデルを読み込み直してから重ねます。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
画像生成モデルのファインチューニング:Stable Diffusion の DreamBooth と LoRA
テキストの言語モデルだけでなく、画像生成モデルも追加学習できます。Hugging Face の diffusers の公式ドキュメントでは、次のように整理されています(diffusers「DreamBooth」、2026年10月29日確認)。
| 手法 | 公式ドキュメントの説明 | 注意点 |
|---|---|---|
| DreamBooth | 特定の被写体やスタイルの数枚の画像で、拡散モデル全体を更新する手法。プロンプト中の特別な単語を、用意した画像と結びつける | 「学習のハイパーパラメータに非常に敏感で、過学習しやすい」と明記。生成した画像を使う prior preservation loss で、多様さを保つ方法もある |
| DreamBooth + LoRA | 学習するパラメータを大きく減らす手法。学習が速く、保存される重みも小さい(約100MB程度) | 専用のスクリプト(train_dreambooth_lora.py)が用意されている |
| テキストエンコーダも学習する | 画質を上げる選択肢。顔の生成で特に効果があると説明 | 24GB以上のGPUメモリが必要 |
公式のコマンド例では、被写体を表す特別な単語に sks を使い、--instance_prompt に「a photo of sks dog」のような文を指定します。GPUメモリが少ないときは、16GBなら 8-bit オプティマイザと gradient checkpointing、12GBならそれに加えて xFormers などを組み合わせると公式は説明しています。画像の学習でも、学習データの質、過学習、検証用プロンプトでの出力確認という手順は同じです。
うまくいかないときの原因と対処
| 症状 | 考えられる原因 | 対処 |
|---|---|---|
| 学習データの損失は下がるが、検証データの損失が上がる | 過学習 | エポック数を減らす、データを増やす・多様にする、LoRAのランクを下げる、早期終了を使う |
| 損失が下がらない、またはNaNになる | 学習率が高すぎる、数値精度の設定の不整合 | 学習率を一桁下げて再実行。bf16 と fp16 の設定を確認する |
| 指示を無視する、同じ言葉を繰り返す | 学習データの形式がバラバラ、チャットテンプレートとデータの不一致 | 形式をそろえ、使うモデルのチャットテンプレートに合う書式で学習する |
| 元の能力が大きく落ちた(破滅的忘却) | 学習率が高い、エポックが多い、特定の仕事のデータだけで学習した | 学習率とエポック数を下げる、LoRAに切り替える、元の能力を保つための一般的な例を少し混ぜる |
| GPUメモリ不足(OOM) | バッチサイズやトークン長が大きい | バッチサイズを下げて勾配累積を増やす、max_length を下げる、QLoRAにする(TRLの gradient_checkpointing は既定で有効) |
| 学習後も期待した出力にならない | データの件数や質が足りない、ファインチューニングでは解決しない課題 | データを見直す。最新の知識が必要な課題はRAGに切り替える |
| クラウドで「ジョブを作れない」 | OpenAI は新規ユーザーに提供されていない。Bedrock・Vertex AI はモデルとリージョンの対応が限られる | OpenAI は他の基盤か PEFT+TRL に切り替える。Bedrock・Vertex AI は公式の対応モデル表を確認する |
ファインチューニングの方法に関するよくある質問
Q. ファインチューニングのやり方(方法)を一言で教えてください。
A. JSONLで「入力と望ましい出力」の組を用意し、手法(フル・LoRA・QLoRA)とベースモデルを選び、クラウドの学習サービス(Vertex AI・Amazon Bedrock)か、Hugging Face の PEFT+TRL で学習し、学習に使っていないデータで学習前後を比べて評価します。
Q. 学習データは何件必要ですか?
A. 公式ドキュメントでは、Vertex AI が「まず100件から」、OpenAI(既存の利用者)が最小10件・推奨の出発点は50件、Bedrock の Llama 3.1/3.2/3.3 は合計100件以上、Claude 3 Haiku は最小32件とされています。Vertex AI は、データの質は量よりもはるかに重要だと明記しています(2026年10月29日確認)。
Q. 学習データの形式は何ですか?
A. 1行に1件を書いたJSONLです。TRL は messages(会話形式)・prompt と completion・text の形式に対応し、Bedrock は prompt/completion または Converse API 形式、Vertex AI は contents と parts を使います。
Q. OpenAI のAPIでファインチューニングを新しく始められますか?
A. 始められません。OpenAI の公式ドキュメントに、プラットフォームを終了する方向で、新規ユーザーは利用できないと記載されています。既存の利用者は 2027年1月6日まで学習ジョブを作成できます(2026年10月29日確認)。
Q. GPUがなくてもできますか?
A. Vertex AI や Amazon Bedrock の学習サービスは、自分でGPUを用意せずにコンソールやAPIから実行できます。費用は、Bedrock では学習データのトークン数 × エポック数に応じた学習費と、モデルの保存料です。
Q. LoRAとQLoRAのどちらを使えばよいですか?
A. GPUメモリに余裕があればLoRA、足りなければ4ビットに量子化して学習するQLoRAです。QLoRA論文は、65Bパラメータのモデルを1枚の48GB GPUで調整できると述べています。
Q. 学習率やエポック数はどう決めますか?
A. 各基盤の既定値から始めて、評価データでの結果を見て1つずつ動かします。たとえば TRL の既定は学習率2e-5・3エポック、アダプタの学習では1e-4前後が案内されています。Bedrock の公式ドキュメントも、既定値から始めることを推奨しています。
Q. ファインチューニングが向かない用途はありますか?
A. 最新の知識の追加は、再学習が必要になるため向きません。参照させたい資料が頻繁に変わる場合は、RAGを検討してください。
まとめ:ファインチューニングの方法
- 流れ:目的と評価方法を決める → JSONLで学習データを用意する → 手法とベースモデルを選ぶ → 学習を実行する → 評価して直す
- データ:1行に1件の「入力と望ましい出力」。最初は数十〜100件程度の質の高い例から(Vertex AI は100件、OpenAI は50件が出発点の案内)
- やり方:Vertex AI・Amazon Bedrock のクラウドか、PEFT+TRL の自分の環境。OpenAI は新規ユーザーに提供されていません
- 設定値:各基盤の既定値から始め、評価データの結果を見て1つずつ動かす
- 評価:学習に使っていないデータで、学習前後の出力と検証損失を比べる
仕組み・種類・プロンプトやRAGとの違いはファインチューニングとは、費用はファインチューニングの料金、無料で試す方法はファインチューニングを無料で試す、活用例はファインチューニングの事例を参照してください。
関連記事
LLM・ローカルLLMの業務導入をご検討の方へ
クリスタルメソッドは、オープンモデル・ローカルLLMの選定からRAG構築・PoC・本番導入までのAI開発を支援しています。「機密データを外部に出さずにLLMを使いたい」「自社の業務に合うモデルを選びたい」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
ファインチューニングを無料で始める方法と使えるツール・環境まとめ
ファインチューニングを無料で始める方法と使えるツール・環境まとめ 「ファインチューニングをやってみたいけど、コストが心配」という声はAI開発の現場でよく聞かれま...
-
ファインチューニングの料金とは?コストの全体像を把握しよう
ファインチューニングの料金とは?コストの全体像を把握しよう AIモデルのファインチューニングを検討するとき、最初に気になるのが「どれくらいの費用がかかるのか」と...
-
ファインチューニング事例|産業別・用途別の最新活用例と成果を徹底解説
ファインチューニング事例:産業別・用途別の最新活用例と成果を徹底解説 「ファインチューニングを実際にどう使っているのか、具体的な事例が知りたい」——そう感じてい...