
blog
AIブログ
ファインチューニング とは?仕組み・活用を分かりやすく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
ファインチューニングとは?一言でいうと何か
ファインチューニングとは、大量のデータで事前学習(プレトレーニング)済みのAIモデルに、特定の分野やタスク向けの少量データを追加で学習させ、モデル内部のパラメータ(重み)を微調整して専門特化させる手法です。ゼロから学習し直すのではなく、賢い汎用モデルを土台にして「自分の用途に合わせて仕立て直す」イメージが最も近い理解です。
- 事前学習との違い:ゼロから学ばせるのではなく、学習済みモデルの重みを出発点にするため、少ないデータ量と計算資源で特定タスクの精度を高められます。
- RAG(検索拡張生成)との違い:RAGは外部の知識を参照させるだけでモデル自体は変えませんが、ファインチューニングはモデルの重みそのものを更新し、口調・文体・出力形式といった「振る舞い」を根本から変えられます。
- 代表的な手法:全パラメータを更新するフルファインチューニングと、LoRAに代表される一部パラメータだけを効率的に更新するPEFT(軽量な追加学習)があり、目的とリソースに応じて選び分けます。
この記事では、ファインチューニングが何をしているのか(仕組み)、RAGやプロンプトの工夫とどう使い分けるのか、LoRAなどの手法、進め方、費用、2026年10月時点の提供状況を、初めての方にも分かるように順番に説明します。進め方の節では、小さなモデルをこの記事の執筆環境で実際に追加学習した画面を載せています。細かい手順・料金・事例は、本文中のリンク先の専用記事に分けています。
先に結論だけ:ファインチューニングは「モデルの振る舞い(口調・出力形式・特定タスクの精度)」を変える手段で、「最新の知識を参照させる」用途にはRAGのほうが向きます。まずプロンプトの工夫とRAGで足りるかを確かめ、それでも残る課題にだけ使うのが基本です。費用は、公開モデルをLoRAで学習するならGPU1枚から始められ、クラウドの学習サービスなら学習トークン数に応じた従量課金です。なお、OpenAIのAPIのファインチューニングは新規の利用者には提供されていません(2026年10月13日に公式ドキュメントで確認)。
関連記事ファインチューニングの手順は? / ファインチューニングを無料で始めるには? / ファインチューニングの料金はどれくらい?
ファインチューニングの仕組み:事前学習済みモデルを追加で学習させる
事前学習との違いを理解する
ファインチューニングを正しく理解するには、まず「事前学習(Pre-training)」との関係を押さえる必要があります。
事前学習は、インターネット上の膨大なテキスト・画像などを使い、「言語の構造」「概念の関係」「世界の知識」を汎用的に学習させるフェーズです。GPT-4やLLaMA、Geminiといったモデルはこの段階で数兆トークン・数百億パラメータ規模の学習を終えています。計算コストは莫大で、一般企業が一から実施することは現実的ではありません。
ファインチューニングは、その事前学習済みモデルが持つ「汎用的な知識」を土台にしたうえで、特定の用途・スタイル・ドメインに最適化するための追加学習です。必要なデータ量・計算コストは事前学習の数百〜数千分の一以下で済み、比較的小規模な組織でも実施可能です。
事前学習(Pre-training)
- 大規模な汎用データで学習
- 数週間〜数ヶ月・膨大なGPU
- 言語・知識・推論力を習得
- コスト:数億〜数百億円規模
ファインチューニング(Fine-tuning)
- 特定タスク・ドメインのデータで追加学習
- 数時間〜数日・少量のGPU
- 特定用途への最適化
- コスト:数万〜数百万円規模
特化型モデル(完成)
- 医療・法律・カスタマーサポートなど特定分野に強い
- 独自のトーン・スタイルを保持
- 少ないプロンプトで高精度な回答
転移学習との関係
ファインチューニングは転移学習(Transfer Learning)の一手法です。転移学習とは「ある課題で得た知識を別の課題に活かす」という広い概念であり、ファインチューニングはその中でも「既存モデルのパラメータを新しいデータで直接更新する」アプローチを指します。
転移学習にはほかに「特徴抽出(Feature Extraction)」もあります。これは事前学習済みモデルの重みを凍結(freeze)し、最終層だけを差し替えて学習させる手法です。ファインチューニングは全層または一部の層の重みを更新するため、より深い適応が可能な反面、データ量と計算コストをやや多く必要とします。
ファインチューニングが必要な場面:プロンプト・RAGとの使い分け
プロンプトエンジニアリングでは解決できないケース
生成AIを業務活用する際、まず検討すべきはプロンプトエンジニアリングです。指示の書き方を工夫するだけで多くの問題は解決でき、コストもほぼゼロです。しかしプロンプトで対処しきれない状況が存在します。
- 一貫したトーン・スタイルの維持:毎回詳細なシステムプロンプトを書かなくても、ブランドボイスを保った文章を生成させたい
- 非公開のドメイン知識の反映:社内規定・製品仕様・業界特有の用語をモデルに覚えさせたい
- 入出力フォーマットの固定化:特定のJSON形式・帳票レイアウトで必ず出力させたい
- 推論コスト・速度の最適化:小さなモデルをファインチューニングすることで、大型モデルと同等の性能を低コストで実現したい
- コンテキスト長の節約:Few-shotサンプルをプロンプトに詰め込む必要がなくなり、トークン消費を抑えられる
RAGとの使い分け
近年はRAG(Retrieval-Augmented Generation=検索拡張生成)もドメイン特化の有力な選択肢です。ファインチューニングとRAGは目的が異なり、多くの場合は組み合わせて使われます。RAGそのものの仕組みはRAG(検索拡張生成)とはで説明しています。
| 観点 | ファインチューニング | RAG |
|---|---|---|
| 目的 | モデルの振る舞い・スタイル・知識を変える | 最新・大量の外部情報を参照させる |
| 知識の更新 | 再学習が必要(頻繁な更新に不向き) | ドキュメントの更新だけでOK |
| 推論コスト | モデル本体が小さければ低い | 検索・埋め込みの追加コストが発生 |
| 適しているケース | 定型フォーマット、スタイル統一、特定タスクの精度向上 | 社内ドキュメント検索、最新情報への回答 |
| ハルシネーションリスク | データ品質次第で残存する | 根拠文書があるため比較的低い |
ファインチューニングのメリット(重要とされる3つの理由)
- 汎用モデルと自社業務の間には必ず「ずれ」がある:公開モデルは世の中の平均的な文章で学んでいるため、自社の用語・書式・判断基準をそのままでは再現できません。プロンプトで毎回補うか、モデル側に覚えさせるかの二択になり、頻度が高い業務ほど後者が合理的になります。
- 小さなモデルで済ませられる:特定の仕事に絞って学習させれば、小型モデルでも大型モデルに近い品質が出ることがあり、推論コストと応答速度を大きく改善できます。大量処理やオンプレミス運用では、この差が導入可否を左右します。
- データが競争力になる:モデル自体は誰でも使えますが、自社に蓄積された対応履歴・文書・評価データは他社にありません。ファインチューニングは、そのデータを「振る舞い」として製品やサービスに組み込む手段です。
一方で、知識を最新に保つ用途には向きません。「振る舞いを変えたいならファインチューニング、知識を参照させたいならRAG」という使い分けが前提です(上の表を参照)。産業別の活用例はファインチューニングの事例にまとめています。
ファインチューニングの主な手法
手法は「モデルのどの部分を、どれだけ更新するか」で分かれます。先に早見表で全体像をつかんでください。
| 手法 | 更新する範囲 | 必要なGPUメモリ | 向いている場面 |
|---|---|---|---|
| フルファインチューニング | 全パラメータ | 大(モデル全体+勾配) | 大きく性能を変えたい・資源が十分にある |
| LoRA | 元の重みは固定し、小さな追加行列だけ | 中(元の重み+追加分) | 実用上の主流。GPU1枚で始めたい |
| QLoRA | LoRAに加え、元の重みを4ビットに圧縮 | 小(LoRAよりさらに少ない) | 大きめのモデルを少ないメモリで |
| Prefix / Prompt Tuning | 入力に足す学習可能なベクトルだけ | 最小 | 複数タスクを軽く切り替えたい |
| RLHF / DPO | 好みの比較データで振る舞いを調整 | 手法による | 回答の好ましさ・安全性を高めたい |
フルファインチューニング(Full Fine-tuning)
モデルの全パラメータを更新する最もシンプルな手法です。データとタスクへの適応度が高い反面、以下の課題があります。
- 大規模モデルでは莫大なGPUメモリが必要(例:70Bモデルでは数百GBのVRAMが必要)
- 破滅的忘却(Catastrophic Forgetting)のリスク:特定タスクを学習した結果、元の汎用能力が劣化する
- 保存すべきチェックポイントのストレージが大きい
パラメータ効率的ファインチューニング(PEFT)
PEFT(Parameter-Efficient Fine-Tuning)は、モデルの大部分のパラメータを凍結したまま、ごく一部だけを更新することで、計算コストを大幅に削減する手法群の総称です。2022年以降、実用上の主流となっています。
LoRA(Low-Rank Adaptation)
2021年にMicrosoftの研究チームが発表した手法で(論文の初版は2021年6月公開)、現在最も広く使われているPEFT手法です。
LoRAのアイデアはシンプルです。モデルの重み行列 W を直接更新する代わりに、低ランクの行列分解 ΔW = A × B(AとBは元の行列より大幅に小さい)を学習させます。推論時はΔWをWに足し合わせるだけなので、追加の計算コストがほぼ発生しません。
LoRAの学習パラメータ削減効果(例)
GPT-3(175Bパラメータ)をフルファインチューニングした場合と比較すると、LoRAを適用した場合の学習パラメータ数は元の約0.01〜0.1%程度に圧縮可能。VRAMも大幅に削減でき、消費者向けGPU(RTX 4090等)でも7B〜13Bクラスのモデルをファインチューニングできる。
QLoRA(Quantized LoRA)
2023年にワシントン大学のチームが発表した手法で、LoRAに量子化(Quantization)を組み合わせています。モデルの重みを4ビット精度に圧縮してロードし、LoRAの追加パラメータはfloat16で学習します。これにより、65Bクラスのモデルを48GB未満のVRAMでファインチューニングすることが可能になり、アクセシビリティが飛躍的に向上しました。
そのほかのPEFT:Prefix Tuning・Prompt Tuning・Adapter Tuning
Prefix Tuning / Prompt Tuningは、モデルの重みは一切変えず、入力に付け足す「ソフトプロンプト」(学習できる連続値のベクトル)だけを最適化する手法です。学習するパラメータは極めて少なく、複数タスクへの同時対応が容易ですが、タスクによっては精度がLoRAに劣ることもあります。Adapter Tuningは、各トランスフォーマー層の間に小さな「アダプタ」を挿入し、そのモジュールだけを学習させます。元のモデルの重みは完全に保たれるため、複数タスクのモデルをコンパクトに管理できます。
RLHF(人間のフィードバックによる強化学習)
RLHF(Reinforcement Learning from Human Feedback)は、ChatGPTやClaudeなどの指示追従能力・安全性を高めるために採用された手法です。①人が作った指示と応答の組で教師あり学習(SFT)→②複数の応答を人が比較したデータで「応答の良さ」を予測する報酬モデルを作る→③その報酬を最大化するよう強化学習で調整する、の3段階で進めます。2023年以降は、比較データから直接最適化できるDPO(Direct Preference Optimization)が、実装が簡単で安定しているため多くの公開モデルで使われています。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
ファインチューニングの進め方:4ステップの流れ(実際に動かした画面つき)
進め方は、どの手法・どのモデルでも次の4ステップです。下の画面は、2026年10月13日にこの記事の執筆環境(Linux・GPU1枚=NVIDIA RTX 3090・Hugging Face transformers と peft)で、公開モデル Qwen2.5-0.5B-Instruct をLoRAで実際に追加学習して撮ったものです。学習データは、この記事のために作った「案内文を丁寧な口調に書き直す」24件の練習用データです。細かい設定やハイパーパラメータの調整はファインチューニングの方法で、無料で試せる環境はファインチューニングを無料で始める方法で説明しています。
ステップ1:目的とベースモデルを決める
まず、何を解決したいのかを明確にします。「カスタマーサポートの返答の口調をそろえたい」「特定の形式のレポートを生成させたい」など、目的によって適切なベースモデルと手法が変わります。2026年10月13日時点で選べる主な選択肢は次のとおりです。
- クラウドの学習サービス:Google Cloud の Vertex AI(教師ありファインチューニングは Gemini 2.5 Flash・2.5 Pro など公式が列挙するモデルに対応)、Amazon Bedrock(教師ありファインチューニング・強化学習ファインチューニング・蒸留)。インフラ不要で始めやすい一方、学習データを外部に渡す点を確認します。なお、OpenAIのAPIのファインチューニングは新規の利用者には提供されていません(後述)。
- 公開モデル(オープンウェイト):Meta の Llama 3.1/3.2、Google の Gemma 3、Alibaba の Qwen2.5/Qwen3、Mistral など。自社サーバーやクラウドのGPUで、データを外に出さずに学習できます。
- 日本語に強い公開モデル:LLM-jp(国立情報学研究所)、Swallow(東京科学大学)、Sarashina(SB Intuitions)、ELYZA、PLaMo(Preferred Networks)など。いずれも Hugging Face で公開されています(2026年10月13日確認)。
ステップ2:学習データを用意する(JSONL形式)
ファインチューニングの成否を最も左右するのがデータの質です。対話型モデルの追加学習では、「入力と理想の出力」の組を1行1件のJSONL形式で用意するのが一般的です。目的別に3つの例を示します。
例1:社内FAQ応答(口調と回答方針を揃える)
{"messages":[{"role":"system","content":"あなたは社内ヘルプデスクです。規程に基づき、丁寧に簡潔に答えます。"},{"role":"user","content":"出張の宿泊費の上限はいくらですか?"},{"role":"assistant","content":"国内出張の宿泊費上限は、就業規則第○条に定める区分に従います。該当する区分と上限額は人事ポータルの「出張規程」ページで確認できます。例外が必要な場合は事前に所属長の承認を得てください。"}]}例2:出力形式の固定(問い合わせ内容をJSONで構造化)
{"messages":[{"role":"user","content":"昨日注文した商品がまだ届きません。注文番号はA-1234です。"},{"role":"assistant","content":"{\"category\":\"配送遅延\",\"order_id\":\"A-1234\",\"urgency\":\"中\",\"next_action\":\"配送状況を確認して回答\"}"}]}例3:文体の統一(ブランドの口調に書き換える)
{"messages":[{"role":"user","content":"次の文を自社の案内文の口調に直してください:新機能を追加しました。使ってください。"},{"role":"assistant","content":"このたび新機能を追加いたしました。ぜひお試しください。"}]}今回の実演では、例3と同じ「文体の統一」の練習用データを24件用意しました。1件は system(役割の指示)・user(元の文)・assistant(望ましい書き直し)の3つの文で構成します。
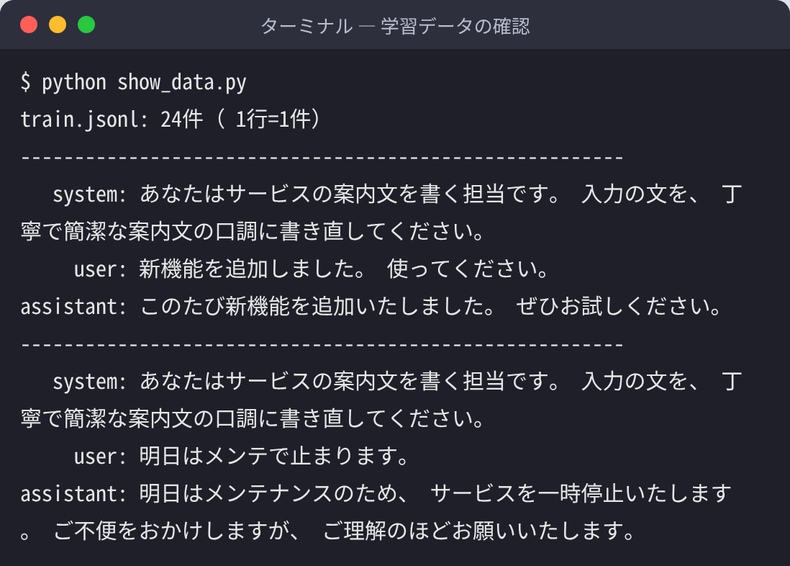
データ作成で重要なのは、量より一貫性です。ノイズのある1,000件より、回答方針・口調・形式が揃った100件のほうが良い結果を出すことが多く、似たパターンばかりだと汎化性能が落ちます。件数の目安は、スタイル調整なら50〜200件、新しいタスクの習得なら500〜2,000件、ドメイン知識の注入なら1,000件以上です(モデルやタスクによって大きく変わります)。個人情報や機密情報は学習前に必ずマスキングし、検証用のデータは学習用と分けて保管してください。
ステップ3:学習を実行する
公開モデルを手元やクラウドのGPUで学習するなら、Hugging Face の transformers+peft(LoRA/QLoRA)が標準的な環境で、より速い Unsloth や、設定ファイルだけで動く Axolotl もよく使われます。クラウドの学習サービス(Vertex AI・Amazon Bedrock)では、データをアップロードして学習ジョブを作る操作が中心で、GPUの用意は不要です。
下の画面は、Qwen2.5-0.5B-Instruct に LoRA(r=16)を当てて、24件のデータを4エポック学習させたときのものです。更新したパラメータは全体の約0.44%(約216万個)だけで、loss(学習の誤差)は 2.889 → 0.681 まで下がり、学習にかかった時間はGPU1枚で数秒でした(モデルとデータが小さいためです)。
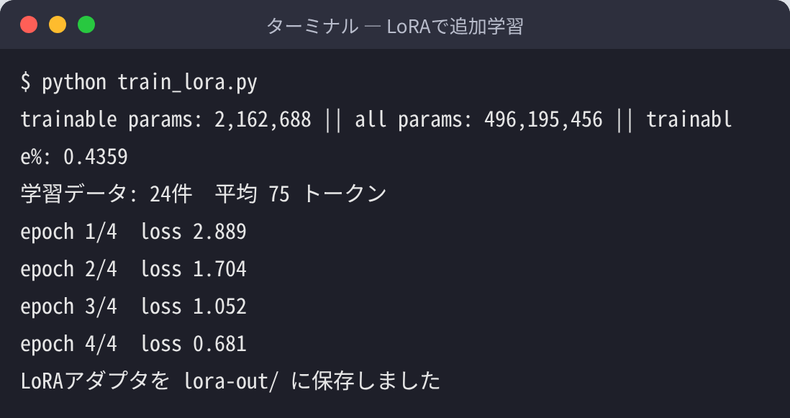
主なハイパーパラメータは次の4つです。それぞれの決め方はファインチューニングの方法で詳しく説明しています。
- 学習率(Learning Rate):事前学習より低い値が一般的。高すぎると既存の知識を壊す
- エポック数:過学習を防ぐため、少なめ(1〜5程度)から試す
- バッチサイズ:GPUメモリと相談して決める。勾配累積で実効バッチサイズを増やす工夫も有効
- LoRAのrank(r):8〜64が典型。rが大きいほど表現力が増えるがメモリを消費する
ステップ4:評価して、データと設定を直す
学習後は必ず、学習に使っていないデータで確認します。下の画面は、学習に使っていない3つの文を、学習前のモデルと学習後(LoRA適用)のモデルに同じ指示で書き直させたものです。
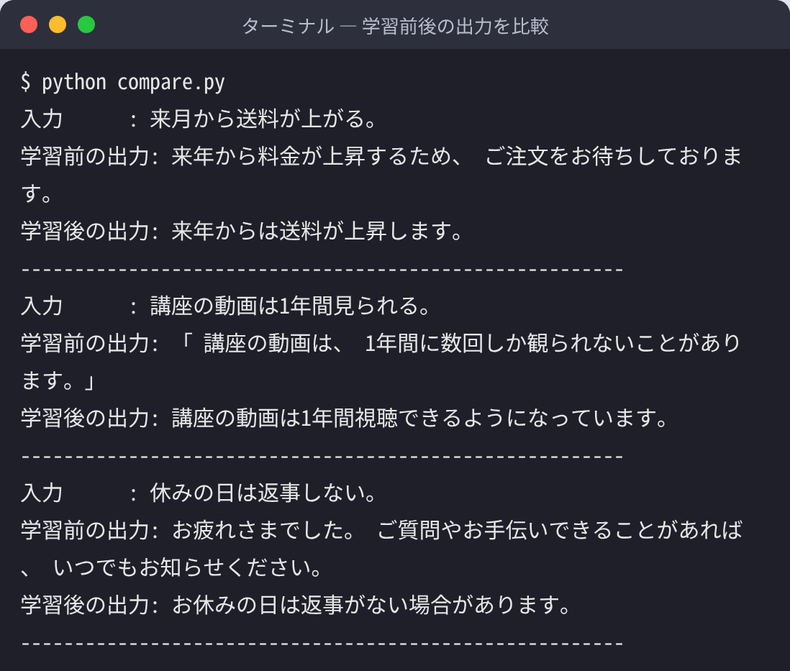
学習前は「ご注文をお待ちしております」のように指示と関係のない文を足していたのに対し、学習後は案内文らしい短い言い回しになっています。ただし「来月から」を「来年から」と書き換えるなど、内容の正確さはまだ不十分です。24件という少ないデータでは、口調は学べても中身の正確さまでは保証できないことが分かります。これが「評価して、データと設定を直す」工程が欠かせない理由です。確認する観点は次のとおりです。
- 検証ロス(Validation Loss)の確認:学習ロスは下がっても検証ロスが上がっていれば過学習のサイン
- タスク固有の指標:分類精度・BLEU・F1・人間による評価など
- ベースモデルとの比較:学習前後で同じテストセットに回答させて比べる(上の画面がこれにあたります)
- 回帰テスト:元の汎用能力が落ちていないかを確認する(破滅的忘却の検出)
実務ではどう使い分けるか:バーチャルヒューマン運用の例
対話型のバーチャルヒューマン(AIアバター)「DeepAI」は、AI面接練習や営業ロールプレイの現場で使われています。その運用で分かったのは、「口調・応答スタイルの一貫性」と「参照させたい知識の鮮度」は別の課題として切り分けると設計が安定する、ということです。キャラクターとして崩れない話し方や振る舞いはモデル側に定着させたい性質ですが、「どの企業のどの情報を踏まえて話すか」は頻繁に差し替わるため、後者を学習で焼き込むと更新のたびに再学習が必要になり、運用が硬直します。
そこで、企業ごとの模擬面接では、参照する知識の側をRAG(検索拡張生成)で外部化し、企業情報を都度読み込ませる構成を採っています。人物ごとの応答スタイルや役割の作り分けは、プロンプト設計と対話制御で担保できる範囲が広く、いきなり全層更新のファインチューニングに踏み込まないほうが、更新のしやすさ・検証の手間・情報漏えいの面で扱いやすいというのが運用上の実感です。
また、顧客の機密データを扱う案件では、外部のAPIに送らずローカルLLMを自社環境で運用しています。ファインチューニングを検討するときは「学習させたデータがモデルに記憶され、後から引き出される可能性」を前提に、学習に使う時点でマスキング・匿名化と閉じた実行環境をセットで設計することをおすすめします。まずRAGとプロンプト設計で解けないかを確かめ、それでも残る「振る舞いの定着」だけをファインチューニングに寄せる——この順序が、運用コストと安全性の両面で失敗を減らします。
次に読む:ファインチューニングの手順は?
ファインチューニングの応用分野
企業・ビジネスへの活用
ファインチューニングはさまざまな業種で使われています。主な活用パターンを以下に示します。産業別の具体例はファインチューニングの事例にまとめています。
| 業種・用途 | 具体的な活用例 | 期待効果 |
|---|---|---|
| カスタマーサポート | FAQデータでチャットボットを学習させ、ブランドボイスを統一 | 対応品質の安定化、応答速度向上 |
| 医療・ライフサイエンス | 電子カルテ・医学文献での専門用語を学習させた診断補助 | 専門用語の精度向上、誤訳の低減 |
| 法律・コンプライアンス | 契約書レビュー、判例データベースに特化したQAシステム | 作業時間の短縮、見落としリスク低減 |
| コード生成・開発支援 | 社内フレームワーク・コーディング規約を学習させた補完AI | コードレビュー工数の削減 |
| コンテンツ制作 | ブランドのトーン・語調・スタイルを学習した文章生成AI | コンテンツ量産の効率化 |
| バーチャルヒューマン | 特定キャラクターの口調・知識・応答スタイルを学習させた対話AI | 一貫したキャラクター体験の提供 |
画像・マルチモーダルモデルへの適用
ファインチューニングはテキストモデルに限りません。画像生成・認識モデルでも活発に活用されています。
- Stable Diffusion / FLUX のDreambooth・LoRAチューニング:特定の人物・スタイル・商品外観を数十枚の画像で学習させ、一貫したビジュアル表現を生成させる
- ViT(Vision Transformer)の画像分類チューニング:ImageNetで事前学習されたモデルを、製造業の外観検査や医療画像診断に特化させる
- マルチモーダルLLM(LLaVA、Qwen-VL等)のファインチューニング:テキストと画像を組み合わせた業務フロー、たとえば図面の読み取りや製品説明文の自動生成に活用
ファインチューニングの課題とリスク
破滅的忘却(Catastrophic Forgetting)
特定タスクへの最適化によって、モデルが事前学習で獲得した汎用的な能力を喪失する現象です。対策として、EWC(Elastic Weight Consolidation)などの正則化手法や、汎用データと特化データを混合して学習する「リプレイ法」、そもそも重みを凍結するPEFT系手法が有効です。
過学習(Overfitting)
学習データが少ない・エポック数が多すぎる場合、モデルが学習データを「丸暗記」してしまい、未知の入力への汎化性能が落ちます。検証データを常に分離し、アーリーストッピングを活用することが基本的な対策です。
データ品質と偏り
学習データに偏見・差別的表現・誤情報が含まれていると、ファインチューニング後のモデルはその偏りを増幅させる可能性があります。データのアノテーションガイドラインを整備し、レビュープロセスを設けることが不可欠です。
ライセンスと法的リスク
ベースモデルによってはファインチューニング後のモデルの商用利用が制限されている場合があります。また、著作権のある文書を無断で学習データに使用することは法的リスクを生じさせる可能性があります。使用するモデルのライセンス(Apache 2.0、Llama Community License等)と学習データの権利関係を事前に確認することが必要です。
情報漏洩リスク
機密情報を含むデータでファインチューニングすると、モデルがその情報を「記憶」し、特定のプロンプトで引き出される可能性があります。特に顧客情報・営業秘密を含むデータを扱う場合は、差分プライバシー(Differential Privacy)の適用や、データのマスキング・匿名化が推奨されます。
ファインチューニングのコストと現実的な見積もり
コストは「学習コスト」と「推論コスト」に分かれます。
| アプローチ | 学習コスト(目安) | 推論コスト | 向いているケース |
|---|---|---|---|
| クラウドの学習サービス(Vertex AI・Amazon Bedrock) | 学習トークン数×エポック数で課金(Vertex AIの公式料金ページの記載) | 各社の公式料金ページに従う | インフラ不要で早く試したい |
| QLoRA(7Bモデル、A100×1台) | 数時間〜十数時間(クラウド費:数千〜数万円) | 自社サーバーなら低コスト | データの自社保持が必要な場合 |
| フルファインチューニング(70Bモデル) | A100×8台以上・数十〜数百万円 | 高いGPUが継続的に必要 | 高精度・大規模タスクが必要な場合 |
上の表の金額は目安で、モデルの大きさ・データ量・エポック数で大きく変わります。参考までに、進め方の節で実演した0.5Bクラスのモデルでは、24件・4エポックの学習がGPU1枚で数秒で終わりました。量子化(QLoRA)を使えば7Bクラスでも1枚のGPUで学習できます。各社の料金の内訳と試算例はファインチューニングの料金で説明しています。
2026年10月時点の動向:OpenAIの終了と、ほかの選択肢
OpenAIはファインチューニング機能の新規受付を終了(2026年10月確認)
OpenAIの公式ドキュメントによると、OpenAIはAPIのファインチューニング機能(プラットフォーム)を段階的に終了しています。新しい利用者は使えなくなっており、これまで使っていた利用者は今後数か月の間は学習ジョブを作れます。すでに作ったファインチューニング済みモデルは、元になったモデルが廃止されるまで推論(回答の生成)に使えます。
終了前の時点で対応していた方法とモデルは、次のとおりです。
| 方法 | 内容 | 対応モデル |
|---|---|---|
| 教師ありファインチューニング(SFT) | 「入力と望ましい回答」の例を学ばせる、もっとも基本的な方法 | gpt-4.1/gpt-4.1-mini/gpt-4.1-nano |
| DPO(直接選好最適化) | 「良い回答」と「悪い回答」の組を見せて好みを学ばせる | gpt-4.1/gpt-4.1-mini/gpt-4.1-nano |
| 強化学習ファインチューニング(RFT) | 採点の基準を与えて、推論の質を高める(推論モデル向け) | o4-mini |
これからファインチューニングを始めるなら、ほかのクラウドが提供する仕組みか、公開モデルをLoRAなどで手元やクラウドで学習させる方法が選択肢になります。また、まずRAGやプロンプトの工夫で足りないかを確かめてから、ファインチューニングに進むのが現実的です(出典:OpenAI「Model optimization」、2026年10月13日確認)。
ほかのクラウドの選択肢:Vertex AI と Amazon Bedrock(公式の記載)
Google Cloud の Vertex AI では、Gemini モデルの教師ありファインチューニングに加えて、プリファレンス チューニング(好みの比較データで調整)と強化学習ファインチューニングが提供されています。教師ありファインチューニングの対象として公式が列挙するのは Gemini 3.5 Flash・3.1 Flash-Lite・2.5 Pro・2.5 Flash-Lite・2.5 Flash です。料金は「学習データのトークン数×エポック数」で決まると公式の料金ページに記載されています(出典:Vertex AI「モデルのチューニング」・同「料金」、2026年10月13日確認)。
Amazon Bedrock では、教師ありファインチューニング・強化学習ファインチューニング・蒸留(大きなモデルの応答を使って小さなモデルを学習させる)の3つのカスタマイズ方法が提供されています(出典:Amazon Bedrock「Customize your model」、2026年10月13日確認)。対応モデルや料金は各社の公式ページで最新を確認してください。
小さなモデルの高性能化・合成データ・継続学習(2024年以降の流れ)
2024年以降、スマートフォンやエッジ端末でも動く小型の公開モデル(Llama 3.2 の 1B・3B、Gemma 3 の 1B、Qwen3 の 0.6B など)が増え、小さなモデルを自分の用途に合わせて追加学習する選択肢が現実的になりました。オンデバイスでの処理は、プライバシー保護・低遅延・オフライン利用の面で、医療・製造・金融分野で注目されています。
あわせて、大きなモデルに高品質な学習データを生成させる「合成データ」の活用(Microsoft の Phi シリーズなどが代表例)と、LoRAアダプタをタスクごとに差し替えて一つのベースモデルを使い回す「継続学習」の設計も広がっています。データ収集のコストが下がり、更新しやすい構成が取れるようになったことで、ファインチューニングは「大規模なGPUがないとできない技術」から「標準的なMLOpsの一部」に近づいています。
ファインチューニングのよくある質問
Q. ファインチューニングとRAGの違いは何ですか?
A. ファインチューニングはモデルの重みそのものを追加学習で更新し、口調・出力形式・専門知識といった「振る舞い」を変える手法です。RAG(検索拡張生成)はモデルを変えず、外部のドキュメントを検索して参照させる手法で、最新情報や大量の社内文書への回答に向きます。知識を頻繁に更新するならRAG、定型フォーマットやスタイル統一・特定タスクの精度向上ならファインチューニングが適しており、実務では両者を組み合わせることが多いです。
Q. ファインチューニングの欠点・リスクは何ですか?
A. 主なリスクは、特定タスクに最適化しすぎて汎用能力を失う「破滅的忘却」、学習データが少ないときに起きる過学習、学習データの偏りや誤情報の増幅、ベースモデルのライセンスや学習データの著作権に関する法的リスク、機密情報をモデルが記憶してしまう情報漏洩の5つです。PEFT(LoRA等)で更新範囲を絞る、検証データを分離してアーリーストッピングを使う、データのマスキングやレビュー体制を整えることが基本の対策になります。
Q. ファインチューニングの費用はどのくらいかかりますか?
A. 費用は「学習コスト」と「推論コスト」に分かれます。クラウドの学習サービス(Google Cloud の Vertex AI など)は学習データのトークン数×エポック数で課金され、7Bクラスの公開モデルを QLoRA で学習する場合はGPU1枚で数時間〜十数時間、クラウド費で数千〜数万円程度、70Bクラスのフルファインチューニングは A100 8台以上で数十〜数百万円規模が目安です。なお、OpenAI のAPIのファインチューニングは新規の利用者には提供されていません(2026年10月に公式ドキュメントで確認)。
Q. どんな場面でファインチューニングが必要になりますか?
A. プロンプトの工夫だけでは解決できない場面です。具体的には、毎回長いシステムプロンプトを書かずにブランドの口調を保ちたい、社内規定や製品仕様などの非公開知識を覚えさせたい、特定のJSON形式や帳票レイアウトで必ず出力させたい、小さなモデルで大型モデル並みの性能を低コストに実現したい、Few-shot例をプロンプトに詰め込んでトークン消費を抑えたい、といったケースです。まずプロンプトエンジニアリングを試し、それでも足りないときにファインチューニングを検討します。
Q. 学習データはどのくらい必要ですか?
A. スタイルや口調の調整なら50〜200件、新しいタスクの習得なら500〜2,000件、ドメイン知識の注入なら1,000件以上が目安ですが、モデルやタスクによって大きく変わります。件数より、回答方針・口調・形式が揃っていることのほうが重要です。この記事で実演した24件の学習では、口調は学べても内容の正確さまでは保証できませんでした。
Q. LoRAとは何ですか?
A. LoRA(Low-Rank Adaptation)は、モデルの元の重みは固定したまま、小さな追加の行列だけを学習するファインチューニングの手法です。更新するパラメータが全体の1%未満で済むため、GPU1枚でも学習でき、学習結果(アダプタ)も小さなファイルで保存・差し替えできます。元の重みを4ビットに圧縮してさらにメモリを減らしたものがQLoRAです。
まとめ
ファインチューニングとは、事前学習済みモデルの豊かな知識を土台に、特定のタスク・ドメイン・スタイルへ最適化するための追加学習技術です。フルファインチューニングからLoRA・QLoRA・RLHFまで手法は多様で、目的・コスト・データ量に応じた使い分けが重要になります。
実践するうえでは、データ品質の確保が成否を最も左右します。学習・評価・改善のサイクルを回しながら、破滅的忘却・過学習・データ偏りのリスクに注意して進めることが大切です。
2026年10月時点では、OpenAIのAPIのファインチューニングが新規の利用者には提供されない一方、Vertex AI や Amazon Bedrock の学習サービス、そして公開モデルをLoRAで学習する方法が整っています。この記事で実演したように、小さなモデルならGPU1枚で数秒〜数分で試せます。まずプロンプトとRAGで足りるかを確かめ、それでも残る「振る舞い」の課題にファインチューニングを使う、という順序で進めてください。
関連記事
監修
河合 継(クリスタルメソッド株式会社 代表取締役)
AI・ディープラーニングに関する特許16件の発明者。過去、国立がん研究センターとの共同研究や、テレビ番組でのAI解説実績を持つAI研究者として、AIの研究開発を主導している。
運営会社について | 編集方針
Read next
あわせて読みたい
-
ファインチューニングの方法|手順・手法・ハイパーパラメータ調整まで解説【2026年版】
ファインチューニングとは何か:まず全体像をつかむ ファインチューニング(Fine-tuning)とは、大規模な事前学習済みモデル(Pre-trained Mod...
-
ファインチューニングを無料で始める方法と使えるツール・環境まとめ
ファインチューニングを無料で始める方法と使えるツール・環境まとめ 「ファインチューニングをやってみたいけど、コストが心配」という声はAI開発の現場でよく聞かれま...
-
ファインチューニングの料金とは?コストの全体像を把握しよう
ファインチューニングの料金とは?コストの全体像を把握しよう AIモデルのファインチューニングを検討するとき、最初に気になるのが「どれくらいの費用がかかるのか」と...