
blog
AIブログ
GPT Imageとは?最新モデルGPT Image 2.5・2の特徴・使い方・料金・無料枠を解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
GPT Imageとは?――OpenAIの画像生成モデルシリーズ(最新はGPT Image 2.5・2)
GPT Imageは、OpenAIが提供する画像生成AIモデルのシリーズです。文章で指示して画像を作る「生成」と、すでにある画像を指示どおりに直す「編集」ができ、ChatGPTの画面とAPIから使えます。2026年10月28日時点の最新世代は、2026年9月8日に公開されたGPT Image 2.5(gpt-image-2.5-sunburst/gpt-image-2.5-flare)で、その前の世代が2026年4月21日公開のGPT Image 2(gpt-image-2)です。
| モデル | 公開日 | 公式の位置づけ | 提供終了 |
|---|---|---|---|
| GPT Image 2.5 Sunburst | 2026年9月8日 | 編集の精度を重視するワークフロー向け | 終了予定の記載は確認できず |
| GPT Image 2.5 Flare | 2026年9月8日 | 速く高品質な日常の画像生成向け | 終了予定の記載は確認できず |
| GPT Image 2 | 2026年4月21日 | 任意サイズ、高忠実度の画像入力、トークン課金に対応 | 終了予定の記載は確認できず |
| GPT Image 1.5 | 2025年12月16日 | 旧モデル(後継は2.5) | 2026年12月1日 |
| GPT Image 1 Mini | 2025年10月6日 | 低コスト版の旧モデル(後継は2.5) | 2026年12月1日 |
| GPT Image 1 | 2025年4月23日 | 初代(後継は2.5) | 2026年10月23日 |
出典:OpenAI公式の変更履歴(Changelog)と廃止予定表(Deprecations)。確認日:2026年10月28日。
ChatGPT上の名称とAPIのモデル名の対応
ChatGPTの画面ではシリーズ名が「ChatGPT Images」、APIでは「gpt-image-…」という名前で呼ばれ、世代の数字がそろっています。OpenAIの開発者コミュニティの公式告知によると、2026年4月21日に「ChatGPT Images 2.0」とともにAPIでgpt-image-2が公開されました。OpenAIのリリースノートには、2026年9月8日付で「ChatGPT Images 2.5」が載り、同じ日にAPIでGPT Image 2.5のSunburstとFlareが公開されています。画面で実際にどのモデルが使われるかはプランや画面の表示で確認してください。
出典:OpenAI Developer Community「Introducing gpt-image-2」、OpenAIのChatGPTリリースノート、OpenAI APIの変更履歴。確認日:2026年10月28日。
できることは大きく4つです。①画像の中に文字を入れる、②会話で「背景だけ変えて」のように部分的に直す、③マスクで直す範囲を指定する、④参考画像を渡して複数枚をまとめて作る。それぞれの使い方・仕様・料金は、このあとの「使い方」と「仕様と料金」で順に説明します。旧モデルのGPT Image 1.5・1やDALL-E 3との違いは、後半の「旧モデルとの違いと提供状況」にまとめています。
そもそも画像生成AIの仕組みや著作権の注意点は、画像生成AIとは?仕組み・種類で解説しています。
GPT Imageの使い方――ChatGPTとAPI、無料で使えるか
方法①:ChatGPT(ノーコード)
最も手軽な利用方法は、ChatGPT(Plus・Pro・Businessプランなど)上で画像生成を依頼する方法です。2025年12月には、GPT Image 1.5がChatGPTの既定の画像生成モデルとして導入されました。その後、OpenAIのリリースノートには2026年9月8日付で「ChatGPT Images 2.5」が載っています(ChatGPTの画面で実際に使われるモデル名は、プランや画面の表示で確認してください)。
- ChatGPT(chatgpt.com)にログイン
- テキストボックスに画像生成の依頼を日本語で入力(例:「夕暮れの東京タワーと富士山を背景にしたイラスト風の画像を作って」)
- 自動的に画像生成モデルが呼び出され、画像が生成される
- 「背景をもう少し暗くして」「左にビルを追加して」など、会話形式で編集指示を続けられる
- 生成画像をクリックしてダウンロード
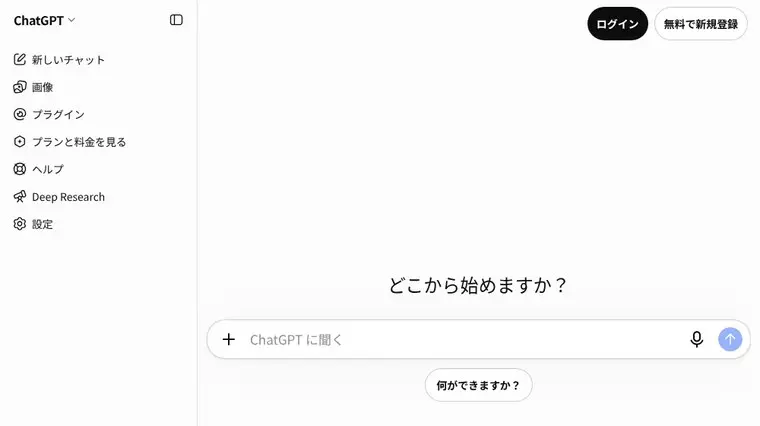
ChatGPT利用時の注意点:サブスクリプションプランによって1日あたりの生成枚数に上限があります。また、ChatGPT UIでは品質設定や解像度設定をユーザーが直接指定しにくい場合があります(UIのバージョンにより変動)。細かいパラメータ制御にはAPIが適しています。
無料で使えるか、無料枠の上限
- ChatGPT:OpenAIのヘルプ(ChatGPT Free Tier FAQ)では、無料プランでも画像の作成が使え、画像作成にはテキストのチャットとは別の利用上限があると説明されています。上限に達すると案内が表示され、上限がリセットされるまで待つ形です。現在の具体的な枚数は公式に記載なしです(確認日:2026年10月23日)。2024年8月のリリースノートには「無料ユーザーは1日2枚まで」という展開が載っていますが、当時のDALL·E 3の話で、現在の数字ではありません。画面に表示される残りの上限とリセット時刻が確実です。
- Instant/Thinking:OpenAIの料金ページ(Plans and Pricing)の比較表では、「Thinkingによる画像生成」はPlusとProで使え、FreeとGoでは使えないとされています(確認日:2026年10月23日)。無料では、通常の(Instant側の)画像作成が、上記の別枠の上限つきで使えます。
- API:画像生成は従量課金で、無料枠の記載は料金ページにありません。
- 生成にかかる時間:公式の画像生成ガイドは、遅延と費用はどちらも出力トークン数に比例し、大きいサイズ・高い品質ほど時間がかかると説明し、正方形が一般に最も速いとしています。秒数は公式に記載なし。本記事のAPI実行では約17秒でした(1536×1024・medium)。
方法②:API(開発者向け)
APIを使用すると、品質・解像度・枚数などを細かく制御でき、自社アプリケーションへの組み込みも可能です。
import base64
from openai import OpenAI

client = OpenAI()  # 環境変数 OPENAI_API_KEY を読む

result = client.images.generate(
    model="gpt-image-1.5",
    prompt="夕暮れの東京タワーとスカイライン、水彩画風",
    size="1536x1024",
    quality="medium",
    n=1,
)

# GPT Image の結果は URL ではなく base64 で返る
image_bytes = base64.b64decode(result.data[0].b64_json)
with open("tokyo.png", "wb") as f:
    f.write(image_bytes)
OpenAI公式の画像生成ガイドのとおり、GPT Image の結果は画像のURLではなく b64_json(base64の文字列)で返るため、上のようにデコードして保存します。
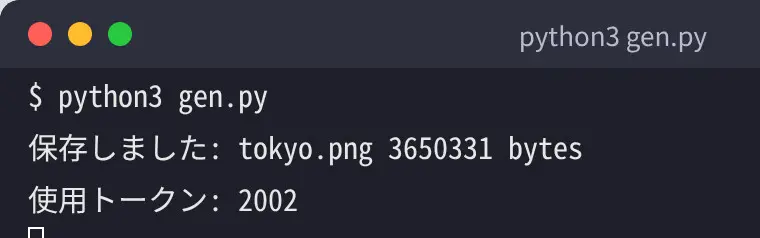
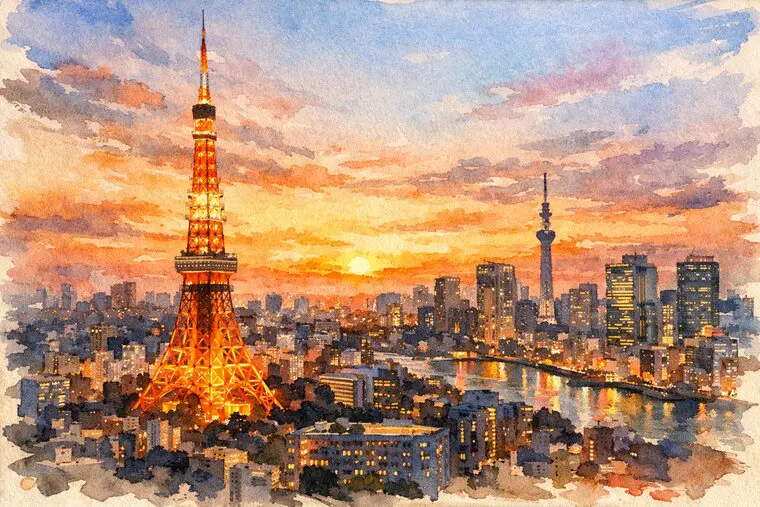
APIの主要パラメータは以下の通りです。
| パラメータ | 型 | 設定値 | 説明 |
|---|---|---|---|
| model | string | “gpt-image-1.5” | モデル指定(必須) |
| prompt | string | テキスト文字列 | 画像の内容を指示するプロンプト |
| size | string | “1024×1024” “1024×1536” “1536×1024” |
出力解像度 |
| quality | string | “low” / “medium” / “high” | 生成品質(コストに直結) |
| n | integer | 1〜10 | 一度に生成する枚数 |
| response_format | string | “url” / “b64_json” | レスポンス形式(URLまたはBase64) |
次に読む:DALL-Eとは?提供終了と移行・代替は?
GPT Image 2・2.5の仕様と料金――品質・サイズ・文字・編集・商用利用
品質設定(Quality)
GPT Image 1.5は生成品質を3段階で指定できます。品質設定はAPIパラメータとして渡すほか、ChatGPT UIでも選択可能です(UIの表現はバージョンにより異なる場合があります)。
| 品質レベル | APIパラメータ値 | 特徴 | 推奨ユースケース |
|---|---|---|---|
| Low | low | 高速生成(数秒)、細部は粗め | プロトタイピング、大量バッチ処理 |
| Medium | medium | 品質と速度のバランス | SNS投稿、ブログ用画像、日常業務 |
| High | high | 最高品質、生成に時間を要する | 商業印刷物、プレゼン素材、最終成果物 |
解像度(Size)
指定可能な解像度は3種類です。GPT Image 2では4K級までの大きな出力(最大辺3840px・総画素数は最大8,294,400)が使えるようになりましたが、GPT Image 1.5は最大1536×1536相当の出力となります。詳しい制約は次の「GPT Image 2・2.5のサイズ指定」で整理しています。
| 解像度 | アスペクト比 | 用途 |
|---|---|---|
| 1024×1024 | 1:1(正方形) | SNSアイコン、サムネイル、アイキャッチ |
| 1024×1536 | 2:3(縦長) | スマートフォン壁紙、縦型バナー、書籍カバー |
| 1536×1024 | 3:2(横長) | ブログヘッダー、横型バナー、プレゼン背景 |
GPT Image 2・2.5のサイズ指定――比率・上限・制約
2026年10月23日にOpenAI公式の画像生成ガイドで確認した内容です。GPT Image 2と、GPT-Image-2.5(sunburst/flare)では、1.5のような3サイズ固定ではなく、条件を満たす任意の「幅×高さ」を指定できます(2.5で任意サイズが使えることはガイドに明記されています)。
| 項目 | 公式の制約 |
|---|---|
| 推奨サイズ | 1024×1024/1536×1024/1024×1536 |
| 幅・高さ | どちらも16の倍数 |
| 最大辺 | 3840px以下 |
| アスペクト比 | 長辺:短辺が3:1以内(1:3〜3:1) |
| 総画素数 | 655,360以上、8,294,400以下(8,294,400が4K相当) |
| 2560×1440超 | 「experimental(実験的)」。この大きさを超えると結果のばらつきが大きくなると説明されています |
| size の既定値 | GPT Image 2は auto(既定)。正方形が一般に最も速いとされています |
| 品質(quality) | GPT Image 2は low/medium/high。2.5はこれに xhigh と max が加わります |
たとえば16:9のバナーなら1536×864のように、16の倍数で組めるサイズを選びます。サイズと品質を上げるほど出力トークンが増え、生成時間も費用も増えます。
画像内の文字(日本語を含む)はどこまで正確か
公式ガイドは、文字描画が「大きく改善された」一方で、文字の正確な配置や読みやすさでは今も苦戦することがあると説明しています。日本語についての精度の数値や保証は、公式ガイドに記載がありません(確認日:2026年10月23日)。このため、他社記事にある「約99%」といった数値は引用せず、次の運用をお勧めします。
- 入れたい文字は引用符「 」や” “で囲むか大文字で書き、フォント・大きさ・色・位置も条件として指定します(公式プロンプトガイドの「Text in images」)。
- ブランド名など間違えやすい語は、1文字ずつ綴りを書き出して指示する方法が、公式プロンプトガイドで紹介されています。
- 小さな文字、文字が多いパネル、複数のフォントを使う構成では、medium以上の品質を使うよう、同ガイドが勧めています。
- 日本語の漢字・かなは、生成のたびに目視で確認します。誤りがあれば、その文字だけ直す再編集(次項)か、後工程で文字を載せ替えます。
会話での部分編集と、マスクで範囲を指定する編集
編集には大きく2つの方法があります(出典:公式の画像生成ガイド、2026年10月23日確認)。
会話(マルチターン)で少しずつ直す
- Responses APIの画像生成ツールで、
previous_response_idを渡すか、前回の画像生成呼び出しの出力・ID を渡して、続きの指示を出します。 actionには auto/generate/edit を指定でき、画像が無い状態で edit を強制するとエラーになります。- 公式プロンプトガイドは、編集では「変えるのは○○だけ」「それ以外は同じまま」と書き、直すたびに「そのまま残すもの」を繰り返し書くと、意図しない変化(ドリフト)が減ると説明しています。一度に多くを頼まず、1回1か所ずつ直す進め方です。
マスクで編集する範囲を示す
- 元の画像とマスクは同じ形式・同じサイズで、どちらも50MB未満にします。
- マスクにはアルファチャンネルが必要です。白黒のマスクをアルファ付きに変換する方法が、公式ガイドのPythonの例にあります。
- 複数の画像を渡した場合、マスクは最初の画像に適用されます。
- マスクは「完全な切り抜き」ではなくプロンプトに基づく目安で、モデルがマスクの形を厳密には守らないことがあると、公式ガイドが説明しています。
- GPT-Image-2.5 sunburstの公式モデルページには、機能として「Inpainting」が挙げられています(モデルページ)。
キャラクターの一貫性と、複数枚の同時生成
- 複数枚:
nパラメータで1回のリクエストで複数枚を生成できます(既定は1枚)。ガイドで確認した範囲では、「最大8枚」のような上限の数値は示されていません。 - 参考画像:1枚以上の画像を参考として渡せます。公式プロンプトガイドは、各入力を「何番目の画像で、何が写っているか」で呼び分け、それらをどう組み合わせるかを書くよう勧めています。
- 一貫性:同ガイドは、顔や本人らしさの保持、キャラクターの一貫性、複数手順にわたる作業が得意だと説明し、絵本のように「キャラクターがぶれては困る」作業では、再利用できる「キャラクターの基準(アンカー)」を最初に決める例を挙げています。一方で、画像生成ガイドの制限事項には、繰り返し登場するキャラクターやブランド要素の見た目を保つのが、まれに難しいことがあると書かれています。
- input_fidelity:GPT Image 2では
input_fidelityを指定しません(変更できません)。画像入力は常に高い忠実度で処理されるため、参考画像つきの編集は入力トークンが多くなることがあります。
プロンプトのコツ
- 文字は引用符か大文字で書き、フォント・大きさ・色・位置を条件にします。
- 配置を決めたいときは、「左上に○○、右下に△△」のように、場所ごとに箇条書きで指示します。
- 編集では「変えるのは○○だけ。それ以外は同じ」と書きます。
- 複数の画像を渡すときは、番号と中身で呼び分けます。
- 画風は、写真風・水彩風・ベクターイラスト風など、具体的な言葉で書きます。
1・3・4は公式プロンプトガイドの記載に基づく内容で、2と5は一般的な書き方の例です。
プロンプト例(そのまま使える書き方の見本)
バナー:「横長1536×864。春のセール告知バナー。中央に『春の新生活フェア』と日本語で1回だけ、太いゴシック体・白文字で大きく入れる。左下に『3月31日まで』を小さく。背景は淡いピンクの桜の写真風。文字以外の余計な文字は入れない。」
図解:「縦長1024×1536。3段階の流れ図。上から『1 申し込み』『2 審査』『3 利用開始』を、同じ大きさの角丸の四角で縦に並べ、間を下向きの矢印でつなぐ。文字は各四角の中央に黒で、背景は白。」
部分編集:「この画像の背景だけを夕暮れの空に変える。人物の顔・服・ポーズ、商品、文字の位置はすべてそのまま保つ。」
これらは書き方の見本で、公式ガイドから引用した文ではありません。結果は毎回違うため、文字を目視で確認してください。
価格(APIご利用の場合)
以下は2026年6月時点の参考価格です。OpenAIの公式価格ページで最新情報を必ず確認してください。ChatGPT PlusなどのサブスクリプションはAPIとは別課金体系です。
| 品質 | 解像度 | 1枚あたりの価格(USD) | 100枚あたりのコスト(USD) |
|---|---|---|---|
| Low | 1024×1024 | 約 $0.009 | 約 $0.90 |
| Medium | 1024×1024 | 約 $0.042 | 約 $4.20 |
| High | 1024×1024 | 約 $0.167 | 約 $16.70 |
| High | 1536×1024 / 1024×1536 | 約 $0.20 | 約 $20.00 |
※ 上記価格はOpenAI公式情報をもとにした参考値です。為替変動・プランによる割引・将来の価格改定により変動します。最新の確定価格はOpenAI公式サイト(platform.openai.com/pricing)でご確認ください。
GPT Image 2・2.5の価格、Batch API、商用利用
2026年10月23日に確認したOpenAI公式の料金ページとモデルページの内容です。上の表はGPT Image 1.5の2026年6月時点の参考値で、現行モデルの課金は「トークン単価」で示されています。
| モデル | 画像出力(標準) | 画像出力(Batch) | 画像入力(標準/Batch) |
|---|---|---|---|
| gpt-image-2.5-sunburst/flare | $30/100万トークン | $15/100万トークン | $8/$4 |
| gpt-image-2 | $30/100万トークン | $15/100万トークン | $8/$4 |
| gpt-image-1.5 | $32/100万トークン | $16/100万トークン | $8/$4 |
Batch APIの割引は、公式の変更履歴(Changelog)に、GPT Image 2のリリース時点で「Batch APIで50%割引」と書かれています。料金表のBatch単価も標準のちょうど半額です。Batch(v1/batch)は、GPT-Image-2.5 sunburstの対応エンドポイントとして、画像生成(v1/images/generations)・画像編集(v1/images/edits)と並んで公式モデルページに載っています。
1枚あたりの金額は、公式ガイドのGPT Image 2の例で、正方形/縦長/横長の順に次のとおりです。
| 品質 | 正方形 | 縦長 | 横長 |
|---|---|---|---|
| low | $0.006 | $0.005 | $0.005 |
| medium | $0.053 | $0.041 | $0.041 |
| high | $0.211 | $0.165 | $0.165 |
2.5はGPT Image 2と同じトークン単価ですが、トークン数は品質やモデルで変わるため同じ金額とは限らず、GPT Image 2用の見積もり計算機は2.5のトークン数を見積もれません。1枚あたりの金額は、サイズと品質を明示して実際に試すのが確実です。プロンプトや編集用の入力画像も別途課金されます。
商用利用:OpenAIの利用規約(個人向けの利用規約、およびAPIなどの法人向けのサービス契約)には、法律が認める範囲で、入力に関する権利は利用者に残り、出力は利用者が所有すると書かれています。ただし、出力が他の利用者のものと似ることがあり得ること、出力を競合モデルの開発に使えないことなどの条件もあります。著作権として保護されるかは各国の法律によるため、商標・肖像権などの第三者の権利は、この所有権の取り決めでは解決しません。他社のロゴや実在の人物に似た画像は、公開前に別途確認が必要です。実際の利用前に利用規約とサービス契約の条文を確認してください。
画像生成AIの業務活用をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
旧モデル(DALL-E 3・GPT Image 1.5・1)との違いと提供状況
GPT Image 1.5を検討する際に最も知りたいのは、「DALL-E 3から何が変わったのか」「GPT Image 2と何が違うのか」という点でしょう。以下の表で整理します。
| 比較項目 | DALL-E 3 (API削除済) |
GPT Image 1.5 (旧モデル) |
GPT Image 2 (2026年6月時点の最上位) |
|---|---|---|---|
| アーキテクチャ | 拡散モデル | 自己回帰 (GPT-5統合) |
自己回帰 (改良版) |
| 最大解像度 | 1024×1024 | 1536×1024 (約157万画素) |
最大辺3840px (総画素数は最大8,294,400=4K UHD相当) |
| 画像内テキスト精度 | △(誤字多め) | ◯(大幅改善) | ◎(さらに向上) |
| プロンプト忠実性 | ◯ | ◎ | ◎〜◎+ |
| 出力の一貫性 | ◎(安定) | ◯(ばらつきあり) | ◯〜◎ |
| 画像編集機能 | △(限定的) | ◯(会話で編集可) | ◎(高精度) |
| フォトリアル品質 | ◎(拡散の強み) | ◯(やや劣る場合あり) | ◎ |
| API利用可否 | ✗(2026年5月削除済) | ✓(利用可) | ✓(利用可) |
| 最低価格(1枚・USD) | — | 約 $0.009 | GPT Image 1.5より高い |
| ChatGPT既定モデル採用 | 〜2025年11月 | 2025年12月〜 | 上位プランで展開中 |
GPT Image 1.5とは――DALL-E 3の後継モデルを徹底解説
GPT Image 1.5は、OpenAIが開発した画像生成AIモデルです。従来のDALL-Eシリーズとは根本的にアーキテクチャが異なり、テキスト言語モデルと画像生成機能を単一のニューラルネットワークに統合した点が最大の特徴です。2025年12月にChatGPTの既定画像生成モデルとして自動導入され、実質的にDALL-E 3の後継として位置づけられています。
ここでは旧モデルGPT Image 1.5について、技術的な仕組みから具体的な仕様・価格、DALL-E 3や後継のGPT Image 2・GPT-Image-2.5との比較、実際の使い方、そして向き不向きまでを、できる限り具体的かつ中立的な視点で解説します。
OpenAIのImage APIには現在4モデルが存在します。GPT Image 1.5は「前フラッグシップ」で、その後にGPT Image 2(4K対応、2026年4月リリース)が出ています。さらに2026年10月23日時点のOpenAI公式のモデル一覧では、画像生成の最上位はGPT-Image-2.5 Sunburst/Flareで、公式の廃止予定表ではGPT Image 1.5は2026年12月1日に提供終了(後継はGPT-Image-2.5)とされています。新規プロジェクトではGPT-Image-2.5を前提に検討してください。なお、DALL-E 2およびDALL-E 3はAPIから2026年5月12日に削除済みです。
技術的な仕組み――なぜDALL-E 3と根本的に異なるのか
自己回帰モデルとしての画像生成
DALL-E 3は拡散モデル(Diffusion Model)をベースとしており、ノイズから画像を段階的に復元するアプローチを取っていました。これに対しGPT Image 1.5は自己回帰(autoregressive)モデルを採用しています。
自己回帰モデルとは、テキストにおいてトークンを左から右へ順に予測するのと同じ原理で、画像を構成するトークンを順次生成するアーキテクチャです。GPT Image 1.5はGPT-5のニューラルネットワークに統合されており、テキストトークンと画像トークンを同一のモデルが処理します。
↓ テキストエンコーダ
↓ ノイズ付加
↓ デノイジング(繰り返し)
↓ 画像出力
↓ 統合Transformerが処理
↓ テキスト+画像トークンを逐次予測
↓ 画像トークンをデコード
↓ 画像出力
LLM統合がもたらす3つの実用的メリット
テキスト言語モデルと画像生成が同一アーキテクチャに統合されることで、以下の具体的なメリットが生まれます。
- 画像内テキストの正確な描画:看板・ラベル・スライドなど、画像内に文字を挿入する際の誤字・文字化けが大幅に減少。DALL-E 3では「COFEE」のような誤字が頻出していましたが、GPT Image 1.5では言語モデルとしての文字知識がそのまま活用されます。
- 複雑な空間指示の遵守:「左上に赤いリンゴ、右下に青いカップ、中央に白いテーブルクロス」のような多要素の配置指示に対し、より高い忠実度を示します。
- 会話による既存画像の部分編集:「この画像の背景だけを夕暮れに変えて」「人物の服の色を青から赤に変更して」といった自然言語による編集が、会話の文脈を保ったまま実行可能です。
正直な限界:自己回帰モデルは拡散モデルに比べてテクスチャの細かさや写実的な質感表現で劣る側面があります。特に布の繊維感、肌の毛穴レベルの質感、複雑な反射光など、フォトリアルな静物撮影的品質ではGPT Image 2や一部の拡散ベースモデルに及ばない場合があります。
OpenAI Image APIの4モデル全体像と選び方
2026年6月時点でOpenAIのImage APIで利用可能な4モデルを整理すると、以下のようになります。GPT Image 1.5の位置づけをより明確に理解するために参照してください。
| モデル名 | ポジション | 最大解像度 | 価格帯 | 特記事項 |
|---|---|---|---|---|
| GPT Image 2 | 🥇 2026年6月時点のフラッグシップ(後継はGPT-Image-2.5) | 最大辺3840px(4K UHD相当) | 最高 | 2026年4月リリース。最高品質が必要な用途向け |
| GPT Image 1.5 | 🥈 前フラッグシップ | 1536×1024 | 中〜高 | 旧モデル。品質とコストのバランスが良い |
| GPT Image 1 | 旧世代 | 1024×1024 | 中 | 2026年10月23日に提供終了予定。新規利用非推奨 |
| GPT Image 1 Mini | エコノミー | 1024×1024 | 最低 | 大量生成・コスト最優先の用途向け最安モデル |
2026年10月23日の公式情報での更新:OpenAIのモデル一覧では、画像生成の最上位は GPT-Image-2.5 Sunburst(編集の精度を重視)と GPT-Image-2.5 Flare(速さを重視)です。公式の廃止予定表では、gpt-image-1 は2026年10月23日に、gpt-image-1.5 と gpt-image-1-mini は2026年12月1日に提供終了とされ、後継はどちらも GPT-Image-2.5 です。上の表は2026年6月時点の整理として残しています。
活用シーン・向き不向き・公開の歴史
旧モデルGPT Image 1.5が向くシーン(2026年12月1日の提供終了まで)
旧モデルGPT Image 1.5が苦手なシーン(正直な評価)
GPT Imageシリーズの公開の歴史
OpenAIの公式の変更履歴(Changelog)と廃止予定表(Deprecations)から、2026年10月23日に確認した順に並べます。
| 日付 | 出来事 |
|---|---|
| 2025年4月23日 | gpt-image-1を追加 |
| 2025年10月6日 | gpt-image-1-miniを公開(低コスト版) |
| 2025年12月16日 | gpt-image-1.5とchatgpt-image-latestを公開 |
| 2026年4月21日 | GPT Image 2を公開(任意サイズ、高忠実度の画像入力、トークン課金、Batch API 50%割引) |
| 2026年5月12日 | dall-e-2とdall-e-3をAPIから削除 |
| 2026年8月20日 | gpt-image-2で透過背景(プレビュー、pngまたはwebp出力) |
| 2026年9月8日 | GPT Image 2.5 SunburstとFlareを公開(xhigh・max品質) |
GPT Image 2の特徴として、公式の変更履歴とモデルページは、任意サイズの指定、高忠実度の画像入力、インペイント(部分編集)への対応を挙げています。2.5は、Sunburstが編集の精度を重視するワークフロー向け、Flareが速く高品質な日常の生成向けと説明されています。GPT Image 2.5は、GPT Image 2と同じトークン単価です。評価順位などの比較は、第三者の集計に左右されるため、ここでは取り上げません。
この表には、公式の変更履歴にある日付だけを載せています。ChatGPTで「4o画像生成」と呼ばれていた時期の日付は、今回確認した公式ページでは確認できていないため載せていません。
用途別の活用例――公式ガイドに載っている型
公式プロンプトガイドは、画像生成の用途を次のように分けて例を載せています(確認日:2026年10月23日)。SNS・資料・EC・広告バナーに当てはめると、次のとおりです。
| 用途 | 公式ガイドの該当する型 | ひと言のコツ |
|---|---|---|
| SNS・広告バナー | 広告(Ads)、画像内の文字入りの広告素材 | キャッチコピーは「1回だけ、はっきり読める形で」と指定する |
| 資料・スライド | インフォグラフィック、スライド・図表 | 文字量が多い場合は medium 以上の品質にする |
| EC・商品画像 | 透明背景の商品モックアップ、ライティングの変更 | 背景だけを変え、商品は「そのまま」と書く |
| 画像の中の文字の差し替え | 画像内の文字の翻訳 | 「文字以外はそのまま保つ」と書く |
| ロゴ・UI案 | ロゴ生成、UIモックアップ | 配置を箇条書きで指定する |
| 絵本・マンガ | 絵本の絵(キャラクター一貫性)、ストーリーのコマ割り | キャラクターの基準を最初に決める |
競合ツールとの立ち位置
GPT Image 1.5はOpenAIエコシステム内での統合性(ChatGPTとの会話連携、GPTsへの組み込みなど)が強みです。一方、画像品質の絶対値を追求するならMidjourney v7やStable Diffusion XL(ローカル運用)、Adobe Fireflyなど専門特化ツールも引き続き有力な選択肢です。特に写真品質の商業広告素材や精密なスタイルコントロールが必要な場合は、複数ツールの併用を検討することをお勧めします。
GPT Imageと他サービスの使い分け――Midjourney・Stable Diffusion・Imagen・Fireflyと比べて
DALL-E系やGPT Imageシリーズ内の違いは上で述べたとおりだが、実務で迷うのは「MidjourneyやStable Diffusion、GoogleのImagenと比べて、自分の用途ではどれを採るべきか」だ。ここではOpenAI以外の主要サービスとの立ち位置を1行で整理し、そのうえで選定の軸を示す。定義の解説ではなく、選ぶための材料としてまとめる。
主要サービスとの1行使い分け
| サービス | 強みと立ち位置(1行) | 主に向く場面 |
|---|---|---|
| GPT Image(2.5 / 2 / 1.5) | 画像内テキストの描画と指示追従に強く、APIでプログラム制御・会話編集しやすい。 | 自動化パイプラインへの組み込み、文字入りの図版・サムネ量産 |
| Midjourney | 芸術性・写真的な質感の作り込みに定評があるが、公式APIがなくWeb/Discord中心で自動化には不向き。 | 人が数枚をじっくり作るコンセプトアート・ビジュアル探索 |
| Stable Diffusion(SDXL等・ローカル) | オープンで自前ホスト可能。LoRA等で追加学習でき、大量生成をオフライン・低従量で回せる反面、構築とGPUが要る。 | 大量生成、独自スタイルの微調整、社内クローズド運用 |
| Google Gemini/Imagen | Googleエコシステムと統合、APIも提供。用途は近いが、日本語の画像内テキストは発展途上の面がある。 | Google Cloud/Workspace中心の環境、多言語案件 |
| Adobe Firefly | 学習データのライセンスをうたい商用利用の権利面を重視、Creative Cloudと統合。 | 権利クリアが最優先の制作現場、既存Adobeワークフロー |
※各サービスは頻繁に更新されるため、料金・提供モデル・API仕様は導入前に必ず公式で最新を確認すること。
選び方の軸――この4つで自分の用途に落とす
- 自動化するか、手作業か。 APIで生成を組み込み、記事サムネのように「同じテンプレで大量に揃える」なら、プログラム制御しやすいGPT ImageやImagen、ローカルSDが候補。人が数枚を吟味する制作ならMidjourneyやChatGPTのUIでも足りる。
- 画像の中に文字を入れるか。 ロゴ調の見出しやラベル入り図版など、画像内テキストの正確さが要る用途はGPT Imageが比較的得意とする領域。文字を入れない純ビジュアルなら選択肢は広がる。
- 商用利用の権利をどこまで重視するか。 生成物の権利面を最優先するならFireflyのように権利設計を前面に出すサービスが安心材料になる。いずれにせよ各サービスの利用規約は必ず確認する。
- コストと運用形態。 従量課金で手軽に始めるならクラウドAPI(GPT Image/Imagen)、大量生成を固定費・オフラインで回したいなら自前ホストのStable Diffusion、という分かれ方になる。
たとえば「記事のアイキャッチを、タイトル文字を焼き込みつつ同じトーンで継続的に量産する」といった用途は、上の軸でいえば①自動化する・②画像内テキストが要る、に該当し、APIで制御しやすいGPT Imageが噛み合いやすい。逆に一点物のアートワークを人手で追い込むならMidjourney寄り、と考えると迷いが減る。
図解・アイキャッチ制作でのGPT Image運用の勘所
クリスタルメソッドはAI・ディープラーニングの研究開発を手がける傍ら、自社コンテンツの図解やアイキャッチ画像の制作にOpenAIの画像生成モデル(gpt-image-2.5)を実際に利用しています。実運用のなかで得た、記事の各所では触れられていない実務的な勘所を共有します。
まず、GPT Imageは「一枚絵の美しさ」よりも「指示への忠実さ」で選ぶツールだと捉えると使い分けが明快になります。図解のように「配置」「文字の意味」「要素の関係」を正確に反映したい用途では、プロンプトで意図を言語化しきれるぶん狙いどおりの構図を得やすく、アイキャッチや説明図の下地づくりに向いています。一方で、写真のような質感や細部のリアリティを最優先する場面では別の選択肢を併用しており、記事本文の「苦手なシーン」の指摘は実感と一致します。
運用面での注意点は次の3つです。(1) 文字入りの図はそのまま完成品にしない――日本語テキストは崩れることがあるため、生成物は下地とみなし、文字は後工程で載せ替える前提で設計すると手戻りが減ります。(2) トンマナは初期に固定する――配色・画角・余白の指示をテンプレート化しておくと、記事シリーズ全体で統一感を保てます。(3) 費用と品質は用途で切り替える――量産する下地は軽い品質設定、主役の一枚は高品質と、目的に応じて設定を分けると無駄なコストを抑えられます。API利用時の課金体系は生成トークン量に依存するため、量産前の小さな検証が結果的に近道になります。
GPT Imageのよくある質問
GPT Imageとは何ですか。
OpenAIが提供する画像生成AIモデルのシリーズです。2026年10月28日時点の最新はGPT Image 2.5(2026年9月8日公開)、その前がGPT Image 2(2026年4月21日公開)です。
GPT Imageは無料で使えますか。
ChatGPTでは、OpenAIのヘルプ上、無料プランでも画像の作成は使え、テキストのチャットとは別の利用上限があるとされています。具体的な枚数は公式に記載がありません。APIは従量課金で、料金ページに無料枠の記載はありません(確認日:2026年10月23日)。
APIの料金はいくらですか。
公式の料金ページでは、GPT Image 2とGPT Image 2.5の画像出力は標準で100万トークンあたり30ドル、Batchで15ドルです。1枚あたりの金額はサイズと品質で変わります(確認日:2026年10月23日)。
GPT Image 1.5はいつまで使えますか。
OpenAIの廃止予定表では、2026年12月1日に提供終了で、後継はGPT Image 2.5(SunburstまたはFlare)とされています。GPT Image 1は2026年10月23日に提供終了の予定でした。
DALL-E 3は今も使えますか。
dall-e-2とdall-e-3は、2026年5月12日にAPIから削除されました(OpenAI公式の変更履歴)。
生成した画像は商用で使えますか。
OpenAIの利用規約には、法律が認める範囲で出力は利用者が所有すると書かれていますが、出力が他の利用者のものと似ることがあるなどの条件があります。詳しくは「仕様と料金」の商用利用の項を確認してください。
まとめ――GPT Image 2.5を前提に選ぶ/1.5を選ぶ条件
これから使うなら、GPT Image 2.5(または2)を前提に選ぶのが基本です。以下は、期限つきで使える旧モデルGPT Image 1.5を選ぶ条件の整理です。GPT Image 1.5は、DALL-E 3からOpenAIの画像生成が大きく転換したことを象徴するモデルです。拡散モデルから自己回帰モデルへの移行により、テキスト理解の深さ・画像内テキストの正確性・会話による編集のしやすさが実用レベルで向上しました。
ただし、2026年10月23日時点の最上位はGPT-Image-2.5で、GPT Image 1.5は2世代前のモデルです(2026年12月1日に提供終了予定)。GPT Image 2と比較すると最大解像度(4Kに非対応)や一部の細部品質で劣ります。一方でコスト面ではGPT Image 2より有利であり、1024×1024 Low品質なら1枚約$0.009という価格は大量生成ワークフローで魅力的です。
- ✅ DALL-E 3からの移行先を探している
- ✅ 画像内に正確なテキストを含む素材が必要
- ✅ 複雑なシーン構成・多要素のプロンプトを扱う
- ✅ 会話形式での繰り返し編集を多用する
- ✅ Large-scale(100〜1,000枚/日以上)の生成でコストを抑えたい
- ✅ OpenAIエコシステム(ChatGPT・GPTs・Assistants API)との統合が前提
- ❌ 4K以上の大判出力が必要 → GPT Image 2を選ぶ
- ❌ フォトリアルな静物・人物写真品質が最優先 → GPT Image 2または専門ツールを検討
- ❌ コスト最優先で品質は最低限でよい → GPT Image 1 Miniを検討
OpenAIのモデルラインナップは今後も更新が続く見込みです。GPT Image 1が2026年10月23日に提供終了予定であるように、モデルのライフサイクルは比較的短いため、プロダクションコードではモデル名をハードコーディングせず、設定ファイル等で管理することをお勧めします。APIの最新仕様・価格・提供状況についてはOpenAI公式ドキュメント(platform.openai.com/docs)を定期的に確認してください。
GPT Imageを使った画像生成AIの業務活用のご相談はこちら
クリスタルメソッドは、GPT Imageをはじめとする画像生成AIの業務導入を支援しています。「広告・資料制作にAI画像生成をどう活かせるか」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
DALL-Eとは?提供終了と移行・代替を解説【2026年版】
この記事では、DALL·Eとは何か、いまも使えるのか、後継は何か、同じことをいまどう実現するかを、OpenAIの公式ページで確認した内容にもとづいて、初めて調べ...
-
画像生成AI比較|おすすめ主要9サービスの料金・無料枠・商用利用をわかりやすく解説【2026年10月版】
画像生成AIのおすすめは、目的によって変わります。まず無料で試すならChatGPT(ChatGPT Images 2.5)・Gemini・Adobe Firef...
-
画像生成AIとは?仕組み・種類・できること・著作権の注意点をわかりやすく解説
画像生成AIとは、文章(プロンプト)や参考画像を入力すると、AIが新しい画像を自動でつくり出す技術です。大量の画像とその説明文を学習したAIが、学んだ特徴をもと...