
blog
AIブログ
LLM比較とは?意味・評価軸・選び方の基本をやさしく解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
「ChatGPTとGeminiとClaude、結局どれを選べばいいの?」「比較記事を読むほど分からなくなってきた」——この記事は、LLM(大規模言語モデル)の選定を任された方のための入口です。むずかしい専門用語は最小限にして、選び方の考え方・見るべき評価軸・最新の比較表・自社で決めるための手順までを一通り分かる状態にします。
クリスタルメソッドは、LLMを対話AI・バーチャルヒューマンに組み込んで運用している開発会社です。カタログスペックではなく「実際に業務に載せる」目線で解説します。各モデルの一覧スペックを先に見たい方は主要LLMのカタログ記事をどうぞ。
LLM比較とは?(結論)
LLM比較とは、ChatGPT(GPT)・Claude・Gemini などの大規模言語モデル(LLM)を、精度・料金・日本語の品質・一度に扱える文章量(コンテキスト長)・データの取り扱いといった同じ評価軸でそろえて比べ、自分の用途に合うモデルを選ぶことです。
ポイントは「一番性能が高いモデル」を探すことではなく、「自分の用途で必要な条件を満たすモデル」を選ぶことです。上位モデルは僅差で並ぶことが多いため、まず用途と評価軸を決め、次にその軸で候補を2〜3に絞ると迷わずに選べます。評価軸の詳しい見方と、比べても決めきれないときの割り切り方は、このあと順に解説します。
LLMとは何か、生成AIとどこが違うのかは、大規模言語モデル(LLM)の仕組みで解説しています。
関連記事国産LLMの性能・料金・用途は?
目的別の早見表:まず見る候補(結論を先に知りたい方へ)
「結局、自分の目的ならどこから見ればよいか」を先に知りたい方向けの早見表です。候補は、この記事の比較表と各社の公式ページ(2026年10月12日確認)にあるモデルです。ここで挙げるのは「最初に試す候補」で、決定ではありません。最終的には、あとの章の手順で自分のタスクを実際に流して決めます。
| 目的 | 最初に見る候補 | 見るポイント |
|---|---|---|
| 個人・少人数のチャット利用 | ChatGPT・Claude・Geminiのアプリ | 月額プランは3社とも数千円の同じ価格帯。同じ質問を無料プランで見比べる(「チャットで使う場合の月額プラン」の表) |
| 大量の定型処理・低コスト | GPT-6 Luna・Claude Haiku 5.5・DeepSeek-V4.1-Flash | 入力は100万トークンあたり$0.10〜0.30。安くてもやり直しが増えると合計は逆転するため、自社のタスクで確認する |
| 長い文書の読み込み | GPT-6の各モデル・Claudeの現行モデル・Gemini 3.8 Flash・DeepSeek-V4 | いずれも約100万トークン。長い入力で単価が変わるモデルがある(比較表の注意点の列) |
| 複雑な推論・コード | GPT-6 Astra・Claude Opus 5.5・Gemini 3.1 Pro | 上位クラスは標準クラスの2〜5倍の価格。失敗が許されない工程だけに絞る |
| 機密データ・自社サーバーで動かす | Llama 4・Qwen3.8・Gemma 4・Mistral | オープンウェイト。モデルは無料でもGPUなどの実行環境の費用が別にかかる |
| 日本語の業務文書 | 海外モデルと国産LLMの両方 | 日本語ベンチマークの順位より、自社の実際の文書で試した結果を優先する |
次に読む:大規模言語モデル(LLM)の一覧は?

拮抗して選べないときの割り切り方(比較を止める判断軸)
評価軸をそろえて比べても、上位モデルは僅差で並び「どれでも良さそう」に見える段階が必ず来ます。ここで比較を延々と続けても差は縮まりません。迷いを止めるための割り切り基準を、よくある分岐ごとにまとめました。
| 迷っている分岐 | 割り切りの基準(先に決める1つ) |
|---|---|
| 性能が僅差で選べない | ベンチマーク差ではなく「自社の代表タスク10件」を両モデルに実際に流し、出力を目視で比べる。数字が拮抗するなら、そのまま運用コストが安い方でよい。 |
| 日本語重視だが海外モデルも捨てがたい | 敬語・専門用語・長文要約など「実際に一番投げるプロンプト」で比較する。汎用ベンチの日本語スコアより、自社ドメインの再現性を優先する。 |
| 精度とコストのトレードオフ | 「その精度差がユーザー体験や業務に効くか」で判断。差が体感できない工程は安いモデル、失敗が許されない工程だけ上位モデル、と工程単位で分ける。 |
| 1モデルに絞るか複数併用か | まず1モデルで通しで動かす。ボトルネックが特定の工程に偏って初めて、その工程だけ別モデルへ切り替える。最初から多モデル前提にしない。 |
| 今のモデルを使い続けるか乗り換えるか | 乗り換えは「今のモデルで具体的に困っている事象」がある時だけ。新モデル登場そのものは乗り換え理由にしない(移行検証にも工数がかかる)。 |
比較を切り上げてよいサイン:候補が2〜3モデルに絞れ、自社の代表タスクで致命的な差が出ず、コスト・データ管轄・提供形態(API型かオープンウェイトか)の条件を満たしている――この3つがそろえば、それ以上の横並び比較は判断材料を増やしません。残りは実運用で確かめるフェーズに進むほうが速く決まります。
🔥 選び方はこう変わる(before → after)
- 今まで:「最強LLMランキング」を読み漁る → 記事ごとに順位が違って、決められない。
- これから:先に「自社で何を作るか」を決める → 用途から逆算すると、候補は自然と3〜5個に絞れる。
- 今まで:ベンチマークスコア1位を採用 → 日本語の業務文書でつまずいて本番後に発覚。
- これから:自社の実プロンプト20〜50件で並行テスト → 数字ではなく自社タスクの出来で決められる。
結論を先に言うと、「どのLLMが最強か」という問いに、用途抜きの答えは存在しません。この記事は「最強探し」を「自社に合う1本の特定」に切り替えるためのガイドです。
見るべき評価軸は5つ
性能だけで選ぶと、稟議は通っても現場運用で問題が出がちです。評価軸は次の5つに整理できます。
- (1)性能:ベンチマーク(MMLU・SWE-benchなど)は一次フィルターとしては有用ですが、測っているものがそれぞれ違います。日本語タスクなら、日本語ベンチマーク(例:Qualiteg社の日本語対応LLMランキング2026)と自社タスクでの直接評価が必要です。
- (2)コスト:APIのトークン単価だけでなく、処理量・プロンプト長・キャッシュ活用まで含めた月次の総所有コスト(TCO)で比べます。自前ホストならGPU・運用コストが乗ります。
- (3)日本語対応:「日本語が通じる」と「日本語業務に使える」は別問題です。敬語・専門用語・フォーマット指示への追従は、自社のプロンプトで検証するのが唯一確実な方法です。
- (4)プライバシー・データ管轄:データがどこで処理され、学習に使われないか。ここを後回しにすると稟議が通りません。
- (5)用途適合性:最終決定因子です。長文処理・コード・チャット・推論・エージェント——何を作るかで最適解が変わります(後述)。
主要LLM比較表:2026年時点の代表モデルと選定の観点
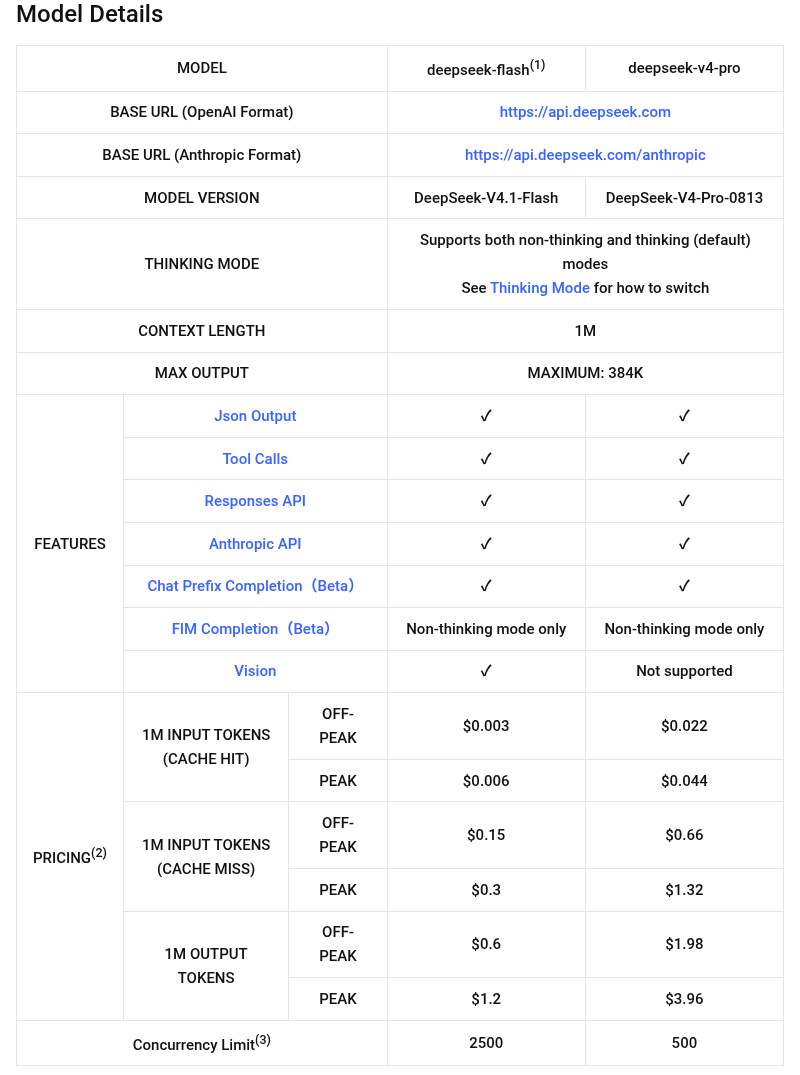
以下の比較表は、各社公式の料金ページとモデル一覧を2026年10月12日に確認して作成しました。料金・仕様は各社が随時更新するため、導入前に必ず各社公式ページで最新情報を確認してください。DeepSeekについては、開発元が中国企業であることから、機密性の高い業務データに使う場合は、データ管轄・規制コンプライアンスの観点で別途リスク評価が必要です。なお、各社の公式ページに「前の世代」として残っているモデル(Claude Opus 5・Sonnet 5、Gemini 3.6 Flash、GPT-5.6系など)は、この表には載せていません。
| モデル名 | 提供元 | コンテキスト長 | 入力料金 (/1Mトークン) |
出力料金 (/1Mトークン) |
形態 | 主な強み | 注意点 |
|---|---|---|---|---|---|---|---|
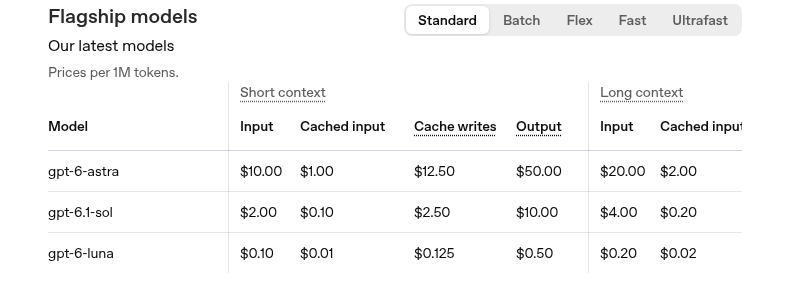
| GPT-6 Astra | OpenAI | 1,050,000 | $10.00(長いコンテキストの区分は$20.00) | $50.00(同$75.00) | クローズドAPI | 最上位。複雑な推論・コーディング向け | 高額。標準のGPT-6.1 Sol($2/$10)、軽量のGPT-6 Luna($0.10/$0.50)も同じ1,050,000トークン |
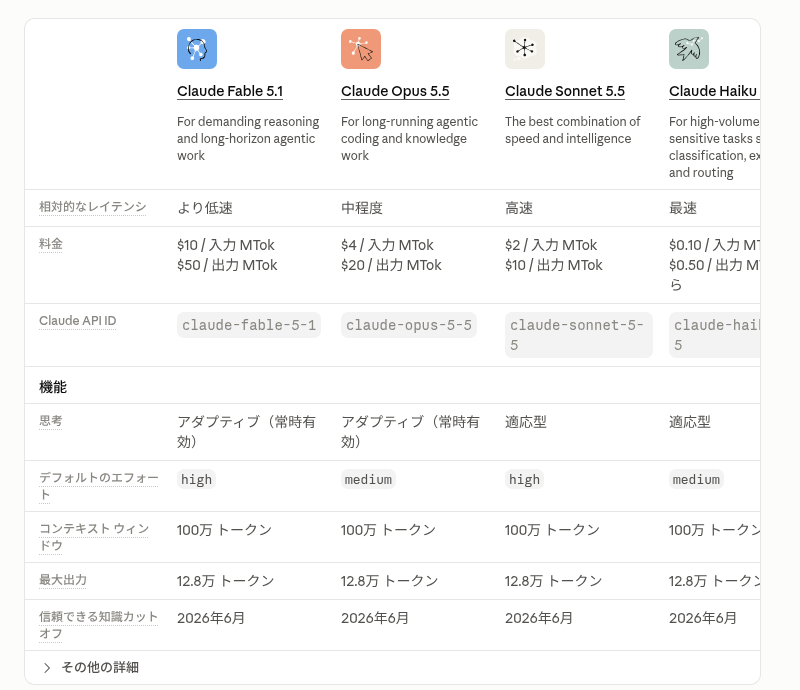
| Claude Sonnet 5.5 | Anthropic | 1,000,000 | $2.00 | $10.00 | クローズドAPI | 長文・安全性・コーディング | 上位にOpus 5.5($4/$20)とFable 5.1($10/$50)。日本語は用途次第で要検証 |
| Claude Haiku 5.5 | Anthropic | 1,000,000 | $0.10(入力10万トークンまで。超えると$0.50) | $0.50(同$2.50) | クローズドAPI | 軽量・大量処理・コスト | Sonnet比で精度は落ちる |
| Gemini 3.8 Flash | 1,048,576 | $0.75(2026年12月末まで。2027年1月から$1.50) | $3.75(同$7.50) | クローズドAPI | Flash系の最上位。エージェント・コーディング向け | 2027年1月1日から値上げ。無料枠あり | |
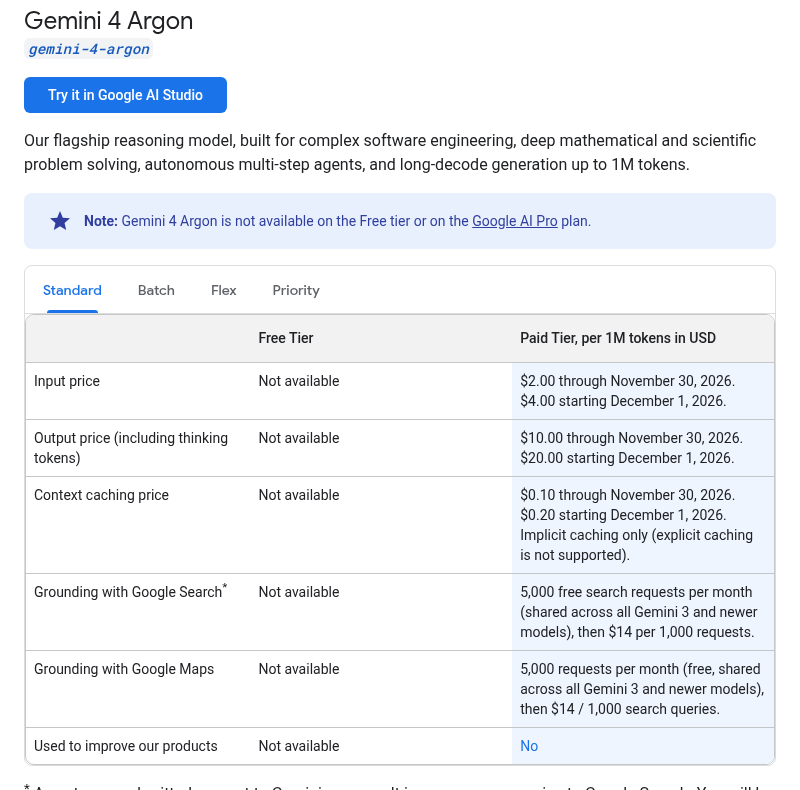
| Gemini 4 Argon | 約1,000,000(公式は「shared 1M context window」と記載) | $2.00(2026年11月30日まで。12月1日から$4.00) | $10.00(同$20.00) | クローズドAPI | Googleの旗艦の推論モデル。複雑なソフトウェア開発・数学や科学の問題・自律的な多段階のエージェント向け(公式の説明) | 12月1日から値上げ。無料枠なし、Google AI Proのプランでも使えないと公式に記載 | |
| Gemini 3.1 Pro(Preview) | 1,048,576 | $2.00(20万トークン超は$4.00) | $12.00(同$18.00) | クローズドAPI | マルチモーダルの理解・エージェント・コーディング向けのPro系 | 公式の一覧でも「Preview」の扱い。無料枠なし | |
| Llama 4(Scout・Maverick) | Meta | Scout:10,000,000 | 無料(セルフホスト) | 無料(セルフホスト) | オープンウェイト | プライバシー・オンプレ・FT自由度 | GPU環境整備・運用コストが必要。Metaの開発者向け公式ページの主役は、2026年10月12日時点でMuse Spark 1.3(Meta Model API)に移っている |
| Mistral Large 4 / Medium 3.5 / Small 4 | Mistral AI | 公式に記載なし | $0.50(Mistral Large。公式料金ページの例) | $1.50(同) | API+オープンウェイト(公式一覧:Large 4はOpen、Small 4・Ministral 3はApache 2.0、Medium 3.5はModified MIT) | 欧州GDPR対応・多言語・コーディング | 日本語精度はタスクにより要検証 |
| DeepSeek-V4.1-Flash / V4-Pro-0813 | DeepSeek | 1,000,000 | Flash $0.15〜0.30/Pro $0.66〜1.32 | Flash $0.60〜1.20/Pro $1.98〜3.96 | API+オープンウェイト(V4-ProはMIT) | 超低価格・推論モード対応 | 時間帯で料金が2段階(混雑する時間帯は2倍)。中国企業:データ管轄の慎重評価が必須 |
| Qwen3.8(27Bなど) | Alibaba | 262,144(最大1,000,000まで拡張。27B) | 無料(セルフホスト) | 無料(セルフホスト) | オープンウェイト(27BはApache 2.0) | コーディング・業務・調査・長い作業向けに強化(モデルカードの記載) | データ管轄の確認を推奨 |
| Gemma 4 | 128,000〜256,000 | 無料(セルフホスト) | 無料(セルフホスト) | オープンウェイト(Apache 2.0) | 端末・ブラウザ向けの小型から31Bまで。軽量・エッジ・研究・PoC | 小〜中型が中心。最上位のAPIモデルとは用途が違う |
※料金は標準のAPI料金(100万トークンあたり・米ドル)。出典:OpenAI・Anthropic・Google・DeepSeek・Mistral AIの各公式ページ(2026年10月12日確認)。コンテキスト長は各社の公式文書で確認できたものだけを載せ、確認できなかったものは「公式に記載なし」としています。オープンウェイトの「無料(セルフホスト)」はモデルの利用料が無料という意味で、GPUなどの実行環境の費用は別にかかります。各社が随時改定するため、導入前に公式ページで最新値を確認してください。
各社の公式ページの実際の画面です(2026年10月14日に撮影)。上の表の数字は、これらの画面と各社の公式文書で確認した内容です。
同じ提供元のなかの「上位・標準・軽量」を比べる
2026年10月12日時点では、主要3社とも「上位・標準・軽量」の3段階でモデルをそろえています。提供元を決めたあとは、この段階のどれを使うかで費用が大きく変わります。
| 提供元 | 上位 | 標準 | 軽量 |
|---|---|---|---|
| OpenAI | GPT-6 Astra($10/$50) | GPT-6.1 Sol($2/$10) | GPT-6 Luna($0.10/$0.50) |
| Anthropic | Claude Fable 5.1($10/$50)、Claude Opus 5.5($4/$20) | Claude Sonnet 5.5($2/$10) | Claude Haiku 5.5($0.10/$0.50) |
| Gemini 4 Argon($2/$10。12月1日から$4/$20) | Gemini 3.8 Flash($0.75/$3.75) | Gemini 3.5 Flash-Lite($0.30/$2.50) |
※かっこ内は「入力/出力」の100万トークンあたりの標準料金(米ドル)。OpenAIとAnthropicでは、上位と軽量で入力単価に40〜100倍の差があります(GPT-6 Astraの$10に対しGPT-6 Lunaは$0.10で100倍、Claude Opus 5.5の$4に対しClaude Haiku 5.5は$0.10で40倍)。Googleは、Gemini 4 Argonの$2に対しGemini 3.5 Flash-Liteが$0.30で約7倍です。
読み取れるのは次の3点です。
- 標準クラスはほぼ同じ価格帯:GPT-6.1 SolとClaude Sonnet 5.5はどちらも入力$2・出力$10で、料金では差がつきません。自社のタスクでの出来で選ぶことになります。
- 軽量クラスは入力$0.10まで下がっている:分類・要約・定型の応答のような量の多い処理は、軽量クラスで足りるかを先に試す価値があります。
- 上位クラスは標準の2〜5倍:失敗が許されない工程や複雑な推論だけに絞って使うと、費用を抑えられます。
チャットで使う場合の月額プラン(ChatGPT・Claude・Gemini)
システムに組み込むのではなく、チャット画面で人が使う場合は、API料金ではなく月額プランで比べます。主要3サービスの個人向けプランは次のとおりです(各社公式の料金ページ、2026年10月12日確認。ChatGPTとGeminiは日本向けページの円表示、Claudeはドル表示です)。
| サービス | 無料プラン | 個人向けの有料プラン(月額) | 上位プラン(月額) |
|---|---|---|---|
| ChatGPT(OpenAI) | あり | Go 月1,400円、Plus 月3,000円 | Pro 月16,800円から |
| Claude(Anthropic) | あり | Pro 月払い$20(年払いの割引では月$17) | Max 月$100から(使用量がProの5倍または20倍の2段階) |
| Gemini(Google) | あり | Google AI Plus 月725円、Google AI Pro 月2,900円 | Google AI Ultra 月14,500円から(上限が20倍の構成は月32,000円) |
個人向けの有料プランの中心は、ChatGPT Plusが月3,000円、Google AI Proが月2,900円、Claude Proが月払い20ドルと、3社とも月額数千円の同じ価格帯にそろっています。料金で差がつかないため、同じ質問を3つの無料プランに投げて回答を見比べ、自分の用途で使いやすいものを選ぶのが近道です。各サービスの詳しい内容はChatGPTの解説・Claudeの解説・Geminiの解説をご覧ください。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
用途別の選び方:何を作るかで最適解が変わる
- 長文・ドキュメント処理:2026年10月12日時点では、Gemini 4 Argon・Gemini 3.1 Pro(プレビュー)・GPT-6の各モデル・Claudeの現行4モデル・DeepSeek-V4が100万トークン級の入力に対応し、選択肢は広がりました。長い入力で単価が上がるモデルもあるため、比較表の「長いコンテキストの区分」の記載も確認します。
- コード生成・技術タスク:実際のGitHub issueの解決率を測るSWE-benchのような公開ベンチマークもありますが、測り方は指標ごとに違うため、最終的には自社のコードで試した結果で選びます。Claude Sonnet 5.5・GPT-6.1 Solなどの最新世代が候補です。
- チャットボット・サポート:レイテンシとコストが支配的です。Claude Haiku 5.5・GPT-6 Luna・Gemini 3.8 Flash・DeepSeek-V4.1-Flashなどの軽量帯から、自社タスクの精度で選びます。安いモデルで再処理が増えると実質コストは逆転します。
- 数学・複雑な推論:各社の上位モデル(GPT-6 Astra・Gemini 4 Argon・Claude Opus 5.5)が候補です。低コスト代替はDeepSeek-V4-Proの推論モードですが、機密データを使わない用途に限定すべきです。
- 機密データを扱うシステム:オープンウェイトのオンプレ展開が前提になります。Llama 4・Qwen3.8・Gemma 4が候補で、欧州要件にはMistral Large 4も候補です。公的機関の考え方は総務省の白書が参考になります(令和6年版 情報通信白書)。
- 業種特化モデルの構築(ファインチューニング):オープンウェイトが必須条件です。Llama 4・Mistral系・Qwen系が代表格。医療では国産特化LLMの開発も進んでいます(NEDO)。
- AIエージェント・業務自動化:コーディングに強い上位モデル(Claude Sonnet 5.5・GPT-6系)が基準ですが、モデル以上にエージェント設計の品質が結果を左右します。AIエージェントの解説とあわせてどうぞ。
API型かオープンウェイトか:動かし方も選ぶ
「どのモデルか」と同じくらい大事なのが「どの形態で動かすか」です。ざっくり言うと、早く小さく試すならAPI型、機密データ・大量処理・作り込みならオープンウェイトの自社ホストが向いています。
| 判断軸 | クローズドAPI型(プロプライエタリ) | オープンウェイト(自己ホスティング) |
|---|---|---|
| 導入速度 | 数日〜数週間でPoC可能 | GPU環境整備に数週間〜数ヶ月 |
| インフラコスト | 初期ゼロ・トークン従量課金 | GPU調達・クラウド費用・運用保守 |
| 大量処理時のコスト | 処理量に比例して増加 | 固定費的に安定(スケールで有利) |
| データプライバシー | 外部APIにデータ送信(DPA確認必須) | データが外部に出ない |
| カスタマイズ性 | プロンプト・RAGの範囲内 | ファインチューニング・アーキテクチャ改変まで自由 |
| 最新モデルへのアクセス | リリース直後から利用可能 | 公開・量子化対応に遅延が生じる場合 |
| 運用責任 | 開発元がインフラ・セキュリティ管理 | 自社責任(セキュリティ・可用性とも) |
| 推奨ケース | PoC・中小規模・迅速展開・機密性が低い用途 | 機密データ・大量処理・ドメイン特化FT・規制対応 |
Azure OpenAI ServiceやVertex AIのようなマネージドサービスは両者の中間で、データ処理地域の明確化とインフラ運用の委託を両立したい場合の有力な選択肢です。なお、自然言語の意味解析については特許7055529「意味判定プログラム、及び意味判定システム」が存在しており、音素データと機械学習を組み合わせて個人差を考慮した意味判定を行う手法が開示されています。
国産LLMはどう考えるか
国産モデルを選ぶ理由は主に4つ——①データが国内で処理される安心感 ②日本語特有の表現への対応 ③国内法規制への適合しやすさ ④日本語・日本時間のサポート——です。デジタル庁もガバメントAIで国内LLMを試用する取り組みを進めています(デジタル庁)。LLM-jp(国立情報学研究所)やSwallowなどの研究機関発モデル、NTT・富士通・NECなどの商用モデルがあります。
一方で、汎用性・マルチモーダル・エージェント機能ではグローバルモデルとの差が残る場面もあります。「日本語が流暢」と「自社の日本語業務で最適」は別の話なので、ここでも結局は自社ユースケースでの比較評価が決め手になります。バーチャルヒューマン「DeepAI」でも、LLMを対話エンジンに組み込む際は日本語対応精度と用途適合性の評価が設計上の重要な判断点です。
公開ベンチマークと比較サイトの数字をどう使うか
LLMの比較記事や比較サイトでは、総合スコアや順位がよく使われます。便利な出発点ですが、何を測った数字なのかを知らないと、選定を誤る原因になります。代表例として、比較サイトのArtificial Analysisが公開している総合指標「Intelligence Index」の公式の説明(2026年10月14日確認)を見てみます。
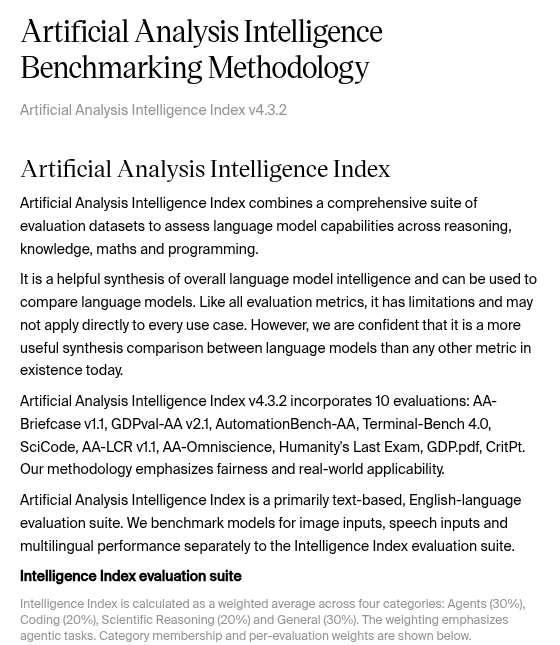
この公式ページには、次のことが書かれています。
- Intelligence Index v4.3.2は10個の評価をまとめた指標で、エージェント(30%)・コーディング(20%)・科学的な推論(20%)・一般(30%)の4分類の重みつき平均で計算される。
- 公式は、この指標を「主にテキスト・英語の評価」と説明している。画像入力・音声入力・多言語の性能は、この指標とは別に計測するとしている。
- 公式は、すべての評価指標と同じく限界があり、あらゆる用途にそのまま当てはまるとは限らないとも書いている。
つまり、総合スコアが高いモデルが、日本語の敬語や自社の業務文書でも最良とは限りません。数字の種類ごとに、分かることと分からないことを分けて使うと迷いません。
| 見る数字 | 分かること | 分からないこと |
|---|---|---|
| 総合スコア・順位(Intelligence Indexなど) | 複数の評価をまとめた、モデル同士の大まかな位置関係 | 自社のタスク・日本語の文体での出来(公式も英語中心と説明) |
| 日本語のベンチマーク(Nejumi Leaderboardなど) | 日本語の課題での相対的な傾向(前述のQualitegの記事が整理しています) | 自社の用語・社内文書への強さ、出力形式の指示への追従 |
| コーディングの公開ベンチマーク(SWE-benchなど) | 公開された課題の解決率 | 自社のコードベースでの出来 |
| API料金表 | 100万トークンあたりの単価 | 実際の月額費用(処理量・プロンプトの長さ・やり直しの回数で変わる) |
使い方の基本は、スコアと順位で候補を3〜5個に絞り、最後は自社のプロンプト20〜50件で並行テストして決めることです。次の「自社で決めるための6ステップ」はこの順番になっています。
自社で決めるための6ステップ
公開ベンチマークは出発点にすぎません。実業務に耐える選定の手順はこうです。
- 要件の明文化:優先指標(精度・コスト・速度・プライバシー)と、許容できないトレードオフを先に決めます。
- 一次スクリーニング:形態・コンテキスト長・料金帯で3〜5モデルに絞ります。本記事の比較表を一次フィルターにどうぞ。
- テストセットの作成:実業務に近いプロンプトを20〜50件。エッジケースと日本語特有の表現、出力フォーマット指定を必ず含めます。
- 並行テスト:同じプロンプトを全候補に投入し、出力・コスト・応答時間を記録します。
- 評価と採点:正確性・流暢さ・指示追従・一貫性を採点します。LLMに評価させる方法(LLM-as-judge)は便利ですが、重要項目は人間評価を優先してください。
- TCO試算と総合判断:性能・月次総コスト・プライバシー・ライセンスを総合して決めます。
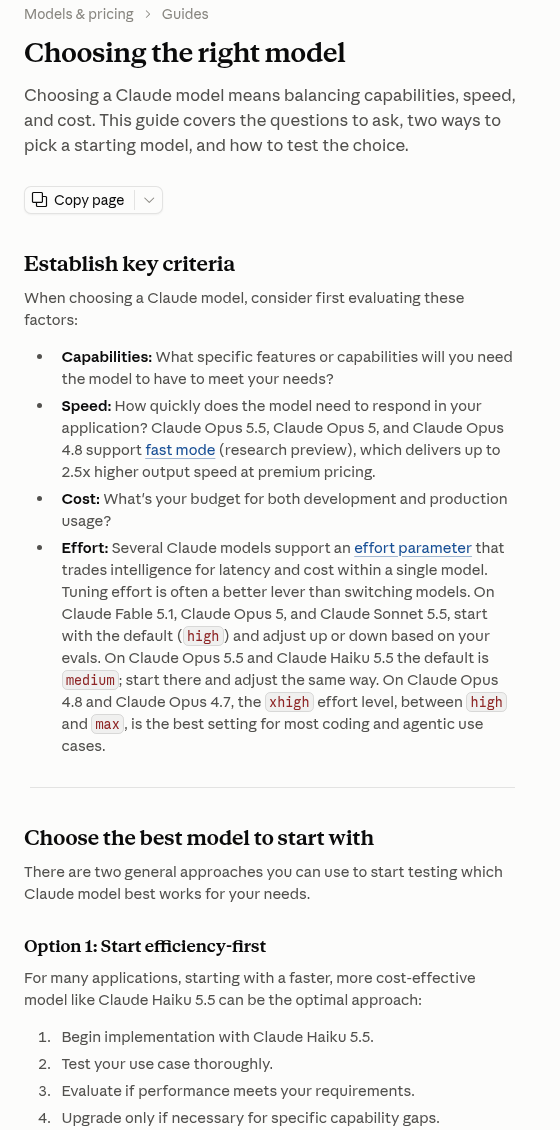
手順1〜2(基準を決めて候補を絞る)の考え方は、Anthropic自身の公式ドキュメントにも同じ順番で書かれています。能力・速度・コストなどの基準を先に決め、効率優先か能力優先のどちらかで始めるモデルを選び、自分のテストで確かめる、という流れです。
よくある失敗5つ(先に知っておけば避けられます)
- 失敗1:ベンチマーク1位をそのまま採用。自社タスク検証なしの導入は、業種特有の表現やフォーマット要件への不適合が本番後に発覚しがちです。PoCを省略しないでください。
- 失敗2:プロンプトを見直さずにモデルを変える。モデル変更の前にSystem PromptやFew-shotの質を見直すと改善するケースは多いです。プロンプトエンジニアリングの解説もどうぞ。
- 失敗3:全処理に最高性能モデルを使う。単純な分類・要約に最上位モデルはコスト非効率です。簡易タスクはGemini 3.8 FlashやClaude Haiku 5.5、GPT-6 Lunaに、複雑な推論だけ上位モデルに振り分ける「モデルルーター」設計が基本です。
- 失敗4:データポリシー確認を後回しにする。選定前にDPA・学習への利用可否を必ず確認します。稟議後の発覚は致命的です。
- 失敗5:リリース直後のモデルを即本番投入。ステージングでの検証を経てから本番へ。
LLM比較に関するよくある質問
結局、一番おすすめのLLMはどれですか?
用途が決まっていない段階での「一番」はありません。まず「何を作るか」を決めて、本記事の用途別の章から入るのが最短です。迷ったら、無料枠のあるChatGPT・Gemini・Claudeを同じ質問で触り比べるところから始めてください。
無料で比較検証はできますか?
初期の触り比べは各社の無料枠でできます。業務前提の検証は、APIの少額課金で実プロンプト20〜50件の並行テストを行うのが確実です。手元マシンで試すならローカルLLMという選択肢もあります。
国産LLMと海外モデル、どちらを選ぶべきですか?
データ管轄・国内法規制・日本語サポートを重視するなら国産が候補になります。汎用性能・エコシステムの広さでは海外モデルが先行しています。どちらか一方ではなく「業務ごとの使い分け」も現実的な解です。
APIの料金がいちばん安いのはどのモデルですか?
2026年10月12日時点の各社公式の料金表では、軽量モデルのGPT-6 LunaとClaude Haiku 5.5が入力100万トークンあたり$0.10・出力$0.50、DeepSeek-V4.1-Flashが入力$0.15〜0.30・出力$0.60〜1.20で、この3つが最も安い価格帯です。ただし安いモデルでやり直しが増えると合計の費用は逆転するため、単価だけでなく自社のタスクでの出来とあわせて判断してください。
コンテキスト長とは何ですか?どれくらい必要ですか?
コンテキスト長は、モデルが一度に読み込める文章の量(トークン数)です。2026年10月12日時点では、GPT-6の各モデル・Claudeの現行モデル・Gemini 3.8 Flash・DeepSeek-V4が約100万トークン(Geminiは1,048,576トークン)に対応しており、通常の業務文書であれば不足しにくくなっています。長い入力は料金が上がるモデルもあるので(Claude Haiku 5.5は10万トークン超、Gemini 3.1 Proは20万トークン超で単価が変わります)、必要な分だけ渡す設計が基本です。
ChatGPT・Claude・Geminiのアプリを比べるのと、APIを比べるのは何が違いますか?
アプリ(チャット画面)は月額の定額プランで、人が対話しながら使います。APIは使った量に応じた従量課金で、自社のシステムや製品にLLMを組み込むときに使います。個人や少人数で使い始めるなら月額プランの比較、システムに組み込むならAPIの料金・コンテキスト長・データの取り扱いの比較、と見る項目が変わります。
まとめ:最強探しをやめた瞬間から、選定は前に進む
LLM比較は「最も性能が高いモデル探し」ではなく、「自社の用途・コスト・プライバシー要件に最も合う1本の特定」です。①用途を先に決める ②5つの軸で評価する ③自社タスクで直接検証する ④タスクの難易度でモデルを使い分ける ⑤データポリシーを先に確認する——この5点を押さえれば大きく外しません。モデルは次々更新されるので、選定は一度きりにせず、定期的に見直してください。
AIの業務活用・導入をご検討の方へ
クリスタルメソッドは、LLM・RAG・AIアバターを活用した業務へのAI導入を支援しています。自社の課題にどう活かせるか、まずはお気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
参考文献
- 総務省「令和6年版 情報通信白書 主要なLLMの概要」https://www.soumu.go.jp/johotsusintokei/whitepaper/ja/r06/html/nd141110.html
- デジタル庁「ガバメントAIで試用する国内大規模言語モデル(LLM)の取り組み」https://www.digital.go.jp/news/1b093bba-a4c8-4001-8a92-ff3667a69198
- NEDO「医療現場の事務作業を支援する高性能な日本語LLMを開発しました」https://www.nedo.go.jp/news/press/AA5_101936.html
- Qualiteg「日本語対応LLMランキング2026 〜ベンチマーク分析レポート〜(Nejumi Leaderboard 4、2026年3月6日版)」https://blog.qualiteg.com/llm-ranking-2026/
- DevelopersIO「2026年のローカルLLM事情を整理してみた」https://dev.classmethod.jp/articles/local-llm-guide-2026/
LLM 比較の関連記事
関連記事
Read next
あわせて読みたい
-

大規模言語モデル(LLM)とは?生成AIとの違いや仕組みをわかりやすく解説【2026年版】
大規模言語モデル(LLM)とは、膨大な文章から「次に来る言葉」を予測する訓練を重ね、文章の理解・生成ができるようになったAIのことです。ChatGPT・Gemi...
-
大規模言語モデル(LLM)一覧・リスト2026年版|主要モデル比較
大規模言語モデル(LLM)の選定は、2026年時点でさらに複雑な判断を要する局面に入っている。GPT・Claude・Geminiといったクローズドモデルが性能を...
-
国産LLM比較|主要モデルの性能・料金・用途を徹底解説【2026年版】
【2026年7月 最新確認】本記事の各サービスの料金・機能・対応状況は更新が速く、変動します。最新の詳細は各公式サイトでご確認ください。 国産LLM比較2025...