
blog
AIブログ
WebGPUとは?WebGLとの違い・対応ブラウザ・AI推論での使いどころ【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
WebGPUとは——ブラウザからGPUの計算力を直接使うための標準API
WebGPUとは、Webブラウザ上のJavaScriptから、パソコンやスマートフォンのGPU(グラフィックスプロセッサ)を使って、高速な計算と3Dなどの描画を行うためのWeb標準APIです。MDN Web Docsは、WebGPUを「WebGLの後継」と位置づけ、現代のGPUとの相性の良さ、汎用計算(GPGPU)への対応、より高速な処理、より高度なGPU機能へのアクセスを特徴として挙げています。
要点は3つです。
- 描画だけでなく計算もできる:WebGLは3D描画のためのAPIでしたが、WebGPUは計算専用の仕組み(コンピュートシェーダ)を正式に持ちます。AIの推論に必要な大規模な行列演算を、ブラウザ内のGPUで実行できます。
- 標準化が進行中の仕様:W3CのGPU for the Webワーキンググループが策定しています。W3Cの仕様ページは「Candidate Recommendation Draft」(2026年9月15日版)です。Apple、Google、Intel、Microsoft、Mozillaが貢献していると、Chrome for Developersの記事(web.dev)は説明しています。
- HTTPS(セキュアコンテキスト)でのみ使える:MDNによると、WebGPU APIはセキュアコンテキストでのみ利用できます。
この記事では、WebGPUとは何か、できること、WebGLとの違い、対応ブラウザの現状、最小限のコード、AI推論での使いどころを、初めて調べる方に向けて順にまとめます。ブラウザ・仕様・APIの記述は、W3C、MDN、Chrome for Developers、WebKit、Mozilla、gpuwebの公式ページを2026年10月29日に確認した内容です。出典は記事末尾に載せています。
WebGPUのAI推論で実際に何ができるかは、業務・サービスへの活用ケースで解説しています。
WebGPUで何ができるのか——4つの用途
WebGPUの用途は、大きく「描く」と「計算する」に分かれます。
| 用途 | 内容 | 代表的な使い方 |
|---|---|---|
| AI推論(ブラウザ内AI) | 画像分類・音声認識・埋め込み生成・小型LLMの実行などを、ブラウザ内のGPUで行う | データを外部サーバーへ送らない構成、インストール不要で配れるAI機能 |
| 3Dグラフィックス・ゲーム | 現代的な描画パイプラインで3Dシーンを描く | Three.js、Babylon.js、PlayCanvas、Unityなどのエンジン経由での利用 |
| 画像・動画処理 | フィルタ、背景分離、超解像などの重い画素処理をGPUで並列に行う | ブラウザ上の画像編集、ビデオ会議の映像加工 |
| 科学計算・シミュレーション | 並列性の高い計算をGPUに任せる | 物理シミュレーション、大規模なデータ変換 |
Chrome for Developersは、WebGPUを使うと同じ描画でもJavaScript側の負荷が大きく減り、機械学習モデルの推論が3倍以上高速になるとも説明しています(同社の記載であり、実際の速さはモデル・端末・ブラウザで変わります)。AI推論の詳しい活用場面はブラウザAI(WebGPU AI)の業務活用で解説しています。
次に読む:オンデバイスAIとは?クラウドとの違いは?
WebGLとの違い——「描く」から「計算する」へ
MDNは、WebGPUを「WebGLの後継」で、GPGPU(汎用計算)に対応し、より高度なGPU機能へアクセスできるものと説明しています。主な違いを表にまとめます。
| 観点 | WebGL | WebGPU |
|---|---|---|
| 位置づけ | 3Dグラフィックス描画のためのAPI | 描画と汎用計算の両方を扱うAPI(WebGLの後継) |
| 汎用計算(GPGPU) | 専用の仕組みはなく、描画の仕組みを流用して代用 | コンピュートシェーダを正式にサポート |
| シェーダ言語 | GLSL | WGSL(WebGPU Shading Language。Rustに似た構文) |
| 状態の扱い | グローバルな状態を切り替えながら描く。Chrome for Developersはこれを誤りの主な原因と説明 | グローバルな状態を持たず、不変の「パイプライン」と、命令をまとめる「コマンドエンコーダ」で組み立てる |
| 処理の同期 | 呼び出しで処理の完了待ち(同期)が生じることがある | 非同期を前提に設計され、エラーの扱いも非同期 |
| 土台とする仕組み | OpenGL。MDNによると、OpenGL(とWebGL)の更新予定はない | Direct3D 12・Metal・Vulkanといった現代のGPU APIの考え方に沿う設計。今後も機能追加が見込まれるとMDNは説明 |
| APIの設計 | 状態を切り替えながら描く方式 | アダプター・デバイス・パイプライン・コマンドを明示的に組み立てる方式 |
| AI推論 | 可能だが描画の仕組みを使うため制約が多い | ONNX Runtime Web・Transformers.js・WebLLMなどが実行基盤として対応 |
| 対応状況 | 広く普及 | 主要ブラウザが対応済みだが、OS・GPUによって差がある(次の章) |
ニューラルネットワークの推論は巨大な行列積の連続で、GPUの並列計算が最も効く処理です。WebGLでは描画用の仕組みを流用するしかなかった計算を、WebGPUでは計算専用のパイプラインとして素直に書けます。
どちらを使うか:AI推論・画像処理・科学計算などの計算用途ではWebGPUが適しています。3D表示だけが目的で、古い環境を含めて広く動かしたい場合は、当面WebGLも選択肢です。実際には、Three.jsなどの描画ライブラリがバックエンドの切り替えを引き受けることが多いため、API自体を直接書く機会は多くありません。
対応ブラウザの現状(2026年10月時点)
Chrome for Developersの記事(2025年11月25日)は、WebGPUがChrome、Edge、Firefox、Safariの主要4ブラウザで公式にサポートされたと伝えています。ただし、対応は「OS・GPU・バージョン」ごとに異なります。gpuwebの実装状況ページ(2026年10月2日更新)などをもとに整理します。
パソコン(Windows・macOS・Linux)
| ブラウザ | Windows | macOS | Linux |
|---|---|---|---|
| Chrome/Edge | 113 | 113 | 144(Intel Gen12以降)、147(NVIDIA・Wayland)。それ以外はフラグが必要 |
| Firefox | 141 | Apple Silicon搭載Macのみ:145(macOS 26以降)、147(macOS全般) | Nightlyのみ(安定版は未対応) |
| Safari | — | 26(既定で有効) | — |
スマートフォン・タブレット
| ブラウザ | Android | iOS/iPadOS |
|---|---|---|
| Chrome/Edge | 121(Android 12以降) | — |
| Firefox | フラグの背後(既定は無効) | — |
| Safari | — | 26(既定で有効)。visionOS 26も対応 |
表の数字は、WebGPUが既定で使えるようになったブラウザのバージョンです。Windows ARM64のChromeはフラグが必要など、細かな条件は実装状況ページに載っています。MDNは、WebGPUがBaseline(主要ブラウザで広く使える機能)には入っていないと明記し、本番で使う前に互換性表を確認し、実行時に navigator.gpu で機能検出することを求めています。
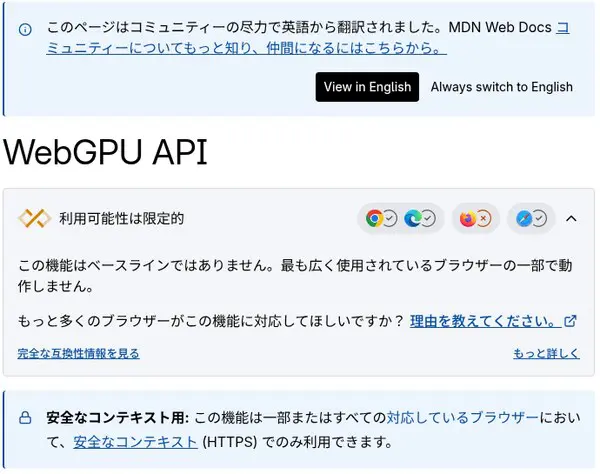
Hugging FaceのTransformers.js公式ドキュメントは、WebGPUの世界的な対応率をcaniuse.com調べで約85%と記載しています(同ドキュメントの執筆時点)。つまり、WebGPUが使えない利用者が一定数いる前提で設計する必要があります。
WebGPUが使えるか確認する——最小限のコード
自分のブラウザで使えるかは、JavaScriptで navigator.gpu があるかを調べると分かります。MDNが示す基本の流れは、次の3段階です。
navigator.gpu(GPUオブジェクト)を取得するrequestAdapter()でアダプター(使えるGPUを表すオブジェクト)を要求するadapter.requestDevice()でデバイス(WebGPUの機能を使う窓口)を要求する
async function init() {
  if (!navigator.gpu) {
    throw Error("WebGPU に対応していません。");
  }
  const adapter = await navigator.gpu.requestAdapter();
  if (!adapter) {
    throw Error("WebGPU アダプターの要求に失敗しました。");
  }
  const device = await adapter.requestDevice();
  // ここから buffer や pipeline を作る
}
開発者ツールのコンソールで navigator.gpu と打って undefined でなければ、そのブラウザはAPIを備えています。ただし、アダプターが取得できるかは別の問題で、GPUやドライバの状態によって取得できないことがあります。そのため、上のコードのように requestAdapter() の結果まで確認します。
WebGPUの仕組み——アダプター、デバイス、パイプライン、WGSL
MDNの説明では、WebGPUの処理は「物理GPU → OSのネイティブGPU API(Metal、Direct3D 12、Vulkanなど)とドライバ → ブラウザのWebGPU実装 → 論理デバイス」という層で動きます。Chrome for Developersの記事によると、実装エンジンはChromiumがDawn、Firefoxがwgpuです。Webアプリ側から見ると、次の部品を組み合わせて使います(MDNのインターフェース一覧による)。
| 部品 | 役割 |
|---|---|
| GPU/GPUAdapter | navigator.gpu から得る入口と、物理GPUとドライバを表すアダプター。機能や上限値の情報を持つ |
| GPUDevice | 論理デバイス。Webアプリがほとんどの機能を使うときの土台になる |
| GPUBuffer/GPUTexture | GPUに渡すデータ(数値の並び、画像など)を置く資源 |
| GPUShaderModule | WGSLで書いたシェーダのコード(device.createShaderModule({ code })) |
| GPUComputePipeline/GPURenderPipeline | 計算用/描画用の処理段階の設定 |
| GPUCommandEncoder/GPUQueue | GPUへの命令を記録し(finish())、キューへ投入する(device.queue.submit()) |
| GPUCanvasContext | canvas.getContext("webgpu") で得る、描画先の設定 |
2種類のパイプライン
MDNは、パイプラインを「プログラム可能な段階をまとめた論理的な構造」と説明し、次の2種類に分けています。
- レンダーパイプライン:頂点段階とフラグメント段階を持ち、主に
<canvas>へ描画します。 - コンピュートパイプライン:コンピュート段階が1つあり、コンピュートシェーダが指定した数のワークグループで並列にデータを処理します。AI推論はこちらが中心です。
WGSLで書くシェーダ
シェーダは、WGSL(WebGPU Shading Language)という専用言語で書きます。構文はRustに似ており、MDNによればMIMEタイプは text/wgsl です。次は、数値の配列の各要素を2倍にする計算シェーダの例です。
@group(0) @binding(0) var<storage, read_write> data: array<f32>;

@compute @workgroup_size(64)
fn main(@builtin(global_invocation_id) id: vec3u) {
  data[id.x] = data[id.x] * 2.0;
}
画面に三角形を描くまでの流れ
MDNの「基本的なレンダーパイプライン」の例は、次の順序で進みます。
- WGSLで頂点シェーダとフラグメントシェーダを書き、シェーダモジュールにする
canvas.getContext("webgpu")で描画コンテキストを取得し、configure()でデバイスと形式を設定する- 頂点データを入れるバッファを作り、
device.queue.writeBuffer()で書き込む device.createRenderPipeline()でパイプラインを作る(頂点バッファの配置、トポロジなどを指定)- コマンドエンコーダで描画パスを開始し、パイプラインと頂点バッファを設定して
draw(3)を呼び、end()のあとqueue.submit()で投入する
計算を実行して結果を読み出すまでの流れ
MDNの「基本的なコンピュートパイプライン」の例は、次の順序です。AI推論ライブラリは、この流れをモデルの演算ごとに内部で行っています。
- コンピュートシェーダのモジュールを作る
- 結果を書き込むストレージバッファと、CPUが読み出すためのステージングバッファを作る
- バインドグループ(バッファをシェーダの
@bindingに結び付ける設定)を作る device.createComputePipeline()でコンピュートパイプラインを作る- コンピュートパスで
setPipeline()、setBindGroup()、dispatchWorkgroups()を呼ぶ - 結果をステージングバッファへコピーし、
mapAsync()でCPU側から読み出す
コンピュートシェーダを直接書くのは、独自の計算を実装したい開発者です。モデルを動かしたいだけであれば、次の章のライブラリを使います。
ブラウザ内AI推論のエコシステム——WebGPUを直接書かずに使う
AI用途では、WGSLでシェーダを直接書くよりも、WebGPUを内部で使う推論ライブラリを利用するのが普通です。Chrome for Developersの記事は、対応ライブラリとして Babylon.js、PlayCanvas、ONNX Runtime、Three.js、Transformers.js、TypeGPU、Unity などを挙げています。
| ライブラリ | 役割 | WebGPUの使い方(公式ドキュメントの記載) |
|---|---|---|
| ONNX Runtime Web | ONNX形式のモデルをブラウザで実行する推論エンジン | onnxruntime-web/webgpu から読み込み、executionProviders に "webgpu" を指定する |
| Transformers.js | Hugging Faceのモデルをブラウザで動かすライブラリ | モデルを読み込むときに device: "webgpu" を指定する |
| WebLLM | ブラウザ内で動く言語モデルの推論エンジン | WebGPUでハードウェア加速を行う。OpenAI互換のAPIとWeb Workerに対応 |
Transformers.jsの公式ドキュメントにある、埋め込み生成の例です。
import { pipeline } from "@huggingface/transformers";

const extractor = await pipeline(
  "feature-extraction",
  "mixedbread-ai/mxbai-embed-xsmall-v1",
  { device: "webgpu" },
);
const embeddings = await extractor(
  ["Hello world!", "This is an example sentence."],
  { pooling: "mean", normalize: true },
);
ONNX Runtime Webでは、次のように実行プロバイダを指定します。
import * as ort from "onnxruntime-web/webgpu";

const session = await ort.InferenceSession.create(modelPath, {
  executionProviders: ["webgpu"],
});ブラウザ内でAIを動かす利点は、入力データを外部サーバーへ送らずに処理できること、インストールなしでWebページとして配れることです。処理の分担の考え方はオンデバイスAIの処理分担設計で解説しています。
WebGPUを使う際の実務上の注意点
- 使えない環境を前提にする:対応はOS・GPU・ブラウザのバージョンで分かれます。
navigator.gpuとrequestAdapter()の結果で機能検出し、使えない場合はWebAssembly(CPU実行)やサーバー推論に切り替える設計にします。 - 実機で確認する:同じブラウザでも、OS・GPUドライバ・搭載GPUで動作や速度が変わります。対象とする端末で実際に動かして確認します。Transformers.jsの公式ドキュメントも、WebGPUはまだ実験的な面があり、Chromium以外のブラウザではモデルの実行で問題が出ることがあると注意しています。
- 初回ロードの設計:AIモデルのファイルは大きくなりがちです。初回ダウンロードとキャッシュ(Cache APIなど)の設計が使い勝手を左右します。
- モデルサイズの上限:端末のGPUメモリに載る範囲でしか動かせません。大型モデルによる高品質な生成はクラウドに任せ、軽量な解析・分類・埋め込みをブラウザ側に置く分担が現実的です。
- HTTPSで配信する:WebGPUはセキュアコンテキストでのみ使えるため、HTTPSで配信します。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
WebGPUに関するよくある質問
Q1. WebGPUとは何ですか?
WebブラウザのJavaScriptからGPUを使って、高速な描画と汎用計算を行うためのWeb標準APIです。W3Cのワーキンググループが策定しており、MDNはWebGLの後継と位置づけています。3D描画に加えてAI推論などの計算(コンピュートシェーダ)を正式にサポートする点がWebGLとの本質的な違いです。
Q2. WebGLとどちらを使うべきですか?
AI推論・画像処理・科学計算など計算用途ならWebGPUが適しています。3D表示だけが目的で、古い環境を含めて広く動かしたい場合は当面WebGLも選択肢です。Three.jsなどのライブラリを使うと、バックエンドの切り替えをライブラリに任せられることがあります。
Q3. WebGPUはどのブラウザで使えますか?
ChromeとEdgeはバージョン113からWindows・macOS・ChromeOSで、Android(Android 12以降)はバージョン121から使えます。FirefoxはWindowsがバージョン141から、Safariはバージョン26からmacOS・iOS・iPadOSで使えます。Linuxなどは条件付きです。詳細は章内の表とgpuwebの実装状況ページを確認してください。
Q4. WebGPUとAIはどう関係しますか?
AIモデルの推論は大規模な行列演算の連続で、GPUの並列計算が最も効く処理です。WebGPUでこの計算をブラウザ内で実行できるため、データを外部に送らないAIや、インストール不要でWebページとして配れるAIを作れます。ONNX Runtime Web、Transformers.js、WebLLMなどが対応しています。
Q5. プログラミングの知識がなくても関係ありますか?
直接プログラミングしない人にとっても、AI機能がインストール不要でWebページとして使える、入力データを端末の外に出さない構成が可能になる、といった形で関係します。業務での活用場面はブラウザAIの解説記事を参照してください。
Q6. WebGPUはHTTPでも使えますか?
使えません。MDNによると、WebGPU APIはセキュアコンテキスト(HTTPS)でのみ利用できます。
Q7. 自分のブラウザで使えるか、どう確認しますか?
開発者ツールのコンソールで navigator.gpu が定義されているかを確認します。実際に使えるかは requestAdapter() がアダプターを返すかで判断します。
参考文献
- W3C「WebGPU」仕様(GPU for the Web Working Group、2026年10月29日確認)
https://www.w3.org/TR/webgpu/ - Chrome for Developers「WebGPU の概要」(2026年10月29日確認)
https://developer.chrome.com/docs/web-platform/webgpu - Chrome for Developers(web.dev)「主要なブラウザで WebGPU がサポートされるようになりました」(2025年11月25日、2026年10月29日確認)
https://web.dev/blog/webgpu-supported-major-browsers - Chrome for Developers「WebGL から WebGPU へ」(2026年10月29日確認)
https://developer.chrome.com/docs/web-platform/webgpu/from-webgl-to-webgpu - gpuweb「Implementation Status」(2026年10月2日更新、2026年10月29日確認)
https://github.com/gpuweb/gpuweb/wiki/Implementation-Status - Firefox 141 リリースノート(MDN、2026年10月29日確認)
https://developer.mozilla.org/en-US/docs/Mozilla/Firefox/Releases/141 - WebKit「News from WWDC25: Web technology coming in Safari 26 beta」(2025年6月9日、2026年10月29日確認)
https://webkit.org/blog/16993/news-from-wwdc25-web-technology-coming-in-safari-26-beta/ - Hugging Face「Running models on WebGPU」Transformers.js(2026年10月29日確認)
https://huggingface.co/docs/transformers.js/guides/webgpu - ONNX Runtime「Using the WebGPU Execution Provider」(2026年10月29日確認)
https://onnxruntime.ai/docs/tutorials/web/ep-webgpu.html - WebLLM ドキュメント(2026年10月29日確認)
https://webllm.mlc.ai/docs/ - MDN Web Docs「WebGPU API」(日本語版・英語版、2026年10月29日確認)
https://developer.mozilla.org/ja/docs/Web/API/WebGPU_API
関連記事
LLM・ローカルLLMの業務導入をご検討の方へ
クリスタルメソッドは、オープンモデル・ローカルLLMの選定からRAG構築・PoC・本番導入までのAI開発を支援しています。「機密データを外部に出さずにLLMを使いたい」「自社の業務に合うモデルを選びたい」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
ブラウザAI・WebGPU AIで何ができる?業務・サービスへの活用ケースを実例で解説
「機密データをクラウドのAIに送れなくて、導入が止まっている」「店舗や研修の端末にアプリを配って回るのが大変」「ユーザーが増えるとAIのサーバー代が怖い」——こ...
-
オンデバイスAI(オフラインAI)とは?クラウドとの違い・身近な例・業務活用を解説
「スマホの中でAIが動く、ってどういうこと?」「顔映像や機密データを外部サーバーに送れないから、AIの導入が止まっている」——この記事は、そんな疑問や悩みを持つ...
-
エッジAIとは?クラウドAIとの違い・現場の活用ケース・導入の勘所【2026年版】
「工場やお店の現場にAIを入れてみたいけれど、カメラの映像や機密データをクラウドに送っていいのか分からない」「そもそもエッジAIって何?」——この記事は、そんな...