
blog
AIブログ
バイオインフォマティクスとは|仕事・学び方・技術スタック
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
バイオインフォマティクス(生命情報科学)とは、生命科学と情報科学・統計学を融合し、ゲノムなどの生物学データをコンピュータで解析して生命現象を解き明かす学際分野です。ゲノム解析や次世代シーケンシングが生み出す膨大なデータを、コンピュータの力で解析・解釈することで、病気の原因解明から創薬、個別化医療まで幅広い応用が広がっています。本記事では、バイオインフォマティクスの基本概念から具体的な研究手法、日本のデータベース、資格・就職情報まで体系的に解説します。
- 何ができるか:分野別の早見表と具体例
- 何を使うか:代表的なデータベース・ツール・ファイル形式
- どう関わるか:仕事・キャリア、学び方、認定試験(2026年度の概要)
バイオインフォマティクスとは?
バイオインフォマティクス(Bioinformatics)は、日本語で「生命情報科学」「生物情報学」「情報生命科学」などと表記される学問分野です。生命科学と情報科学・統計学が融合した比較的新しい分野であり、1990年代ごろから急速に発展してきました。
「生命科学」は高校生物などでなじみ深い分野であり、細胞・遺伝子・タンパク質・生態系など生命現象全般を扱います。一方「情報科学」は、コンピュータを用いたプログラミング・アルゴリズム設計・統計処理・データベース構築など、情報を効率的に処理・管理するための学問です。
この2つの分野はもともと独立して発展してきましたが、ゲノム解析が盛んになるにつれて生物学が扱うデータ量が爆発的に増加し、情報処理技術との連携が不可欠となりました。たとえばヒトのDNAには約30億塩基対の情報が含まれており、これを人手だけで解析することは不可能です。プログラミングや機械学習などの情報処理技術を用いて、こうした膨大なデータを効率的に処理・分析する手法が求められるようになったのです。
バイオインフォマティクスを一言で表すなら、「生命現象を調査・研究する際に、実験結果やデータを情報科学技術によって処理・解析し、生命の謎を解き明かしていく学問」です。
現在ではバイオインフォマティクスはあらゆる生命科学の分野で活用されており、研究対象からデータの処理方法まで多様化しているため、一言でこれと断言できるものではありません。ただし、どのジャンルの研究に関わるにしても、バイオインフォマティクスに携わる人材は「生命科学」と「情報科学」双方の知識・技術を兼ね備えている必要があります。
生化学・遺伝学
統計・機械学習
データベース
プログラミングで機械学習を実際に扱う方法は、Pythonによる機械学習の実装で解説しています。
バイオインフォマティクスでできること|分野別の早見表
日本バイオインフォマティクス学会(JSBi)は、この分野を「生命現象をコンピュータを使って研究する、最先端の学問分野」と説明しています。学会が挙げている内容を、目的別に整理すると次のとおりです。
| 目的 | 行うこと | 本記事で詳しく読む箇所 |
|---|---|---|
| 病気のメカニズムの解明 | ゲノムデータの解析 | 具体例「ゲノム解析」「次世代シーケンシング(NGS)」 |
| 治療薬の開発 | タンパク質の構造や動きの解析 | 具体例「タンパク質の構造解析」 |
| 生命システムの理解 | 生命のネットワークやシステムのコンピュータシミュレーション | 具体例「生体内におけるネットワーク解析」 |
| 生物の探索・利用 | 環境汚染物質を分解する生物や、有用物質を生み出す生物の探索 | (JSBiの紹介より) |
| 進化の解明 | 生物の進化の歴史の解明 | 具体例「集団遺伝学」 |
| 基盤技術の開発 | これらの研究に必要な新しいソフトウェアや情報技術の開発 | 学び方・技術スタック |
百科事典(Wikipedia)の整理では、配列解析(BLASTなどで類似配列を探す)、ゲノムのアセンブルとアノテーション、メタゲノム解析、GWASなどの医学応用、遺伝子発現の解析、タンパク質の構造予測、システム生物学などが主な研究分野として挙げられています。
出典:日本バイオインフォマティクス学会「バイオインフォマティクスについて」、Wikipedia「バイオインフォマティクス」(2026年10月29日確認)。
バイオインフォマティクスの具体例
バイオインフォマティクスの全体像が見えてきたところで、具体的にどのような研究・実験・データ処理が行われているのかを紹介します。主要な取り組みと特に効果が認められているアプローチを順に見ていきましょう。
ゲノム解析
ゲノム解析はバイオインフォマティクスにとって最も根幹をなす領域です。ゲノム解析とは、多くの生物の遺伝情報を解明するための実験・技術であり、DNAに含まれる遺伝情報すなわち塩基配列を明らかにすることで行われます。
塩基配列はA(アデニン)・T(チミン)・C(シトシン)・G(グアニン)の4種類の記号で表されます。それら単体では単なる記号データにすぎませんが、複数の塩基が組み合わさることでゲノム(遺伝子や染色体)の情報を構築しています。ゲノム解析ではこれらすべての塩基配列を明らかにし、どの配列がどの遺伝情報を司っているのかを解読することが求められます。
データ量は何十億にも及ぶため、コンピュータとの相性は抜群です。現在ではゲノム解析は自動的にコンピュータで処理できるようになっています。ヒトゲノムはほぼすべての配列が完全に解析されており、現在の研究の主軸は解析された遺伝子の相互作用の理解や、病気との因果関係の解明へとシフトしています。また、2022年以降は「ヒトゲノムの完全解読」がさらに進み、これまで解析困難とされていた反復配列領域まで含めた完全なヒトゲノム配列が公開されるなど、研究の最前線は常に更新されています。
生体内におけるネットワーク解析
人間の生命現象は、生体内外の様々な分子の相互作用によって成り立っています。ゲノム解析などの成果によって、個別の遺伝子やタンパク質の情報については研究が大幅に進んできました。しかし実際の生命現象は、これら個別の遺伝子が相互に作用しあってより複雑な現象を引き起こしているため、現在ではそれらの相互作用を解明する研究が盛んに行われています。
遺伝子同士の相互作用は「パスウェイ」と呼ばれ、これらの構造をグラフ化したりデータベースに登録したりすることで、世界中の研究者が協力してタンパク質生成・代謝・シグナル伝達といった生物の基本機能の仕組みを分析しています。代表的なデータベースとしてはKEGG(京都遺伝子・ゲノム百科事典)やReactomeなどがあり、研究者が無料で利用できるよう公開されています。
ゲノム情報や塩基配列データは非常に膨大であるため、大量のデータを処理・分析するのに長けたバイオインフォマティクスの技術は、ネットワーク解析においても不可欠な役割を果たしています。
タンパク質の構造解析
タンパク質は人間の体の約15〜20%を構成する非常に重要な分子です。タンパク質は約20種類のアミノ酸が結合して構成されており、アミノ酸の配列によってその立体構造・機能が異なります。この立体構造をコンピュータで予測・解析することは生命科学の大きな課題のひとつとされてきました。
日本では2002〜2006年に文部科学省の「タンパク3000プロジェクト」が実施され、その成果は現在もWebで公開されています(タンパク質3000構造ギャラリー)。このような取り組みにより、タンパク質の立体構造をモデリングし分析することが可能となってきました。
また2021年には、Google DeepMindが開発したAIシステム「AlphaFold2」がほぼすべての既知タンパク質の立体構造を高精度で予測できることを示し、生命科学の歴史的転換点となりました。AlphaFold2が予測した2億種類以上のタンパク質構造データベースは無料公開されており、創薬・農業・基礎研究など多分野に革命をもたらしています。この分野はバイオインフォマティクスの中でも「構造バイオインフォマティクス」と呼ばれ、新規タンパク質の機能解明に向けた研究が現在も活発に進められています。
次世代シーケンシング(NGS)
次世代シーケンシング(NGS:Next Generation Sequencing)とは、数千から数百万ものDNA分子を同時に配列決定することが可能な画期的な技術基盤です。変異の探索や病気の原因遺伝子の特定などにおいて、効率的にDNA配列を決定できるこの技術はゲノムサイエンスに革命をもたらしました。
従来の方法(サンガー法)ではDNA塩基配列を決定する際に1〜96のDNA断片を同時に処理するのが限界でしたが、NGSでは1回の実験で数千億もの塩基情報を取得できます。処理できるデータ量が格段に増えたことで、研究の速度とコストが劇的に改善されました。
NGSとバイオインフォマティクスは切っても切れない関係にあります。NGSが生み出す膨大なデータはコンピュータの処理なしには成り立ちません。現在ではバイオインフォマティクス専用のツール(Galaxy、GATK、SAMtoolsなど)を使えば、NGSから得られたデータを遺伝子の機能・構造別にファイル形式で出力・比較できるようになっています。こうしたツールの普及によって、かつては一部の専門家だけのものだったバイオインフォマティクス解析が多くの研究者に開かれるようになりました。
また、2010年代後半からはシングルセルRNA-seq(単一細胞レベルの遺伝子発現解析)や空間トランスクリプトミクスといった手法も登場し、NGSとバイオインフォマティクスの活躍領域はさらに拡大しています。
集団遺伝学
集団遺伝学は、個体群や生物群集の遺伝子プール(ある集団に属する遺伝情報のまとまり)を対象に、進化と遺伝について確率論・統計学などの数学的手法を用いて研究する分野です。突然変異・遺伝的浮動・自然選択・遺伝的組み換えといった事柄を研究する際に非常に有効な手段であり、数学的手法を主に用いることからバイオインフォマティクスの一領域として発展してきました。
もともとはチャールズ・ダーウィンの自然選択説と、グレゴール・ヨハン・メンデルの遺伝法則が融合して生まれた分野であり、歴史は長いですが、近年のNGS技術と情報処理能力の向上に伴い、集団レベルでのゲノムワイド関連解析(GWAS)や祖先集団の推定など、さらなる発展が進んでいます。
ここまで紹介した具体例すべてに共通することは、「膨大なデータを扱う必要がある」という点です。生命科学はもともと複雑な生命現象を対象にした研究であり、各分野が狭く深く特化した状態で発展してきた歴史があります。しかし実験技術の発展により扱うデータ量が爆発的に増え、分野横断的な解析が不可欠になったことから、バイオインフォマティクスが生まれ現在まで発展してきたのです。
ゲノム解析以外の主な研究分野|メタゲノム・比較ゲノム・疾患・がん・遺伝子発現
「バイオインフォマティクス=ゲノム解析」と思われがちですが、扱う対象はもっと広い分野です。百科事典(Wikipedia)の整理にそって、代表的な分野を一覧にします。
| 分野 | 何をするか |
|---|---|
| メタゲノム解析 | 環境中の微生物群集からゲノムDNAを直接回収し(主にショットガンシーケンス)、どの微生物がどの程度いて、どんな機能をもつかを調べる。物質循環や生態系の理解につながる |
| 比較ゲノム・系統樹 | 異なる生物間で対応する遺伝子(オルソログ)を探し、欠失・重複・転位などの進化の過程をたどる。配列の類似性から種間の系統樹も作る |
| 疾患研究(GWAS) | 次世代シーケンシングやゲノムワイド関連研究(GWAS)で、不妊症・乳がん・アルツハイマー病などの複雑な疾患に関わる遺伝子を探す |
| がんの変異解析 | がんは体細胞変異が蓄積する病気。正常なゲノムと比べ、発症に関わる「ドライバー変異」と無関係な「パッセンジャー変異」を区別する |
| 遺伝子発現・転写調節 | マイクロアレイやRNA-SeqでmRNAを測定する。ノイズが多いため統計手法が重要。プロモーター領域の配列モチーフ探索や、共発現する遺伝子のクラスタリングも行う |
| ゲノムの決定・注釈 | シーケンサの出力から塩基を読み取り(ベースコール)、短い断片をつなげてゲノムを組み立て(アセンブル)、遺伝子とその機能の位置を記す(アノテーション) |
| タンパク質の構造予測 | 配列から立体構造を予測する。相同性モデリングなどの手法があり、DNA・RNA・タンパク質の分子シミュレーションも行う |
| 文献・画像の解析 | 科学論文のテキストマイニングや、生物医学の画像・動画の解析も研究分野に含まれる |
| 創薬・ヘルスケア | 配列・構造・発現などのデータを統合し、機械学習で遺伝子機能の予測や疾患バイオマーカーの特定を行う(Databricksの説明) |
創薬・医療への応用
JSBiは、タンパク質の構造や動きの解析を治療薬の開発に結びつけています。またDatabricksの説明では、配列・構造・発現・代謝経路・文献のデータベースを統合し、機械学習や統計手法で遺伝子機能の予測、疾患バイオマーカーの特定、複雑な生物システムのモデル化を行うとされています。生物学データの量が急増したことで、多くの課題で大きな計算能力が必要になっています。
「バイオインフォマティクス」という言葉の由来
この用語は1970年にPaulien HogewegとBen Hesperが、生物システムにおける情報処理を研究する分野を指す言葉として作りました。当時の意味は現在の使われ方とは異なり、のちにゲノム配列の解析が中心になるにつれて、今の意味で広まりました。
出典:Wikipedia「バイオインフォマティクス」、Databricks「バイオインフォマティクスとは」(2026年10月29日確認)。
バイオインフォマティクスが発展してきた背景|なぜ今必要とされているのか
バイオインフォマティクスは比較的新しい分野ですが、1990年代から今日まで飛躍的に発展してきた歴史があります。その発展の背景には、いくつかの重要な技術的・社会的要因があります。
最大のきっかけは、1980年代から1990年代にかけて世界中で進められた「ゲノム解析」プロジェクトです。DNAに含まれる遺伝子情報(塩基配列)を解読するこのプロジェクトでは、A・T・C・Gの4種類の記号で表される塩基配列というきわめて膨大かつ量的なデータを解析する必要がありました。ヒトゲノムだけでも約30億塩基対に及ぶこのデータをコンピュータなしに分析することは極めて困難であり、世界的に情報処理分野と生命科学分野が協力して研究を進めてきた経緯があります。
ゲノム解析がほぼ完了した後も、生命科学の実験やデータ分析に情報処理技術を用いることの有用性は明確でした。2000年代以降は次世代シーケンシング(NGS)技術の登場によってデータ取得コストが劇的に低下し、さらに多くの研究者がバイオインフォマティクスを活用するようになりました。また2010年代以降は機械学習・深層学習の発展が生命科学の解析にも取り込まれ、タンパク質構造予測(AlphaFold2など)や創薬AI、ゲノム医療といった領域で革新的な成果をもたらしています。
2020年代においても、シングルセル解析や空間トランスクリプトミクスなど大量の細胞レベルデータを扱う技術が台頭し、バイオインフォマティクスの需要はますます拡大しています。
代表的なデータベースとツール|どこで何を調べるか
バイオインフォマティクスの作業は、公共データベースからデータを取り出し、解析ツールで処理する流れが基本です。初めて調べるときに名前が出てくる代表的なものを、用途別にまとめます。
| 種類 | 名前 | できること |
|---|---|---|
| 塩基配列データベース | DDBJ(日本)・ENA(欧州)・GenBank(米国) | 国際塩基配列データベース連携(INSDC)として塩基配列を収集・公開。いずれか1つに登録すれば世界で共有される |
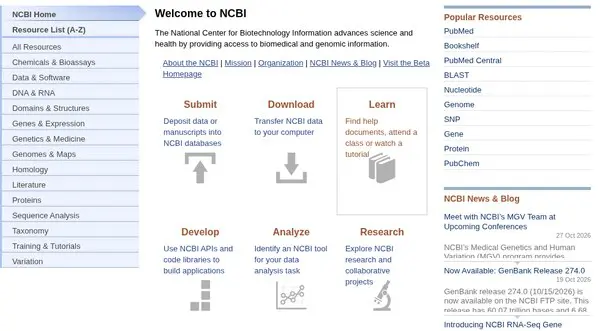
| 総合ポータル | NCBI | PubMed(文献)、Nucleotide、Protein、Gene、Genome、SNP、ClinVar、SRA、BLASTなどを提供 |
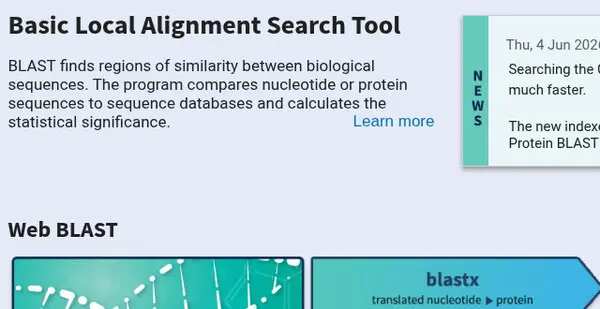
| 配列の類似検索 | BLAST(NCBI) | 塩基配列やタンパク質配列を配列データベースと比べ、局所的に似た領域と統計的な有意性を求める。blastn・blastp・blastx・tblastnなどがある |
| 立体構造・経路・発現 | PDB/KEGG/GEO・ArrayExpress | タンパク質の立体構造、代謝などの経路、遺伝子発現データ(Wikipediaの整理) |
| 解析ライブラリ | Biopython/Bioconductor | PythonやRで配列・発現データを扱うオープンソースのパッケージ |
| ワークフロー | Galaxy | 解析手順を組んで実行するプラットフォーム |
出典:NCBI、NCBI BLAST、DDBJセンターについて、Wikipedia「バイオインフォマティクス」(2026年10月29日確認)。
解析で必ず出てくるファイル形式|FASTQ・SAM/BAM・VCF
シーケンサから得たデータは、解析の段階ごとに決まったファイル形式で受け渡されます。初心者が最初に目にする3種類を整理します。
| 形式 | 入っているもの | 使う場面 |
|---|---|---|
| FASTQ | 塩基配列と品質情報を1つのファイルに収めた、アライメント前の配列データ | シーケンサの出力。最初の品質確認・前処理の入力 |
| SAM/BAM(CRAM) | 配列をゲノム上に並べた(マッピングした)アライメントデータ。SAMはテキスト、BAMはそのバイナリ版 | マッピングの結果の保存・共有 |
| VCF/BCF | 変異(バリアント)の呼び出し結果。VCFはテキスト、BCFはバイナリ形式 | 変異の一覧の受け渡し・集計 |
FASTQには正式な単一の定義がなく、互換性のない版がある点に注意が必要です。仕様は公式のHTS仕様ページ(SAM・VCFなど)にまとまっています。
出典:HTS specifications(samtools)(2026年10月29日確認)。
世界に誇れる日本の「DDBJ」とは?
バイオインフォマティクスの発展にゲノム解析が深く関わっていることは前述しましたが、そこで得られた膨大なデータはどのように管理・共有されてきたのでしょうか。
それらのデータを専門的に扱うのが、DDBJ(DNA Data Bank of Japan:日本DNAデータバンク)です。DDBJは日本のDNAデータベースであり、国際塩基配列データバンク(INSDC:International Nucleotide Sequence Database Collaboration)の一翼を担っています。INSDCには他に欧州のENA(European Nucleotide Archive)と米国のNCBI(National Center for Biotechnology Information)が参加しており、3機関が協調してデータを共有・管理しています。
| 機関名 | 国・地域 | 運営組織 | 特徴 |
|---|---|---|---|
| DDBJ | 日本 | 国立遺伝学研究所(NIG) | アジア太平洋地域の塩基配列データ登録・公開の中心 |
| ENA | 欧州 | 欧州バイオインフォマティクス研究所(EBI) | 欧州の核酸配列データの総合データベース |
| NCBI | 米国 | 国立生物工学情報センター | GenBankをはじめ多数の生命科学データベースを提供 |
DDBJは1984年に運用を開始し、1987年に定期リリース1を公開して公式な活動を始めました(DDBJセンター公式サイトの沿革による)。国際塩基配列データベース連携(INSDC)の整備により、ゲノム解析や関連分野の研究は大きく前進しました。
このシステムの優れた点は、各研究者が解析した塩基配列をデータベースに登録・共有し、かつ無料で閲覧・検索できる点にあります。DNA配列やアミノ酸配列のキーワード検索で目的のデータを素早く見つけることができ、研究者にとって欠かせないインフラとなっています。データは全世界の研究者に対して無料で公開されており、日本・欧州・米国の3機関がリアルタイムでデータを同期・共有しています。
このデータベースの開発と、データ取り扱いのルールを国際的に整備したことにより、ゲノム解析を含む生命科学の研究は飛躍的に発展しました。生命科学の研究者だけでなく、システム開発やデータベース構築を担当するエンジニアの貢献も大きく、まさにバイオインフォマティクス発展の礎といえます。
DDBJの詳細はDDBJ-国立遺伝学研究所公式HPでご確認いただけます。
バイオインフォマティクスとデータサイエンスの違いと重なり
バイオインフォマティクスは、生物学、コンピュータサイエンス、数学、統計学を組み合わせて、ゲノムなどの生物学データを収集・保存・分析・解釈する学際分野です。データを扱う点でデータサイエンスと重なりますが、違いは「扱うデータの意味を生物学の知識で解釈するかどうか」にあります。
- 重なる部分:Python・R、統計、機械学習、データベース(SQL)。認定試験の出題範囲にも、確率・統計、機械学習、データベース技術が含まれます。
- 違う部分:配列データや発現量データといった生物学固有のデータ形式を扱い、結果を遺伝子やタンパク質の働きとして説明する必要があります。
- 進路の見方:情報科学のスキルは、研究職だけでなくIT企業のデータサイエンティストやエンジニアにも生かせます(キャリアの節を参照)。
出典:Databricks「バイオインフォマティクスとは」、JSBi 認定試験の出題範囲(2026年10月29日確認)。
バイオインフォマティシャンとは
バイオインフォマティクスに携わる専門人材を「バイオインフォマティシャン(Bioinformatician)」と呼びます。これまでの説明からわかるように、バイオインフォマティクスは生命科学と情報科学の両方を高いレベルで使いこなすことが求められる分野です。
バイオインフォマティシャンは現在、常に深刻な人材不足の状況にあります。その理由は明確で、生命科学も情報科学もそれぞれ単独で習得することでさえ非常に難しい分野であるにもかかわらず、バイオインフォマティシャンにはその両方においてエキスパートである必要があるからです。
この問題は1990年代からすでに指摘されており、分野横断的な人材育成や需要拡大に向けた取り組みが各所で行われてきました。大学・大学院でも、生命科学と情報科学を横断して学べる教育が行われています。それ以外にも京都大学、大阪大学、慶應義塾大学など多くの大学・大学院でバイオインフォマティクスに関連するコースや研究室が設けられています。
2026年現在においても深刻なバイオインフォマティシャン不足が続いており、従来の人材育成以外のアプローチも模索されています。特に注目されているのは、すでに生命科学の研究機関に属している研究者が情報科学技術を習得するという方向性です。若い世代をゼロから育成することも重要ですが、現場の研究者をバイオインフォマティシャンとして「アップスキル」させる仕組みが一層求められています。
具体的な取り組みとして、オンライン教育プラットフォームを活用したバイオインフォマティクス講座の提供や、研究者コミュニティによる勉強会・ハッカソンの開催が増えています。国際的にはBioconductor(R言語ベースの生命科学データ解析ツール群)やBioconda(バイオインフォマティクスツールのパッケージ管理)といったオープンソースコミュニティが、研究者の参入障壁を下げる役割を果たしています。
AIの業務導入をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
バイオインフォマティシャンの就職・キャリアについて
バイオインフォマティシャンになったとして、どのような就職先があるのかイメージしにくいという方も多いでしょう。しかしバイオインフォマティクスの需要が急増している現代では、バイオインフォマティシャンには様々なキャリアパスが開かれています。
バイオインフォマティクスをおこなう研究者
バイオインフォマティシャンの代表的な就職先は研究者です。ただし「研究者=大学の研究室」という認識は今や古く、様々な企業や研究機関がバイオインフォマティクスに精通した人材を積極的に募集しています。
求められるスキルとしては、タンパク質のモデリング、ゲノムのデータ解析、統計解析(R・Pythonを用いたもの)、機械学習の実装などが典型的です。年収は就職先・職種・経験・雇用形態によって大きく異なるため、具体的な水準は応募先の求人票で確認してください。特に創薬・製薬企業、バイオテクノロジーベンチャー、医療機器メーカーなどでの需要が高まっています。
研究機関別に見ると、以下のような就職先が考えられます。
- 国立・公立研究機関:国立遺伝学研究所、理化学研究所(RIKEN)、産業技術総合研究所など
- 大学・大学院:研究員・ポスドク・助教など、アカデミアのポジション
- 製薬・創薬企業:国内外の製薬企業など
- バイオテクノロジーベンチャー:ゲノム解析サービス、個別化医療、農業バイオなど
- 医療・ヘルスケア企業:ゲノム医療、精密医療関連サービスの提供企業
IT企業のエンジニア・データサイエンティスト
バイオインフォマティシャンが身につける情報科学スキル、たとえばアルゴリズムの設計、データベース操作(SQL)、Python・RによるデータサイエンスおよびAI・機械学習の実装技術は、IT分野全般において非常に重宝されます。
現代はバイオインフォマティシャンに限らずエンジニアの不足も深刻であるため、バイオインフォマティクスで培った情報処理技術を持つ人材は、IT企業でのエンジニア・データサイエンティスト職への転身も十分可能です。特にアルゴリズム設計のスキルや機械学習のスキルは、AI・ビッグデータ分析・クラウドサービス開発など多くの成長領域で必要とされます。
また近年では「バイオ×ITスタートアップ(BioTech)」の領域が急速に拡大しており、生命科学の知識とエンジニアリングスキルの両方を持つ人材が特に重宝されます。遺伝子検査サービス、AIを用いた創薬、農業テクノロジー(AgriTech)、デジタルヘルスなど、バイオインフォマティクスの応用領域はますます広がっています。
バイオインフォマティシャンの職種別に見たキャリアパスと年収の確認方法
| キャリアパス | 主な就職先 | 求められる主なスキル |
|---|---|---|
| バイオ系研究者 | 製薬会社・研究機関・大学 | ゲノム解析・タンパク質モデリング・統計解析 |
| データサイエンティスト | IT企業・BioTechスタートアップ | Python/R・機械学習・SQL・統計 |
| バイオITエンジニア | 医療IT・ゲノム医療関連サービス企業 | NGS解析パイプライン構築・クラウド活用 |
| アカデミア研究者 | 大学院・研究所 | 専門領域の深い知識・論文執筆・データ解析 |
年収の水準は求人ごとに差が大きいため、このページでは数値を載せていません。志望する職種(研究員・データサイエンティスト・エンジニアなど)の求人票で、必須スキルと提示年収をあわせて確認するのが確実です。上の表の「求められる主なスキル」は、求人票を読むときの比較軸として使えます。
バイオインフォマティクスの学び方|何から始め、どんな技術スタックを使うか
「興味はあるが何から手をつければよいか分からない」という声は少なくありません。バイオインフォマティクスは生物学・プログラミング・統計の三領域が交わる分野なので、すべてを一度に極めようとせず、目的に近い順に積み上げるのが現実的です。
学習のはじめ方(おすすめの順序)
- プログラミング言語:まずはPythonかRのどちらかに絞ります。配列解析やデータ処理にはPython(Biopython・pandas)、統計解析や発現量データにはR(Bioconductor)が広く使われます。
- 基礎となる生物学:DNA・RNA・タンパク質の流れ(セントラルドグマ)と、配列・ゲノム・発現といった基本データの種類を押さえます。
- 手を動かす教材:プログラミング課題で生物配列を扱えるRosalindのような演習サイトや、大学・MOOCの入門講座を併用すると、知識が実装に結びつきます。
実務で使う代表的な技術スタック
- 言語・環境:Python/R、コマンドライン操作(Linux・シェル)
- データベース:NCBI、後述のDDBJ、Ensembl などの公共データベース
- 解析ツール:配列検索のBLAST、リードのマッピングに使うBWAやsamtools など
- 統計・可視化:多検定の考え方、Rやpandas/matplotlibでの集計・可視化
バイオインフォマティシャンになるための試験
バイオインフォマティシャンとして活躍するには生命科学と情報科学の双方を高いレベルで習得する必要がありますが、日本にはバイオインフォマティクスへの精通を公式に証明できる認定試験があります。それが「バイオインフォマティクス技術者認定試験」です。
バイオインフォマティクス技術者認定試験の概要
この試験は、日本バイオインフォマティクス学会(JSBI)が主催するもので、バイオインフォマティクスに関する基礎知識から先端知識まで幅広く熟知していることを証明できるよう設計されています。学生や研究者がバイオインフォマティクスの入門として学習するのにも適した内容です。
試験方式は2019年まではマークシート方式でしたが、2020年からCBT(Computer Based Testing)方式に変更されました。CBT方式はパソコン画面上で回答していく形式であり、各地のテストセンターで試験期間中に受験できます。また、学会の正会員・学生会員が合格した場合は、合格翌年度の年会費が免除される特典があります(本人からの申込みが必要)。
出題範囲について
出題範囲が明示されているため、膨大な生命科学・情報科学の知識をある程度絞って学習できます。試験の出題カテゴリーは大きく以下の3領域に分かれています。
| 領域 | 主な出題分野 |
|---|---|
| 生命科学分野 | 生物学基礎、分子生物学・生化学、バイオテクノロジー |
| 情報科学分野 | コンピュータシステム、アルゴリズム、データベース技術、確率・統計、機械学習 |
| バイオインフォマティクス | 分子生物学、配列解析、タンパク質・立体構造・機能解析、進化・遺伝、オーミクス |
出題範囲は非常に広いと感じるかもしれませんが、公式サイトではさらに詳細な分野ごとの指針が公開されているため、効率的に学習を進めることができます。バイオインフォマティクスに興味を持ち始めた方が「自分の知識レベルを確認しながら体系的に学ぶ」ための目標として、まずこの試験を目指すのは非常に合理的な選択肢です。
詳細はバイオインフォマティクス技術者認定試験 公式サイトをご参照ください。
2026年度の実施概要(公式ページで確認した内容)
日本バイオインフォマティクス学会の2026年度認定試験の概要は次のとおりです(2026年10月29日に公式ページで確認)。
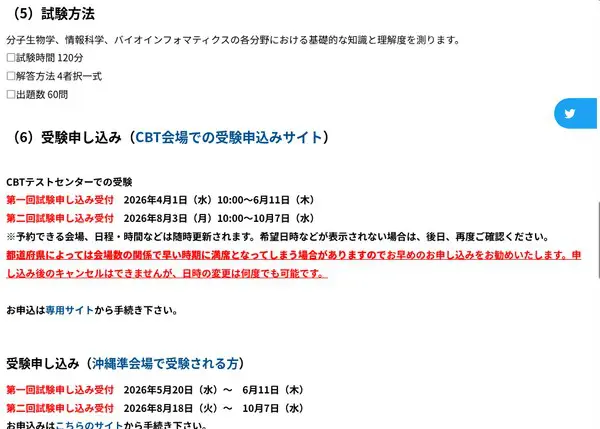
| 項目 | 内容 |
|---|---|
| 実施回数・日程 | 年2回。第一回は7月11日(土)〜8月9日(日)、第二回は11月7日(土)〜12月6日(日) |
| 試験時間・問題数 | 120分・60問(4者択一式) |
| 受験料 | 6,000円(税込) |
| 受験資格 | 問わない(公式ページに「受験資格は問いません」と記載) |
| 申込期間 | 第一回は4月1日〜6月11日、第二回は8月3日〜10月7日(2026年度) |
| 形式 | CBT(2020年度からマークシート方式の筆記試験より移行) |
| 後援 | 文部科学省・科学技術振興機構 |
| 出題範囲 | 生命科学分野/情報科学分野/バイオインフォマティクスの3領域(上の表のとおり。機械学習・SQL・統計も含む) |
出典:日本バイオインフォマティクス学会 認定試験、2026年度認定試験情報、出題範囲(いずれも2026年10月29日確認)。年度ごとに日程・料金が変わるため、受験前に必ず最新の公式ページを確認してください。
バイオインフォマティシャンの実務イメージ|仕事の進め方
求人票の言葉だけでは仕事像がつかみにくいため、実際の進め方をおおまかな流れで示します。多くの場合、「課題設定 → データ取得・整形 → 解析 → 解釈・共有」という順に進みます。
- 課題設定:研究者や事業側と「何を明らかにしたいか」をすり合わせます。ここが曖昧だと解析が空回りします。
- データ取得・整形:シーケンサ出力や公共DBのデータを集め、品質管理と前処理を行います。実務では、この前処理に多くの時間がかかります。
- 解析:目的に応じてマッピング・発現量比較・統計検定などをコードで実行し、再現できる形(スクリプト)で残します。
- 解釈・共有:結果を生物学的な意味に翻訳し、図表とともに関係者へ説明します。
つまり、求められるのは「プログラミングだけ」でも「生物学だけ」でもなく、両者をつなぐ翻訳力です。独学で始める場合も、この一連の流れを小さなデータで一周してみると、学ぶべき技術の優先順位が見えてきます。
バイオインフォマティクスでつまずきやすい「再現性」とAIツールとの付き合い方
バイオインフォマティクスの実務では、解析手法そのものよりも「同じ解析を後からもう一度実行しても、同じ結果が得られるか」という再現性の担保に苦労する場面が少なくありません。ゲノム解析や次世代シーケンシング(NGS)のパイプラインは、参照ゲノムのバージョン、各ツールのバージョン、パラメータの初期値、乱数シードといった要素の違いで結果が変わり得るためです。学び始めの段階から、次の点を習慣づけておくと後戻りを防げます。
| つまずきやすい点 | 実務での対処の考え方 |
|---|---|
| ツールや依存パッケージのバージョン差 | 解析環境をコンテナや環境定義ファイルとして固定し、使用したバージョンを記録する |
| 参照ゲノム・アノテーションの取り違え | どのビルド・リリースを使ったかをメタデータとして明示し、混在させない |
| 手作業のコマンド実行による属人化 | 処理手順をワークフローとして記述し、実行ログを残して追跡可能にする |
| 乱数や初期値による揺らぎ | シードを固定し、再実行時に差分を検証できる状態にしておく |
近年は、コード生成を支援するAIツールを解析スクリプトの下書きやコード整形に活用する場面も増えています。定型的な前処理や可視化コードのたたき台づくりでは有用ですが、生成されたコードや説明を、生物学的な妥当性を確かめずにそのまま採用するのは危険です。統計手法の前提条件、フィルタリング基準、ゲノム座標の扱いなどはドメイン知識に依存し、もっともらしく見えても誤った処理になり得ます。AIツールはあくまで作業の補助と位置づけ、最終的な解析設計と結果の解釈は必ず人が検証する——この線引きが、信頼できる解析を積み上げるうえでの基本になります。
よくある質問(バイオインフォマティクスQ&A早見表)
検索でよく聞かれる質問に、結論から先にお答えします。
Q. バイオインフォマティクスとは何ですか?
A. 生命科学(バイオロジー)と情報科学・統計学を融合させた学問領域で、実験やゲノム解析で得られる膨大なデータをコンピュータで処理・解析し、生命現象の解明や創薬、個別化医療などに応用します。1990年代以降、次世代シーケンシング技術の普及とともに急速に発展してきました。
Q. バイオインフォマティシャンの年収はどのくらいですか?
A. 就職先・職種・経験・雇用形態によって大きく異なるため、具体的な水準は応募先の求人票で確認するのが確実です(詳細は本記事「バイオインフォマティシャンの就職・キャリアについて」参照)。
Q. バイオインフォマティシャンの1日の仕事の流れは?
A. 「課題設定→データ取得・整形→解析→解釈・共有」という流れで進みます。特に公共データベースやシーケンサ出力の品質管理・前処理に時間がかかる傾向があり、解析結果を生物学的な意味に翻訳して関係者へ説明する「両領域をつなぐ翻訳力」が求められます(詳細は本記事「バイオインフォマティシャンの実務イメージ」参照)。
Q. バイオインフォマティクスを学ぶには何から始めればよいですか?
A. まずはR言語やPythonによる統計解析、ゲノム解析やタンパク質モデリングの基礎知識を身につけることが一般的な出発点です(詳細は本記事「バイオインフォマティクスの学び方|何から始め、どんな技術スタックを使うか」参照)。
本記事の該当箇所への案内
Q. バイオインフォマティクスとは何ですか?
A. 本文「バイオインフォマティクスとは?」で解説しています。
Q. 具体的にどんなことに使われていますか?
A. 本文「バイオインフォマティクスの具体例」で紹介しています。
Q. バイオインフォマティシャンになるにはどうすればよいですか?
A. 本文「バイオインフォマティシャンになるための試験」「バイオインフォマティクスの学び方」で解説しています。
Q. どんな仕事をするのですか?
A. 本文「バイオインフォマティシャンの実務イメージ|仕事の進め方」で整理しています。
本記事は2024年3月6日に公開し、2026年10月29日に内容を確認・更新しています。
まとめ
バイオインフォマティクスは、生命科学と情報科学・統計学が融合した学際分野であり、ゲノム解析・タンパク質構造解析・次世代シーケンシング・集団遺伝学など幅広い領域でその技術が応用されています。1990年代のゲノム解析ブームを契機に急速に発展し、2020年代にはAlphaFold2や単一細胞解析・ゲノム医療など、生命科学の最前線でますます重要な役割を担っています。
日本ではDDBJが国際塩基配列データバンクの一角を担い、世界の生命科学研究の基盤を支えています。また「バイオインフォマティクス技術者認定試験」という公式資格も整備されており、学生・研究者・ITエンジニアがバイオインフォマティクスへの第一歩を踏み出せる環境が整いつつあります。
バイオインフォマティシャンは深刻な人材不足が続いており、研究者・データサイエンティスト・エンジニアなど多様なキャリアパスが開かれています。習得すべき知識・スキルの量は膨大ですが、その分だけ活躍できるフィールドは広く、今後もさらなる需要拡大が見込まれます。生命科学に興味がある方も、情報科学を学んできた方も、バイオインフォマティクスという融合領域はきわめて魅力的な選択肢です。
AIの業務活用をご検討の方へ
クリスタルメソッドは、バーチャルヒューマンをはじめAIの開発・業務導入を支援しています。生成AI・AIエージェントの活用や、自社業務へのAI導入をご検討の際は、お気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-

Pythonを使って機械学習を実装する
機械学習は、膨大なデータから法則性を見つけ出し自律的に学習する技術です。近年ではビジネス・研究・サービス開発など幅広い領域で活用されており、その実装手段としてP...
-
コラボラトリー(Google Colaboratory)とは|初心者がPythonを始める環境
Google Colaboratory(通称:Colab)は、Googleが提供するクラウドベースのPython実行環境です。ソフトのインストールも環境構築も不...
-
【目的別】Python入門におすすめな書籍5選を紹介
最近プログラミング言語として注目を集めているのが、短いコードでプログラムを組むことができたり、豊富なライブラリが特徴であるPython。機械学習やデータの分析な...