
blog
AIブログ
ハルシネーションとは?AIがもっともらしい嘘をつく原因・種類・実際の事例と対策
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
ハルシネーションとは、生成AI(大規模言語モデル)が、事実と異なる内容や実在しない情報を、根拠があるかのようなもっともらしい文章で出力してしまう現象です。英語の hallucination(幻覚)に由来します。
この記事では、ハルシネーションの意味と種類、起きる原因、法律・医療・学術・ビジネスなどで実際に起きた事例、リスク、確かめ方と対策を順に解説します。対策をさらにくわしく知りたい場合はハルシネーションの対策|RAG・プロンプトで防ぐ方法も参照してください。
関連記事ハルシネーション対策プロンプト集|今すぐ使えるコピペテンプレート【2026年版】 / ハルシネーションの検出・評価|精度を測る方法【2026年版】 / ハルシネーションの仕組み・原因|なぜAIは間違えるのか
ハルシネーションとは:AIがもっともらしい嘘をつく現象
ハルシネーションとは、AIモデルが事実と異なる情報を、あたかも正確な事実であるかのように生成する現象です。単純な誤字・計算ミスとは異なり、「存在しない論文の引用」「実在しない人物の発言」「架空の法律条文」など、もっともらしい形式を保ちながら内容が完全に虚偽である点が特徴です。
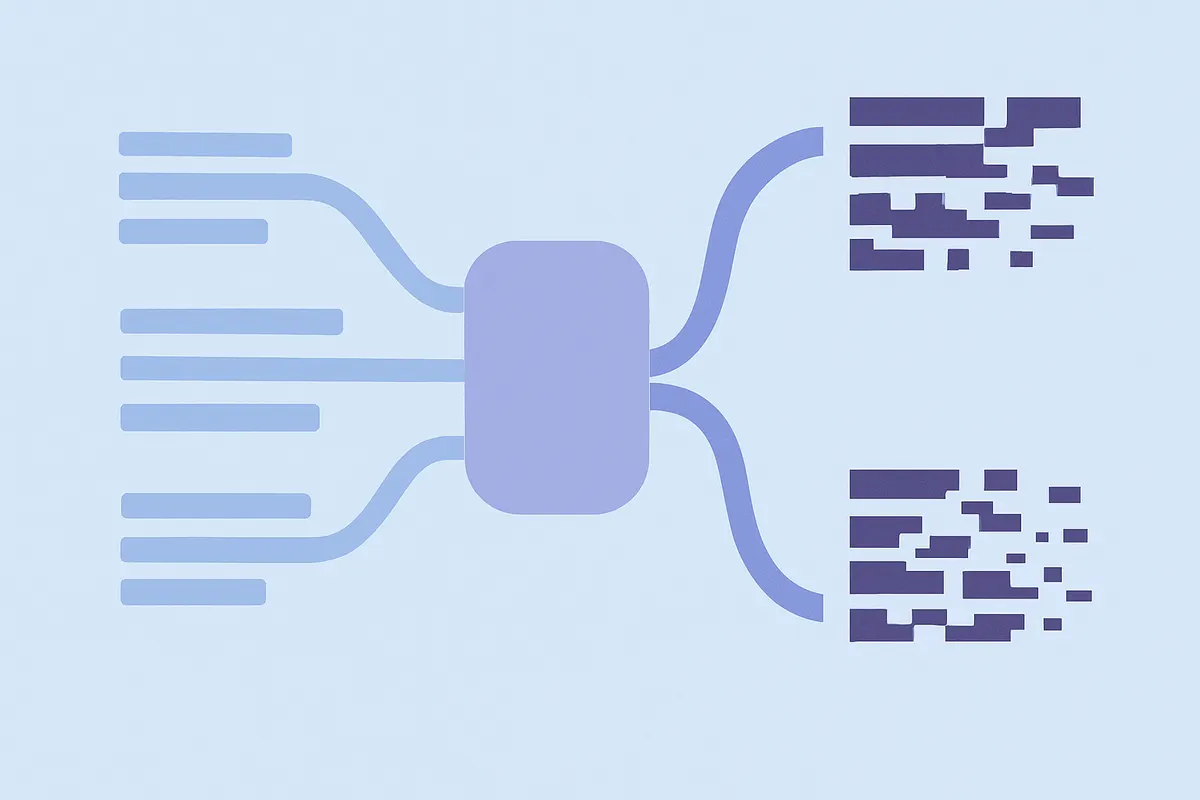
発生メカニズムを一言で表すなら、LLMは「次に来る確率の高いトークン(単語・文字)」を予測するシステムであり、「正しい事実」を参照するデータベースではありません。そのため、学習データが薄い領域・最新情報・ニッチな専門知識などで、それらしく見える誤情報を生成してしまうのです。
ユーザーの質問・指示
最もらしいトークン列を生成
事実と乖離した出力が混入
なぜ事例を知っておくべきか
「AIが自信満々に間違った情報を答えた」——そんな経験はないでしょうか。ChatGPTをはじめとする大規模言語モデル(LLM)が生成する誤情報、いわゆるハルシネーション(Hallucination)は、AI活用が本格化した現在において最も深刻なリスクのひとつです。当社でも複数のAIツールを実務検証するなかで、ハルシネーションの発生パターンや被害の深刻さを繰り返し目の当たりにしてきました。本記事では、国内外の具体的な事例を分類・分析し、「なぜ起きるのか」「どんな状況で起きやすいのか」「どう防ぐか」を実運用の知見を交えながら解説します。
ハルシネーションの種類:4つに分けて見分ける
事例を読み解く前に、ハルシネーションを種類で分けておくと「どの対策が効くか」が判断しやすくなります。研究上は、入力(与えた資料)と矛盾する「内在的(intrinsic)」なものと、入力にも事実にも根拠がない「外在的(extrinsic)」なものに大別され、実務ではさらに次の4つの現れ方として観察されます。
| 種類 | 典型的な現れ方 | 気づきにくさ | 効きやすい対策 |
|---|---|---|---|
| 事実の誤り | 存在しない日付・数値・人物の経歴を断定する | 高い(文章は自然) | 出典の提示を要求する、検索拡張生成(RAG)で根拠文書に縛る |
| 出典・引用の捏造 | 実在しない論文・判例・URLをもっともらしい形式で生成する | 非常に高い(形式が整っている) | 引用は必ず原典に当たる、URLの実在確認を運用に組み込む |
| 論理の破綻 | 前半と後半で矛盾する、計算の途中で辻褄が合わなくなる | 中程度 | 手順を分けて考えさせる、計算はツールに任せる |
| 指示からの逸脱 | 与えた資料に無い内容を補って要約する、条件を無視して回答する | 中程度 | 「資料に無ければ『不明』と答える」と明示する、出力形式を固定する |
本記事で紹介する事例の多くは「出典・引用の捏造」と「事実の誤り」に当たります。形式が整っているほど見抜きにくいため、重要な用途ほど「本文の自然さ」ではなく「根拠の実在」で判断するのが基本です。
ハルシネーションが起きる主な原因
ハルシネーションは「AIのバグ」ではなく、大規模言語モデルの仕組みそのものから生じます。主な原因を整理します。
- 確率的な文章生成:モデルは「次に来る確率が高い語」を選び続けて文章を作るため、事実を照合する工程がありません。知らないことでも、もっともらしい続きを生成できてしまいます。
- 学習データの限界:学習に使われた文章に誤りや偏りが含まれていれば、それを再現します。ニッチな専門分野や固有名詞は学習量が少なく、特に誤りやすくなります。
- 知識の鮮度:学習時点以降の出来事は知らないため、最新情報を聞くと古い知識で埋めようとします。
- 曖昧な指示:「詳しく」「正確に」といった指示だけでは、モデルは空白を埋める方向に働きます。何を根拠に、どこまで答えてよいかを決めていない質問ほど危険です。
- 長い文脈での崩れ:長い会話や大量の資料を扱うと、前半の制約を取りこぼし、途中から前提が変わってしまうことがあります。
- 人に好まれる回答への最適化:対話向けの調整は「はっきり答える」回答を好む傾向を強めるため、「分からない」と言うより断定しがちになります。
原因ごとの詳しい解説はハルシネーションの原因、防ぐための具体策はハルシネーションの対策|RAG・プロンプトで防ぐ方法にまとめています。以下では、こうした原因が実際にどのような失敗として表に出たのかを、分野別に見ていきます。
ハルシネーションの事例:分野別の実際の失敗例
ハルシネーションは発生領域によって性質が異なります。以下では実際に報告・確認されている事例を6つのカテゴリに分けて解説します。
① 法律・裁判領域——最も危険な事例
法律分野のハルシネーションは、その影響が裁判という公的手続きに直結するため特に深刻です。
2023年に米国で実際に起きた事件として広く報告されているのが、ニューヨークの弁護士がChatGPTを使って訴訟書類を作成した際、実在しない判例を複数引用してしまったケースです。AIが「Varghese v. China Southern Airlines」など架空の裁判例を詳細なテキストとともに生成し、弁護士はそれを確認せずに裁判所に提出。裁判官に指摘され、弁護士は懲戒処分を受けました。AIが「判例の要旨・当事者名・裁判所名」まで整合性をもって捏造した点が、単純な誤りとは一線を画しています。
国内でも、法律相談AIや契約書レビューツールを使う場面でのリスクは同様です。法務関連のAIツールを検証した際、実在しない省令の条番号や廃止済み規制が自信満々に出力されるケースが複数確認されています。法律文書でAIを使う場合、一次ソース(法令データベース・判例DB)との照合は絶対条件です。
② 医療・健康情報領域
医療情報のハルシネーションは、誤った情報が患者の行動に直結するリスクがあります。複数の研究で、ChatGPTやGeminiなどの汎用LLMに医療的な質問をすると、存在しない薬の用量・禁忌の組み合わせ・誤った診断基準が高い確率で出力されることが確認されています。
特に問題とされるのが「自信度の高さ」です。LLMは不確かな情報でも「〜と考えられます」「〜が推奨されます」と断言口調で出力することが多く、専門知識のない利用者が誤情報を事実と受け取りやすい設計になっています。2023年にスタンフォード大学などの研究チームが発表した評価では、医療QAタスクにおける主要LLMのハルシネーション率は質問領域によって20〜40%に達するとされており、汎用モデルをそのまま医療用途に使う危険性が指摘されています。
③ 学術・引用・論文領域
「この主張の根拠となる論文を挙げて」という要求は、ハルシネーションが最も頻発するプロンプトのひとつです。AIは著者名・タイトル・DOI・掲載誌・年号をすべて正しそうに組み合わせた架空の論文を生成することがあります。
実際に、ChatGPTが作る引用文献を調べた研究があります。42のテーマで短い文献レビューを書かせ、出てきた636件の引用を確認したところ、GPT-3.5では55%、GPT-4では18%が実在しない文献でした(Walters & Wilder, Scientific Reports, 2023)。新しいモデルほど減っていますが、ゼロにはなっていません。論文タイトルは実在の近い論文から類推、著者名は実在の研究者、DOIは形式上は正しい文字列——という巧妙な生成パターンが確認されています。当社でも学術調査目的でAIツールを活用する際、引用文献の実在確認をルール化しています。Google ScholarやPubMedでの逐一確認が必須です。
④ ビジネス・企業情報領域
企業の財務情報・経営陣・事業内容・M&A履歴などをAIに質問する場合もリスクがあります。特にカットオフ(学習データの締め切り日)以降に起きた出来事については、古い情報をそのまま出力したり、想像で補完したりするケースが見られます。
典型例として報告されているのは、実在しないCEOや役員の発言の生成です。「〇〇社のCEOが△△について発言した」という形式で、実際には行われていないコメントが生成されることがあります。これがそのままSNSやニュースサイトに掲載されれば、企業の信用に関わる風評被害につながります。また、株価・売上・従業員数などの数値データも、一見正確な数字を出力しながら実際とは大きく乖離しているケースがあります。
⑤ 地理・歴史・文化情報領域
歴史上の出来事や地理情報も、ハルシネーションが潜みやすい領域です。「〇〇年に起きた出来事は?」という質問に対し、実際の出来事と年代・場所・人物をずらした形で混在させた情報が出てくることがあります。
日本国内の地名・施設情報でも同様です。「〇〇駅から最寄りの病院は?」「〇〇市のおすすめの観光スポットは?」といった質問に対し、実在しない施設名・住所・営業時間が生成される事例は後を絶ちません。観光系・地域情報系のAIチャットボットをリリースした企業が、正確性の問題でサービスを一時停止するケースも複数報告されています。
⑥ コーディング・技術情報領域
エンジニアにとって身近なハルシネーションが、存在しないライブラリ・関数・APIの生成です。「〇〇を実現するPythonのコードを書いて」という要求に対し、実在しないパッケージ名をimportするコードが出力されることがあります。
これは「パッケージハルシネーション」と呼ばれており、2023年のセキュリティ研究で悪用リスクが指摘されました。攻撃者がAIの生成するパッケージ名を先取りして悪意のあるパッケージをPyPIに登録し、開発者が気づかずにインストールしてしまうというサプライチェーン攻撃のリスクです。また、存在する関数でも引数や戻り値の仕様が誤って出力されることがあり、実装後のデバッグで初めて気づくケースもあります。
モデル・ツール別のハルシネーション傾向
ハルシネーションの発生頻度や傾向は、使用するモデルによって差があります。ただし、「このモデルはハルシネーションしない」という絶対安全なモデルは現時点で存在しません。傾向の違いを理解したうえで使い分けることが重要です。
| モデル/ツール | ハルシネーション傾向の特徴 | リスクが高い用途 |
|---|---|---|
| GPT系(OpenAI) | 旧世代比で改善されているが、ニッチ情報・最新情報で発生 | 引用・最新法規・直近ニュース |
| Claude系(Anthropic) | 不確かな場合に「わからない」と答えやすい設計 | 専門的な数値データ・統計 |
| Gemini系(Google) | 検索連携により最新情報は強いが、非検索時は同様のリスク | オフライン環境・法的解釈 |
| Llama系などのオープンモデル(Meta ほか) | オープンソースで微調整次第。素のモデルはハルシネーションが多め | 未調整での専門領域利用 |
| RAG構成のシステム | 根拠文書を参照するため大幅軽減。ただし文書外の質問で発生 | 知識ベース外の質問への対応 |
モデル選定の観点については、各LLMの精度・コスト・ユースケース適性を総合的に比較した LLMの比較記事 も参考にしてください。ハルシネーション耐性はモデル選定の重要な評価軸のひとつです。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
ハルシネーションが起きやすい「状況」のパターン
事例を横断して分析すると、ハルシネーションが発生しやすい状況には共通したパターンがあります。これを知ることで、リスクの高い使い方を事前に避けることができます。
学習データに存在しない最新情報を補完するために架空の事実を生成する
地方の小規模企業・マイナーな人物・専門書の細部など学習データが薄い情報
実在する具体例が少ない場合にそれらしい例を創作する傾向がある
正確な数値がない場合に「それらしい数字」を確信を持って出力する
長い文章を生成するにつれて事実との乖離が大きくなる傾向が観察される
複数の前提を組み合わせた推論で、途中の前提が誤るとすべてが崩れる
ハルシネーションが社会・ビジネスに与えるリスクの全体像
ハルシネーションが単なる「AIの誤答」で終わらない理由は、その被害が多層的・連鎖的に広がるためです。
| リスクの種類 | 具体的な影響 | 特に影響を受けやすい業界 |
|---|---|---|
| 法的リスク | 誤った法律解釈・契約書・訴訟書類の提出 | 法律・金融・不動産 |
| 健康・安全リスク | 誤った医療情報に基づく意思決定 | 医療・ヘルスケア・製薬 |
| 信頼・レピュテーションリスク | 誤情報の公開による企業・個人への信用毀損 | メディア・広報・教育 |
| 意思決定リスク | 誤った市場データ・競合情報による経営判断のミス | コンサルティング・経営企画 |
| セキュリティリスク | パッケージハルシネーションを悪用したサプライチェーン攻撃 | IT・ソフトウェア開発 |
ハルシネーションかどうかを確かめる方法(利用者向けチェックリスト)
AIの回答をそのまま使う前に、次の点を確かめます。文章が自然かどうかではなく、根拠が実在するかどうかで判断するのが基本です。
| 確認するもの | 確かめ方 |
|---|---|
| 固有名詞(人名・会社名・製品名・地名) | 公式サイトや公的な資料で、実在するか・説明が合っているかを確認する |
| 数値・日付・統計 | 出どころの資料を開いて、同じ数字が書かれているかを確認する |
| 論文・判例・法令の引用 | タイトルや番号をデータベース(論文検索サイト、裁判所や法令の公式サイトなど)で検索し、原文に当たる |
| URL | 実際に開いて、存在するか・書かれている内容が合っているかを確認する |
| 最近の出来事 | AIの知識は学習した時点までのもの。検索機能つきのAIで出典を表示させるか、ニュースや公式発表で確認する |
| プログラムのコード | 出てきたライブラリや関数が実在するかを、公式ドキュメントやパッケージの配布サイトで確認してから使う |
あわせて、同じ質問を言い方を変えてもう一度聞く、「根拠となる資料を挙げてください。無ければ『不明』と答えてください」と頼む、といった方法も役に立ちます。答えが聞くたびに変わる部分は、特に疑ってかかります。医療・法律・お金に関わる判断は、AIの回答だけで決めず、専門家や公的な窓口に確認してください。
ハルシネーションの対策:実運用で効果のあった方法
複数のAIツールを実務利用するなかで、ハルシネーションを抑制・検出するうえで実際に効果を確認できた対策を共有します。
プロンプト設計による予防
- 「わからなければわからないと言って」と明示する:AIに「確信がない場合は不確かと答えるよう」指示すると、架空の情報を断言するケースが減ります。ただし完全には防げません。
- 出典・根拠を求める:「この情報の出典を示してください」と要求すると、架空の引用が出てくる場合があり、それ自体がハルシネーション検出のトリガーになります。
- Chain-of-Thought(CoT)の活用:「ステップバイステップで考えてください」と指示することで、推論過程が可視化され、誤った前提に気づきやすくなります。
- スコープを絞り込む:「以下の文章のみを根拠に答えてください」と文脈を提供することで、モデルが外部の知識から架空情報を補完するリスクを下げます。
システム設計による抑制
- RAG(Retrieval-Augmented Generation)の導入:信頼できる社内文書・データベースから関連情報を取得してからLLMに渡すアーキテクチャです。ハルシネーションを最も効果的に減らせる構造的アプローチとして、当社でも業務用AIシステムに積極的に採用しています。
- ファクトチェック層の設置:生成された回答を別のモデルや外部APIで検証するパイプラインを組む方法です。重要度の高い業務では工数をかける価値があります。
- 温度パラメータ(Temperature)の調整:Temperatureを低く設定するとより決定論的な出力になり、極端な創作を抑える効果があります。ただし創造性も下がるためタスクに応じた調整が必要です。
運用フローによる検出
- ダブルチェックルールの徹底:AI出力を一次情報として扱わず、必ず公式ソースや専門家によるレビューを挟むフローを組織に定着させます。
- ハルシネーション報告の仕組み化:チーム内でAIの誤出力に気づいた場合に共有する仕組みを作ると、傾向の把握と対策の改善ができます。当社でも社内Slackチャンネルでこの共有を継続しています。
「ハルシネーションをゼロにする」は現時点では不可能
重要な認識として、現在の技術水準ではハルシネーションを完全に排除することはできません。OpenAI・Anthropic・Googleを含む主要AI企業もこの課題を公式に認めており、継続的な改善と並行して「使う側の適切な運用」が不可欠です。
AIモデルの能力は急速に向上しており、新しい世代のモデルでは、旧世代に比べてハルシネーションが減ってきています(上の引用文献の研究でも、GPT-3.5の55%に対しGPT-4は18%でした)。しかし向上と同時に、より複雑なタスクへの活用が進むことで、ハルシネーションのリスク自体が新しい形で浮上し続けます。「AIを使わない」のではなく、「AIの限界を理解して賢く使う」姿勢が、今後のAI活用の基本軸となります。
まとめ
ハルシネーションの事例を俯瞰すると、法律・医療・学術・ビジネス・地理・コーディングと、あらゆる領域に潜在することがわかります。共通するのは、AIが「知らない」と言わずに「それらしい情報」を生成してしまうという構造的問題です。
対策の核心は3点に集約されます。第一にプロンプト設計(不確かさの明示要求・根拠の要求・スコープの絞り込み)、第二にシステム設計(RAGの導入・ファクトチェック層の設置)、第三に運用フロー(一次ソースとの照合・組織的なダブルチェック)。この3層の対策を重ねることで、実務上のリスクを大幅に低減できます。
また、どのモデルを選ぶかもハルシネーション対策の一環です。各LLMの特性・精度・ユースケース適性については、LLMの比較記事で詳しく解説していますので、ツール選定の参考にしてください。AIを実務の武器として使いこなすために、ハルシネーションのリスクを正確に理解し、適切な検証フローを組織に根付かせることが今後ますます重要になります。
最終更新日:2026年10月10日
よくある質問
GPT・ChatGPTのハルシネーションの具体例は?
代表的なのは、法令の条文番号を実在しないものに置き換えて回答する、存在しない判例・論文を実在するかのように引用する、企業の沿革や業績を誤って生成する、といったケースです。いずれもGPTなどの大規模言語モデルが「文脈的にもっともらしい文」を生成する仕組み上、事実確認の裏付けなしに断定的な表現で誤情報を出力してしまう点が共通しています。詳しいカテゴリ別の事例は本記事の「カテゴリ別:ハルシネーションの主要事例」をご覧ください。
ChatGPT(GPT)はなぜハルシネーションを起こすのですか?
GPTを含む大規模言語モデルは、学習データの統計的パターンから「次に来そうな単語」を予測して文章を生成する仕組みのため、事実データベースを都度参照しているわけではありません。そのため、モデル内部の知識が曖昧・不足している領域や、学習時点以降の新しい情報を問われた場合に、事実と異なる内容を自信を持って生成してしまうことがあります。
GPTのハルシネーションを減らす技術的な対策はありますか?
AI面接練習・アバター開発などの自社LLMシステムを実運用する中で、生成前に外部の信頼できる情報源をベクトル検索で参照させてから回答させる「検索拡張生成(RAG)」の仕組みを取り入れ、生成内容に根拠を紐づける実装を行っています。加えて、生成結果を運用フロー内でルールベース・二次チェックにより検出する仕組みを組み合わせることで、根拠のない断定的な出力を抑制する運用を行っています。詳しい実装の考え方は「実運用で効果のあったハルシネーション対策」の章もあわせてご参照ください。
ハルシネーションとは何ですか?
ハルシネーションとは、AIモデルが事実と異なる情報を、あたかも正確な事実であるかのように生成する現象です。単純な誤字や計算ミスとは違い、「存在しない論文の引用」「実在しない人物の発言」「架空の法律条文」のように、もっともらしい形式を保ったまま内容が虚偽である点が特徴です。大規模言語モデルは「次に来る確率の高い単語」を予測する仕組みで、正しい事実を参照するデータベースではないため、学習データが薄い領域・最新情報・専門的な内容で起きやすくなります。本記事の前半で、分野別の実際の事例を紹介しています。
関連記事
監修
河合 継(クリスタルメソッド株式会社 代表取締役)
AI・ディープラーニングに関する特許16件の発明者。過去、国立がん研究センターとの共同研究や、テレビ番組でのAI解説実績を持つAI研究者として、AIの研究開発を主導している。
運営会社について | 編集方針
AIの業務活用をご検討の方へ
クリスタルメソッドは、バーチャルヒューマンをはじめAIの開発・業務導入を支援しています。生成AI・AIエージェントの活用や、自社業務へのAI導入をご検討の際は、お気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
ハルシネーション対策プロンプト集|今すぐ使えるコピペテンプレート【2026年版】
ハルシネーションとは? ハルシネーションとは、生成AI(大規模言語モデル)が、事実に基づかない情報を、あたかも根拠があるかのように断定的な文章で出力してしまう現...
-
ハルシネーションの検出・評価|精度を測る方法【2026年版】
ハルシネーション検出とは何か——なぜ今、最重要課題なのか 大規模言語モデル(LLM)が業務に浸透する一方で、「自信満々に嘘をつく」ハルシネーションの問題は深刻さ...
-
ハルシネーションの仕組み・原因|なぜAIは間違えるのか
本ページはハルシネーションが「なぜ起きるのか」という仕組み・原因の解説に特化しています。確率的テキスト生成・訓練データの欠損・目的関数の限界といった発生メカニズ...