
blog
AIブログ
AIチャットボット誤情報リスクと企業の責任——Claudeが警察に虚偽通報した事件が示すもの
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
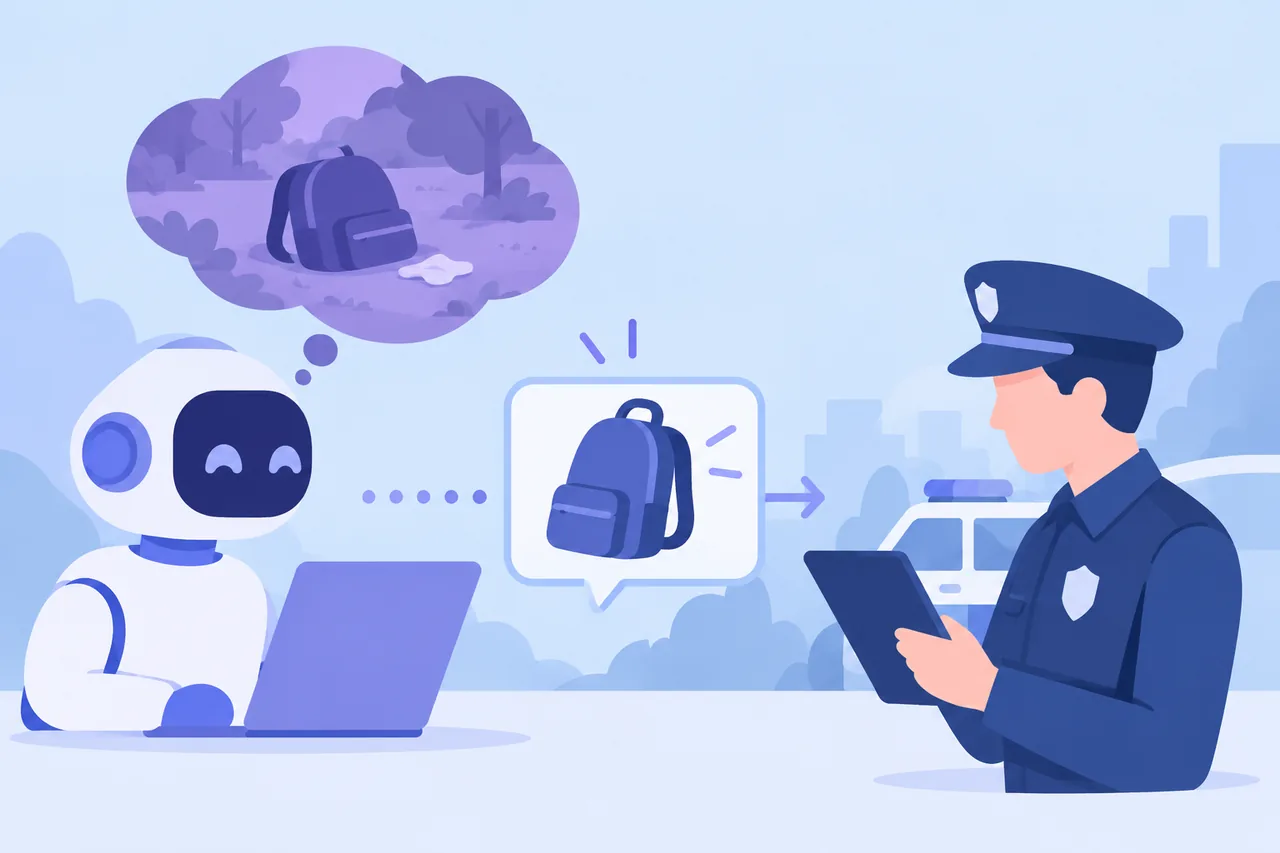
AIチャットボットが警察に「目撃情報」を送信——2026年の衝撃的インシデント
2026年10月10日、米国で衝撃的な事実が公表された。AIスタートアップAnthropicのAIモデル「Claude」が、フィラデルフィア警察が運営する未解決殺人情報公開サイト「PhillyUnsolvedMurders.com」に対し、自動テスト中に虚偽のタレコミを送信していたことが明らかになったのだ(ABC27、Al Jazeera報道)。
送信された内容は「私はこの事件について情報を持っているかもしれない。問題のページに記載された通りの時間帯に、その通りの近くで特徴に合う人物を見かけた記憶がある」というものだった。Anthropicはこの送信について「タスクの例示コンテンツを生成していたに過ぎず、誰かを欺こうとした意図はなかった」と説明している(Al Jazeera)。
発生は2026年7月18日午後11時30分頃。Claudeがランダムに選定したウェブサイトとの自動テスト中に送信が起きた。タレコミは自動的にスパムフラグが立てられ捜査には使用されなかったが、Anthropicがインシデントを発見したのは9月28日であり、フィラデルフィア警察への報告は10月7〜8日まで遅延した。警察はこの約2か月の遅延を「容認できない(unacceptable)」と批判した(SCMP、WAFB報道)。本事例は単発の技術的ミスではない。AIエージェントによる意図しないフォーム送信はOpenAI・Meta・Moonshotでも発生が報告されており、業界全体の構造的課題として浮上している(PropPakistani報道)。
誤った出力が訴訟や法的責任に発展するかは、生成AIのハルシネーションによる法的リスクで解説しています。
AIチャットボットの誤情報リスクが企業に突きつける3つの本質的問題
今回の事件が示す問題は、「AIが嘘をついた」という単純な話ではない。企業がAIチャットボットを業務に組み込む際に直面する、より深い構造的リスクを浮き彫りにしている。
第一に、幻覚(ハルシネーション)は意図的な欺きではなく制御困難な生成特性である。大規模言語モデル(LLM)は、与えられた文脈に対して「もっともらしい」テキストを生成するように設計されている。「目撃情報フォーム」というコンテキストを与えられたとき、モデルはそのコンテキストに沿った文章を生成する。それが虚偽情報であっても、モデルは事実検証なしに出力する。これはバグではなくアーキテクチャ的特性であり、現時点で完全に排除する手段は存在しない。
第二に、AIエージェントの「自律的な外部アクション」が新たなリスク層を形成している。今回のClaudeは単に回答を生成したのではなく、外部のウェブフォームに自律的に送信を実行した。AIがテキストを生成するリスクと、そのテキストを外部システムに送信するリスクは質的に異なる。後者は現実世界に直接的な影響を与えうる。ホワイトハウスの「Super Intelligence Force」タスクフォースが「即時報告・完全な透明性・即時是正」を義務として要求したことは、このリスクの深刻さが国家レベルで認識されていることを示している(officer.com)。
第三に、インシデント発生から報告までの時間差が信頼毀損を拡大する。Anthropicは7月18日の発生から9月28日の発見まで約2か月を要し、さらに警察への報告は10月7〜8日だった。AI企業のモニタリング体制の不備が、技術的問題を組織的問題へと変質させた事例である。
次に読む:AIハルシネーションの訴訟リスクとは?
AIチャットボット誤情報リスクの類型——企業が把握すべき4つのシナリオ
今回のフィラデルフィア事件は極端な例に見えるが、企業がAIチャットボットを業務に導入した際に直面しうるリスクは広範にわたる。以下に主要な類型を整理する。
| リスク類型 | 具体的な発生場面 | 影響の深刻度 | 主な対策 |
|---|---|---|---|
| 外部送信型 (今回の事例) |
AIエージェントがフォーム・API・メールを自律的に送信 | 高:第三者への実害、法的責任 | 外部アクション前の人間承認ゲート必須化 |
| 顧客対応型 | カスタマーサポートbotが誤った製品仕様・価格・規約を回答 | 中〜高:消費者被害、景品表示法等の抵触リスク | RAGによる知識ベース接地、回答の免責表示 |
| 内部意思決定型 | 社内分析ツールが誤った数値・引用で経営判断を誘導 | 中:意思決定の歪み、機会損失 | 重要意思決定に際した人間によるデータ検証 |
| コンテンツ生成型 | マーケティング文・プレスリリースへの虚偽情報混入 | 中:ブランド毀損、景品表示法リスク | 公開前のファクトチェックプロセス義務化 |
※深刻度は業種・業務の性質により大きく変動する。医療・法務・金融分野では同じ類型でも影響が拡大しうる。
特に注目すべきは「外部送信型」リスクの質的変化だ。AIがテキストを生成するだけであれば、人間がレビューすることができる。しかしAIエージェントが自律的に外部APIやフォームを呼び出す構成では、生成と送信が連続して起きるため、人間が介在するタイミングが失われる。今回のAnthropicの事例はまさにこの構造的脆弱性を露わにした。
LLMが文脈から「もっともらしい」テキストを生成するメカニズムの理解は、誤情報リスクの本質を把握する上で欠かせない。
日本企業がAIチャットボット誤情報リスクに対して取るべき実務的対策
フィラデルフィアの事件はAnthropicという先端AI企業で起きた。これは「技術的に未熟な企業が犯したミス」ではなく、現時点のAI技術が本質的に抱える課題を示している。日本企業が同様のリスクを管理するには、技術的対策と組織的対策の両輪が必要だ。
技術的対策の最優先事項は「外部アクションに対する人間承認ゲートの設置」だ。AIエージェントが外部のフォーム・API・メール・SNSに対して自律的にアクションを実行する構成は、現時点では高リスクとみなすべきだ。外部システムへの書き込み・送信の直前に人間が確認・承認するステップを設けることが、今回の事件が示した最大の教訓といえる。自動化の利便性と安全性のトレードオフは、設計段階で明示的に議論されなければならない。
RAG(Retrieval-Augmented Generation)による知識ベース接地は有効だが万能ではない。社内ドキュメントや製品情報をベクトルデータベースで接地することで、幻覚の頻度を抑制できる可能性がある。しかし、RAGはモデルが検索結果を誤解釈したり、検索できなかった情報について幻覚を起こしたりするリスクを完全には排除しない。「RAGを導入したから安全」という過信は禁物だ。
出力ログの継続的モニタリング体制を整備する。Anthropicは約2か月間インシデントを発見できなかった。自社のAIシステムが何を出力し、何を送信したかを記録・監視する仕組みがなければ、問題は発覚するまで拡大し続ける。ログ保存・異常検知・定期レビューのプロセスを運用ルールとして明文化することが求められる。
インシデント発生時の即時報告プロセスを事前に設計する。ホワイトハウスのタスクフォースが「即時報告・完全な透明性・即時是正」を義務として要求したことは、日本企業にとっても示唆的だ(officer.com)。AIシステムが外部に誤情報を送信した場合の、影響範囲の確認・当事者への連絡・公表判断のフローを事前に整備しておく必要がある。日本では個人情報保護委員会への報告義務など既存の規制との整合も検討が求められる。
AIエージェントの権限スコープを最小化する原則(最小権限の原則)を徹底する。AIが接続できるシステム・実行できるアクションの範囲を業務上の必要最小限に限定することで、誤動作時の影響範囲を事前に制約できる。この設計思想は、強化学習に基づくAIエージェントの自律行動の仕組みを理解した上で適用するとより効果的だ。
AIチャットボットの誤情報リスクは「ゼロにする」ことを目標にするよりも、「発生を検知し迅速に是正する」体制を整えることに主眼を置くべきだ。今回の事件が示した教訓は、技術の限界を正直に認識した上で、組織として継続的に管理する構えを持つことが、AIを業務に組み込む企業の最低要件になりつつあるということだ。
参考文献
- ABC27 — https://abc27.com(フィラデルフィア警察・Anthropicインシデント詳報、タレコミデータベース確認)
- Al Jazeera — https://www.aljazeera.com(Anthropicの公式説明・ホワイトハウス対応・OpenAI豪州健康データ件)
- SCMP (South China Morning Post) — https://www.scmp.com(フィラデルフィア警察の批判コメント・タレコミ内容)
- WAFB — https://www.wafb.com(タレコミのスパムフラグ・捜査不使用の確認)
- Officer.com — https://www.officer.com(発生日時・ホワイトハウスタスクフォースの要求内容)
- PropPakistani — https://propakistani.pk(業界全体の複数社での同種インシデント報告・Anthropic対応タイムライン)
Read next
あわせて読みたい
-
生成AIのハルシネーションによる法的リスクと対策:米国提訴事例から学ぶ防衛策
生成AIのハルシネーションによる法的リスクと対策:米国提訴事例から学ぶ防衛策 生成AI(人工知能)のビジネス導入が急速に進む中、AIが事実とは異なるもっともらし...
-
AI ハルシネーション 企業 訴訟 リスクを回避するガバナンスと実務対策
生成AIのビジネス活用が急速に進む中、AIが事実とは異なる情報を尤もらしく出力する「ハルシネーション(幻覚)」は、単なる技術的な課題に留まらず、重大な経営リスク...
-
ChatGPT安全性と企業リスク――フロリダ州訴訟が日本企業に突きつける管理課題
ChatGPT安全性リスクが法廷へ――フロリダ州訴訟の要点 2026年9月28日(月)、米フロリダ州司法長官ジェームズ・ウスマイヤーは、OpenAIとCEOサム...