
blog
AIブログ
ベクトルデータベースとは?仕組み・主要DB比較・選び方をわかりやすく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
ベクトルデータベースとは、文章や画像などをAIで数値の並び(ベクトル)に変換して保存し、キーワードの一致ではなく「意味の近さ」で高速に検索できるデータベースです。RAG(検索拡張生成)や類似検索、レコメンドの土台として使われています。
「ベクトルデータベース」という言葉を耳にする機会が増えたものの、従来のデータベースと何が違うのか、なぜ今これほど注目されているのか、疑問をお持ちの方も多いのではないでしょうか。本記事では、ベクトルデータベースの仕組みから種類・用途・選び方までを、実際に動かした結果と、各社の公式ページで2026年10月29日に確認した無料枠・提供形態を交えて、体系的に解説します。
迷ったらこの3タイプから選びます(結論)
| タイプ | 代表例 | 向く場面 | 費用のかかり方 |
|---|---|---|---|
| フルマネージドの専用DB | Pinecone、Zilliz Cloud(Milvus)、Weaviate Cloud、Qdrant Cloud、Vertex AI Vector Search | 運用の手間を減らして、数千万件規模まで伸ばしたい | 保存量や読み書きの量に応じた従量課金が中心 |
| OSSを自前で運用 | Milvus、Qdrant、Weaviate、Chroma | 機密データを自社環境に置きたい、構成を細かく決めたい | ソフトは無料。サーバー代と運用の手間がかかる |
| 既存DBの拡張 | pgvector(PostgreSQL)、sqlite-vec(SQLite) | いまのDBを使っていて、件数が数万件程度から始めたい | 拡張は無料。いまのDBの費用の範囲で動く |
まず既存DBの拡張で試し、件数や応答速度が足りなくなったら専用DBへ移す順番が、過剰投資を避けやすい進め方です。製品ごとの違いは「主要8製品の比較」、一覧はベクトルデータベース一覧にまとめています。
ベクトルデータベースとは:従来のデータベースとの違い
ベクトルデータベースとは、テキスト・画像・音声などをAIモデルで数値の並び(ベクトル)に変換して保存し、ベクトル同士の「近さ」で似たデータを探すためのデータベースです。AIが作る数値表現のことを埋め込み(Embedding)と呼びます。「この文章と意味が近い資料はどれか」を、キーワードが一致しなくても見つけられる点が最大の特徴です。
従来のリレーショナルデータベース(RDB)は「東京都在住のユーザーを全員取り出す」のような条件に一致するデータを正確に取り出す検索が得意です。ベクトルデータベースは「この質問に意味が近い文書を近い順に返す」検索が得意で、役割が違います。注目されている背景は次の3つです。
- 社内資料や最新情報をLLMに参照させるRAG(検索拡張生成)が広がり、意味で資料を探す部品が必要になった
- 文書・画像・音声など、表にしにくい非構造化データを業務で扱う場面が増えた
- 「自動車」と「クルマ」のような言い換えや文脈の近さで探したい要望が、検索やレコメンドで強まった
| 比較軸 | リレーショナルDB(RDB) | ベクトルデータベース |
|---|---|---|
| 格納するもの | 行と列(表形式) | 高次元のベクトル(数値配列)+元データ・属性 |
| 検索の方式 | 完全一致・範囲条件(SQL) | 近さの順に取り出す近傍検索 |
| 得意なデータ | 構造化データ(数値・日付・カテゴリ) | 非構造化データ(テキスト・画像・音声) |
| 主な用途 | 業務システム・在庫・会計 | RAG・類似検索・レコメンド |
ベクトルデータベースを無料で試し始めるときは、無料プランで選ぶベクトルデータベース比較で解説しています。
ベクトル(Embedding)の仕組み:なぜ数値で「意味」を表せるのか
用語を整理します。スカラーは温度のような1つの数値、ベクトルは複数の数値を並べたもの(例:[0.12, -0.84, 0.31])、テンソルはそれをさらに多次元に広げた数値の配列です。ベクトルデータベースが扱うのは、このうちベクトルです。
Embeddingモデルは、文章や画像を数百〜数千個の数値の並びに変換します。意味が近い「犬」と「猫」は数値の空間でも近くに、遠い「自動車」は離れた位置に置かれます。この「意味の近さ=数値の近さ」がベクトル検索の土台です。検索の流れは次の6段階です。
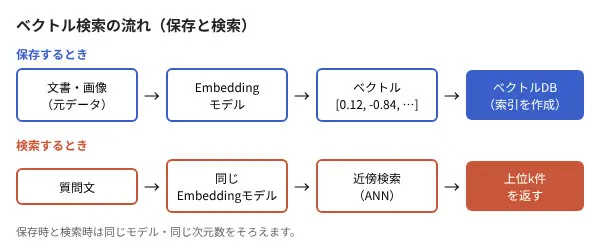
- 生データを用意:文書・画像・音声など
- Embeddingモデルで変換:OpenAIやBGEなどのモデルで数値の並びにする
- ベクトルとして保存:元データや属性(日付・カテゴリ)と一緒にデータベースへ入れ、索引を作る
- 質問も同じモデルで変換:保存時と同じモデルを使うことが前提
- 近いものを探す:距離の近い順に上位k件を取り出す
- 結果を使う:検索結果として見せる、またはLLMへ根拠として渡す
距離の測り方:コサイン類似度・ユークリッド距離・内積
「近さ」の測り方は代表的な3つに加え、データの種類に応じた測り方もあります。モデルが想定している尺度と違う測り方をすると、並び順がずれます。
| 尺度 | 見ているもの | ベクトルの長さの影響 | 近いほど |
|---|---|---|---|
| コサイン類似度 | 向き(角度) | 受けない | 値が大きい |
| ユークリッド距離(L2) | 位置の隔たり | 受ける | 値が小さい |
| 内積 | 向き+長さ | 受ける | 値が大きい |
| マンハッタン距離(L1) | 各成分の差の絶対値の合計 | 受ける | 値が小さい |
| ハミング距離 | 2値ベクトルで値が異なる位置の数 | - | 値が小さい |
| ジャッカード類似度 | 2つの集合の重なりの割合 | - | 値が大きい |
ベクトルを長さ1にそろえる(正規化する)と、内積とコサイン類似度は同じ順序になります。文章の埋め込みではコサイン類似度が広く使われるため、使うモデルの推奨尺度を確認し、必要なら正規化してから検索するのが基本です。pgvectorの公式READMEでは、ユークリッド距離は <->、内積は <#>(負の内積を返す)、コサイン距離は <=>、L1(タクシー)距離は <+>、2値ベクトル向けのハミング距離は <~>、ジャッカード距離は <%> の演算子で指定します。ハミング距離やジャッカード類似度はIBMの解説にも挙げられています(出典:pgvector 公式README、IBM、2026年10月29日確認)。
埋め込みの質が検索の当たり外れを決める
データベースは渡されたベクトルの近さを返すだけで、ベクトルの良し悪しは補正しません。対象データの意味を捉えられないモデルを使うと、どれだけ高性能なデータベースでも検索は当たりません。汎用モデル、多言語モデル、医療・法務などのドメイン特化モデルから選び、日本語を含むデータで実際に確かめます。次元数を増やせば必ず精度が上がるわけではなく、メモリと計算量は増えます。
次に読む:ベクトルデータベースは用途別にどう選ぶ?
近似最近傍探索(ANN):大規模データでも速く探せる理由
数百万件以上のベクトルを全件と比べる総当たり(厳密な最近傍探索)は時間がかかります。そこで多くのベクトルデータベースは、厳密な最近傍でなくても十分に近いものを高速に返す近似最近傍探索(ANN)を使い、速度と引き換えに再現率を少し下げます。pgvectorの公式READMEも「既定は完全な最近傍探索で再現率は100%。近似のインデックスを足すと再現率を少し犠牲にして速度を得る」と説明しています。
| 索引の方式 | 考え方 | 特徴 | 公式に確認できた採用例 |
|---|---|---|---|
| HNSW | 階層的なグラフをたどる | 速度と再現率のバランスが良い。ビルドが遅くメモリを多く使う(pgvector公式README) | pgvector、Milvus |
| IVF(IVFFlat) | ベクトルをクラスタに分けて探す | ビルドが速くメモリも少なめ。クエリ性能はHNSWに劣る(同README) | pgvector(IVFFlat)、Milvus |
| ScaNN | Google Researchの手法 | 大規模向け | Vertex AI Vector Search |
| DiskANN | ディスク上のグラフ索引 | メモリに載り切らない規模向け | Milvus |
| LSH(局所性鋭敏型ハッシュ) | ハッシュ関数で似たベクトルを同じバケットに振り分ける | IBMの解説で、ANNの代表的な方式の一つとして紹介されている | (IBMの解説による方式の紹介) |
| PQ(積量子化) | ベクトルを短いコードに変換して保存する | メモリ使用量を抑えられる(IBMの解説) | Qdrantは量子化の一つとして提供(下記) |
出典:pgvector README、Milvus GitHub、Vertex AI Vector Search 公式(いずれも2026年10月29日確認)。件数が数万件程度なら、索引なしの総当たりでも正確に動くことがあります。
量子化:メモリを減らす代わりに精度を少し手放す
ベクトルが増えるとメモリが先に足りなくなります。そのため、ベクトルの表現を小さくする量子化が使われます。Qdrantの公式ドキュメントでは、次の3方式が説明されています(Qdrant 公式、2026年10月29日確認)。
| 方式 | 内容 | メモリ | 注意点 |
|---|---|---|---|
| スカラー量子化 | 各成分を32ビット浮動小数点から8ビット整数へ | 1/4(4倍圧縮) | 検索品質がわずかに下がる。公式の実験では誤差は通常1%未満と説明 |
| バイナリ量子化 | 各成分を1ビットで表現 | 1/32(32倍圧縮) | 高次元で、成分の分布が中心に寄っている場合のみ効率的。リスコアリングを推奨 |
| 直積量子化(PQ) | ベクトルを分割して各部分を重心の番号で近似 | 最大64倍圧縮 | 距離計算が遅くなり、精度の損失もある。メモリ最優先のとき向け |
pgvectorの公式READMEにも、半精度ベクトル(halfvec)やバイナリ量子化の節があります。どの方式でも、対象データで検索の正確さが許容範囲かを確かめてから採用します。
RDB・全文検索・グラフデータベースとの違い
「ベクトルデータベースは何を置き換えるのか」でつまずく方が多いため、検索の考え方で並べます。置き換えではなく、役割の分担です。
| 種類 | データの持ち方・探し方 | 得意なこと | 苦手なこと |
|---|---|---|---|
| RDB | 表。SQLの条件で探す | ID・日付・金額など正確な条件での抽出 | 言い換えや意味の近さでの検索 |
| 全文検索(BM25など) | 語の出現を索引にして探す | 固有名詞・型番など語の一致 | 表記が違う言い換え |
| グラフデータベース | ノード(実体)とリレーションシップ(関係)で持ち、関係をたどる | 人と組織、部品と部品のような関係の探索 | 文章の意味が近いものを探すこと |
| ベクトルデータベース | ベクトルで持ち、距離の近さで探す | 言い換え・文脈が近い文書や画像の検索 | 完全一致や数値範囲の厳密な検索 |
ベクトルデータベースとグラフデータベースの比較
グラフデータベースは、データをノード・リレーションシップ・プロパティとして格納し、JOINを使わずに関係をたどります(出典:Neo4j 公式ドキュメント、2026年10月29日確認)。「誰が誰に報告しているか」のような関係を深くたどる問いに向きます。ベクトルデータベースは「この文章に意味が近い資料」を探す問いに向きます。ナレッジグラフ(実体と関係の知識)とベクトル検索は競合ではなく、関係をたどりたい部分はグラフ、言い換えを含めて資料を拾いたい部分はベクトルと、一つのRAGの中で併用することもできます。
NoSQL・既存の検索エンジンとの関係
MongoDBのようなNoSQLは柔軟な形のデータをキーや項目で取り出すことが得意で、意味の近さで探すことを目的に作られたものではありません。一方で、検索エンジンやクラウドの検索サービスにはベクトル検索が組み込まれつつあります。たとえばAmazon OpenSearch Serviceのk-NN検索はユークリッド距離またはコサイン類似度で近傍を探せます(AWS公式、2026年10月29日確認)。つまり実際の分かれ目は「専用のベクトルデータベースを選ぶか、使っているDBや検索エンジンの機能で足りるか」です。
ベクトルデータベースのメリットとデメリット
メリット
- 言い換え・表記ゆれに強い:「自動車」と「クルマ」のように文字が違っても、意味が近ければ見つかります
- 非構造化データをそのまま検索対象にできる:文章・画像・音声を同じ方法で探せます
- 件数が増えても速い:ANNで全件と比べずに近いものを返します
- LLMに社内資料を渡せる:RAGで、質問に関係する資料だけを探して文脈にできます
デメリット・注意点
- 理由を説明しにくい:なぜその文書がヒットしたかを、SQLの条件のようには示せません
- 埋め込みモデルの品質に依存する:モデルの選定と評価が検索精度を左右します
- 厳密な条件検索は苦手:「売上100万円以上」のような数値範囲はRDBやメタデータ絞り込みで補います
- 要約やテーマ分析のような問いには向かない:「この文書群全体の傾向は」のように、特定の近い断片を探すのでなく全体を俯瞰する問いは、近傍検索だけでは答えにくく、集計や別の処理が必要です
- 絞り込みとの組み合わせに注意:pgvectorの公式READMEでは、近似インデックスの絞り込みは索引を走査した後に適用されるため、条件に合う行が少ないと返る件数が減ることがあると説明されています(HNSWの既定ef_search=40で全体の10%に当たる条件なら平均4件)。対策として反復インデックススキャンやパーティションなどが挙げられています
- 保存コスト:pgvectorの公式READMEでは、vector型は1件あたり「4×次元数+8バイト」を使うと説明されています。件数が増えるとメモリとディスクの負担が大きくなります
- 埋め込みモデルを変えると作り直し:保存時と検索時のモデルをそろえる必要があり、モデル変更は全件の再変換になります
ベクトルデータベースの主な活用事例
RAG(検索拡張生成):LLMに資料を渡す
最も多い用途がRAGです。LLMは学習時点以降の情報や社内固有の資料を持ちません。RAGでは「質問をベクトル化 → ベクトルデータベースから関連する文書の断片(チャンク)を検索 → LLMに文脈として渡す」という流れで回答を作らせます。ファインチューニングをしなくても、社内FAQや最新の仕様を踏まえた回答ができます。RAG全体の考え方はRAG(検索拡張生成)とはで解説しています。
なお、ベクトルデータベースそのものがハルシネーション(もっともらしい誤り)を減らすわけではありません。減らす助けになるのは、取り出した資料を根拠として渡し、資料にあることだけで答えさせる使い方です。関係のない資料が上位に来れば的外れな根拠から答えてしまうため、埋め込みモデルの選定・チャンクの切り方・ハイブリッド検索で検索の質を上げ、出典を画面に出して人が確かめられるようにします。
セマンティック検索(意味検索)
キーワード検索では別の語として扱われる「自動車」と「クルマ」も、ベクトル検索では近い位置に置かれます。社内Wiki、ドキュメント管理、問い合わせ履歴の検索などで表記ゆれや言い換えを吸収できます。
レコメンデーション
ユーザーの行動や商品の特徴をベクトル化し、近いベクトルを持つ項目を返します。新商品や新規ユーザーでも特徴から候補を出せる点が、コールドスタート問題を和らげる方法として使われます。
画像・マルチモーダル検索
CLIPなどのマルチモーダルモデルは、テキストと画像を同じ空間に置けます。「テキストで画像を探す」「似た画像を探す」用途に使えます。Amazon S3 Vectorsの公式ドキュメントでも、医用画像、画像の重複排除、動画のシーン検索、企業文書検索、パーソナライズが類似検索の用途として挙げられています(AWS公式、2026年10月29日確認)。
重複・異常の検出
正常なデータのベクトル群から大きく外れたものを見つける異常検知・不正検知や、近すぎるものを重複として扱う用途にも使われます。AWSのS3 Vectorsの公式ドキュメントでは、動画の映像から異常を見つける用途、画像の重複排除、著作権侵害の疑いがあるコンテンツの検出が類似検索の例として挙げられています。取引や通信のように「正常な振る舞い」が多数ある領域では、新しいデータが正常群からどれだけ離れているかを距離で測り、しきい値を超えたものを確認対象にします。
主要ベクトルデータベース8製品の比較と無料で試せる範囲
各社の公式ページで、提供形態・検索の機能・無料枠を2026年10月29日に確認しました。数値は公式の記載のみで、速度などのベンチマークは載せていません。無料枠や料金は変わるため、契約前に必ず公式ページを確認してください。製品の網羅的な一覧はベクトルデータベース一覧、無料・OSSの深掘りは無料・OSSのベクトルデータベースにあります。
| 製品 | 提供形態・ライセンス | 検索の特徴(公式) | 無料枠・料金(公式) |
|---|---|---|---|
| Pinecone | クラウドサービス(Starter・Standard・Enterprise) | 1つのインデックスで全文・意味(密ベクトル)・スパースベクトル・ハイブリッド検索。メタデータ絞り込み、namespaceでテナント分離 | Starter:保存2GB・書き込み月200万・読み取り月100万・インデックス5つ。リージョンはAWSのus-east-1のみ。Standardは月額最低50ドル |
| Weaviate | OSS(BSD-3-Clause)+Weaviate Cloud | ベクトル検索とBM25Fの結果を統合するハイブリッド検索。alphaで重みを調整 | Free:1クラスタ・10万オブジェクト・メモリ1GB・ディスク10GB。Flexは月額45ドルから |
| Milvus | OSS(Apache-2.0)+Zilliz Cloud | HNSW・IVF・DiskANNなど複数の索引。密・疎ベクトル、BM25全文検索、複数の検索結果を再ランクして統合 | Zilliz Cloud Free:保存5GB・月250万vCU・コレクション5つまで |
| Qdrant | OSS(Apache-2.0、Rust製)+Qdrant Cloud | Query APIのprefetchで密・疎ベクトルを組み合わせ、RRFまたはDBSFで融合。ペイロードで絞り込み | Free:1ノード(0.5vCPU・1GB RAM・4GBディスク)、期限なし。有料は従量課金。Hybrid Cloudは自社インフラ上で運用 |
| Chroma | OSS(Apache-2.0)+Chroma Cloud | 密・疎・ハイブリッド検索、全文・正規表現検索、メタデータ絞り込み | Starter:月0ドル+従量課金、5ドル分のクレジット付き。保存1GiBあたり月0.33ドル、書き込み1GiBあたり2.50ドル |
| pgvector | PostgreSQLの拡張(OSS) | HNSW・IVFFlat。L2・内積・コサイン・L1などの距離。PostgreSQLの全文検索と組み合わせてハイブリッド検索 | 拡張は無料。いまのPostgreSQLの費用の範囲で動く |
| Amazon OpenSearch Service | AWSのマネージドな検索サービス | k-NN検索(ユークリッド距離・コサイン類似度)。knn_vectorは1項目に最大1万次元 | 本記事では料金ページを未確認。AWSの料金ページで確認 |
| Vertex AI Vector Search | Google Cloudのサービス | ScaNNベース。密・疎の埋め込みによるハイブリッド検索、Restrictによる絞り込み | デプロイしたインデックスをホストするVMと、構築・更新の費用がかかる |
出典:Pinecone 料金・Pinecone ドキュメント、Weaviate 料金・Weaviate ハイブリッド検索・GitHub、Milvus GitHub・Zilliz 料金、Qdrant 料金・Qdrant ハイブリッド検索・GitHub、Chroma 料金・Chroma ドキュメント・GitHub、pgvector README、OpenSearch Service k-NN、Vertex AI Vector Search(2026年10月29日確認)。
費用のかかり方の3パターン
| 提供形態 | 費用のかかり方 | 気をつける点 |
|---|---|---|
| 既存DBに足す(pgvector・sqlite-vecなど) | 拡張は無料。いまのDBの費用の範囲 | 件数が増えるとメモリやディスクの増強が必要 |
| OSSを自分で運用(Milvus・Qdrant・Weaviate・Chroma) | ソフトは無料。サーバー代と運用の手間 | 監視・バックアップ・更新を自分で行う |
| マネージドサービス(Pinecone・各OSSのクラウド版) | 保存量や読み書きの量に応じた従量課金が中心 | 無料枠の範囲、最低利用料、データの置き場所(リージョン) |
大手クラウドで使えるベクトル検索:専用DBを契約しない選択肢
すでにAWS・Azure・Google Cloudを使っているなら、同じ基盤の機能で始める選択肢もあります。公式ドキュメントで確認できた特徴です(2026年10月29日確認)。
| サービス | 公式に確認できた特徴 | 向く場面 |
|---|---|---|
| Amazon S3 Vectors | ベクトルを保存・検索できる専用のバケット。たまにしか実行しないクエリは1秒未満、頻繁なクエリは100ミリ秒程度まで。Bedrock Knowledge BasesのベクトルストアやOpenSearchと連携 | 保存コストを抑えたい、検索の頻度がそれほど高くないとき |
| Azure AI Search | ベクトル検索・ハイブリッド検索(ベクトルとキーワードを同じリクエストで実行)・絞り込み付き検索。ベクトル検索は全リージョン・全階層で追加料金なし(埋め込み生成の費用は別) | Azure上のデータからRAGを組むとき |
| Vertex AI Vector Search | Google Researchの技術に基づくScaNNを中核にした検索エンジン。密・疎の埋め込みを使うハイブリッド検索 | Google Cloud上で大規模な類似検索や推薦を組むとき |
出典:AWS S3 Vectors、Microsoft Learn(Azure AI Search)、Google Cloud。
導入判断と選び方:専用ベクトルデータベースは本当に必要か
製品を比べる前に、そもそも専用のベクトルデータベースが必要かを判断します。ここを飛ばすと、既存の仕組みで足りたのに運用対象を一つ増やしてしまいがちです。
導入を前向きに検討するサイン
- 意味・類似での検索が本質的に必要:RAGの根拠検索、FAQや問い合わせの意味での照合、レコメンドなど
- ベクトルの件数が増え続け、総当たり計算が重くなってきた
- メタデータで絞り込みながら近いものを低遅延で返したい:特定ユーザー・期間・カテゴリに限定した類似検索など
見送ってよいケース
- 完全一致・キーワードで足りる:ID・タグ・属性の絞り込みは、既存のRDBや全文検索のほうが速く安く運用も楽です
- 件数が少なく、変化も小さい:FAISSなどのライブラリやメモリ上の近似検索で足りることが多いです
- すでにPostgreSQLを運用している:まずpgvectorで既存DBの中で検証し、規模や遅延が合わなくなってから専用DBへ移します
検索方式の使い分け
| 検索方式 | 得意なこと | 向く場面 |
|---|---|---|
| キーワード/全文検索(BM25) | 語の一致 | 固有名詞・型番・完全一致で確実に当てたい |
| RDBの絞り込み(WHERE) | 属性・範囲での正確な抽出 | ID・カテゴリ・期間などの構造化条件 |
| ベクトル検索 | 意味・文脈の近さ | 言い換えや文意の類似で拾いたい(RAGの根拠検索など) |
| ハイブリッド(全文+ベクトル) | 一致と意味の両取り | キーワードも意味も両立させたい本番検索 |
製品選びの観点
| 観点 | 確認すること |
|---|---|
| データ規模 | 数万件ならpgvectorやChromaの単一構成でも足りることが多く、数千万件以上は分散構成やマネージドを検討 |
| 埋め込みモデルとの整合 | 保存と検索で同じモデル・同じ次元数を使う。次元数がインデックスの上限(pgvectorは2,000次元まで)に収まるか |
| 応答速度の要件 | 利用者向けのリアルタイム検索か、バッチか。ANNの設定(HNSWなど)で調整 |
| 絞り込みの要件 | メタデータ絞り込みの機能と、絞り込み後に返る件数。pgvectorのREADMEには絞り込みとインデックスの組み合わせ方の節がある |
| データの置き場所 | 機密データをSaaSに送れるか。セルフホスト(OSS)、Qdrantのような自社インフラ上のHybrid Cloud、自社クラウドのサービスが選択肢 |
| セキュリティ・ガバナンス | 暗号化・アクセス制御・監査ログ・SSOがあるか、どのプランで使えるか |
セキュリティ・ガバナンスで確認すること
埋め込みやメタデータにも、元の文書と同じ機密性があります。IBMの解説でも、規制や社内要件への適合とアクセス制御でデータの保護水準を保つ必要があると説明されています。一例として、Pineconeの公式ドキュメントには次の機能が書かれています(Pinecone セキュリティ、2026年10月29日確認)。
| 確認項目 | Pineconeの公式の記載 | 提供プラン(公式) |
|---|---|---|
| 暗号化 | 保存時はAES-256、転送時はTLS 1.2。自分のクラウドKMSの鍵で暗号化するCMEKにも対応(現在はAWS KMS) | ページ内に記載なし |
| アクセス制御(RBAC) | ユーザー・APIキー・サービスアカウントにロールを割り当て、組織またはプロジェクト単位で管理 | ページ内に記載なし |
| 監査ログ | ユーザーとAPIの操作を記録し、約30分ごとにJSONファイルとして保存 | Enterprise、またはHIPAAコンプライアンスのアドオン |
| SSO | 組織のID管理を通じたサインイン。Oktaの設定例あり | Standard、Enterprise |
ほかの製品も同じ観点で確認します。Qdrantは、自社のインフラ上でマネージドクラスタを運用するHybrid Cloudや、隔離された専用環境のPrivate Cloudを用意しています(Qdrant 料金、2026年10月29日確認)。
迷ったときは「まず既存の手段(全文検索・pgvector)で検証し、規模や遅延で頭打ちになったら専用のベクトルデータベースへ移す」順番が、過剰投資を避けやすい進め方です。
ベクトルデータベースの始め方:最小構成で試す
専用サービスを契約しなくても試せます。流れは「文章をベクトルにする → 保存する → 質問も同じモデルでベクトルにして近い順に取り出す」の3ステップです。
実際に動かした結果:言葉が違っても「意味が近い文」が見つかる
ベクトル検索で何が起きるかを小さな例で確かめました。SQLiteの拡張機能sqlite-vec(v0.1.9)に、日本語の短い例文5件を埋め込みベクトル(Voyage AIのvoyage-3・1024次元)にして保存し、「クルマを買い替えたい」に近い順に並べています。例文は検証用に用意した短い文です。
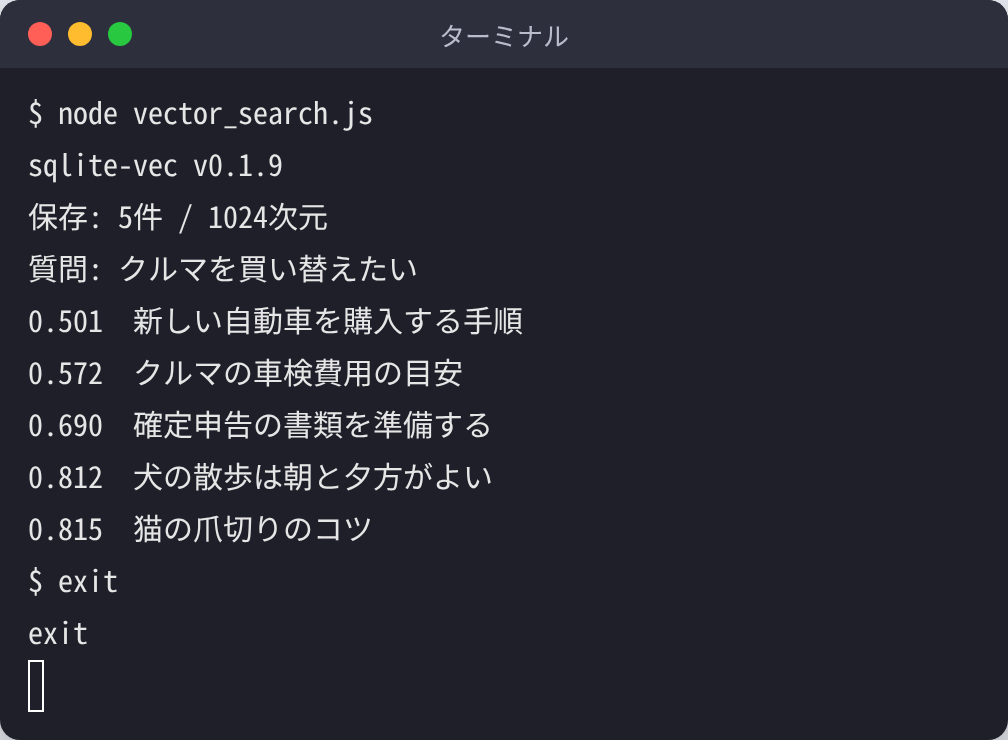
距離(コサイン距離)は小さいほど近く、「クルマ」と文字が違う「新しい自動車を購入する手順」が最も近い(0.501)と返りました。2位は同じ「クルマ」を含む車検費用の文(0.572)で、確定申告・犬・猫の文は0.69〜0.82と離れています。キーワードの一致ではなく、意味の近さで並んでいることが分かります。
実運用の構成例:用途ごとに選んだデータベース(2026年10月時点)
| システム | データベース | 埋め込みモデル | 用途 |
|---|---|---|---|
| SEO分析システム | SQLite+sqlite-vec(1024次元) | Voyage AI voyage-3 | 自社記事どうしの内容の重複検出、記事のグループ分け、内部リンク候補の抽出(約15万ベクトル) |
| SNS投稿管理システム | SQLite+sqlite-vec | Voyage AI voyage-3 | 投稿の重複・類似チェック |
| 開発支援システム(エラー学習) | PostgreSQL+pgvector(ivfflat) | OpenAI text-embedding-ada-002(1536次元) | 過去のエラー事例7,548件から似た事例を検索 |
| 映像生成プロジェクト | PostgreSQL+pgvector(ivfflat、lists=100) | - | 動画キャプションを使ったRAG |
ファイル1つで動くSQLiteの分析ツールにはsqlite-vec、PostgreSQLを持つシステムにはpgvectorと、手元のデータベースに合わせて選んでいます。
つまずいた点:距離の種類をそろえる
sqlite-vecの仮想テーブル(vec0)が返す距離はL2(ユークリッド距離)です。一方、文章の意味の近さはコサイン類似度で判定するのが一般的です。そのためSEO分析システムでは、保存したベクトルを取り出してコサイン類似度を計算し直し、「0.9以上なら内容が重複している」と判定しています。pgvectorでは演算子 <=> でコサイン距離を直接使えます(類似度=1−距離)。
PostgreSQLなら:pgvector
pgvectorの公式READMEにある最小の例です(3次元のベクトルを保存し、近い順に5件取り出します)。
CREATE EXTENSION vector;

CREATE TABLE items (id bigserial PRIMARY KEY, embedding vector(3));

INSERT INTO items (embedding) VALUES ('[1,2,3]'), ('[4,5,6]');

SELECT * FROM items ORDER BY embedding <-> '[3,1,2]' LIMIT 5;実際の埋め込みは数百〜数千次元なので、vector(3) の数字は使うモデルの次元数に合わせます。公式READMEでは、vector型は最大16,000次元、インデックス(HNSW・IVFFlat)を作れるのは2,000次元までとされています(出典:pgvector 公式README、2026年10月29日確認)。
Pythonですぐ動かすなら:Chroma
Chromaの公式READMEにある最小のコードです。メモリ上で動き、文書を追加して近い順に2件取り出します(出典:Chroma GitHub、2026年10月29日確認)。
pip install chromadbimport chromadb
client = chromadb.Client()
collection = client.create_collection("all-my-documents")
collection.add(
documents=["This is document1", "This is document2"],
metadatas=[{"source": "notion"}, {"source": "google-docs"}],
ids=["doc1", "doc2"],
)
results = collection.query(
query_texts=["This is a query document"],
n_results=2,
)フレームワークから使う:LangChain
RAGを組むときは、LangChainなどのフレームワーク経由でベクトルデータベースを使うことが多くあります。LangChainは共通のインターフェース(add_documents・similarity_search など)を用意しており、ストアごとに統合パッケージがあります(LangChain 公式、2026年10月29日確認)。ただし、メタデータによる絞り込みへの対応は実装ごとに異なるため、使うストアのドキュメントで確認します。
| ベクトルストア | 統合パッケージ |
|---|---|
| Chroma | langchain-chroma |
| Pinecone | langchain-pinecone |
| Qdrant | langchain-qdrant |
| PGVector(pgvector) | langchain-postgres |
| Milvus | langchain-milvus |
| Weaviate | langchain-weaviate |
RAG全体の組み立て(チャンク分割・LLMへの受け渡し)はベクトルデータベース入門で扱っています。
ベクトルデータベースとハイブリッド検索
ベクトル検索だけでは、人名・商品コード・条文番号のような固有名詞の完全一致を取りこぼすことがあります。そこで、キーワード検索(BM25など)とベクトル検索の結果を組み合わせるハイブリッド検索が使われます。融合のしかたは製品で違い、たとえばQdrantはRRF(順位ベース)とDBSF(スコア分布ベース)を選べ、Weaviateは相対スコアによる統合と順位による統合を選べます。pgvectorは、PostgreSQLの全文検索と組み合わせ、READMEの案内するRRFなどで結果を合わせます(Qdrant、Weaviate、pgvector、2026年10月29日確認)。
ハイブリッド検索が特に効くのは、製品番号・SKUなど固有IDを含む検索、人名・地名・法律名などの固有表現が重要な文書検索、「意味が似ているが表現が違う文書」と「同じ語を含む文書」の両方を拾いたい場合です。
ベクトルデータベースの今後:マルチモーダルとAIエージェント
一つ目はマルチモーダル化です。テキストだけでなく画像・音声などを同じ空間で扱うモデルが増え、「テキストで画像を探す」といった横断検索が現実的になっています。二つ目はAIエージェントの記憶としての利用です。エージェントが過去のやりとりや調べた内容をベクトルとして保存し、必要なときに呼び出す使い方が広がっています。AWSがS3 Vectorsを「AIエージェント、推論、RAG、意味検索向け」と位置づけている(上記の公式ドキュメント)ように、クラウド側もこの用途を前提にした提供を進めています。
よくある質問
ベクトルデータベースとは何ですか?
文章や画像などをAIで数値の並び(ベクトル)に変換して保存し、キーワードの一致ではなく「意味の近さ」で検索できるデータベースです。
従来のデータベース(RDB)とは何が違いますか?
RDBは「条件に一致するものを正確に取り出す」検索が得意です。ベクトルデータベースは「意味や文脈が近いものを順に取り出す」検索が得意で、言い換えや表現の違いがあっても関連する情報を見つけられます。数値や日付の範囲で絞る検索はRDBのほうが向いています。
ベクトルデータベースは無料で使えますか?
使えます。pgvector(PostgreSQLの拡張機能)やsqlite-vec、Milvus・Qdrant・Weaviate・Chromaなどはオープンソースで、ソフトウェア自体は無料です。自分で運用する場合はサーバー代と運用の手間がかかります。PineconeやQdrant Cloudなどのマネージドサービスにも無料枠があります。
RAGにベクトルデータベースは必須ですか?
必須ではありません。RAGで大事なのは「質問に関係する資料を探して渡す」ことで、件数が少なければ全文検索や既存のデータベースでも実現できます。言い換えに強い検索が必要になり、件数も増えてきた段階で、ベクトル検索が有効になります。
どのベクトルデータベースを選べばよいですか?
まずは今あるデータベースに足す方法(PostgreSQLならpgvector、SQLiteならsqlite-vec)で試し、件数や応答速度の要件が合わなくなったら、専用のデータベースやマネージドサービスを検討する順番が、費用を抑えやすい進め方です。
まとめ
ベクトルデータベースは、文章・画像・音声などをベクトルとして保存し、意味の近さで高速に探すためのデータ基盤です。RDB・全文検索・グラフデータベースの代わりではなく、意味で探す部分を受け持つ部品として組み合わせます。
選ぶときは、データ規模、埋め込みモデルとの整合、応答速度、ハイブリッド検索や絞り込みの必要、データの置き場所を軸にします。まず既存のDBに足して試し、足りなくなったら専用のサービスへ進む順番が、無駄な投資を避けやすい進め方です。RAGで使うLLMの選び方はAIモデルの比較も参考にしてください。
関連記事
ベクトルデータベースの関連記事
AIの業務活用をご検討の方へ
クリスタルメソッドは、バーチャルヒューマンをはじめAIの開発・業務導入を支援しています。生成AI・AIエージェントの活用や、自社業務へのAI導入をご検討の際は、お気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
ベクトルデータベース比較|無料プランで選ぶ2026年版
sqlite-vecとは?SQLiteだけで無料でベクトル検索を実装する方法 sqlite-vecは、既存のSQLiteに読み込むだけでベクトル検索を追加できる...
-
ベクトルデータベース一覧:主要サービスの比較と用途別の選び方
ベクトルデータベースは、文章や画像を数値の並び(ベクトル)として保存し、意味の近いデータを高速に探せるデータベースです。主な製品には、Pinecone・Weav...
-
ベクトルデータベース入門:RAGでの使い方と最小構成での始め方
ベクトルデータベースとは?まず「何ができるのか」からやさしく解説 ベクトルデータベースとは、文章や画像がもつ「意味の近さ」を数値の列(ベクトル)に変換して保存し...