
blog
AIブログ
AIイラストとは?無料で作れるツール・作り方・著作権の注意点をわかりやすく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
AIイラストとは、文章(プロンプト)や参考画像を入力すると、人工知能が自動でイラストを描いてくれるものです。絵の経験がなくても、ChatGPT・Canva・Adobe Firefly・Geminiなどの無料枠を使えば、今日から1枚作れます。
最短で1枚作るなら
- 日本語でそのまま頼みたい:ChatGPT または Gemini(無料枠あり・回数に上限)
- SNS画像や資料までまとめて作りたい:Canva(無料プランあり)
- 商用を前提に考えたい:Adobe Firefly(無料プランあり・条件は規約で確認)
この記事は、疑問の出る順に、イラストAIとは何か、無料ツールの比較と無料枠の仕組み、作り方とプロンプトの書き方、思い通りにならないときの対処、仕上げと保存、スマホアプリ、用途別の向き不向きとプロンプト例、無料プランの安全面(商用・学習・年齢)、商用利用と著作権、うまく描けない理由(仕組み)、活用シーンとメリット・デメリットを解説します。
AIイラストとは何か
AIイラストとは、人工知能(AI)の画像生成モデルを使って自動的に生成されたイラスト・画像のことです。ユーザーがテキスト(プロンプト)や参考画像を入力すると、AIが学習データをもとに画像を出力します。従来の「デジタルイラスト」が人間の手によるペンタブレット操作で描かれるのに対し、こちらはアルゴリズムが自動的にピクセルを生成する点が本質的な違いです。
呼び方はさまざまで、「AI生成画像」「生成AIアート」「AI絵」とも呼ばれますが、いずれも指すものは同じです。アニメ風・写実風・水彩風・油絵風など多様なスタイルを指定できるため、用途に応じた表現が可能です。
初心者が実際に絵を生成するにはどうすればいいかは、AIイラストの作り方・生成手順で解説しています。
関連記事AIイラストの料金はいくら?
無料で使えるイラストAIの比較と、最初の1枚の選び方
結論:イラストAI(AIでイラストを作るツール)は、まず無料枠のあるChatGPT・Canva・Adobe Firefly・Geminiのどれかで1枚試すのが最短です。下の表は、無料枠・商用可否・日本語とスマホ対応・写真からイラストへの変換を、各社の公式ページに書かれている範囲だけで整理したものです(2026年10月19日確認。「記載なし」は、確認した公式ページにその記述が無かったという意味で、使えないという意味ではありません)。
無料で試せるイラストAIの比較表(公式確認・2026年10月19日)
| ツール | 無料枠 | 商用利用 | 日本語・スマホ | 写真→イラスト変換 |
|---|---|---|---|---|
| ChatGPT(ChatGPT Images) | 無料版でも画像生成は使えるが、画像生成には個別の利用上限がある。上限に達すると通知される(OpenAI公式の無料版FAQ) | OpenAIの利用規約(2026年1月1日施行版)は、出力は利用者が所有し、OpenAIが持つ権利は利用者に譲渡すると定める。ただし似た出力が他の利用者に出ることがあり、他者や第三者の出力には及ばない | FAQには記載なし(本記事の作例は日本語の指示で生成) | 公式FAQには記載なし |
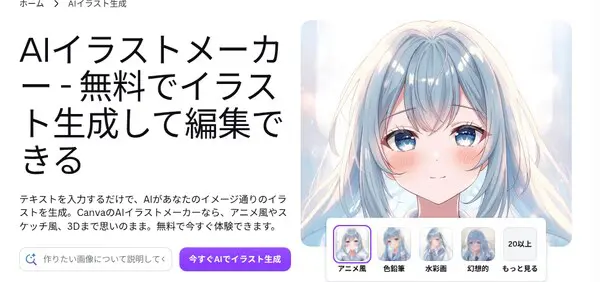
| Canva | 無料プランあり。料金ページ(https://www.canva.com/ja_jp/pricing/)には「標準モデルの機能または高品質モデルの機能を最大20回」、AI生成ページ(https://www.canva.com/ja_jp/ai-illust-generator/)には「標準モデルで最大200回、高品質モデルで最大20回」と書かれていて、公式ページ間で記載が異なります(どちらも2026年10月29日確認)。最高品質モデルは無料では不可(料金ページ) | 個人利用・商用利用の両方に使える。ただしAI出力は排他的な権利を持てない場合があり、実在の人物・キャラクター・ブランドが含まれる場合は権利者の許可が必要(公式ヘルプ) | 日本語の公式ページあり。iOS・Androidの公式アプリあり(AI生成ページのFAQ・2026年10月29日確認) | AIフィルターが無料。スケッチ・カートゥーン・アニメ・古典絵画などのスタイルを、アップロードした画像に適用できる(公式) |
| Adobe Firefly | 無料プランあり(1日あたりの生成回数に上限。超える場合は有料) | Fireflyの独自モデルは商用利用に適すると公式に記載。パートナーモデルは条件が異なる場合あり | 100を超える言語のプロンプトに対応と公式に記載(日本語は個別に明記なし)。iOS・Android向けアプリあり | 「画像から画像生成」が無料アカウントでも毎日の無料枠で使える。参照画像のスタイルや構図に合わせた生成にも対応(公式) |
| Gemini(Nano Banana 2) | Nano Banana 2での画像生成は無料枠で可能。有料のGoogle AIプランで上位モデルも使える(Geminiアプリ公式ヘルプ) | 画像生成のヘルプには出力の商用可否の記載なし。第三者の著作権・プライバシーを侵害しないこと、公開前に自分で確認することが求められる | 日本語のヘルプあり。iPhone・Android・パソコンのGeminiアプリで生成・編集できる | 手元の画像をアップロードして、チャットで指示して編集できる(18歳未満は画像編集不可) |
| PixAI | 公式トップに「Start for free」とあるが、無料枠の範囲は記載なし | 公式トップには記載なし | 公式トップにアプリ(App Store・Google Play)の案内あり。日本語は記載なし | 公式トップには記載なし |
| Midjourney | 無料プランは確認できず(公式ヘルプに、Discordでの無料トライアルは現在なしとの記載)。有料は月額10/30/60/120ドルの4プラン | 利用規約で、作成した画像は利用者が所有。4プランとも商用条件は同じ。年商100万ドル超の企業は、Pro以上のプランに加入している必要がある(公式) | 公式ヘルプでは日本語対応の記載なし。スマホは、別アプリ「niji journey」の案内あり | 今回確認した公式ページには記載なし |
NovelAIとStable Diffusionは、この表の項目を公式ページで確認できた範囲が限られるため表には含めず、下の特徴・料金表で触れています。商用で使う場合は、どのツールでも「生成物の権利は利用者のものか」「排他的な権利を持てない可能性があるか」「実在の人物・ブランドを含めないか」を公開前に自分で確認してください(詳しくは本記事「商用利用と著作権」の項を参照)。
下の表は、ツールごとの特徴と料金の目安です。
| ツール名 | 特徴 | 主な用途 | 料金 |
|---|---|---|---|
| Midjourney | 芸術性・美観に優れた画像生成。アーティスト風スタイルが得意 | コンセプトアート、SNS用ビジュアル | 月額10/30/60/120ドルの4プラン(年払いは約20%引き) |
| Stable Diffusion | オープンソース。ローカル環境で動作可能。高いカスタマイズ性 | 開発・研究・二次元イラスト | 無料(自前サーバー必要)〜クラウド従量課金 |
| ChatGPT(ChatGPT Images) | ChatGPTと統合。日本語プロンプト対応、指示の解釈精度が高い | ブログ・資料の挿絵、多目的 | 無料プランは回数制限あり。Go・Plus・Proで上限が拡大 |
| Adobe Firefly | Adobe Stock・ライセンス取得済みコンテンツ・パブリックドメイン素材で学習。商用利用を想定した設計 | 商業デザイン、広告 | 無料プランあり(1日あたりの生成回数に上限)。個人向けの有料プランは月額1,580円(Standard)〜31,680円(Premium)の4プラン(2026年10月、Adobe公式プランページで確認) |
| Canva AI(Magic Media) | デザインツールに統合。操作が直感的でノンデザイナー向け | SNS投稿、プレゼン資料 | 無料プランは回数に上限あり。有料プランで拡大 |
| NovelAI / Nijijourney | アニメ・マンガ調イラストに特化。日本的なキャラクター表現が得意 | 二次元イラスト、ゲーム素材 | NovelAIは月額10/15/25ドルの3プラン(公式ドキュメントより) |
| PixAI | アニメ調のイラスト生成に特化したWebサービス(公式トップより)。コミュニティが公開したモデルやLoRAを選んで生成できる | 二次元イラスト、キャラクター作成 | 「無料で始める」と案内。料金・無料枠の数字は公式トップに記載がなく、メンバーシップとクレジット購入のページで確認 |
| Gemini(Nano Banana) | Geminiアプリで使える画像生成・編集モデル。文字入れ、複数写真の合成、キャラクターの一貫性保持に対応 | SNS画像、ポスター、写真の編集 | Nano Banana 2は無料。Nano Banana 2.1はGoogle AIの有料プラン |
写真をイラストに変換できるツール
「手持ちの写真をイラスト風にしたい」という使い方は、イラストAIの定番の用途です。公式ページで確認できた範囲では、次の3つがあります(2026年10月19日確認)。
- Canva:AIフィルターで、アップロードした画像にスケッチ・カートゥーン・アニメ・古典絵画などのスタイルを適用できます。AIフィルターは無料で使えると公式に案内されています。
- Adobe Firefly:「画像から画像生成」で、用意した画像をアップロードし、そのスタイルに沿って別のテイストの画像に変換できます。無料アカウントでも毎日の無料枠で使えます。
- Gemini:デバイスの画像をアップロードし、チャットで「水彩画風にして」のように指示して編集できます。
人物の写真を使うときは、本人や写っている人の同意と、元の写真の権利を先に確認してください。

今すぐ無料で試す3つの選択肢
ツール選びで迷ったら、まず以下いずれかを無料で試してから本格導入を検討するのが失敗しない進め方です。
- ChatGPT(無料プラン):
chatgpt.comにアクセスし、チャット欄に「〇〇のイラストを描いて」と日本語でそのまま入力するだけ。無料プランでも画像を作れますが、回数に制限があります(上限に達すると、回復する時刻が画面に表示されます)。日本語の指示精度が高く、初めての1枚を試すのに最も手軽です。 - Canva(Magic Media・無料枠):
canva.comで新規デザインを作成し、「Magic Media」機能から生成。無料アカウントでも一定回数のクレジットが付与され、SNS用画像への貼り付けまでワンストップで完結します。 - Microsoft Copilot(画像生成・無料):
copilot.microsoft.comにMicrosoftアカウントでログインし、チャットで画像生成を指示します。無料で試せますが、利用枠はMicrosoftの案内で変わるため、画面の表示を確認してください。
次に読む:AIイラストを無料で作るには?
無料枠の仕組み:回数制か、クレジット制か
「無料」といっても、ツールによって数え方が違います。使う前に、次の違いだけ押さえておくと、途中で止まって慌てずに済みます(2026年10月29日、各公式ページで確認)。
- 回数の上限が決まっているタイプ:ChatGPTは無料版でも画像生成が使え、個別の利用上限があります。上限に達すると通知され、回復する時刻が画面に出ます。Adobe Fireflyは1日あたりの生成回数に上限があります。
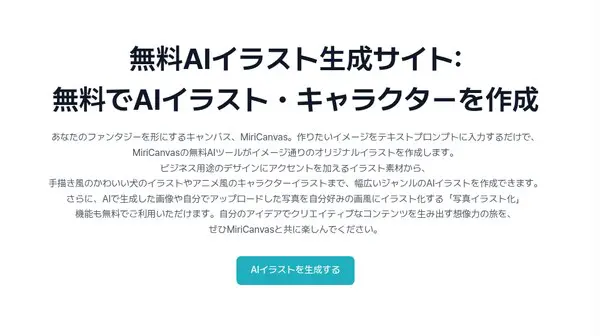
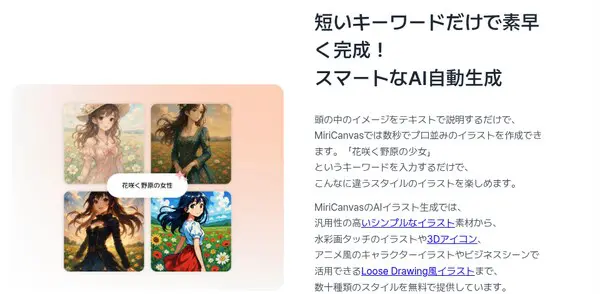
- クレジットを消費するタイプ:ミリキャンバス(MiriCanvas)の公式ページには、無料でイラスト生成ができ、毎日一定量のクレジットが提供され、生成時にクレジットを消費すると書かれています。上位プランではより多くのクレジットが付与されます。クレジットの追加購入や有効期限は、確認した公式ページに記載がありませんでした。
- 月ごとにリセットされるタイプ:Canvaは、AIの利用枠が毎月リセットされると案内しています。高品質のモデルほど使える回数が少なく、最高品質モデルは無料プランでは使えません(Canvaの回数は公式ページ間で記載が異なります。詳しくは前の比較表の注記を参照)。
どのタイプでも、1回で狙いどおりになるとは限りません。回数を無駄にしないために、次の章のように、主題・画風・背景を先に決めてから生成すると効率的です。
作り方・始め方:基本の手順とプロンプトの書き方
ツールによって細かい操作は異なりますが、基本的な流れは共通しています。
- ツールを選んで登録する:用途・予算・技術レベルに合わせてツールを選びます。初心者はCanvaやChatGPT、Geminiが操作しやすくおすすめです。
- プロンプト(指示文)を書く:生成したい画像の内容・スタイル・雰囲気・色などをテキストで指定します。英語の方が精度が出やすいツールが多いですが、ChatGPTやGeminiは日本語でも十分機能します。
- パラメータを調整する:解像度・アスペクト比・スタイル強度・ステップ数などを設定します。Stable DiffusionなどはCFGスケール(プロンプトへの忠実度)も調整可能です。
- 生成して確認する:複数枚を一度に生成し、最も意図に近いものを選びます。
- 修正・リファイン:インペインティング(部分修正)・アウトペインティング(拡張)・img2img(参考画像ベースの再生成)などで仕上げます。
- 出力・利用:PNG/JPEGで書き出して使用します。利用規約の商用利用条件を必ず確認してください。
プロンプトの書き方のコツ
生成される絵の品質はプロンプトの書き方に大きく左右されます。効果的なプロンプト構成の基本を押さえましょう。
- 主題を最初に書く:「A cute cat sitting on a wooden table」のように、何を描きたいかを冒頭に明示します。
- スタイルを指定する:「anime style」「watercolor painting」「photorealistic」など、画風を具体的に指定します。
- ネガティブプロンプトを活用する:「blurry, ugly, low quality」など生成してほしくない要素を指定することで品質が向上します(主にStable Diffusion系)。
- 数値ウェイトを使う:Stable DiffusionやMidjourneyでは「(cat:1.5)」のようにキーワードの重みを数値で調整できます。
- 参照画像を使う:img2imgやIP-Adapterなどの機能で、参考にしたい構図・雰囲気の画像をAIに渡すことでより精密な制御が可能です。
同じお題でスタイルを変えると、こう変わる(作例)
実際にOpenAIの画像生成API(gpt-image-1)で、お題を「窓辺の木のテーブルに座る三毛猫」に固定し、末尾の画風指定だけを変えて生成しました(2026年10月に生成。各1回目の出力をそのまま掲載し、加工していません)。
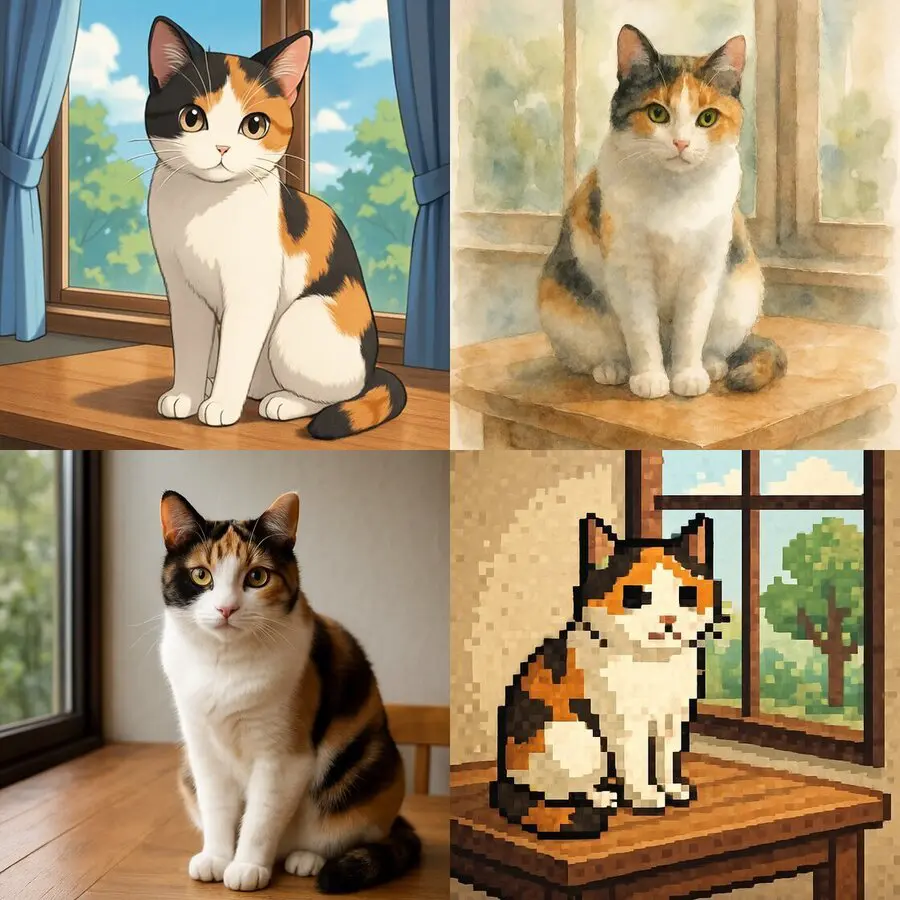
| 画風 | 入力したプロンプト | 生成して気づいた点 |
|---|---|---|
| アニメ風 | 窓辺の木のテーブルに座る三毛猫、アニメ風 | 輪郭線がはっきりし、色が平らに塗られる。窓の外に青空と木が描き足された |
| 水彩画風 | 窓辺の木のテーブルに座る三毛猫、水彩画風 | 色がにじみ、背景の窓や木がぼんやり溶ける。細部より雰囲気が優先される |
| 写真風 | 窓辺の木のテーブルに座る三毛猫、写真のようにリアルに | 毛並みや床の木目の質感が出る。背景は自然にぼける |
| ドット絵風 | 窓辺の木のテーブルに座る三毛猫、ドット絵風 | 粗いマス目でも、三毛の柄と窓・木のモチーフは保たれる |
お題は同じでも、テーブルの形や窓の位置、猫のポーズは画風ごとに変わっています。指示に書いていない部分はAIが補うため、同じ絵を再現したいときは、場所・構図・色まで書き込む必要があります。
プロンプトの書き方の具体例(日本語でOK)
上の作例のように、日本語でそのまま指示できるツール(ChatGPT・Geminiなど)も増えています。迷ったら、次の5つの要素を順に足していくと、狙いに近づけやすくなります。
| 要素 | 書き方の例 | 効くところ |
|---|---|---|
| 主題 | 窓辺の木のテーブルに座る三毛猫 | 何を描くか。最初に書く |
| 画風 | アニメ風/水彩画風/写真のようにリアルに/ドット絵風 | 仕上がりの印象がいちばん変わる |
| 場所・背景 | 窓辺、青空、木のテーブル | 背景を書かないとAIが好きに補う |
| 構図・光 | 正面から、やわらかい自然光 | 向き・距離・明るさ(ツールによって効き方が違う) |
| 色 | 暖色中心、パステル調 | 全体のトーンをそろえる |
まとめると、「窓辺の木のテーブルに座る三毛猫、アニメ風、青空、正面から、暖色中心」のように、主題から順に読点でつなげれば十分です。思い通りにならないときは、一度に全部直さず、1要素ずつ変えて比べると原因をつかめます。
動画・画像生成AIの業務活用をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
思い通りにならないときの対処と、良い指示・悪い指示の違い
生成結果が思ったものと違うときは、全部を一度に直さず、原因を1つずつ切り分けるのが近道です。
- 絵が違うものになる:主題が曖昧なことが多いです。「かわいい女の子」ではなく「髪型・服装・背景」まで書きます。Canvaの公式ページも、髪型・服装・背景などを具体的に書くほど理想に近づくと案内しています。
- 雰囲気が違う:画風の指定が足りません。アニメ風・水彩画・線画・3Dなど、画風を言葉で入れます(上の作例のように、画風だけで印象が大きく変わります)。
- 構図や背景がバラバラ:指定しなかった部分はAIが補います。場所・向き・光・色を書き足します。
- 手や文字が崩れる:仕組み上の傾向です(後述の「仕組み」の章)。文字は後から自分で入れる、複数枚作って良いものを選ぶのが現実的です。
- 会話で直せるツールもある:Canvaの公式ページは、結果を見ながら会話形式で色味・スタイル・構図を調整できると案内しています(「もっと明るい雰囲気にしたい」「背景を変えてほしい」など)。
悪い指示と良い指示の比べ方
| 悪い指示の例 | 良い指示の例 | 違い |
|---|---|---|
| 猫の絵 | 窓辺の木のテーブルに座る三毛猫、水彩画風、やわらかい自然光、暖色中心 | 主題・画風・場所・光・色がそろう |
| かっこいい人物 | 黒髪ショートの青年、白いシャツ、夕方の街、アニメ風、正面から | 「かっこいい」を髪型・服・背景に分解する |
| おしゃれなロゴを文字入りで | 文字なしのシンプルな図案をAIで作り、文字は後から入れる | 苦手な部分(文字)を人の作業に回す |
日本語でそのまま指示できるツールが多い一方、英語の指示のほうが意図が通りやすいツールもあります。うまくいかないときは、同じ内容を英語でも試して比べてみてください。
描いた後の仕上げ:背景透過・高画質化・不要物の削除と保存形式
生成した画像は、そのまま使うよりも、少し手を入れると使いやすくなります(2026年10月29日、公式ページで確認)。
- 背景透過(背景除去):画像の背景を消して、他のデザインに重ねやすくします。Canvaでは、ワンクリックの背景透過機能がCanvaプロの機能として案内されています。ミリキャンバスの公式ページにも背景透過が紹介されています。
- 不要物の削除(消しゴム):画像に写り込んだ不要な要素を消します。Canvaではマジック消しゴム(Canvaプロ)、ミリキャンバスでは消しゴムマジックが紹介されています。
- 高画質化・拡張:ミリキャンバスの公式ページに、高画質化と画像拡張が紹介されています。Canvaは生成画像の拡大そのものには触れておらず、解像度を上げる「高画質化」の別ページを案内しています。
- 色・質感・背景の変更:Canvaでは、AIブラシで変更したい箇所をなぞって色や質感、背景を変えられると案内されています。
保存形式
Canvaの公式ページでは、PNG・JPG・PDFなどで保存でき、背景を透明にしたPNGも作れると案内されています。ミリキャンバスの公式ページでも、PNG・JPGでのダウンロードと、背景透過のファイル作成に対応すると書かれています。ウェブ掲載ならJPG、背景を抜いて他の画像に重ねるなら透明PNG、と使い分けると扱いやすくなります。商用で使う場合は、保存の前後で各ツールの利用規約を確認してください。
スマホで使える画像生成アプリ(公式ストアで確認)
外出先で使いたいときは、公式アプリがあるかどうかを先に見ます。次は、公式のアプリストアのページと各社の公式ページに書かれている範囲です(2026年10月29日確認)。ストアの価格は「無料・アプリ内購入」と表示されており、アプリ内で何回まで無料かは、確認したストアのページには書かれていませんでした。
| アプリ | 対応OS | 価格表示 | 画像生成についての公式の記載 |
|---|---|---|---|
| ChatGPT | iPhone(App Storeで確認) | 無料・アプリ内購入 | ストアの説明に「画像生成:説明文からオリジナル画像を生成」とあります。 |
| Google Gemini | iPhone(App Storeで確認) | 無料・アプリ内購入 | ストアの説明に、Nano Banana 2で写真を生成・編集できると書かれています。 |
| Canva | iOS・Android(公式ページに記載) | 無料・アプリ内購入(App Store) | 公式のAI生成ページのFAQに、iOS・Androidの公式アプリがあり、スマホやタブレットから編集できると書かれています。 |
| Adobe Firefly | iPhoneのみ(App Storeに記載) | 無料・アプリ内購入 | ストアのタイトルに「AI動画生成・画像生成」とあります。 |
Androidのストアは確認していないため、上の表に載せていません。Android向けの有無は、各サービスの公式ページで確認してください。出典:ChatGPT(App Store)、Google Gemini(App Store)、Adobe Firefly(App Store)、Canva AIイラスト生成。
ツールの選び方と、用途別の向き・不向き
AIイラストは万能ではなく、用途によって「そのまま使える/手直し前提/避けた方が無難」がはっきり分かれます。生成ツールを触る前に、自分の目的がどこに当てはまるかを確認しておくと、無駄な試行錯誤やトラブルを減らせます。
向く場面・向かない場面(各3つ)
向く場面
- アイデア出し・ラフの量産:構図やテイストの候補を短時間で複数並べ、方向性を決めたいとき。
- 1点物・使い捨て寄りの画像:SNS投稿やブログのアイキャッチなど、厳密な一貫性より速さと量が優先されるとき。
- 抽象的・イメージ的な絵:背景、質感、雰囲気カットなど、細部の正確さを問われないビジュアル。
向かない(手直し・別手段が前提の)場面
- キャラクターを何枚も同一に保つ:表情・角度違いで同じキャラを揃える用途は、そのままだと崩れやすく調整前提。
- 文字・ロゴ・図表の正確さが要る:日本語テキストや正確な図はまだ苦手で、そのまま納品には不向き。
- 権利がクリティカルな成果物:企業ロゴやブランドの中核ビジュアルなど、独占的な権利保護が前提のもの(後述の商用利用の項も参照)。
用途別の判断早見表
「そのまま使える」か「加工・確認が要る」かの目安です。実際の可否は各ツールの利用規約と最新の法解釈を必ず自分で確認してください。
| 用途 | 相性 | 判断のポイント |
|---|---|---|
| SNS投稿・アイキャッチ | ◎ 向く | 速さと量が活きる。1点物なら試行錯誤が最小で済む。 |
| ブログ挿絵・資料の図版 | ○ 手直し前提で向く | 雰囲気カットは得意。文字入り図は自分で組み直す。 |
| 同一キャラの連作・漫画 | △ 調整が重い | 一貫性の保持に工夫が要る。参照画像や後処理を織り込む。 |
| ロゴ・ブランド中核ビジュアル | × 別手段推奨 | 権利の独占確保が難しい領域。プロ発注や商標も検討。 |
| 高解像度の印刷物 | ○ 条件付き | アップスケールや修正を前提に、解像度・細部を要確認。 |
| 写実的な人物・実在物の再現 | △〜× 慎重に | 肖像・実在物の権利や誤情報リスク。用途を限定する。 |
ツールの選び方:3つの軸で絞る
本記事の前の「無料で使えるイラストAIの比較表」から選ぶ際は、次の3軸で自分に合うタイプへ絞り込むと迷いにくくなります。
- 手間の軸(Web完結型 か ローカル導入型 か):ブラウザで今すぐ作りたいならWeb完結型、生成の自由度や大量生成を求めるなら自分の環境に導入するタイプ。
- コントロールの軸(お任せ か 細かく制御 か):プロンプトだけで手軽に仕上げたいのか、構図・スタイルを細かく指定して詰めたいのか。
- 権利・商用の軸(利用規約の商用可否と権利の扱い):商用なら「生成物の商用利用が明記されているか」「学習データや権利の扱い」を必ず規約で確認する。
タイプ別の1行使い分け
- ブラウザで手軽に作りたい → Web完結型のオンライン生成サービス(登録してすぐ試せる)。
- アート性・作り込みを追求したい → 表現力に強みを持つ高品質特化型のツール。
- 自由度高く大量に・オフラインで回したい → 自分の環境に導入するローカル実行型。
イラストAIはどのタイプでも、公開・販売の前に各ツールの利用規約と著作権・商用利用の条件を確認することが前提です(詳しくは本記事「商用利用と著作権」の項を参照)。
用途別のプロンプト例と、予算別のツールの組み合わせ
ここでは、すぐ使えるプロンプトの例文を用途別に並べます。いずれも筆者が作った例文で、そのまま貼り付けて、括弧の中身だけ自分の内容に変えて使えます。
| 用途 | プロンプトの例 |
|---|---|
| SNSのアイコン | (動物)のキャラクター、丸い顔、やさしい線画、パステルカラー、無地の背景、正面から |
| ブログのアイキャッチ | (テーマ)をイメージしたフラットなイラスト、青と白が中心、余白を広めに、文字は入れない、横長 |
| 資料・スライドの挿絵 | (場面)で作業する人のシンプルなイラスト、線は太め、色は3色まで、背景は白 |
| 年賀状・カード | (干支や季節のモチーフ)、水彩画風、やわらかい光、中央に余白、縦長 |
| キャラクター設定画 | (年齢と性別)、(髪型)、(服装)、アニメ風、全身、白背景、正面と横向きの2パターン |
| 商品のイメージ画 | (商品)がテーブルに置かれた場面、自然光、シンプルな背景、イラスト調、文字やロゴは入れない |
予算別のツールの組み合わせ
金額は変わることがあるため、有料プランの料金は必ず各公式の料金ページで確認してください。無料の範囲は、公式ページで「無料」と案内されているものだけを挙げます(2026年10月29日確認)。
- 0円で始める:ChatGPTまたはGeminiで日本語のまま生成し、仕上げと書き出しはCanvaの無料プラン(料金ページに「無料 ¥0」と表示)で行います。Canvaの無料版のAI回数は、公式ページ間で記載が異なるため、前の比較表の注記を確認してください。
- 画風を選んで量産したい:MiriCanvasは、公式ページで無料でイラスト生成ができ、毎日一定量のクレジットが提供されると案内されています。
- 有料に切り替える:回数の上限に何度も当たるようになってから、使っているツールの有料プランを検討します。Canvaは料金ページに、AIの利用枠を増やす「AIパス」が案内されています。いきなり複数のツールに課金せず、1本に絞るのが無駄が出にくい進め方です。
安全面の確認:無料プランの商用利用・アップロード画像の学習・年齢制限
無料で使えても、使い方の条件は各社の規約で決まっています。商用で使う前、写真をアップロードする前、子どもが使う前に、次の点を公式ページで確認します(確認日:2026年10月29日。「記載なし」は、確認したページに書かれていなかったという意味です)。
| サービス | 商用利用 | 入力・アップロードの学習利用 | 年齢 |
|---|---|---|---|
| ChatGPT | 利用規約に、適用される法律で認められる範囲で、ユーザーが出力を所有すると書かれています。ただし出力は他のユーザーと同じになる場合があり、他者の権利を侵害する使い方は禁止です。無料プランだけの別条件は、確認した規約には書かれていません。 | ヘルプに、個人のFree・Plus・Proでは既定でデータ共有が有効と書かれています。設定の「データコントロール」で「すべての人のためにモデルを改善する」をオフにできます。 | 13歳以上。18歳未満は保護者または法定後見人の許可が必要と規約にあります。 |
| Canva | AI生成ページのFAQに、利用規約に沿う範囲で、個人または商用プロジェクトを含む法的な目的に使えると書かれています。 | 同じFAQに、アップロードしたデータはユーザーが許可しない限りAI学習に使われないと書かれています。 | 利用規約の年齢は確認できていません。App Storeの年齢制限指定は13+です。 |
| Adobe Firefly | FAQに、ベータ表示のない機能の生成物は商用プロジェクトで使え、ベータ機能は製品内に特に明記がなければ使えると書かれています。無料プランだけの条件は、このFAQには書かれていません。 | FAQに、Creative Cloud購読者の個人コンテンツでは学習しないと書かれています。購読していない無料ユーザーについての記載は、確認したFAQにはありません。 | App Storeの年齢制限指定は13+です。規約の年齢は確認できていません。 |
| Gemini | 商用利用について、確認したページには記載がありません。 | プライバシーハブに、プロンプトに画像を追加すると、Googleレンズの技術も使って内容を理解し、プライバシーに関するお知らせのとおり他のプロンプトと同様に使うと書かれています。 | App Storeの年齢制限指定は13+です。 |
不適切なコンテンツの扱い
ChatGPTの利用規約は、違法行為・有害行為・悪用のための利用を禁止し、他者の権利を侵害する使い方と、人が作ったものではない出力を人が作ったものと表示することも禁止しています。Adobe Fireflyは、利用がガイドラインや規約に沿わないとアカウントを制限することがあると、FAQに書いています。どのサービスでも、規約に反する依頼は生成を断られたり、アカウントが制限されたりする場合があります。
出典:OpenAI 利用規約、ChatGPTのデータコントロール(OpenAIヘルプ)、Canva AIイラスト生成、Adobe Firefly FAQ、Gemini アプリのプライバシー ハブ、各アプリのApp Storeページ。
商用利用と著作権:現状と注意点
生成した絵を利用する上で最も注意が必要なのが著作権と法律の問題です。
日本における現状
日本の著作権法では、著作物の保護対象は「人の創作的表現」であるとされています。AIが自律的に生成した画像については、現状では著作権が発生しない(または著作者が誰か不明確)と解釈されることが多いです。一方、人間がAI生成画像に対して創造的な関与(プロンプトの工夫、大幅な手動加工など)を行った場合、その部分には著作権が認められる可能性があります。
また、学習データに含まれる既存のイラストや著作物を無断で学習に使用することへの批判も高まっており、文化庁は「AIと著作権に関する考え方について」(2024年3月15日)と「AIと著作権に関するチェックリスト&ガイダンス」(2024年7月31日)を公表しています。
商用利用時の確認事項
- 各ツールの利用規約(ToS)で商用利用が許可されているか確認する
- 生成した画像をNFTや販売物として使う場合は追加条件がある場合がある
- 他者のスタイル・キャラクター・商標を模倣した画像の商用利用は特に注意が必要
- Adobe FireflyはAdobe Stock・ライセンス取得済みコンテンツ・パブリックドメイン素材で学習しており、商用利用を想定した設計になっている(ただし利用条件は必ずAdobeの規約で確認する)
倫理的な利用のために
使う際は、法律の問題だけでなく倫理的な側面も重要です。特定のイラストレーターのスタイルを大量模倣してそのクリエイターの仕事を奪うような使い方、実在の人物を無断でイラスト化すること、誤情報を広めるためのフェイクビジュアルへの使用は、法的リスクだけでなく社会的・倫理的問題を引き起こします。AIはあくまでも人間の創造性を補助・拡張するツールとして活用することが求められています。

仕組み:言葉から絵ができるまでと、手や文字が崩れる理由
結論から言うと、現在主流の画像生成AIは「拡散モデル(Diffusion Model)」という仕組みで動いており、ノイズだらけの画像から少しずつノイズを取り除いていくことで絵を作り出します。人間のように筆で描くのではなく、「砂嵐のような画像を、入力された言葉に合う絵へと段階的に復元していく」という発想が核心です。
- 学習の段階:大量の「画像+その説明文」のペアを使い、画像に少しずつノイズを加えていく過程と、その逆(ノイズを取り除いて元に戻す過程)をAIに学ばせます。これによりAIは「どんな見た目がどんな言葉に対応するか」を獲得します。
- 生成の段階:利用者が入力した言葉(プロンプト)はテキストエンコーダで数値(ベクトル)に変換され、それを手がかりに、完全なノイズ画像から「その言葉らしい絵」へ向けて何十回もノイズ除去を繰り返します。
- 著作権との関係:AIは学習した画像そのものを保存・貼り付けているわけではなく、統計的な特徴を学びます。ただし学習データに他者の著作物が含まれる点や、特定の作風を模倣した出力の扱いは各国で議論が続いており、商用利用の可否は使うツールの利用規約と最新の法的見解を必ず確認してください。
処理の流れをもう少し詳しく
生成には主に拡散モデル(Diffusion Model)と呼ばれる技術が使われています。大量の画像とテキストのペアデータで学習したモデルが、ランダムなノイズ画像を少しずつ「意味のある絵」へ変換することで画像を生成します。処理の流れを整理すると下記のようになります。
テキストや参考画像を指定
テキストを数値ベクトルへ変換
拡散モデルが繰り返し処理
最終画像として出力
拡散モデルの原理
拡散モデルは「前向き拡散(Forward Diffusion)」と「逆向き拡散(Reverse Diffusion)」の2段階で動作します。学習時は正解画像に少しずつノイズを加えてランダムノイズに崩す操作を学習します。生成時はその逆で、ランダムノイズからノイズを取り除く操作を繰り返し、最終的にプロンプトと整合する画像を生成します。この繰り返し回数(ステップ数)が多いほど精度が上がる一方、生成時間も長くなります。
テキストと画像を結びつけるCLIP
プロンプトの言葉を画像生成に活かすには、テキストと画像の意味を同じ空間にマッピングする仕組みが必要です。OpenAIが開発したCLIP(Contrastive Language-Image Pretraining)がその代表格で、「猫の写真」「cat photo」などの大量ペアデータで学習することで、言葉と視覚表現を橋渡しします。多くの画像生成AIがCLIPまたはその派生技術を内部で採用しています。
GANとの違い
拡散モデルが普及する前は、GAN(Generative Adversarial Network:敵対的生成ネットワーク)が主流でした。GANは「生成器」と「識別器」が互いに競い合うことで高精度な画像を生成しますが、学習が不安定になりやすく、モード崩壊(特定のパターンしか生成できなくなる現象)が課題でした。拡散モデルはGANより安定した学習が可能で、多様な画像を生成できるため、現在の主流となっています。
「なぜそれっぽく描けるのか」と「なぜ手や文字が苦手か」を仕組みから理解する
この仕組みを「魔法」で終わらせず、生成結果の当たり外れを予測できるレベルまで理解しておくと、期待値のズレによる失望を大きく減らせます。ここでは現在主流とされる画像生成モデルが内部でやっていることを、判断に使える範囲でかみ砕きます(モデルの種類やバージョンによって細部の仕組みは異なるため、あくまで一般的な傾向としてご覧ください)。
ノイズから絵を「復元」していく発想
現在広く使われているものの多くは、砂嵐のようなランダムノイズを出発点にして、それを少しずつ「もっともらしい絵」に近づける、という復元作業を繰り返す仕組み(拡散モデル)を採用しているとされています。学習時に大量の画像へノイズを足して壊し、その壊れ方を逆再生する訓練を積むことで、生成時にはノイズを絵へと引き戻せるようになる、という考え方です。プロンプト(指示文)は、この復元をどの方向へ引っ張るかの「舵」として働き、絵そのものを直接描いているわけではありません。ここを理解すると、同じ指示でも毎回違う絵が出やすい理由(出発点のノイズが毎回異なる場合が多いこと)が腑に落ちやすくなります。
「意味」ではなく「見た目の統計」を再現していると説明される
AIモデルは物体の構造そのものを人間のように理解しているわけではなく、膨大な画像から「こういう並びのピクセルがそれらしい」という統計的なパターンを学習していると一般に説明されます。この性質は、得意・不得意の傾向を大きく左右すると考えられています。
- 得意とされる傾向: 質感・光の雰囲気・全体の構図など、多数の作例から平均像を作りやすいもの。
- 苦手とされる傾向: 指の本数、左右対称の一致、画面内の文字、時計や譜面のような「正解が一意に決まる」要素。見た目の統計だけでは正しさを担保しにくいため、崩れが出やすいと言われています。
崩れを前提に付き合うコツ
手・文字・複雑な小物が崩れやすいのは、多くの場合、設定ミスというより仕組み由来の傾向です。そのため実務では「崩れやすい部分は構図で隠す」「文字は後から人が入れる」「同じ指示で複数枚出して当たりを選ぶ」といった、生成結果のゆらぎを前提にした付き合い方が有効になりやすいと考えられます。仕組みのおおまかな傾向を知っておけば、うまくいかない絵を前にしても原因を切り分けやすくなり、無駄なやり直しを減らせます。
活用シーンとメリット・デメリット
画像生成AIはビジネス・クリエイティブ・個人の幅広い場面で活用されています。
ブログのアイキャッチ、Instagram用ビジュアル、X(旧Twitter)のサムネイル生成を素早く量産できます。
コンセプトアート・背景画・キャラクターラフの素早い試作に使われ、開発コストを大幅削減できます。
商品画像の背景置き換え、バリエーション展開、パッケージデザイン案の高速試作が可能です。
書籍・電子書籍の挿絵、教材の概念図、プレゼン資料の図解などに活用されています。
広告ビジュアルの初稿制作、ブランドイメージの方向性探索、A/Bテスト用素材の大量生成に対応します。
オリジナルキャラクターのビジュアル化、世界観の視覚化、同人・NFTアートの制作などに利用されています。
メリット
- 制作スピードの圧倒的な速さ:熟練イラストレーターが数時間〜数日かける作業を、数秒〜数分で完成させられます。アイデアの試行錯誤が格段にしやすくなります。
- コストの削減:外注費・時間コストを大幅に圧縮できます。特にバリエーション展開が多い場面で効果を発揮します。
- 専門知識不要でハイクオリティ:絵の技術がなくても、プロンプトの工夫次第でプロ水準に近いビジュアルを生成できます。
- スタイルの自由度:油絵・水彩・アニメ・写実・ピクセルアートなど、求めるスタイルを指定するだけで切り替えられます。
- 反復作業の自動化:大量の素材を一定品質で量産でき、デザイン業務のボトルネックを解消します。
デメリットと課題
- 細部の精度問題:手の指の本数、文字、複雑な構図などはまだ不自然になりやすいです。特に「手」の描写は業界全体の課題として知られています(2026年10月時点でも完全には解決していません)。
- プロンプト依存の限界:意図通りの画像を出すにはプロンプトの習熟が必要で、思い通りの結果を得るまで試行錯誤が必要なことがあります。
- 一貫性の問題:同じキャラクターを複数枚生成する場合、LoRAや専用機能を使わないと顔や衣装の一貫性を保つのが難しいです。
- 著作権・法的不確実性:AI生成画像の著作権帰属は各国で議論中であり、日本でも2026年10月時点で判例は多くありません。
- 倫理的問題:特定のアーティストのスタイルを模倣した生成、フェイク画像の悪用、不適切なコンテンツの生成リスクが指摘されています。
プロのイラストレーターとの関係
「AIはプロのイラストレーターの仕事を奪うのか」という問いは、クリエイター界隈で重要な議論です。現実的な影響を整理すると、単純・量産型のイラスト案件(ストックイラスト、定型的な挿絵など)への影響は既に出始めている一方、独自のスタイルを持つアーティスト、キャラクターデザイン、ストーリー性のある複雑な表現、クライアントとのコミュニケーションを要する仕事においてはAIには代替できない価値が存在します。
また、多くのプロイラストレーターがAIを「下絵・コンセプト探索ツール」として使いこなし、制作効率を上げる事例も増えています。AIを敵対視するのではなく、創造的プロセスにどう統合するかを模索することが、今後のクリエイターに求められる視点です。
歴史と進化
| 年 | できごと |
|---|---|
| 2014年 | Ian GoodfellowらがGANを発表。AIによる画像生成の研究が本格化 |
| 2021年 | OpenAIがDALL·E(初代)を発表。テキストから画像生成が一般に認知される |
| 2022年4月 | OpenAIがDALL·E 2を発表。高解像度・高品質化が飛躍的に向上 |
| 2022年7月 | Midjourneyがオープンベータを開始。アーティスト的なスタイルが話題に |
| 2022年8月 | Stable Diffusionがオープンソースで公開。個人・企業が自由に利用・改良可能になる |
| 2023年 | Adobe Firefly・Canva AIなど商用プラットフォームへの統合が急拡大 |
| 2024〜2025年 | 動画生成AIとの融合、リアルタイム生成、キャラクター一貫性機能が進化。日本国内での商用利用も広がる |
よくある質問
AIイラストは無料で作れますか?
作れます。ChatGPTは無料プランでも回数制限つきで画像を作れます。GeminiはNano Banana 2を無料で使え、上位のNano Banana 2.1はGoogle AIの有料プランが対象です。Adobe Fireflyにも無料プランがあり、CanvaやMicrosoft Copilotも無料で試せます。回数の上限は各サービスの画面で確認してください。
AIイラストは商用利用できますか?
使うツールの利用規約によります。Adobe FireflyはAdobe Stock・ライセンス取得済みコンテンツ・パブリックドメイン素材で学習しており、商用利用を想定して設計されています。Midjourneyは、年間総収入が100万ドルを超える企業にProまたはMegaプランの契約を求めています。公開・販売の前に、必ず最新の規約を確認してください。
AIイラストに著作権はありますか?
文化庁は「AIと著作権に関する考え方について」(2024年3月15日)と「AIと著作権に関するチェックリスト&ガイダンス」(2024年7月31日)を公表しています。AIが自律的に生成しただけの画像は著作物と認められにくく、人が創作的に関与した部分には著作権が認められる可能性があります。また、既存の作品に似ていて、その作品に依拠していると判断されれば、著作権侵害になり得ます。
手や文字が崩れるのはなぜですか?
画像生成AIは物の構造を理解して描くのではなく、大量の画像から学んだ見た目の傾向をもとに絵を作るためです。指の本数や画面内の文字のように正解が1つに決まる部分は崩れやすくなります。文字は後から自分で入れる、複数枚作って良いものを選ぶ、といった使い方が現実的です。
AIで作った画像かどうかは見分けられますか?
ツールによっては判別の仕組みがあります。Geminiで作った画像には、目に見える透かしと、目に見えない電子透かし(SynthID)が入ります。Geminiアプリに画像をアップロードして、Google AIで作られたものかを尋ねて確認することもできます。
初心者はどのツールから始めればよいですか?
日本語でそのまま指示できるChatGPTかGeminiが始めやすい選択です。SNS画像や資料までまとめて作りたい場合はCanva、商用利用を前提にする場合はAdobe Fireflyが候補になります。
まとめ
AIイラストとは、テキストや参考画像を入力するだけで人工知能が自動生成するイラスト・画像のことです。拡散モデルを中心とした技術が急速に進化し、2022年以降は個人・企業問わず幅広く活用されるようになりました。
主なメリットは制作スピードの速さ・コスト削減・スタイルの自由度ですが、著作権の不確実性・倫理的課題・精度の限界(特に手や文字の描写)といった課題も存在します。商用利用時は各ツールの利用規約と著作権法の現状を必ず確認した上で活用することが重要です。
AIは「人間の創造性を代替するもの」ではなく、創造的プロセスを加速させ、アイデアを素早く視覚化するための強力なツールです。正しく理解し、倫理的・法的に適切な範囲で活用することで、クリエイティブワークの可能性を大きく広げることができます。
関連記事
動画・画像生成AIの業務活用をご検討の方へ
クリスタルメソッドは、動画・画像を生成するAIやAIアバターの開発と業務導入を支援しています。「広告・研修動画の制作を効率化したい」「自社サービスに画像・動画生成を組み込みたい」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
AIイラストの作り方・生成手順を初心者向けに解説
本ページはAIイラストの「作り方・生成手順」に特化して、プロンプト入力から出力までの具体的なステップを解説します。AIイラストの仕組みや活用全体像はaiイラスト...
-
AIイラスト無料ツール完全ガイド|2026年最新おすすめ7選と使い方
AIイラストを無料で作る:使えるツールの無料枠・登録・商用利用と手順 結論から言うと、日本語でまず試すならCanva、商用で使う前提ならAdobe Firefl...
-
AIイラスト料金の全体像|無料・有料・商用利用まで徹底解説
【2026年7月 最新確認】画像生成AIの現行料金の目安は、Midjourney $10〜$120/月(無料枠なし)、DALL-E系はChatGPT Plus(...