
blog
AIブログ
Qwen3 ローカルLLM 性能比較——RTX 4090一枚でClaude Opus級に迫る現実
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
Qwen3.8-27B:ローカル運用の実力を測る前提
2026年8月14日、Alibaba Cloudの研究チームがQwen3.8-27Bをリリースした。総パラメータ27.8Bの密結合(dense)視覚言語モデルで、Apache 2.0ライセンスの下で公開されている(出典:miraflow.ai、codersera.com)。
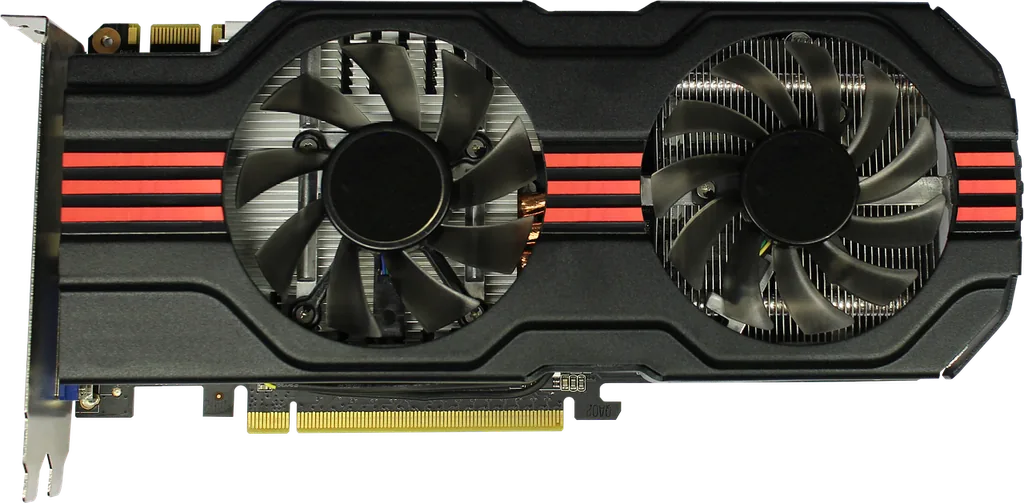
このモデルが広く注目を集めた直接の契機は、r/LocalLLaMAのユーザーspeedb0atが、シングルRTX 4090とllama.cppを組み合わせてモーショングラフィクス生成を実演したことにある(出典:startupfortune.com)。デモの背景にはClaude Opus 5.5のモーショングラフィクスがX上で拡散していたことがあり、「ローカルモデルが最上位クラウドモデルに肉薄した」という印象が広まった。ただしこのデモはcontrolled benchmarkではなく、Opus 5.5との定量的な同等性を証明するものではない(出典:startupfortune.com)。
意思決定者が本来問うべきことは、「消費者向けGPU1枚で動くオープンウェイトモデルが、有料クラウドAPIの最上位モデルに対してどの程度の代替性を持ち、それが自社の業務判断にどう影響するか」である。以下ではその問いに答える。
関連記事VOICEVOX 使い方|インストールから音声生成まで【2026】 / Grokとは?できること・料金・始め方をやさしく解説【2026年版】 / ディープフェイクとは?仕組み・悪用リスク・見分け方と対策を専門家監修で解説【2026年版】
Qwen3 ローカルLLM 性能比較:定量データの読み方
以下の比較表は、検証済み事実の範囲内でQwen3.8-27BとClaude Opus 4.6 Maxを整理したものである。定量ベンチマークの対象は一貫してClaude Opus 4.6 Maxであり、Opus 5.5との数値比較は定量的に確認されていない(出典:codersera.com)。
| 評価軸 | Qwen3.8-27B | Claude Opus 4.6 Max | 備考 |
|---|---|---|---|
| SWE-bench Pro | 61.7 | 53.4 | ベンダー報告値。ハーネス・温度設定の不一致リスクあり(codersera.com) |
| Terminal-Bench 2.1 | 73.0 | 78.2 | ターミナル操作タスク。Opusが優位(codersera.com) |
| AI Intelligence Index(独立機関) | スコア52 | 非公開 | Artificial Analysis Independent Index(codersera.com) |
| パラメータ数 | 27.8B(dense) | 非公開 | — |
| コンテキスト長 | 262,144トークン(YaRN拡張で最大100万) | 非公開 | miraflow.ai |
| VRAM要件(Q4量子化) | 約17〜18GB | ローカル動作不可 | シングルRTX 4090で動作可(codersera.com, explainx.ai) |
| ライセンス | Apache 2.0(商用無制限) | 商用API(重み非公開) | — |
| データ送信先 | 自社環境内で完結 | Anthropic米国サーバー | 機密データ取扱いに直結 |
SWE-bench ProでのQwen3.8-27Bの逆転はコーディング補助用途の参考値として受け取るのが適切であり、汎用的な「全面的優位」を意味するものではない。explainx.aiが指摘するとおり、ベンダー報告値はハーネスや温度設定の不一致による評価バイアスを含むリスクがある。Terminal-Bench 2.1でOpus 4.6 MaxがQwen3.8-27Bを上回っていることは、エージェント的な操作タスクにおけるクラウドモデルの堅牢性を示している。
さらに視野を広げると、Alibabaは2026年8月12日に総パラメータ2.4T・アクティブ95BのMoE構成を持つQwen3.8-Maxオープンウェイト版も公開しており(出典:Alibaba Cloud公式)、ローカル運用の性能上限は27.8Bにとどまらない。ただし兆パラメータ級MoEを動かすには複数GPU・高帯域メモリの大規模な環境が必要であり、「RTX 4090一枚で動く」という文脈とは分けて考える必要がある。
日本企業にとっての導入機会と見落とされやすいリスク
ローカルLLMの選択が現実的になったことで、日本企業の意思決定者にとっての判断軸は「性能が十分か」だけでなく「どのリスクを回避したいか」へ移りつつある。
情報漏洩リスクを制御したい用途への適合性は高い。契約書・財務資料・個人情報を含む文書の要約、社内知識ベースの検索補助、コードレビューの下書き生成などは、データが社外に出ないローカル運用の恩恵が大きい領域である。クラウドAPIでは個人情報保護法の第三者提供・委託条項、金融庁ガイドライン、医療情報の安全管理ガイドラインとの整合確認が必要になるが、ローカル運用であればデータは社内にとどまる。
コスト構造の再設計が可能になる。Qwen3.8-MaxのクラウドAPIは入力$2.00・出力$6.00(100万トークンあたり)が現行値である(出典:Alibaba Cloud Model Studio)。月間トークン処理量が大きい定型業務では、GPUサーバーの減価償却・電力・運用人件費を含めたTCO試算によっては、ローカル運用の方が総コストを抑えやすくなる可能性がある。ただし処理量が少ない場合はAPIの方が割安になることも多く、単純な比較では結論が出ない。
一方、看過できない制約が複数ある。第一にハードウェア調達の問題である。Q4量子化でも約17〜18GBのVRAMが必要であり(出典:codersera.com, explainx.ai)、スループットを業務水準まで引き上げるには複数GPU構成を要することもある。GPU需給の逼迫と価格水準を踏まえた現実的な調達計画が必要である。第二に運用体制の問題がある。量子化・プロンプト調整・バージョン管理・セキュリティパッチの適用は、クラウドAPIでは不要な社内工数を生む。LLMOpsの専門知識を持つ人材が確保できない場合、管理コストが想定を超えることがある。
中国企業提供モデルのサプライチェーンリスク認識も現実的な論点である。Apache 2.0ライセンスにより重みの利用・改変・再配布は自由だが、モデルの出所・学習データに関する内部ポリシーや取引先要件(特に防衛関連・行政システム・金融インフラ)との整合は事前に確認する必要がある。このリスク認識の有無は企業・業種によって大きく異なる。
Qwen3 ローカルLLM 性能比較を踏まえた意思決定の実務ステップ
定量データとリスクを整理した上で、導入判断に向けた実務的な起点を示す。
① 用途を「機密性」と「推論複雑度」で四象限に分類する。機密性が高く推論複雑度が中程度の業務(社内文書処理・要約・分類・コード生成)はQwen3.8-27Bのローカル運用と親和性が高い。機密性が低く推論の質と複雑なエージェント操作を最大化したい用途(R&D・複雑な計画立案)ではクラウド最上位APIが引き続き優位である。この分類なしに「どちらが良いか」を問うことは意味をなさない。
② PoCは公開ベンチマークではなく自社タスクで設計する。SWE-bench ProやTerminal-Benchのスコア差は自社業務の品質水準を保証しない。実際に処理するドキュメント・プロンプト・期待出力を用いた内部評価を設計し、「業務上の許容水準を満たすか」を独立した基準で測定する。ベンダー報告値の差だけで意思決定するのは判断の根拠として薄い。
③ TCOを月間トークン量を変数として試算する。固定費(GPU・電力・人件費)と変動費(API課金)の損益分岐点を月間処理トークン量で算出する。Qwen3.8-MaxのAPI単価(入力$2.00・出力$6.00/100万トークン、Alibaba Cloud Model Studio)を参照値として使い、ローカル運用の固定費回収シナリオを複数作る。
④ 法務・情報セキュリティ部門と技術評価を並行させる。個人情報保護法・業界規制への適合確認、内部ポリシーとの整合、モデル出所審査の要否は技術評価と同時に着手する必要がある。法務確認が遅れると、技術評価が完了しても導入判断が止まるケースがある。
なお、Alibabaは2026年8月26日に軽量モデルQwen3.8-Flash-NextもModelScope・HuggingFaceで公開しており(出典:ModelScope)、要求スペックを下げながら一定の性能を確保する選択肢も加わった。ローカルLLMの性能・コストトレードオフの選択肢は今後も拡張される見込みであるため、現時点の評価は定期的に更新することが望ましい。
ローカルLLMの技術的な基盤となるディープラーニングの仕組みについてはディープラーニング基礎解説を、視覚言語モデルの文脈でQwen3.8-27Bを位置づけたい場合はマルチモーダルAIの動向も参照されたい。
参考文献
- codersera.com — Qwen3.8-27Bベンチマーク・VRAM要件・比較データ(2026年8月)
- miraflow.ai — Qwen3.8-27Bモデル基本情報・コンテキスト長(2026年8月)
- explainx.ai — VRAM要件・ベンチマーク測定手法の注意事項(2026年8月)
- startupfortune.com — r/LocalLLaMAデモ事例・Opus比較の背景(2026年8月)
- cryptobriefing.com — Apache 2.0ライセンス・商用利用条件(2026年8月)
- Alibaba Cloud Model Studio — モデル一覧: https://www.alibabacloud.com/help/en/model-studio/models(参照:2026年8月)
- Alibaba Cloud Model Studio — 料金表: https://www.alibabacloud.com/help/en/model-studio/model-pricing(参照:2026年8月)
- Qwen公式ブログ: https://qwenlm.github.io/blog/
監修
河合 継(クリスタルメソッド株式会社 代表取締役)
AI・ディープラーニングに関する特許16件の発明者。過去、国立がん研究センターとの共同研究や、テレビ番組でのAI解説実績を持つAI研究者として、AIの研究開発を主導している。
運営会社について | 編集方針
Read next
あわせて読みたい
-
VOICEVOX 使い方|インストールから音声生成まで【2026】
VOICEVOXは無料?商用利用・クレジット表記の結論 VOICEVOXは、商用・非商用を問わず無料で使える音声合成ソフトです。ただし「VOICEVOXを利用し...
-
Grokとは?できること・料金・始め方をやさしく解説【2026年版】
「Grokって最近よく聞くけど、何ができるAIなの?」「ChatGPTと何が違うの?」——そんな方に向けて、このページではGrokのできること・料金・始め方を、...
-
ディープフェイクとは?仕組み・悪用リスク・見分け方と対策を専門家監修で解説【2026年版】
ディープフェイクは、深層学習で実在する人物の顔・声・動作を精密に合成・改変する技術です。映画制作や広告、バーチャルヒューマンといった正当な活用が広がる一方、なり...