
blog
AIブログ
大規模言語モデル(LLM)の構築とは?RAG・ファインチューニング・事前学習の進め方を基礎から解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
大規模言語モデルの構築とは、自社の目的に合わせてLLMを用意・調整する作業のことです。ほとんどの企業は、ゼロから事前学習するのではなく、既存の高性能モデルを土台に「RAG(検索拡張生成)→ファインチューニング→(必要な場合のみ)事前学習」の順で検討するのが現実的です。この記事では、その判断の基準と、データ・学習・評価・運用の各工程を順に説明します。LLMとは何かを知りたい方は、先に大規模言語モデル(LLM)とはをご覧ください。
大規模言語モデルの構築は何から始めればいい?
結論として、ほとんどの企業はゼロからの事前学習ではなく、既存の高性能モデルを土台に「RAG(検索拡張生成)→ファインチューニング→(必要な場合のみ)事前学習」の順で検討するのが最短かつ現実的です。目的と保有データ、コスト許容度で最適な段階が変わります。
- RAG(検索拡張生成):モデルを再学習させず、自社データを外部の検索対象として持たせて回答に反映する方式。モデルの重みを変えないため最も低コスト・短期間で着手でき、社内文書QAや最新情報の反映に向く。まず試すべき第一候補。
- ファインチューニング:Llama や Mistral などの公開(オープンウェイト)モデルを自社タスクで追加学習し、文体・専門用語・出力形式を最適化する方式。RAGだけでは精度が不足する専門用途で効果が出やすい。学習データの整備が前提。
- ゼロからの事前学習:大規模なGPUクラスタと膨大な学習データ・期間が必要で、コスト・技術難易度ともに最大。独自の基盤モデルそのものが事業の核となる場合に限って選ぶ選択肢で、多くの企業には過剰。
ゼロからの事前学習にかかる費用の実態は、HRM-Textで説明しています。
大規模言語モデル構築とは:基礎から実装まで徹底解説
大規模言語モデル(LLM)の構築は、現代のAI開発において最も注目される技術領域の一つです。GPT-4やClaude、Geminiなどの商用モデルが注目される一方、自社データや業務要件に特化したLLMを構築・カスタマイズしたいというニーズは急速に高まっています。本記事では、大規模言語モデルを構築するために必要なアーキテクチャの理解から、データ収集・前処理、学習手法、評価・デプロイまでを体系的に解説します。「ゼロからの事前学習」「ファインチューニング」「RAGを用いた構築」といった複数のアプローチを比較しながら、2026年時点の実践知識を網羅的にまとめました。
次に読む:LLMの主要モデル一覧は?

大規模言語モデル構築の全体像
LLMの構築とは、大量のテキストデータを用いてニューラルネットワークを学習させ、自然言語を理解・生成できるモデルを作り上げるプロセスです。ただし「構築」という言葉には複数のアプローチが含まれており、目的・予算・データ量によって最適な手法は大きく異なります。
| アプローチ | 概要 | 必要なリソース | 主なユースケース |
|---|---|---|---|
| 事前学習(Pre-training) | ゼロからモデルを学習 | 超大規模GPU・数百TB以上のデータ | 新規基盤モデルの開発、研究機関・大企業 |
| ファインチューニング(Fine-tuning) | 既存モデルを自社データで追加学習 | 中〜大規模GPU・数千〜数百万件のデータ | 業種・業務特化モデル、社内専門用語対応 |
| PEFT(パラメータ効率チューニング) | LoRA等でパラメータの一部のみ更新 | 小〜中規模GPU・比較的少量のデータ | リソース制約下でのカスタマイズ |
| RAG(検索拡張生成) | モデル自体は変えず知識ベースを外付け | 軽量・ベクトルDB構築が中心 | 社内文書Q&A、最新情報への対応 |
| プロンプトエンジニアリング | 既存モデルをプロンプト設計で制御 | ほぼ不要(APIコスト程度) | 迅速なPoC、汎用タスクへの適用 |
多くの企業にとって現実的な選択肢は、既存のオープンソースモデル(Llama 3、Mistral、Qwen等)をベースにしたファインチューニングやPEFT、あるいはRAGの組み合わせです。一方、特定分野の専門性・データ機密性・モデルの完全な所有権を重視する場合には、より深い層からの構築を検討する価値があります。
構築の前に知っておく基本:LLMの中身を実機で確かめる
大規模言語モデル(LLM:Large Language Model)とは、膨大な文章データを学習し、「次に来る語(トークン)」を確率で予測することで、文章の生成・要約・翻訳・質問応答などを行うAIです。「大規模」とは、モデルの中の調整可能な数値(パラメータ)の数と、学習に使うデータの量が非常に大きいことを指します。ChatGPT・Claude・Gemini が代表例です。LLMそのものの定義と全体像は大規模言語モデル(LLM)とはで解説しています。この記事は、その大規模言語モデルを自社で作る・カスタマイズする(構築する)方法に絞って扱います。
実機で確かめる:LLMは「次の語の確率表」を出している
この端末(Linux・RTX 3090・Ollama 0.40.6)で、Meta の Llama 3.2 3B(llama3.2:3b)を動かし、ollama show llama3.2:3b で中身の仕様を表示しました(2026年10月20日確認)。パラメータ数 3.2B(32億)、文脈長 131072、埋め込みの次元 3072、量子化 Q4_K_M、ファイルの大きさ 2.0GB でした。後の章の「LLMのスケールを決める主要ハイパーパラメータ」の表にある「コンテキスト長」「隠れ次元数」が、実在のモデルでは具体的にこのような値で持たれています。
次に、Ollama の API(/api/generate)に "raw": true, "logprobs": true, "top_logprobs": 5, "temperature": 0, "num_predict": 1 を指定して、書き出しの続きの「次の語」の候補を確率つきで取り出しました。
| 書き出し | 次の語の候補(確率の高い順) |
|---|---|
| 日本の首都は東京、アメリカの首都は | 「ワ」78.7%/「WASHINGTON」2.3%/「Washington」1.2%/「?」0.8%/「?+改行」0.7% |
| 大規模言語モデルは、次の | 「特」11.5%/「要」7.0%/「 」4.4%/「問題」2.3%/「ことを」2.2% |
1行目は文脈から答えがほぼ決まるため「ワ」(「ワシントン」の最初のトークン)に約79%が集まります。2行目は続き方が無数にあるため、最上位でも約12%です。LLMは、この確率の表から語を1つ選んで書き足す動作を繰り返して文章を作っています。事前学習とは、この「次の語の当てやすさ」を、膨大な文章で何度も繰り返して鍛える工程です(後の「事前学習」の章の学習目標=次トークン予測)。小さなモデルでも、基本の仕組みは大きなモデルと同じです。
「大規模」はどれくらいか:パラメータ数の実例
パラメータ数は、モデルの中で学習によって調整される数値の個数です。実在のモデルでは次のような規模です。
| モデル | パラメータ数 | 出典・補足 |
|---|---|---|
| Llama 3.2 3B(Meta) | 32億(3.2B) | この端末で ollama show により確認(ファイル2.0GB) |
| Mixtral 8x7B(Mistral AI) | 全体467億(46.7B)/1語あたり129億(12.9B) | Mistral AI の発表(2023年12月11日)。MoE構造で、語ごとに8つの専門家から2つを使う |
| GPT-3(OpenAI) | 1,750億(175B) | 2020年の論文での公表値 |
| gpt-oss 20b/120b(OpenAI) | 20B/120B(公式の呼び名) | Ollama のタグ一覧でファイルは14GB/65GB。Apache 2.0(ollama.com/library/gpt-oss・2026年10月20日確認) |
数十億から数千億まで幅があり、大きいほど学習に必要なGPUと時間が増えます。MoE では全体のパラメータ数と、1語の処理に使う数が異なる点に注意してください。
LLMで何ができるか:手元の小型モデルに実際に頼んだ結果
用途は、文章生成・要約・翻訳・コード生成・質問応答です。Llama 3.2 3B(温度0・乱数の種固定)に頼んだ結果を、そのまま載せます(2026年10月20日)。
| 用途 | 頼んだ内容 | 返ってきた結果 |
|---|---|---|
| 翻訳 | 「A large language model predicts the next token, one at a time, based on the text so far.」を日本語に | 「大規模な言語モデルは、現在のテキストに基づいて次のトークンを予測する。次のトークンを一つ一つ予測する。」(意味は合っているが、後半が重複した言い回し) |
| コード生成 | 整数のリストから偶数だけを返す Python の関数 only_even | def only_even(numbers): return [num for num in numbers if num % 2 == 0](正しい書き方) |
| 質問応答 | 「社内の問い合わせ対応を自動化したい」という相談に、LLMでできることを2つ | 「Q&A機能」「文脈分析機能」を挙げたが、「トレーニングデータから抽出した答え」という説明は実際の仕組みとずれており、具体性に欠ける |
小型モデルでも、コードや翻訳のように正解が決まる作業は成立します。一方、曖昧な相談には中身の薄い答えになりやすく、ここが「自社用に作る」とき、データを足す(RAG・ファインチューニング)理由になります。
代表的なLLMの配布形態と、作る側の選択肢
| モデル | 提供元 | 使い方・ライセンス(確認できたもの) |
|---|---|---|
| ChatGPT(GPT)・Claude・Gemini | OpenAI・Anthropic・Google | クラウドのAPI・アプリで利用する形。モデルの重みは公開されず、自社で追加学習はできない(提供される調整機能の範囲) |
| Llama 3.2 | Meta | 重みを取得して自分の環境で動かせる。ライセンスは「Llama 3.2 Community License Agreement」(ollama show の表示) |
| gpt-oss | OpenAI | 重みを取得可能。Apache 2.0(Ollama のページ) |
| Qwen3.5 | Alibaba | 重みを取得可能。0.8b は Apache 2.0(Ollama のモデル一覧) |
自社で「作る」ときの素材になるのは、重みが公開されたモデルです。各モデルの性能・料金の比べ方はLLM比較、一覧は主要LLMのカタログで扱っています。企業での活用事例は、後ろの「LLMの企業での活用事例」で、各社の公式発表を確認できたものだけを載せています。
ハルシネーション(もっともらしい誤り)とその対策
ハルシネーション(幻覚)とは、LLMが事実でないことを、もっともらしい文章で自信ありげに答える現象です。OpenAI の研究論文「Why Language Models Hallucinate」(2025年・arXiv 2509.04664)は、原因として、事前学習で正しい文と誤った文を見分けきれないこと、そして多くの評価が「分からない」と答えるより推測したほうが点数が高くなる採点であることを挙げています。つまり、LLMが「次の語」を確率で選ぶ仕組みそのものから、一定の誤りは起こりえます。
この端末の実測でも起きました。Llama 3.2 3B に「ローカルLLMとは何かを、初心者向けに3文で説明してください。」と頼むと、「特定の地域や言語を対象にしたLLM」と答えました。誤りです。しかも温度を0(ばらつきを最小にする設定)にして3回試しても、3回とも同じ誤答でした。温度を下げても、誤りは消えません。
| 対策 | やること | 限界 |
|---|---|---|
| 根拠となる資料を渡す(RAG) | 社内文書や公式資料を検索して、その内容を材料に答えさせる | 資料が古い・不足していれば誤る。検索で拾えないこともある |
| 出典を示させる・確認する | 回答に根拠の箇所を付けさせ、人が原文で照合する | 出典自体を取り違えることがあるため、原文を開いて確認する |
| 温度などの設定を下げる | 回答のばらつきを抑え、同じ質問に同じ答えが返りやすくする | 上の実測のとおり、誤りは消えない(同じ誤りが安定して出る) |
| 追加学習(ファインチューニング) | 自社の用語・書き方を学習させる | 知識の正しさを保証するものではない。更新のたびに学習し直しが必要 |
| 人の確認を工程に入れる | 数値・固有名詞・法律や医療に関わる回答は、必ず人が確かめてから使う | 確認の手間がかかる。確認する範囲を先に決めておく |
構築の場面では、「誤りが出る前提で、確認する仕組みを先に設計する」ことが、モデルの選定や追加学習と同じくらい大切です。
BERTとGPTの違い:同じTransformerでも読み方が違う
どちらも2017年に提案された Transformer(論文「Attention Is All You Need」・arXiv 2017年6月12日)を土台にしています。違いは、文章の「どこまでを手がかりにするか」と、得意な使い方です。
| BERT(Google) | GPT系(OpenAI) | |
|---|---|---|
| 読み方 | ある語の前後の両方を手がかりにする(論文の表現は「deep bidirectional」=深い双方向) | 左から右へ、これまでの語だけを手がかりに次の語を予測する(自己回帰) |
| 主な使い方 | 文章の分類・抽出など、文章を理解して判定する用途 | 文章の生成・対話など、続きを書く用途。今のChatGPTなどの土台 |
| 一次出典 | Devlin ら「BERT: Pre-training of Deep Bidirectional Transformers for Language Understanding」(arXiv 2018年10月11日) | Brown ら「Language Models are Few-Shot Learners」(GPT-3・arXiv 2020年5月28日)。1,750億パラメータの自己回帰モデルと記載 |
LLMの歴史:年表と一次出典
| 時期 | 出来事 | 出典 |
|---|---|---|
| 2017年6月 | Transformer が提案される | arXiv:1706.03762 |
| 2018年 | BERT(Google・10月)と、GPT(OpenAI)が登場。大量の文章で事前学習してから用途に合わせる流れが広がる | BERTは arXiv:1810.04805 |
| 2020年5月 | GPT-3(1,750億パラメータ)。追加学習なしで、例を数個示すだけで多様な課題を解けることが報告される(一部のデータでは苦手とも記載) | arXiv:2005.14165 |
| 2022年11月 | ChatGPT が公開され、対話形式のLLMが一般に広まる | OpenAIの公式発表 |
SLM(小規模言語モデル)との違い
SLM(Small Language Model)は、LLMより小さなパラメータ数で作られた言語モデルです。決まった基準はなく、数十億パラメータ前後のモデルを指して使われることが多い言葉です。
| LLM(大規模) | SLM(小規模) | |
|---|---|---|
| 規模の例 | GPT-3は1,750億パラメータ(論文) | Phi-3-mini は38億(Microsoftの技術報告・arXiv 2024年4月22日。「スマートフォンに載せられる大きさ」と記載)。この記事で動かした Llama 3.2 3B は32億 |
| 動かす場所 | 大きなGPUやクラウドが前提 | ノートPCや手元のGPUでも動く(この端末では Llama 3.2 3B が 2.6GB のメモリで動作) |
| 得意・不得意 | 幅広い話題や複雑な指示に強い | 要約・分類・コードの定型など限られた作業向き。用語の定義を取り違えることがある(上の実測) |
| 構築での位置づけ | API利用か、重みが公開されたモデルの追加学習 | 自社用に追加学習して手元や社内で動かす選択肢 |
LLMの企業での活用事例:各社の公式発表から
次の3件は、企業自身が公式サイトで公開した発表文を2026年10月20日に読んで確認した内容です。発表文に書かれた効果の数値は、ここでは転載していません。詳しくは各社の原文を確認してください。
| 企業 | 用途(発表内容) | 発表日 | 出典 |
|---|---|---|---|
| 明治安田生命保険 | 社内専用の「AIアシスタント」で資料作成や社内照会を支援。お客さまのお申し出への回答案の作成など、生命保険業務に特化した活用を試験的に開始。Microsoft の Azure OpenAI Service を利用 | 2023年11月27日 | 明治安田生命 ニュースリリース(PDF) |
| パナソニック コネクト | 2023年2月から、ChatGPT を基にした社内AIアシスタントを国内の全社員に展開。業務効率化や情報収集、品質管理規定・過去事例の検索に活用 | 2024年6月25日 | パナソニック コネクト ニュースリリース |
| 三菱UFJフィナンシャル・グループ | OpenAI と覚書を締結し、ChatGPT Enterprise の利用を開始。最新の産業情報の収集、コードや設計書の作成、データ分析の自動化、部署別のカスタムGPTの作成などを実証 | 2024年10月15日 | MUFG ニュースリリース(PDF) |
3件に共通するのは、まず社内の文書作成・照会・情報収集のような日常業務から始め、既存のLLMサービスを自社の環境で安全に使う形にしている点です。自社専用のLLMをゼロから作る例ではありません。冒頭の「何から始めればいいか」で、RAGや既存モデルの活用を先に検討すると述べた理由と一致します。
アーキテクチャの理解:Transformerの仕組み
LLMの構築において、基盤となるTransformerアーキテクチャの理解は不可欠です。モデルのどこをどう変えれば何が改善されるかを把握しないまま構築を進めると、チューニングの方向性を誤りやすくなります。
Transformerの主要コンポーネント
トークンをベクトルに変換。位置エンコーディングを付加。
アテンション
トークン間の関係(文脈)を複数の視点で計算。
各位置で非線形変換を適用。特徴の抽出・変換。
語彙サイズ分のlogitを生成しSoftmaxで確率化。
LLMのスケールを決める主要ハイパーパラメータ
| パラメータ | 意味 | 代表的な値の範囲 |
|---|---|---|
| レイヤー数(depth) | Transformerブロックの積み重ね数 | 12(小規模)〜 128(超大規模) |
| 隠れ次元数(d_model) | 各トークンの埋め込みベクトルの次元 | 768 〜 16,384 |
| アテンションヘッド数 | マルチヘッドアテンションの並列数 | 12 〜 128 |
| コンテキスト長 | 一度に処理できるトークン数 | 2,048 〜 128,000以上 |
| 語彙サイズ | トークナイザが扱うユニーク単語数 | 32,000 〜 128,000 |
2024〜2026年にかけては、Grouped Query Attention(GQA)やMixture of Experts(MoE)アーキテクチャの採用が主流になりつつあります。GQAはKV-cacheのメモリ効率を大幅に改善し、MoEはパラメータ数を増やしながら推論コストを抑えられる設計として、Mixtral・Deepseek・Gemini 1.5などで採用されています。
データ収集と前処理:品質がモデルの全てを決める
「Garbage in, garbage out」という原則はLLMにこそ当てはまります。膨大な計算資源を投じても、データの品質が低ければ性能の高いモデルは生まれません。データパイプラインの設計こそが構築成否の鍵です。
データ収集の主なソース
- Webクロールデータ:Common Crawl、C4、FineWebなど。量は最大だが品質管理が必須。
- 書籍・学術論文:Books3、arXiv、PubMedなど。専門性・文体の多様性が高い。
- コードデータ:GitHub、Stack Overflowなど。コーディング能力・論理推論の向上に寄与。
- 対話・指示データ:ShareGPT、OpenAssistant、Dolly等。チャット・instruction following能力の基盤。
- 自社独自データ:業務文書、カスタマーサポートログ、製品マニュアル等。ドメイン特化に不可欠。
前処理パイプラインの標準的なステップ
- フォーマット正規化:HTML除去、文字コード統一(UTF-8)、改行・空白の正規化。
- 言語識別・フィルタリング:fastTextやlangdetectで目的言語のみ抽出。
- 品質フィルタリング:文字数・単語数の閾値設定、記号・数字の比率チェック、ヒューリスティックルール適用。
- 重複排除(deduplication):MinHashやSuffix Arrayによる近似・完全重複の除去。学習データの多様性確保に重要。
- 有害コンテンツ除去:ヘイトスピーチ、個人情報(PII)、著作権侵害コンテンツの除去。
- トークナイゼーション:Byte Pair Encoding(BPE)またはSentencePieceで語彙を構築し、テキストをトークン列に変換。
日本語特有の課題として、形態素境界の扱いがあります。英語と異なりスペースで単語が区切られないため、日本語特化のトークナイザ設計(例:MeCabベースの前処理+BPE、またはtiktoken互換の多言語語彙)が重要です。Llama 3やQwen 2.5は日本語の語彙をある程度カバーしていますが、業務特化語彙の追加が効果的な場面も多くあります。
事前学習(Pre-training):ゼロからモデルを作る
事前学習は最もリソースを要するプロセスですが、その仕組みを理解することはファインチューニング時にも役立ちます。モデルが「どのように言語を学ぶか」を把握しておくことで、後続ステップの設計精度が上がります。
学習目標(Objective)
デコーダ型LLM(GPTアーキテクチャ)の主な学習目標は次トークン予測(Causal Language Modeling)です。入力シーケンスの各位置で次のトークンを予測し、クロスエントロピー損失を最小化します。この単純なタスクを膨大なデータで繰り返すことで、文法・意味・世界知識・推論能力が創発的に獲得されます。
学習インフラの要件
| モデル規模 | パラメータ数 | 必要GPU(参考) | 学習データ規模 | 学習期間(参考) |
|---|---|---|---|---|
| 小規模 | 1〜7B | H100×8〜64枚 | 数百GB〜数TB | 数日〜数週間 |
| 中規模 | 13〜30B | H100×64〜256枚 | 数TB〜数十TB | 数週間〜2ヶ月 |
| 大規模 | 70B〜 | H100×1,000枚以上 | 数十〜数百TB | 数ヶ月 |
| 超大規模 | 400B〜(MoE等) | H100×数千〜1万枚以上 | 数百TB〜PB級 | 半年以上 |
分散学習の手法
大規模モデルの学習には、単一GPUのメモリに収まらないため分散学習が必須です。主要な戦略を以下に示します。
- データ並列(Data Parallelism):同一モデルを複数GPUに複製し、異なるバッチで並列計算。勾配を平均して同期。最もシンプルな分散手法。
- テンソル並列(Tensor Parallelism):行列演算を列方向・行方向に分割し、複数GPUに配置。Megatron-LMが代表的実装。
- パイプライン並列(Pipeline Parallelism):レイヤーを段階的に複数GPUに分割。GPipeやPipeDreamが先行。
- ZeRO最適化(DeepSpeed):オプティマイザ状態・勾配・パラメータをGPU間で分割してメモリ効率を極限まで改善。
- FSDP(Fully Sharded Data Parallel):PyTorchネイティブのシャーディング手法。ZeRO-3相当の効率を提供。
実務的には、Megatron-LM + DeepSpeedの組み合わせ、またはPyTorchのFSDP2が2025〜2026年の標準的な学習スタックとなっています。学習フレームワークとしてはNeMo(NVIDIA)、LLaMA-Factory、torchtitanなども広く使われています。
学習の安定化テクニック
- 勾配クリッピング:勾配爆発を防ぐため、ノルムが閾値を超えた場合にスケールダウン(通常1.0)。
- 学習率スケジューリング:Warmup後にコサインアニーリング。適切なピーク学習率はモデル規模に依存(Chinchilla則を参考に設定)。
- 混合精度学習(BF16/FP16):メモリ削減と高速化。BF16が数値安定性の面でFP16より推奨される。
- Flash Attention:IO効率を改善したアテンション計算実装。長コンテキスト学習を現実的にした。
ファインチューニング:既存モデルを自社用途に最適化する
多くの企業・開発者にとって現実的かつ費用対効果の高い選択肢が、オープンソースの基盤モデルを起点としたファインチューニングです。適切な手法を選択することで、限られたリソースでも高い専門性を持つモデルを構築できます。
教師ありファインチューニング(SFT)
指示文(instruction)と期待される回答(response)のペアデータを使ってモデルを追加学習する最も基本的な手法です。データフォーマットの標準としてはAlpaca形式やChatML形式が広く使われています。
SFTに必要なデータ量の目安:
- 特定タスクの性能向上:数百〜数千件の高品質データ
- 汎用instruction following能力の付与:1万〜10万件程度
- 新たな知識領域のカバー:数十万件以上(継続事前学習も検討)
PEFT:パラメータ効率的ファインチューニング
全パラメータを更新するフルファインチューニングは計算コストが高く、壊滅的忘却(catastrophic forgetting)のリスクもあります。PEFTは少数のパラメータのみを更新することでこれらを克服します。
| 手法 | 仕組み | 特徴 | 代表ライブラリ |
|---|---|---|---|
| LoRA | 重み行列を低ランク行列の積で近似し差分のみ学習 | 最も広く普及。rank値で更新パラメータ量を調整 | HuggingFace PEFT |
| QLoRA | 4bit量子化モデルにLoRAを適用 | 単一コンシューマGPUでも大規模モデルのFT可能 | bitsandbytes + PEFT |
| DoRA | LoRAに重みの方向と大きさを分離した更新を追加 | LoRAより高精度。2024年以降に注目 | HuggingFace PEFT |
| Prefix Tuning | 入力に学習可能なプレフィックストークンを付加 | モデル本体を完全固定。タスク切り替えが容易 | HuggingFace PEFT |
| IA3 | アテンション・FFN層の活性化をスケーリング | LoRAよりパラメータ数が少ない。few-shot向き | HuggingFace PEFT |
RLHFとDPO:人間のフィードバックによるアライメント
SFTで基本能力を付与した後、モデルの出力を人間の好みや価値観に合わせる工程がアライメントです。
- RLHF(人間のフィードバックによる強化学習):報酬モデルを学習し、PPO等の強化学習でポリシーを最適化。ChatGPTで有名になった手法。実装の複雑さが難点。
- DPO(Direct Preference Optimization):好ましい回答と好ましくない回答のペアから直接方針を最適化。RLHFより安定・シンプルで2023年以降急速に普及。
- ORPO / SimPO:2024年に提案された新しいアライメント手法。参照モデル不要でさらに効率化。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
RAG(検索拡張生成)による構築:知識を外部に持つ設計
モデルのパラメータ自体に知識を持たせるのではなく、外部の知識ベースを参照させるRAG(Retrieval-Augmented Generation)は、最新情報への対応・ハルシネーション低減・知識更新コストの削減という点で優れた設計です。
RAGシステムの構成フロー
ドキュメントをチャンク単位に分割(500〜1,000トークン)
Embeddingモデルでベクトル化(text-embedding-3等)
Qdrant・Chroma・Weaviate等に索引化して保存
クエリをベクトル化し類似チャンクをk件取得
LLMがコンテキストと検索結果を合わせて回答生成
RAGの高度化:Advanced RAG
- Hybrid Search:ベクトル検索(意味的類似性)+BM25(キーワード一致)を組み合わせ、検索精度を向上。
- Re-ranking:初期検索結果をCross-Encoderで再スコアリング。BGE-Reranker等が代表的。
- Query Expansion / HyDE:LLMでクエリを展開・仮説回答を生成してからEmbeddingを取ることで検索精度向上。
- Agentic RAG:検索→生成→評価→再検索のループをエージェントが制御。複雑な質問への対応力向上。
- GraphRAG:文書からナレッジグラフを構築し、エンティティ間の関係を活かした検索を実現(Microsoft提案)。
モデルの評価:何を・どのように測るか
構築したLLMを適切に評価することは、改善の方向性を決める上で非常に重要です。単一のベンチマークスコアだけでは不十分であり、目的に応じた多面的な評価設計が必要です。
主要な評価ベンチマーク
| ベンチマーク | 測定能力 | 特徴 |
|---|---|---|
| MMLU | 57分野の知識・推論 | 汎用知識の標準指標。多肢選択式。 |
| HumanEval / MBPP | コード生成能力 | Pythonコードの正解率(pass@k)で評価。 |
| MT-Bench / Alpaca Eval | 会話・指示遵守能力 | GPT-4等をジャッジに使うLLM-as-a-Judge評価。 |
| JMMLU / JGLUE | 日本語の知識・理解能力 | 日本語モデル評価の標準セット。 |
| TruthfulQA | ハルシネーション傾向 | 誤った一般通念に対する正確な回答率を計測。 |
| カスタム評価セット | 業務特化タスク | 自社ユースケースに合わせた評価が最も重要。 |
評価の実施方法
- lm-evaluation-harness(EleutherAI):オープンソースの標準的評価フレームワーク。多数のベンチマークに対応。
- LLM-as-a-Judge:人手評価のコストを削減しつつ品質基準を維持。バイアスに注意が必要。
- 人手評価(Human Evaluation):最終的な品質保証は人手による評価が不可欠。アノテーターの基準統一が重要。
- A/Bテスト・オンライン評価:実際のユーザーからのフィードバックを収集し、継続的改善に活かす。
量子化と最適化:効率的な推論のために
構築したモデルを本番環境で動かす際には、推論速度・メモリ使用量・コストのトレードオフを最適化する必要があります。量子化はモデルの重みをより少ないビット数で表現する技術であり、精度の低下を最小限に抑えながら大幅なリソース削減を実現します。
| 量子化手法 | 精度 | 特徴 | 主なツール |
|---|---|---|---|
| FP16 / BF16 | ほぼ無劣化 | 学習時の標準。推論でも広く使用。 | PyTorch標準 |
| INT8 | 軽微な劣化 | メモリ半減。LLM.int8()で大規模モデルに対応。 | bitsandbytes |
| GPTQ(INT4) | わずかな劣化 | 後処理量子化の代表。VRAM使用量を大幅削減。 | AutoGPTQ |
| GGUF(llama.cpp) | 設定により調整可能 | CPU推論に最適化。M系Mac・ローカル実行向き。 | llama.cpp |
| AWQ | GPTQより高精度なケース多 | 重みの重要度を考慮した活性化認識量子化。 | AutoAWQ |
推論速度向上のためのその他の最適化技術として、Speculative Decoding(小型モデルで候補を生成し大型モデルで検証)、Flash Attention 2/3、Continuous Batching、PagedAttention(vLLMが実装)なども重要です。本番サーバーにはvLLMやTGI(Text Generation Inference)が広く採用されています。
デプロイと運用:本番環境への展開
モデルの性能評価が完了したら、実際のサービスとして提供するためのデプロイ設計が必要です。ここでは可用性・セキュリティ・コストの三点を意識した設計が求められます。
デプロイ方式の選択肢
- クラウドGPUサーバー(自社管理):AWS(p4d/p5インスタンス)、GCP(A3等)、Azure(NDシリーズ)などにvLLMを構築。最高の自由度。
- マネージドLLMホスティング:AWS Bedrock、Azure AI Studio、Together AI、RunPod等。インフラ管理を委託し開発に集中。
- オンプレミス:データ機密性が最重要な場合。NVIDIA DGXシステム等を自社設備に設置。
- エッジデプロイ:量子化モデルをスマートフォンや組み込み機器上で動作させる。llama.cpp、MLC-LLM等を活用。
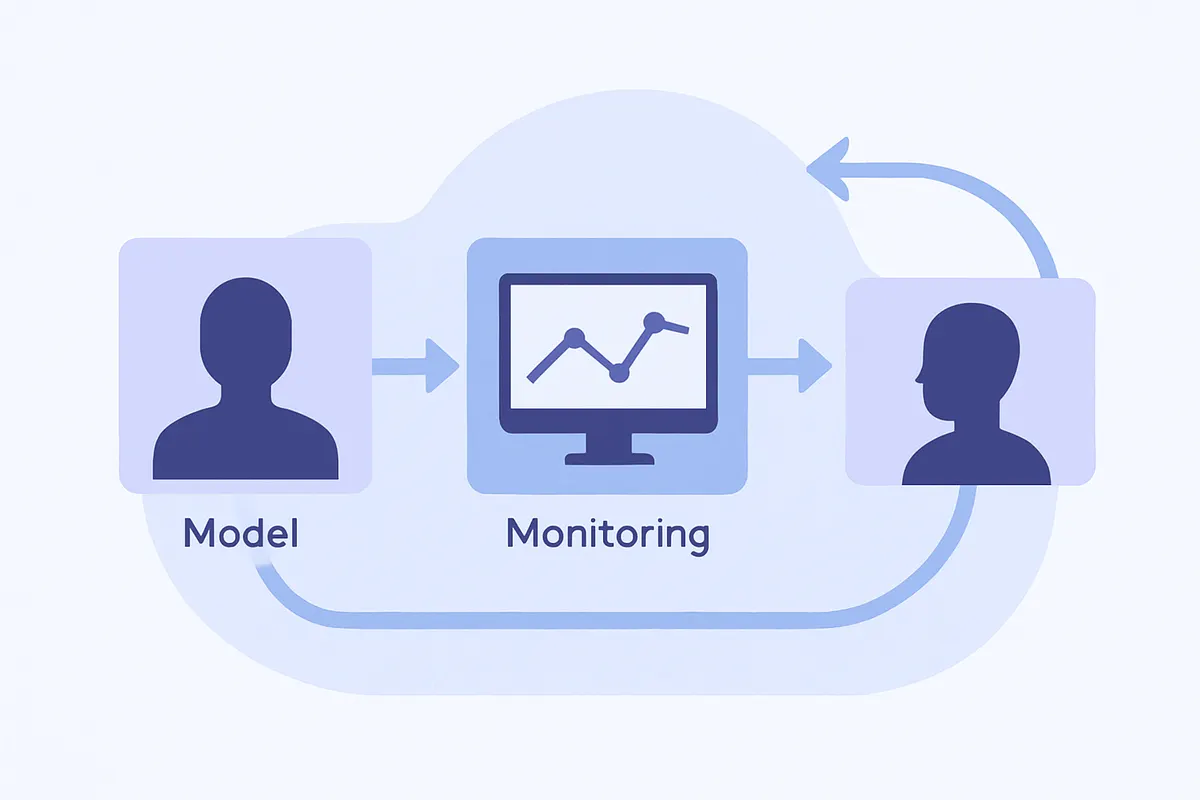
MLOpsと継続的改善
- モデルバージョン管理:MLflow、Weights & Biasesでモデルの実験・バージョンを追跡。
- モニタリング:レイテンシ・スループット・エラー率に加え、出力品質の継続的モニタリング(ドリフト検知)。
- ガードレール設定:有害コンテンツ・機密情報の出力抑制のため、NeMo Guardrails等を導入。
- フィードバックループ:ユーザーの高評価・低評価データを収集し、定期的なリチューニングに活用。
セキュリティとガバナンス:安全なLLM構築のために
LLMを企業システムに組み込む際、セキュリティリスクへの対処とガバナンス体制の整備は不可欠です。特に社内機密データでファインチューニングを行う場合や、外部ユーザーに公開するサービスを構築する場合には慎重な設計が求められます。
- プロンプトインジェクション対策:ユーザー入力によってシステムプロンプトを無効化・書き換えられる攻撃への防御。入力検証・サンドボックス設計が基本。
- データ漏洩防止(DLP):ファインチューニングデータ中の個人情報・機密情報がモデルから抽出されるリスクを低減。学習前のPII除去が最重要。
- 差分プライバシー(DP-SGD):学習時に数学的なプライバシー保証を付与する手法。医療・金融分野で特に有効。
- アクセス制御:LLM APIへのアクセスをRBACで管理し、ログを取得。誰が何を聞いたかを追跡可能にする。
- AI Act・国内規制への対応:EU AI Act(2024年発効)では高リスクAIシステムに透明性・説明責任が要求される。日本国内でも関連ガイドラインが整備されつつあり、早期から対応設計が求められる。
日本語LLM構築における固有の課題と対策
日本語に特化したLLMを構築する場合、英語中心の既存モデルをそのまま使用するのと異なる考慮事項があります。
- トークン効率の問題:日本語は英語と比べてトークン数が多くなりやすく(漢字・ひらがな・カタカナが混在)、コンテキスト長を圧迫する。日本語に最適化された語彙でのトークナイザ再学習や、既存語彙への日本語トークン追加(Vocabulary Expansion)が有効。
- 高品質日本語コーパスの不足:英語と比べてオープンな高品質データが少ない。CC-100、OSCAR、mC4、Wikipedia日本語版に加え、自社独自データの活用が差別化につながる。
- 敬語・文体の多様性:丁寧語・尊敬語・謙譲語など文体の多様性があり、ユースケースに応じた出力スタイルの制御が必要。指示データ設計時に文体を明示的に指定する。
- 日本語特化の評価基準:JGLUEやJMMLUといった日本語ベンチマークを活用しつつ、業務固有タスクの自社評価セット構築が長期的には最重要。
国内ではSwallow(東工大・産総研)、LLM-jp(国立情報学研究所主導)、Sarashina(SB Intuitions)などの日本語LLM研究プロジェクトが進行しており、公開されているモデルウェイトや学習知見が参考になります。
LLM構築のコスト試算と現実的な判断基準
プロジェクトの意思決定において、コストの現実的な把握は欠かせません。以下は2025〜2026年時点の概算であり、クラウド料金・GPU在庫状況によって変動します。
| アプローチ | 概算コスト(参考) | 期間 | 必要なチームスキル |
|---|---|---|---|
| プロンプトエンジニアリング | APIコスト数万円〜 | 数日〜2週間 | LLM API操作の基礎 |
| RAG構築 | 数十〜数百万円(インフラ込み) | 2週間〜2ヶ月 | Python・ベクトルDB・RAGフレームワーク |
| LoRA / QLoRAファインチューニング(7B) | 数万〜数十万円(GPU費用) | 数日〜2週間 | ML基礎・PyTorch・PEFTライブラリ |
| フルファインチューニング(7〜13B) | 数十万〜数百万円 | 1〜4週間 | 分散学習・MLOps・データエンジニアリング |
| 継続事前学習(70B規模) | 数百万〜数千万円 | 1〜3ヶ月 | 大規模ML基盤・インフラエンジニアリング |
| ゼロからの事前学習(100B+) | 数億円以上 | 数ヶ月〜半年以上 | 専門的MLチーム・大規模インフラ管理 |
多くの企業にとって「ゼロから事前学習する必要があるかどうか」の判断が最初の重要な分岐点です。商用モデルAPIのファインチューニング(OpenAI Fine-tuning APIなど)やオープンソースモデル+PEFTで目的の8割が達成できるなら、大規模事前学習への投資は費用対効果が見合わないことが大半です。独自の専門データが大量にある・モデルの完全な所有権が必要・特定の法規制要件がある、といった条件が揃った場合に初めて本格的な事前学習を検討すべきです。
まとめ
大規模言語モデルの構築は、単一の手法ではなく目的・リソース・データに応じた最適なアプローチの選択から始まります。事前学習・ファインチューニング・PEFT・RAGはそれぞれ異なるトレードオフを持ち、多くの実案件ではこれらを組み合わせたハイブリッドなアーキテクチャが採用されています。
重要なポイントを整理すると、まずデータ品質がモデル品質の上限を決めるという原則を常に念頭に置くこと。次に、ゼロから作るよりもオープンソースモデルをベースにしたカスタマイズが現実的かつ効果的なケースが大半であること。そして、性能評価・セキュリティ・運用の継続的改善まで含めた設計が、実際に使えるLLMを作る上で欠かせないこと。この三点が構築成功の核心です。
日本語特化の課題や自社固有のユースケースに対応するためには、適切なトークナイザ設計・ドメイン特化データの活用・業務評価セットの整備が長期的な競争優位につながります。LLM構築は一度で完成するプロジェクトではなく、フィードバックと改善を繰り返すMLOpsサイクルの中に位置づけることで、持続的な価値を生み出し続けることができます。
AIの業務活用・導入をご検討の方へ
クリスタルメソッドは、LLM・RAG・AIアバターを活用した業務へのAI導入を支援しています。自社の課題にどう活かせるか、まずはお気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
- 基礎から知る:大規模言語モデルとは
関連記事
Read next
あわせて読みたい
-
HRM-Text とは――1,500ドルで学習した階層型推論モデルの構造と意義
HRM-Text とは何か――概要と登場の背景 HRM-Text とは、AIスタートアップ「Sapient Intelligence」が2026年に発表した約1...
-

大規模言語モデル(LLM)一覧・リスト2026年版|主要モデル比較
大規模言語モデル(LLM)の選定は、2026年時点でさらに複雑な判断を要する局面に入っている。GPT・Claude・Geminiといったクローズドモデルが性能を...
-
大規模言語モデル(LLM)の活用とは?ビジネスと社会を変える技術の全体像
大規模言語モデル(LLM)の活用とは何か――ビジネスと社会を変える技術の全体像 大規模言語モデル(Large Language Model/LLM)の活用が、企...