
blog
AIブログ
大規模言語モデル(LLM)とは?生成AIとの違いや仕組みをわかりやすく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
大規模言語モデル(LLM)とは、膨大な文章から「次に来る言葉」を予測する訓練を重ね、文章の理解・生成ができるようになったAIのことです。ChatGPT・Gemini・Claudeなどの対話AIの頭脳にあたり、生成AIの中で「文章を扱う」部分がLLMです。このページは定義と全体像を扱い、モデルの一覧・比較・作り方・業務での使い方は、本文末の案内から各記事へ進めます。
「LLM」「大規模言語モデル」という言葉を目にする機会が増えました。でも、いざ人に説明しようとすると言葉に詰まる——この記事は、そんな方のための入口です。
むずかしい内部構造には踏み込みません。「大規模言語モデルとは何で、なぜすごくて、何ができて、何に気をつければいいか」——この4点を短時間でつかめる状態を目指します。定義 → 仕組み → 代表的なモデル → できること → 注意点 → 自社データの扱い、の順に整理しています。
大規模言語モデル(LLM)とは?ひとことで言うと
大規模言語モデル(Large Language Model、LLM)とは、膨大な量の文章を読み込んで「次に来る言葉」を予測する訓練を繰り返し、人のように文章を理解・生成できるようになったAIです。ChatGPT・Gemini・Claudeといった対話AIの「頭脳」にあたる部分です。
- 従来AIとの違い:タスクごとの専用プログラムではなく、1つのモデルで要約・翻訳・作文・質問応答・コード生成まで幅広く扱える「汎用性」が特徴です。
- できること:長文の要約、自然な翻訳、メールや提案書の下書き、質問への回答、プログラムの雛形づくりなど、「言葉を扱う仕事」をまとめて任せられます。
- 注意点:もっともらしく誤る「ハルシネーション(事実誤り)」が起こるため、重要な用途では出力を人が確認する運用が前提になります。
インターネット上の文章、書籍、論文、コードなど、想像を絶する量のテキストから、文法や言葉の意味だけでなく「この質問にはこう答えるのが自然」という人間の文章パターンを吸収しています。使う側の理解としては、「大量の文章を学んで、文章を扱えるようになったAI」——これで十分です。
そもそも「言語モデル」とは何か
言語モデルとは、「ある言葉の並びの次に、どの言葉が来やすいか」を確率で表したものです。たとえば「今日は天気が」の次には「いい」「悪い」が来やすく、「机」はまず来ません。この「次の言葉の出やすさ」を大量の文章から学んだものが言語モデルで、スマートフォンの文字入力で候補の言葉が先回りして出てくるのも、同じ考え方の小さな応用です。
この言語モデルのうち、学習させる文章の量・計算量・モデルの大きさ(パラメータ数)を桁違いに大きくしたものが「大規模」言語モデルです。大きくした結果、単に文章がつながるだけでなく、要約や翻訳、質問への回答までこなせるようになりました(理由は「なぜ『大規模』だと賢いのか」で説明します)。
政策・規制の観点からも注目されており、内閣府消費者委員会のAI技術専門調査会(2026年3月)でも「大規模言語モデルの技術的特質と安全性対策」が取り上げられています(内閣府、2026年3月)。
代表的な大規模言語モデルにはどんなものがあるかは、大規模言語モデル(LLM)一覧・リストで説明しています。
関連記事LLMは自分で構築できる?
生成AI・ChatGPTとLLMの関係を整理する
「生成AI」「ChatGPT」「LLM」は混同されやすい言葉です。関係をシンプルに整理します。
| 用語 | 位置づけ |
|---|---|
| 生成AI | テキスト・画像・音声などを新たに生成するAI全般の総称。LLMはその中の「テキスト系」にあたる |
| 大規模言語モデル(LLM) | 生成AIの一種。文章の理解・生成に特化した大規模モデル |
| ChatGPT | OpenAIが提供する対話サービス。LLMを使った代表的な製品の一つ |
| Claude / Gemini | AnthropicやGoogleが提供するLLMベースの対話サービス |
つまり、ChatGPTはLLMを使ったサービスの一つで、LLMは生成AIの一種です。「生成AI=ChatGPT」ではありません。生成AIの全体像は生成AIの解説記事、土台にある技術はディープラーニングの解説や機械学習の基礎をどうぞ。
次に読む:LLMの活用はビジネスでどう使える?

仕組みをざっくり:5つのステップ
内部でやっているのは「次に来る語を確率的に予測する」ことの繰り返しです。流れは5つに分けられます。
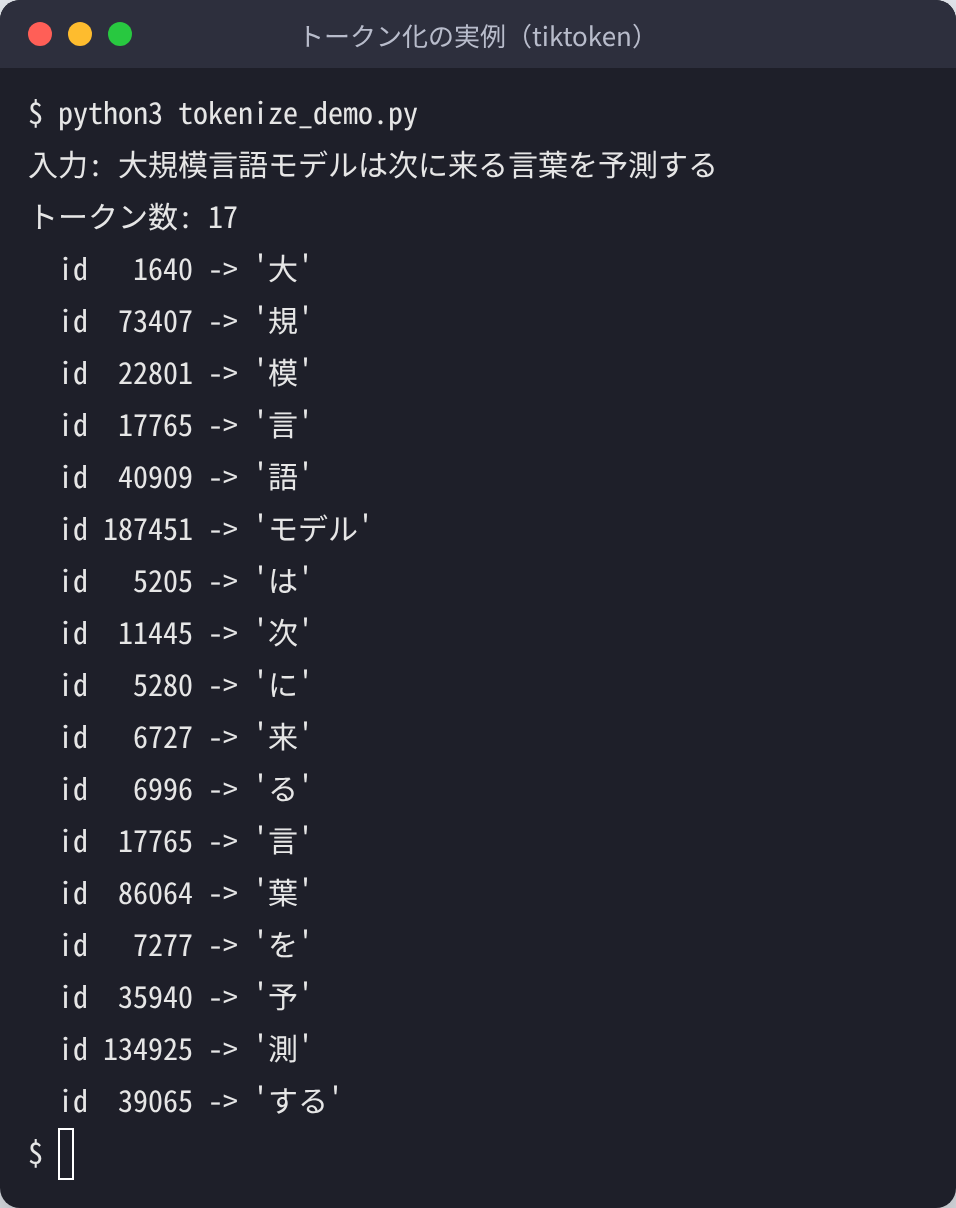
- トークン化:入力文を「トークン」という小さな単位(単語や部分文字列)に分解します。
- ベクトル化(埋め込み):各トークンを、意味の特徴を表す数値に変換します。意味の近い語は近くに配置されます。
- Transformerによる文脈処理:注意(Attention)という仕組みが、文中のどの語とどの語が関係するかを捉えます。 たとえば「今日は会社の機会が多い」と「工場の機械が止まった」のように、同じ発音でも文脈によって意味が変わる語があります。Attentionは、文中の他の語(「会社」「工場」など)との関連度を計算することで、こうした同音異義語も正しい意味で処理できるようにしています。
- 次トークンの予測:文脈から「次に来る確率が最も高い語」を計算します。
- デコード(生成):予測した語を一つずつ出力し、それを入力に戻して次を予測——を繰り返して文章を組み立てます。
ステップ1の「トークン化」は実際に試せます。下の画面は、OpenAIが公開しているトークナイザー(tiktoken・o200k_base)で日本語の一文を分けた結果です。17個のトークンに分かれ、「モデル」「する」はひとまとまり、「大」「規」「模」は1文字ずつになっています。LLMは文章をこの番号の列として受け取り、同じ番号の列として答えを返しています。
「大規模」とは、このパラメータ数と学習データ量が桁違いに大きいことを指します。BERTなど自然言語処理モデルの詳細はBERTの解説、テキスト活用全般はテキストマイニングの記事もどうぞ。
仕組みをもう少し詳しく:事前学習・事後学習・アーキテクチャ
事前学習(プレトレーニング)
インターネット上の文章・書籍・コードなど膨大なテキストを使い、「次の語を当てる」問題を何兆回も解かせます。この段階で文法・知識・推論の土台が作られますが、まだ「指示に従う」ことは学んでいません。計算資源の大半はここで使われます。
事後学習(ポストトレーニング)
事前学習済みのモデルに、人が書いた模範回答を学ばせる「教師ありファインチューニング」と、複数の回答を人が比べて良い方を選ぶ「人のフィードバックによる強化学習(RLHF)」などを施し、指示に従い、安全で、役に立つ回答をするよう調整します。ChatGPT以降の対話AIが使いやすくなったのは、この工程の成果です。
アーキテクチャ:Transformerと注意機構
現在のLLMのほぼすべてが「Transformer」という構造を採用しています。核となる「注意(Attention)」は、文中の各語が他のどの語とどれだけ関係するかを数値で計算する仕組みで、「それ」が何を指すか、長い文の前半と後半の対応関係などを捉えられます。モデルの規模は「パラメータ数」で表され、数十億から数兆に及びます。
なぜ「大規模」だと賢いのか
答えはシンプルで、学習する文章の量とモデルの規模が大きくなるほど、予測の精度が上がっていったからです。たとえるなら、1,000冊の本を読んだ人と、1億冊分の文章を読み込んだAIの違いです。量の差が、質の変化を生みました。
大規模化した3つの要素:計算量・データ量・パラメータ数
「大規模」と呼ぶときに大きくしているのは、次の3つです。
| 要素 | 何のことか |
|---|---|
| 学習データ量 | モデルに読ませる文章の量。Web・書籍・論文・コードなど、数兆トークン規模になります |
| パラメータ数 | モデルの中にある「調整できる数値」の個数。言葉どうしの関係をどれだけ細かく覚えられるかを左右し、数十億から数兆に及びます |
| 計算量 | 学習にかけるコンピュータの仕事量。データ量とパラメータ数が増えるほど、学習に必要な計算も増えます |
スケーリング則と「創発」
この3つを増やすほど性能が一定の法則で伸びることは、2020年にOpenAIの研究者が「Scaling Laws for Neural Language Models」という論文で示しました(arXiv:2001.08361)。これが「とにかく大きくすれば賢くなる」という開発競争の根拠になりました。さらに、ある規模を超えると、明示的に訓練していなかった能力(例を数個見せるだけで新しい仕事をこなす、段階的に推論する など)が急に現れることも観察され、研究者はこれを「創発」と呼んでいます。
文部科学省が運営するmanaPASSでも、大規模言語モデルはDXの基盤技術として位置づけられ、体系的な講座が公開されています(文部科学省manaPASS)。構築側の技術詳細(事前学習・アーキテクチャ選定など)は大規模言語モデルの構築記事に譲ります。
もう一歩深く:データ量・MoE・コンテキストウィンドウ
ここまでの「大規模」の話を、もう少しだけ踏み込んで整理します。構築や実装の詳細は大規模言語モデルの構築記事に任せ、ここでは名前を聞く機会の多い3つの考え方に絞ります。
| 考え方 | ひとことで言うと | 知っておく点 |
|---|---|---|
| データ量とモデルの大きさのバランス | モデルを大きくするだけでなく、学習に使う文章も同じ割合で増やす | 2022年にDeepMindの研究者らは、決まった計算量の中ではモデルの大きさと学習トークン数を同じ割合で増やすのが最適で、当時の大型モデルは学習データが不足していると報告しました(Hoffmann et al., arXiv:2203.15556)。 |
| MoE(Mixture of Experts) | モデルの中に複数の専門ブロックを持ち、入力ごとに一部だけを使う | Mistral AIのMixtral 8x7Bは、各層に8つの専門ブロックを持ち、1トークンごとにルーターが2つを選ぶ構造です。全体のパラメータのうち一部だけが推論で動くため、大きなモデルの能力を保ちつつ計算を抑えられます(Jiang et al., arXiv:2401.04088)。 |
| コンテキストウィンドウ | モデルが1回の応答で参照できる文章の範囲 | Anthropicの公式ドキュメントでは、回答そのものも含めてモデルが参照できるすべてのテキストを指し、学習に使った大量のデータとは別の「作業用のメモリ」にあたると説明されています。大きいほど長い資料を扱えますが、量が増えるほど精度や再現率が下がる場合があり、何を入れるかを選ぶことも大切です(Anthropic Docs: Context windows、2026年10月27日確認)。 |
この3つは「なぜ大きいモデルが賢いのか」「なぜ大きいのに速く動くモデルがあるのか」「なぜ長い資料を渡すと答えが変わるのか」という素朴な疑問の答えに直結します。
LLMの歴史:Transformerから現在まで
| 時期 | 出来事 | 何が変わったか |
|---|---|---|
| 2013〜2014年 | 単語を数値ベクトルで表す手法(word2vecなど)と、翻訳向けの系列変換モデル | 「言葉の意味を数値で扱う」基礎ができた |
| 2017年 | Transformerの提案 | 文中の語同士の関係を一度に捉える「注意(Attention)」の仕組みで、長い文脈の処理と大規模化が可能に |
| 2018年 | BERT、GPT-1 | 大量の文章で事前学習し、用途ごとに少し調整して使う方式が定着 |
| 2020年 | GPT-3(1,750億パラメータ) | モデルを大きくするほど性能が伸びる「スケーリング則」が注目され、例を見せるだけで多くの仕事をこなせることが示された |
| 2022年 | 人のフィードバックによる調整(RLHF)とChatGPTの公開 | 指示に従って会話できるようになり、一般に普及 |
| 2023〜2024年 | GPT-4、Gemini、Claude、Llamaなど。画像や音声も扱うマルチモーダル化、オープンモデルの充実 | 企業利用が本格化し、手元で動かせるモデルも増えた |
| 2025年〜 | 段階的に考える推論モデルと、ツールを使って作業を進めるエージェント化 | 「答える」から「作業を完結させる」へ用途が広がる |
代表的な大規模言語モデル(系統別)
個別のモデル名や版は数か月単位で更新されるため、ここでは系統と使われ方で整理します。最新の一覧は大規模言語モデル(LLM)一覧をご覧ください。
| 系統 | 提供元 | 主な使われ方 |
|---|---|---|
| GPTシリーズ | OpenAI | ChatGPTの中核。対話・文章作成・コード生成の汎用用途 |
| Gemini | 検索やGoogle Workspaceとの連携、長い資料や動画の理解 | |
| Claude | Anthropic | 長文の読解・要約、コーディング支援、安全性を重視した業務利用 |
| Llama・Gemma・Qwen・Mistralなど(オープンモデル) | Meta・Google・Alibaba・Mistral AIなど | 自社サーバーや手元のPCで動かすローカル利用、追加学習による特化 |
| 日本語特化モデル | 国内の大学・企業 | 日本語の敬語・固有表現が重要な業務、国内データでの追加学習 |
2026年10月時点の主なモデル
| 提供元 | 主なモデル(2026年10月確認) |
|---|---|
| OpenAI | GPT-6 Astra(最上位。複雑な推論とコーディング向け)、GPT-6.1 Sol(性能と費用のバランス型)、GPT-6 Luna(低コスト・大量処理向け)。ChatGPTでも2026年10月時点で有料プランの既定モデルがGPT-6になっています(無料プランはGPT-5.6 Luna) |
| Gemini 3.8 Flash、Gemini 3.8 Live、Gemini 3.1 Pro。次世代のGemini 4 Argonは2026年9月30日に発表され、まず限定された利用者への提供から始まっています | |
| Anthropic | Claude Fable 5.1(最上位)、Claude Opus 5.5、Claude Sonnet 5.5、Claude Haiku 5.5 |
| オープンモデル | Gemma 4(Google)、Qwen 3.5〜3.8(Alibaba)、Llama 4 Scout/Maverick(Meta)、gpt-oss(OpenAI)、Ministral 3(Mistral AI)など |
出典(2026年10月13日確認):OpenAI Models、OpenAI ヘルプ(ChatGPTのモデル)、Google Gemini API models、Google(Gemini 4 Argon)、Anthropic、Ollama Library、Mistral AIの各公式情報。
LLMとSLM(小規模言語モデル)の違い
近年は数十億パラメータ以下の「小規模言語モデル(SLM)」も注目されています。最大性能では大規模モデルに及びませんが、1台のPCやスマートフォンで動き、費用と応答速度に優れ、特定業務に絞れば実用水準に達します。上の表のGemma 4・Qwen・Ministral 3 などには、手元のパソコンで動く小さなサイズも用意されています。「何でもできる大規模」と「用途を絞って安く速い小規模」を使い分けるのが2026年時点の現実的な選択です(手元で動かす方法はローカルLLMの解説を参照)。
日本語に強いLLMと、公開モデルか提供サービスかの選び方
日本語の業務で使う場合と、自社の環境に合わせて使う場合では、見るべき点が変わります。
日本語・国産のLLM
国立情報学研究所の大規模言語モデル研究開発センター(LLMC)は、オープンで日本語に強いLLMとして「LLM-jp」シリーズを公開しています。同センターの公式サイトでは、2026年4月にDense型の「LLM-jp-4 8B」とMixture of Expertsの「LLM-jp-4 32B-A3B」を公開し、その後「LLM-jp-4 33B」や「LLM-jp-4.1」シリーズも公開したと案内されています(国立情報学研究所 LLMC、2026年10月27日確認)。国産モデルの比較は国産LLM比較で扱っています。
公開モデルと、提供サービスの違い
| 観点 | 公開モデルを自分で動かす | 提供サービス(ChatGPT・Gemini・Claudeなど)を使う |
|---|---|---|
| 手軽さ | 環境の用意と運用が必要 | アカウントを作ればすぐ使える |
| データの置き場所 | 自社のPCやサーバーに閉じて使える | 入力が外部のサービスに送られる前提で使う |
| 調整のしやすさ | 追加学習などモデルそのものを調整できる | 設定やプロンプトの工夫が中心 |
| 費用の考え方 | 設備と運用の費用がかかる | 利用量や契約プランに応じた費用がかかる |
| 確認すること | ライセンスの商用利用条件 | 利用規約とデータの取り扱い |
公開モデルの定義やライセンスはオープンソースLLMの解説、手元のPCで動かす方法はローカルLLMの解説で扱っています。
LLMでできること(業務での活用例つき)
得意な言語タスクを一覧にしました。「LLMは何屋さんか」がつかめるはずです。
| タスク | 具体的にできること |
|---|---|
| 要約 | 長い文書・議事録・レポートを指定した長さにまとめる |
| 生成 | メール文・提案書・広告コピーなどの文章を下書きする |
| 翻訳 | 日英・英日など多言語間の翻訳を自然な表現で行う |
| 分類 | 問い合わせ内容をカテゴリ分け、感情をポジ/ネガに分ける |
| 対話 | チャットボット・FAQ自動応答・カスタマーサポートの補助 |
| 情報抽出 | 契約書から条件を抜き出す、商品名・数値などを整理する |
| コード生成 | プログラムの雛形を生成、バグの説明や修正案を提示する |
LLMは「文章を扱う汎用エンジン」であり、バーチャルヒューマンのようにリアルタイムで人と対話するサービスでも、相手の言葉を受け取り文脈に合った返答を生成する役割を担っています。
LLMでこんなに変わる(before → after)
LLMのすごさは、「言葉を扱う仕事」がまとめて変わることです。
- 議事録・レポート:今まで=長い記録を読み返して手でまとめる → LLMなら=「3行で要約して」「決定事項だけ抜き出して」が数十秒。
- メール・提案書:今まで=ゼロから文面を考える → 要点を渡せば下書きが届き、トーンの調整(丁寧に/簡潔に)もお願いできる。
- 翻訳:今まで=翻訳ソフト+手直し → 文脈をくんだ自然な訳文が最初から出てくる。
- 問い合わせの仕分け:今まで=人が読んで振り分け → 内容のカテゴリ分けや緊急度の判定を任せられる。
- プログラミング:今まで=調べながら書く → 「こういう処理を書いて」で雛形が出てくる。エラーの説明もしてくれる。
ポイントは、これらを「一つのモデル」でまとめてこなせることです。以前は翻訳には翻訳専用、分類には分類専用のモデルが必要でした。LLMはその常識を変えました。
注意点と課題:ハルシネーション・プロンプトインジェクション・機密情報
LLMはとても便利ですが、万能ではありません。特に「正確さが重要な場面」では、性質を理解したうえで使う必要があります。
最大の注意点は、事実と異なる内容をもっともらしく生成すること——「ハルシネーション(幻覚生成)」です。LLMは「記憶を正確に引き出すシステム」ではなく「確率的に自然な続きを生成するシステム」なので、存在しない文献を引用したり、数値を誤って答えたりすることがあります。しかも、自信ありげな文章で。医療・法律・財務など正確さが命取りになる用途では、人が必ず確認する体制を設計段階から組み込んでください。「LLMが言ったから正しい」は危険な前提です。
- 知識の古さ:学習データには収集時点の締め切りがあり、最新情報や社内固有の情報は持っていません(後述のRAGで補えます)。
- バイアス:学習データ由来の偏りがモデルに残ることがあります。
- 機密情報の扱い:外部サービスに送るプロンプトには機密情報を含めない運用ルールが必要です。
ハルシネーションの2つの種類
ハルシネーションは、性質によって大きく2つに分けられます。
- Intrinsic(内在的):与えた資料や文脈の内容と矛盾する誤りです。例えば「この契約書の支払期限は?」と聞いたのに、資料に書かれた期日と違う日付を答えてしまうケースです。
- Extrinsic(外在的):与えた資料には無い情報を、それらしく作り出してしまう誤りです。存在しない条項や実在しない参考文献を挙げてしまうケースがこれにあたります。
どちらも「もっともらしく」出力される点が厄介で、資料と照らし合わせて検証する運用が欠かせません。実際の失敗例と対策はハルシネーションの事例記事にまとめています。
プロンプトインジェクション(悪意ある指示の混入)
LLMは「入力された文章」を指示として読むため、悪意のある人が、利用者の入力や読み込ませたWebページ・文書の中に「これまでの指示を無視して〇〇せよ」といった文を仕込むと、本来禁止されている動作をしてしまうことがあります。これをプロンプトインジェクションと呼びます。社内文書の検索やWeb閲覧をさせる用途では、外部から来た文章を指示として扱わない設計(権限の分離・出力の検証)が必要です。
LLMが苦手なこと
- 正確な計算や数の扱い:言葉の予測で答えるため、桁の多い計算や厳密な集計は電卓や表計算に任せる方が確実です。
- 最新の出来事:学習データの締め切り以降のことは知りません(検索やRAGで補います)。
- 根拠の提示:「なぜそう答えたか」の出典をそのまま示すことはできません。出典が要る場面では、資料を渡して引用させる形にします。
- 答えの揺れ:同じ質問でも毎回少しずつ答えが変わります。決まった形式で出したいときは、形式を指示するか、後述のファインチューニングで安定させます。
これらは「使うな」という話ではなく、「把握したうえで使う」ための注意点です。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
安全に使うために:機密情報・個人情報・偏り・費用
注意点を、使う前に決めておくことの形に整理します。
| 論点 | 起こりうること | 使う前に決めておくこと |
|---|---|---|
| 機密情報・個人情報 | 入力した文章が外部のサービスに送られる | 入力してよい情報の範囲と、使うサービスの規約・データの扱い設定の確認 |
| 偏りと公平性 | 学習データ由来の偏りが回答に出る | 採用や審査など人に影響する判断は、人が最終確認する |
| 誤りの責任 | もっともらしい誤りを、そのまま外部に出してしまう | 公開前に人が事実を確認する担当と手順 |
| 費用と速度 | 入力と出力の量に応じて費用が増え、長い文章ほど応答に時間がかかる | 用途ごとに、モデルの大きさ(大規模かSLMか)と利用量の見積もり |
この表は考え方の整理です。実際の規約や料金は、利用するサービスの公式ページで確認してください。
自社の知識を持たせるには——RAGとファインチューニング
汎用のLLMを自社に合わせる方法は大きく2つあります。「知識を渡したい」ならRAG、「話し方や作法を身につけさせたい」ならファインチューニングが基本の使い分けです。
- RAG(検索拡張生成):社内文書を検索してLLMに渡し、根拠にもとづいて答えさせる方法です。最新情報にも対応でき、ハルシネーション対策の定番でもあります。詳しくはRAGの解説記事へ。
- ファインチューニング:追加データでモデル自体を再学習し、文体やタスクに最適化する方法です。出力の形式を安定させたい場合に有効ですが、データ整備と計算コストがかかります。
実務では「事実や最新情報はRAGで補い、文体や振る舞いはプロンプト設計やファインチューニングで整える」という併用が現実的です。LLMにRAGや音声・アバター技術を組み合わせると、AI面接の練習相手のような「人と対話するAI」も作れます。鍵になるのはモデル単体の性能よりも、自社のデータや業務プロセスとどう接続するかです。
使いこなしの勘所:モデルの性能より、データと業務との接続
LLMを業務で使うときは、1つのモデルだけで済ませず、用途に応じて複数のLLMを使い分ける形が一般的です。実務で押さえておきたいのは、次の2点です。
ひとつは、ベンチマークの数値と、実務での「使い勝手」は必ずしも一致しないということ。指示への従順さ、長い文脈での安定性、こちらの意図の汲み取り方には、モデルごとに明確な個性があります。だからこそ「最新・最高スコアのモデルを一つ選べば終わり」ではなく、タスクごとに相性を見て選ぶ姿勢が現実的です。
もうひとつは、成果を左右するのはモデル単体の性能よりも、自社のデータや業務プロセスとの接続の設計だということ。RAGを使って社内や企業ごとのデータに答えさせる場面では、「どのモデルか」以上に「どのデータを、どう検索して、どう渡すか」が効果を左右します。LLM導入で失敗しやすいのは、まさにこの接続設計を後回しにしたときです。
大規模言語モデルに関するよくある質問
LLMとChatGPTは同じものですか?
違います。LLMは「文章を理解・生成するAIモデル」の総称で、ChatGPTはLLMを使った対話サービスの一つです。ClaudeやGeminiも同じくLLMベースのサービスです。
無料で触ってみることはできますか?
できます。ChatGPT・Gemini・Claudeなどの対話サービスには無料枠があります。手元のパソコンでLLM自体を動かしてみたい方はローカルLLMの解説が入口になります。
LLMの答えはそのまま信用していいですか?
そのままの信用は禁物です。もっともらしい間違い(ハルシネーション)があるため、事実確認は人の仕事として残ります。社内情報について正確に答えさせたい場合は、根拠を示せるRAGの併用が定番です。
「大規模」と呼ぶ基準はありますか?
明確な数値の基準はありません。学習データ量・パラメータ数・計算量を桁違いに大きくした言語モデルを慣例的に「大規模」と呼び、パラメータ数でいえば数十億以上のものを指すことが一般的です。
LLMとSLM(小規模言語モデル)はどう違いますか?
規模の違いです。SLMは数十億パラメータ以下の小さなモデルで、最高性能では劣るものの、1台のPCやスマートフォンで動き、費用と速度に優れます。用途を絞った業務ではSLM、幅広い作業ではLLM、と使い分けます。
日本語に強いLLMはありますか?
あります。GPT・Gemini・Claudeなどの主要モデルは日本語に対応しているほか、国立情報学研究所の「LLM-jp」のように、日本語の文章を中心に学習した国産のオープンモデルも公開されています。日本語の敬語や固有表現が重要な業務では、こうしたモデルを候補に入れて比べます。
目的別の案内:LLMの次に読む記事
このページは「LLMとは何か」の入口です。知りたいことが決まっている場合は、次の記事が深掘り担当です。
| 知りたいこと | 読む記事 | そこで分かること |
|---|---|---|
| どんなモデルがあるか | 大規模言語モデル一覧 | 主要モデルの一覧と特徴 |
| どれを選ぶか | LLM比較/国産LLM比較 | 評価軸と選び方 |
| 自社で作る・調整する | 大規模言語モデルの構築 | RAG・ファインチューニング・事前学習の進め方 |
| 業務でどう使うか | LLMの活用 | 業務別の使い方と導入の流れ |
| 手元のPCで動かす | ローカルLLM | 必要なPCと始め方 |
| 公開モデルを使う | オープンソースLLM | 定義とライセンスの考え方 |
| 背景の技術を知る | 自然言語処理(NLP) | LLMの土台になる分野 |
まとめ:この記事の要点と次の一歩
この記事の要点をまとめます。
- 大規模言語モデル(LLM)は、膨大な文章から「次に来る言葉」を予測する訓練を重ね、文章の理解・生成ができるようになったAIです。
- 生成AIの中の「文章を扱う」部分がLLMで、ChatGPT・Gemini・ClaudeはLLMを使ったサービスです。
- 仕組みはトークン化→ベクトル化→Transformerでの文脈処理→次の語の予測→生成の繰り返しで、学習データ量・パラメータ数・計算量を大きくするほど賢くなってきました。
- 要約・作文・翻訳・分類・対話・情報抽出・コード生成が得意で、ハルシネーション・プロンプトインジェクション・機密情報の扱いには運用上の対策が要ります。
- 自社の知識を持たせるには、知識を渡すRAGと、作法を身につけさせるファインチューニングを使い分けます。
理解した内容を土台に、次の記事へ進んでください。
- どのモデルを選ぶか知りたい:主要LLMの比較記事
- 手元のPCやサーバーで動かしたい:ローカルLLMの解説記事
- 社内データと組み合わせたい:RAG(検索拡張生成)の解説記事
- 生成AI全体の中での位置づけを知りたい:生成AIの全体像の解説記事
- 構築・実装の方法を知りたい:大規模言語モデルの構築記事
- マルチモーダルAIとの関係を知りたい:マルチモーダルAIの解説記事
- 強化学習とLLMの関係を知りたい:強化学習の解説記事
参考文献
- 内閣府消費者委員会AI技術専門調査会「大規模言語モデルの技術的特質と安全性対策」(2026年3月)
https://www.cao.go.jp/consumer/kabusoshiki/ai_technology/doc/002_260331_shiryou1-2.pdf - 文部科学省manaPASS「大規模言語モデルの基礎とDXのための適用技術 2026」
https://manapass.mext.go.jp/portal/course/detail/pro04adm13com02sch05/10318256/ - J-STAGE「大規模言語モデルと言語系生成AI」
https://www.jstage.jst.go.jp/article/bplus/18/3/18_241/_article/-char/ja/ - Kaplan et al.「Scaling Laws for Neural Language Models」(2020年)
https://arxiv.org/abs/2001.08361 - 国立情報学研究所 大規模言語モデル研究開発センター(LLM-jp)
https://llmc.nii.ac.jp/ - Hoffmann et al.「Training Compute-Optimal Large Language Models」(2022年)https://arxiv.org/abs/2203.15556
- Jiang et al.「Mixtral of Experts」(2024年)https://arxiv.org/abs/2401.04088
- Anthropic Docs「Context windows」(2026年10月27日確認)https://docs.anthropic.com/en/docs/build-with-claude/context-windows
- 各社公式のモデル情報(2026年10月13日確認):OpenAI/Google/Anthropic/Ollama
大規模言語モデルの関連記事
AIの業務活用をご検討の方へ
クリスタルメソッドは、バーチャルヒューマンをはじめAIの開発・業務導入を支援しています。生成AI・AIエージェントの活用や、自社業務へのAI導入をご検討の際は、お気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-

大規模言語モデル(LLM)一覧・リスト2026年版|主要モデル比較
大規模言語モデル(LLM)の選定は、2026年時点でさらに複雑な判断を要する局面に入っている。GPT・Claude・Geminiといったクローズドモデルが性能を...
-
大規模言語モデル(LLM)の活用とは?ビジネスと社会を変える技術の全体像
大規模言語モデル(LLM)の活用とは何か――ビジネスと社会を変える技術の全体像 大規模言語モデル(Large Language Model/LLM)の活用が、企...
-
大規模言語モデル(LLM)の構築とは?RAG・ファインチューニング・事前学習の進め方を基礎から解説
大規模言語モデルの構築とは、自社の目的に合わせてLLMを用意・調整する作業のことです。ほとんどの企業は、ゼロから事前学習するのではなく、既存の高性能モデルを土台...