
blog
AIブログ
RAG(検索拡張生成)とは?仕組み・メリット・活用例をわかりやすく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
RAG(検索拡張生成)とは、AIが答える前に関連する資料を検索し、その内容をもとに回答させる仕組みです。読み方は「ラグ」で、Retrieval-Augmented Generation の略です。AIを作り直さなくても、最新の情報や社内の資料を根拠つき(出典つき)で答えさせられます。一方で、検索が外れると答えも外れるため、品質は資料の整備と検索の作り込みで決まります。
この記事は、RAGの「定義と全体像」を扱う入口のページです。仕組み(5つのステップ)、ファインチューニングなど似た手法との違い、活用例、限界、費用の目安を順に説明します。無料で作る手順はRAGは無料で作れる?無料ツールの選び方と構築手順、コードを含む実装手順はRAGの実装手順で詳しく解説しています。
「RAGって言葉はよく聞くけど、結局なにをする技術?」「ChatGPTがあるのに、なぜわざわざ必要なの?」——この記事は、そんな方のための入口です。専門用語はできるだけかみくだいて、RAGとは何か・なぜ必要か・どう動くか・似た手法と何が違うか・どんな業務で効くか・限界と費用はどうか、を一通り分かる状態にします。
先に結論だけ:RAGは「AIにカンペ(資料)を渡してから答えさせる」仕組みで、モデルを作り直さずに、最新情報や社内情報に根拠つきで答えさせられます。ただし、検索が外れると答えも外れるため、品質は「資料の整備と検索の作り込み」で決まります。本文の途中で、同じ質問を資料なし・資料ありで実際に聞いた画面もお見せします(料金・ツール名は2026年10月13日に公式ページで確認)。
RAGとは?ひとことで言うと
RAG(Retrieval-Augmented Generation:検索拡張生成。読み方は「ラグ」)をひとことで言うと、「AIに”カンペ(資料)”を渡してから答えさせる仕組み」です。質問が来たら、まず関係する資料を検索して見つけ、それをAI(LLM)に渡して「この資料をもとに答えて」と頼む——それだけのシンプルな発想です。
これだけのことで、AIは「知らないことを聞かれると、もっともらしく間違える」存在から、「手元の資料を根拠に、出典つきで答える」存在に変わります。
RAGを無料で自分の環境に構築するときは、無料で使えるRAGツールと構築手順で説明しています。
関連記事RAGの実装は何工程で進める?
なぜRAGが必要か:LLMの4つの弱点と、RAGで変わること
LLM(ChatGPTなどの頭脳部分)は非常に優秀ですが、構造的な弱点が4つあります。①知識が学習時点で止まっている ②社内情報など「学習していないこと」は知らない ③知らなくても、もっともらしく答えてしまう ④答えの根拠を示せない——です。この4つを、モデルを作り直さずにまとめて補うのがRAGです。反対に言うと、この4つに困っていないなら、RAGは要りません。
RAGを導入する4つのメリット
- 最新情報・社内情報に答えられる:LLMの学習時点に関係なく、今日更新した資料をもとに回答できます。
- ハルシネーションを減らせる:根拠となる資料を渡したうえで答えさせるため、知らないことをもっともらしく作る余地が小さくなります。資料に無いことは「不明」と答えさせる設計も可能です。
- 再学習が不要で安い:ファインチューニングのようにモデルを作り直す必要がなく、資料の追加・差し替えだけで知識を更新できます。
- 根拠を示せる:回答がどの文書のどの部分に基づいたかを提示できるため、利用者が確認でき、業務での説明責任を果たしやすくなります。
RAGでこんなに変わる(導入前→導入後)
- 社内の問い合わせ対応:今まで=ChatGPTは自社の規定や製品仕様を知らないので答えられない → RAGなら=社内文書を根拠に「この製品の保証期間は◯◯です(出典:製品仕様書)」と答えられます。
- 最新情報への対応:今まで=AIの知識は学習した時点で止まっている → 資料を差し替えるだけで、今日の情報にもとづいて答えられます。再学習は不要です。
- 回答の信頼性:今まで=それらしい間違い(ハルシネーション)を見抜けない → どの資料を根拠にしたかが示されるので、人が検証できます。
- 新人教育・ナレッジ共有:今まで=「詳しい人に聞かないと分からない」が属人化 → 蓄積したマニュアル・議事録がそのまま「答えてくれる先輩」になります。
つまりRAGは、生成AIを「自社の事情を知っている即戦力」に変えるための技術です。生成AIの基礎から知りたい方は生成AIの解説、頭脳にあたるLLMは大規模言語モデルの解説をどうぞ。
次に読む:RAGはタイプ別にどう選ぶ?
RAGの仕組み:本棚づくりと司書の仕事(5つのステップと実際の画面)
RAGの動きは2つのフェーズに分かれます。図書館にたとえると分かりやすいです。
- フェーズ1:本棚づくり(インデックス構築)。社内文書を読みやすい単位に切り分け(チャンキング)、「意味で探せる索引」(ベクトルデータベース)に登録しておきます。
- フェーズ2:司書の仕事(検索して答える)。質問が来たら、意味の近い資料を本棚から取り出し、LLMに渡して回答を作らせます。多くのシステムでは、キーワード検索も併用して取りこぼしを防ぎます(ハイブリッド検索)。
意味で探す仕組み(埋め込み・ベクトル検索)を深掘りしたい方はベクトルデータベースの基礎へ。実際に手を動かしたい方はOllamaでのローカル構築ガイドが入口になります。
RAGの処理の流れ:5つのステップ
本棚と司書のたとえを、実際のシステムの手順に置き換えると次の5段階になります。
- 資料を分割する(チャンキング):社内マニュアルやFAQなどの文書を、数百字程度の「チャンク」に切り分けます。切り方が検索精度を大きく左右します。
- 数値化して保存する(埋め込み・ベクトルDB):各チャンクを埋め込みモデルで意味を表す数値(ベクトル)に変換し、ベクトルデータベースに登録します。これが「本棚づくり」に当たります。
- 質問を数値化して検索する:利用者の質問も同じ方法でベクトルにし、意味が近いチャンクを上位から取り出します。キーワードが一致しなくても言い換えを拾えるのが特徴です。
- プロンプトに差し込む:取り出したチャンクを「この資料に基づいて答えてください」という指示とともにLLMへ渡します。
- 根拠つきで生成する:LLMは渡された資料を参照して回答を作り、どの資料に基づいたかを出典として示せます。
ポイントは、LLM自体は何も学習し直していないことです。資料を更新すれば翌日から回答が変わり、再学習の費用も時間もかかりません。各ステップの作り込み(チャンクの切り方・検索精度・評価)は、後述の「RAGの作り方」の節で説明します。
RAGの「プロンプトの拡張」:LLMに渡す指示の書き方
5つのステップの4番目「プロンプトに差し込む」は、実際には指示文の書き方で品質が変わります。基本は、①役割、②検索で見つけた資料、③ユーザーの質問、④回答のルール、の4つを区切って渡す形です。
あなたは社内ヘルプデスクの担当者です。
以下の【資料】だけを根拠に、【質問】に答えてください。

【資料】
(検索で取り出したチャンクをここに入れる)

【質問】
(ユーザーの質問)

【回答のルール】
・資料に書かれていないことは「資料には記載がありません」と答える
・回答の最後に、根拠にした資料の名前を示す
・です・ます調で、3文以内で答える
ポイントは2つです。資料に無いことは答えさせない指示を入れること(ハルシネーションを減らす基本の対策)と、出典を示させることです。うまくいかないときは、資料の量を増やす前に、ルールの書き方と渡す資料の順番を見直します。
実際に動かしてみた:同じ質問を「資料なし」と「資料あり」で聞く
仕組みを言葉で追うより、動かした画面を見るほうが早いので、最小のRAGをこの記事のために実際に動かしました(2026年10月13日)。資料は、公開されている会社概要ページの文6件(会社名・住所・設立・資本金など)をそのまま使い、「設立年と資本金は?」と質問しています。使ったのは、埋め込みモデル(Voyage voyage-3)・ベクトル検索(sqlite-vec)・回答を作るLLM(Claude Sonnet 4.6)の3つだけです。
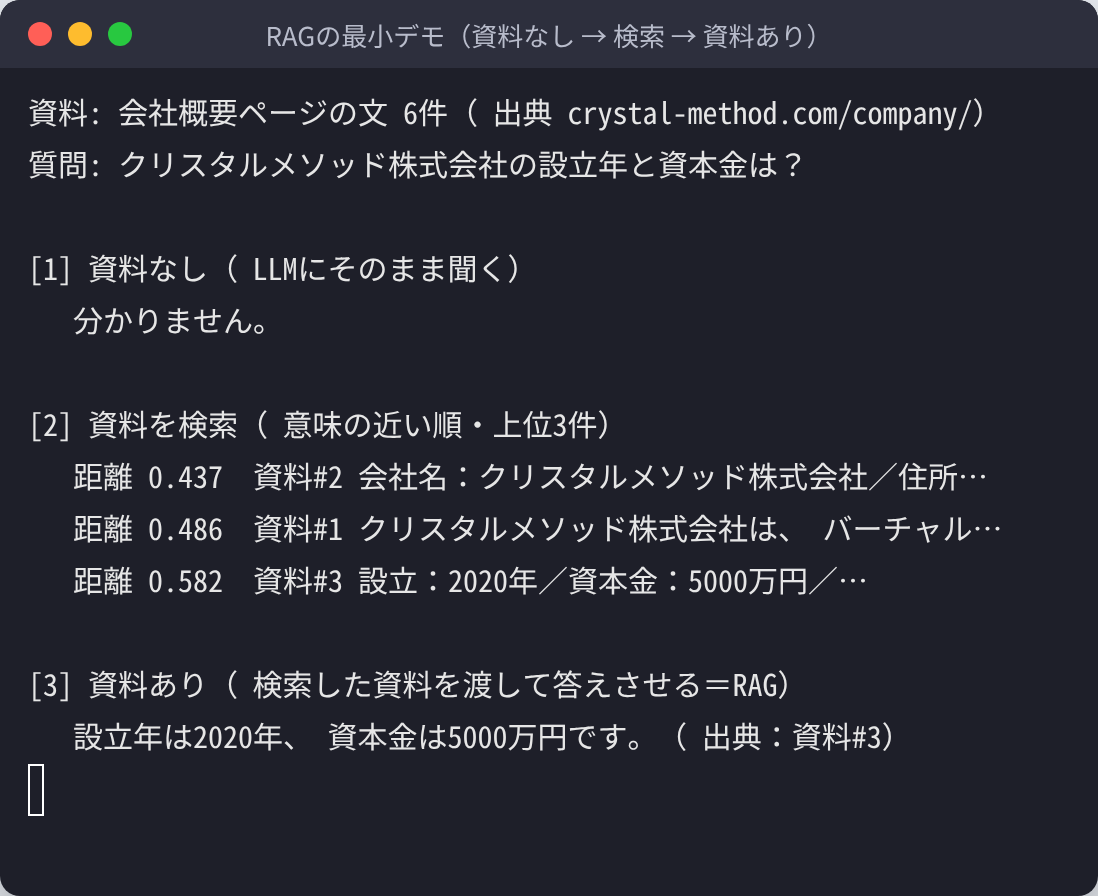
- [1] 資料なし:LLMにそのまま聞くと「分かりません」と答えました。小さな会社の設立年は学習データにほとんど無いためで、知らないことを知らないと言えた例です(知ったかぶりをする場合もあります)。
- [2] 資料を検索:質問と意味の近い資料が、距離の小さい順に3件取り出されました(0.437・0.486・0.582)。3件目に「設立:2020年/資本金:5000万円」の行が入っています。
- [3] 資料あり(RAG):取り出した3件を渡して答えさせると「設立年は2020年、資本金は5000万円です(出典:資料#3)」と、根拠つきで正しく答えました。
やっていることは、この3段だけです。モデルは何も学習し直しておらず、渡す資料を差し替えれば答えも変わります。なお、この例で検索を上位2件に絞ると答えが出なくなります。その画面は後述の「RAGの作り方」の節に載せています。
RAGと似た手法の違い・使い分け(ファインチューニング・ロングコンテキスト・セマンティック検索)
RAGは万能ではありません。「AIに自社の知識を持たせたい」と思ったときの選択肢には、RAGのほかにプロンプト設計・ロングコンテキスト(資料を全文そのまま渡す)・ファインチューニングがあります。先に、自分の課題がRAGに向くのか・向かないのかを切り分けると、遠回りを避けられます。
RAGが向く3つの場面
- 知識が頻繁に更新される——社内マニュアル・規程・商品情報など、内容が変わり続ける知識にもとづいて答えさせたいとき。元データを差し替えるだけで回答も追随します。
- 出典の明示・検証可能性が要る——「どの文書を根拠にしたか」を示す必要があるとき。監査やコンプライアンスが絡む用途で効きます。
- 汎用LLMが知らない自社固有の事実に答えさせたい——非公開データや最新情報など、モデルが学習していない事柄を根拠にしたいとき。
RAGが向かない(別の手法が向く)3つの場面
- 欲しいのが「知識」でなく「振る舞い」のとき——口調・書式・出力の形式を固定したいだけなら、プロンプト設計やファインチューニングのほうが素直です。
- 参照する情報が少量で毎回同じとき——プロンプトに全文を貼れる規模なら、検索を挟まずロングコンテキストで足りることが多く、構成もシンプルになります。
- 本質が推論・計算・多段の操作のとき——正しい文書を引けても解けない課題は、検索ではなくエージェント(ツール実行)や推論強化の領域です。
迷ったら、この4つの軸で決める
- 知識の更新頻度は高いか——高いほどRAG向きです(再学習なしで差し替えられます)。
- 出典の明示は必要か——必要ならRAGです(根拠の文書を提示できます)。
- 対象データ量はどれくらいか——小さく固定的なら、ロングコンテキストで十分なことが多くなります。
- 求めるのは「知識」か「振る舞い」か——振る舞い(文体・形式)の固定は、ファインチューニングやプロンプト設計の担当です。
これらは排他ではなく組み合わせられます。実際には「RAGで根拠を引きつつ、プロンプトで出力の形式を整え、必要な操作はツール実行に回す」といった併用が現実的な着地点になります。次の2つの比較表で、ファインチューニングとセマンティック検索との違いを確認してください。
ファインチューニングとの違いを表で比較
「AIに自社の知識を持たせる」もう一つの方法が、モデル自体を追加学習させるファインチューニングです。ざっくり言うと、「知識を渡したい」ならRAG、「話し方や作法を身につけさせたい」ならファインチューニングが向いています。
| 比較項目 | RAG | ファインチューニング | ロングコンテキスト(全文入力) |
|---|---|---|---|
| 知識の更新性 | ◎ 文書差し替えで即時反映 | △ 再学習が必要 | ○ ファイル差し替えで対応 |
| 初期コスト | ○ 比較的低い | △ GPU・時間コスト大 | △ トークン課金が高額になりやすい |
| 根拠・出典の提示 | ◎ 取得元文書を明示可 | ✗ 根拠が不透明 | ○ 原文を含む |
| 大量文書への対応 | ◎ 数百万文書規模でも可 | ○ 学習データに取り込める | ✗ コンテキスト長に制限 |
| ハルシネーション抑制 | ◎ 根拠文書が制約として機能 | △ 効果は限定的 | ○ 原文参照で抑制しやすい |
| 文体・挙動のカスタマイズ | △ システムプロンプトで対応 | ◎ 深くカスタマイズ可能 | △ 限定的 |
まず低コストで始められて、資料の差し替えだけで最新化でき、根拠も示せる——という理由で、企業の知識活用はRAGから始めるのが定石です。ファインチューニングの詳細はファインチューニングの解説へ。
セマンティック検索・キーワード検索との違い
RAGと混同されやすいのが「セマンティック検索」です。両者の関係は部品と仕組みにあたります。
| 方式 | やること | 出力 | 向く場面 |
|---|---|---|---|
| キーワード検索 | 単語の一致で文書を探す | 文書の一覧 | 固有名詞や型番など、言葉が決まっている検索 |
| セマンティック検索 | 意味の近さ(ベクトルの類似度)で文書を探す | 文書の一覧 | 言い回しが違う質問、曖昧な問い合わせ |
| RAG | セマンティック検索(やキーワード検索)で取り出した文書をLLMに渡し、回答文を生成する | 根拠つきの回答文 | 「探す」だけでなく「答えてほしい」場面 |
つまりセマンティック検索は「該当しそうな資料を見つける」までで、RAGはその先の「資料を読んで答える」までを自動化します。RAGの回答品質は検索の質で頭打ちになるため、実務では意味の検索とキーワード検索を組み合わせることが多くなります。
RAGの活用例:どんな業務で効くか
- 社内ヘルプデスク:規定・手順書・FAQを根拠にした自動回答。もっとも定番の適用先です。
- カスタマーサポート:製品マニュアル・過去の対応履歴にもとづく回答案の作成。
- 専門文書の調査:契約書・技術文書・論文などの「探して読む」時間の短縮。
- 対話型サービスの知識源:クリスタルメソッドの模擬面接のように、対話AIに「その企業・その場面の知識」を持たせる用途。
具体的な事例をもっと見たい方はRAG活用事例の記事へどうぞ。
業務別のユースケース
| 業務 | RAGに渡す資料 | できること |
|---|---|---|
| カスタマーサポート | 製品マニュアル、FAQ、過去の問い合わせ履歴 | 一次回答の自動生成、オペレーター向けの回答候補提示 |
| 社内ヘルプデスク | 就業規則、経費規程、IT手順書 | 「出張の精算はどうする?」など社内ルールへの即答 |
| 営業 | 提案書、事例集、価格表 | 顧客の業種に合わせた提案の下書き、過去事例の検索 |
| 法務・契約 | 契約書ひな形、審査基準、過去の修正履歴 | 条項の確認、リスク箇所の指摘の補助 |
| 開発 | 設計書、API仕様、障害対応記録 | 仕様の問い合わせ対応、過去の障害との照合 |
| 人事・採用 | 企業情報、職種要件、面接評価基準 | 企業ごとに特化した模擬面接の生成(次の節の実例) |
分野別に渡す資料と質問の例
RAGで何ができるかは、「どんな資料を渡すか」で決まります。分野ごとの資料と質問の組み合わせのイメージです(想定例であり、導入実績や効果の数値ではありません)。
| 分野 | 渡す資料の例 | 質問の例 |
|---|---|---|
| 金融・保険 | 商品約款、社内規程、手続きの手順書 | 「この保険の解約手続きはどう進める?」 |
| 製造 | 作業標準書、設備マニュアル、不具合の対応記録 | 「この装置のエラー表示の対処は?」 |
| 医療・介護 | 院内の手順書、公的なガイドライン(出典を明示) | 「感染対策の院内ルールの該当箇所は?」 |
| 法務・士業 | 契約書のひな形、社内の審査基準、法令の条文 | 「この契約書に入れる条項の社内基準は?」 |
| 小売・EC | 商品情報、返品・配送のルール、問い合わせ履歴 | 「この商品の返品条件は?」 |
| 教育 | 授業資料、学内規定、よくある質問 | 「履修登録の締め切りはいつ?」 |
医療・法務のように判断を誤ると影響が大きい分野では、RAGの回答は「根拠の資料を素早く探す補助」と位置づけ、最終判断は専門家が行います。回答に出典を付け、人が原文を確認できる形にしておくことが前提です。
実際にRAGを構築・運用して分かった3つのポイント(企業情報データベースの例)
RAGの価値は「実データにもとづいて、汎用でなく特化した回答を返す」ことに尽きます。ここでは、クリスタルメソッドが実際に構築・運用しているRAGを例に、机上の解説では分からなかった点を紹介します。
構築したのは、上場企業 約4,400社の基本情報(業種・市場・規模など)と約3.8万件の財務データ、各社の公式ドメイン情報を集めた企業情報データベースです。そのうえで、対象企業を選ぶとその企業の実データを取得してRAGの参照資料を組み立て、「その企業に特化した模擬面接の質問」を生成する仕組みを動かしています。「志望動機を教えてください」のような汎用の質問ではなく、対象企業の業種や事業の文脈をふまえた質問になる点が、実データを根拠にする効果です。同じ仕組みは、自社サービスのヘルプ機能(ヘルプ記事をベクトル化して回答の根拠にする)にも使っています。
この構築・運用を通じて分かった、RAGの導入で本当に効くポイントは次の3つです。
- ① 回答の品質は、結局「投入データの質・網羅性」でほぼ決まります。 モデルを高性能なものに変えるより、参照させるデータを正確で網羅的に整えるほうが、回答の的確さに直結します。企業の公式ドメインを正しく特定する作業には相当の手間がかかりました(自動取得には誤りも多く、品質チェックと手直しが不可欠でした)。「ゴミを入れればゴミが出る」はRAGでこそ顕著です。
- ② データの「鮮度」を保つ仕組みが要ります。 財務情報のように更新されるデータは、取り込んだまま放置すると古い回答の原因になります。いつのデータを参照しているかを管理し、更新する設計が前提になります。
- ③ 何を、どう切り分けて渡すかで検索精度が変わります。 大量の資料をそのまま入れても、関連する箇所がうまく検索されなければ意味がありません。情報を適切な単位に分け、質問に対して的確な部分が引ける状態にしておくことが、体感の品質を大きく左右します。企業名・製品名のような固有名詞の取りこぼしを防ぐには、意味の検索に加えてキーワード検索を併用する必要がありました。
逆に言えば、RAGは「高性能なAIを用意すれば終わり」ではなく、参照させるデータの整備と運用が成否を分ける取り組みです。導入を検討する際は、まず「自社に、AIに参照させるだけの整ったデータがあるか」から考えることをおすすめします。
RAGの限界とデメリット:検索が外れると答えも外れる
万能ではありません。導入前に知っておくべき弱点を整理します。
- 検索に失敗すると答えも失敗する:必要な資料を取り出せなければ、LLMは資料無しで答えるか「不明」と返すしかありません。チャンクの切り方や検索方式の設計が品質を決めます。
- 資料の質に依存する:古い版や矛盾する文書が混在していると、誤った根拠で正しそうな回答を作ります。資料の棚卸しと版管理が前提になります。
- 推論に時間とコストがかかる:検索と長いプロンプトが毎回発生するため、応答時間とトークン費用は通常の対話より増えます。
- 権限管理が難しい:誰に見せてよい資料かを検索段階で制御しないと、本来見られない情報が回答に混ざります。
- 評価が難しい:「検索は正しかったか」「回答は資料に忠実か」を分けて測る仕組みが要ります。
- 文体や振る舞いは変えられない:口調や出力形式を根本から変えたい場合は、ファインチューニングの領域です。
うまくいかないときは、どこを見るか
RAGの答えがいまいちなとき、原因は大きく「探す側(検索)の失敗」か「答える側(生成)の失敗」に分かれます。切り分けて見るのが改善の近道です。
| 評価指標 | 評価対象 | 意味 |
|---|---|---|
| Context Precision | 検索層 | 取得チャンクのうち質問と関連するものの割合 |
| Context Recall | 検索層 | 正解に必要な情報がどれだけ取得されているか |
| Faithfulness(忠実性) | 生成層 | 生成された回答が取得文書の内容から逸脱していないか |
| Answer Relevancy | 生成層 | 生成された回答がユーザーの質問に対してどれだけ的確か |
実務では、①資料の切り方(チャンキング)が悪くて文脈が途切れる ②似た用語が多くて違う資料を取ってくる ③資料は正しいのに要約で歪む——あたりが定番のつまずきポイントです。まず「検索で正しい資料が取れているか」から確認してください。この記事のデモでも、検索を上位2件に絞っただけで答えが出なくなりました(「RAGの作り方」の節の画面)。表の指標名は評価の枠組み Ragas のもので、Answer Relevancy は現在の公式ドキュメントでは Response Relevancy と呼ばれています。
RAGの作り方:精度を決める3つの作り込みと、小さく始める順番
RAGを「動くだけ」から「業務で使える精度」に引き上げるのは、派手なモデル選びではなく、資料の切り方・検索の精度・評価の3つの作り込みです。ここでは要点だけを説明し、コードを含む手順はRAGの実装手順(7工程)に分けています。
作り込み①:資料の切り方(チャンキング)
文書をどの単位で切ってベクトル化するかで、検索のヒット率は大きく変わります。代表的な切り方は3つです。
- 固定長:一定の長さ(例:300〜800トークン)で機械的に切ります。実装は簡単ですが文の途中で切れるため、前後を少し重ねる(オーバーラップ)のが一般的です。
- 意味のまとまり:見出し・段落・文の単位で切ります。文脈が保たれますが、前処理の手間が増えます。
- 親子チャンク:検索は小さい単位で行い、LLMに渡すときは前後を含む大きい単位を渡します。ヒット精度と文脈量を両立できる定番の形です。
切り方の影響は、仕組みの節のデモでも出ています。「設立:2020年/資本金:5000万円」の行には会社名が入っていないため、質問との意味の距離が開いて3番目にしか出ませんでした。検索を上位2件に絞ると、この行が渡されず、LLMは「資料にありません」と答えます。
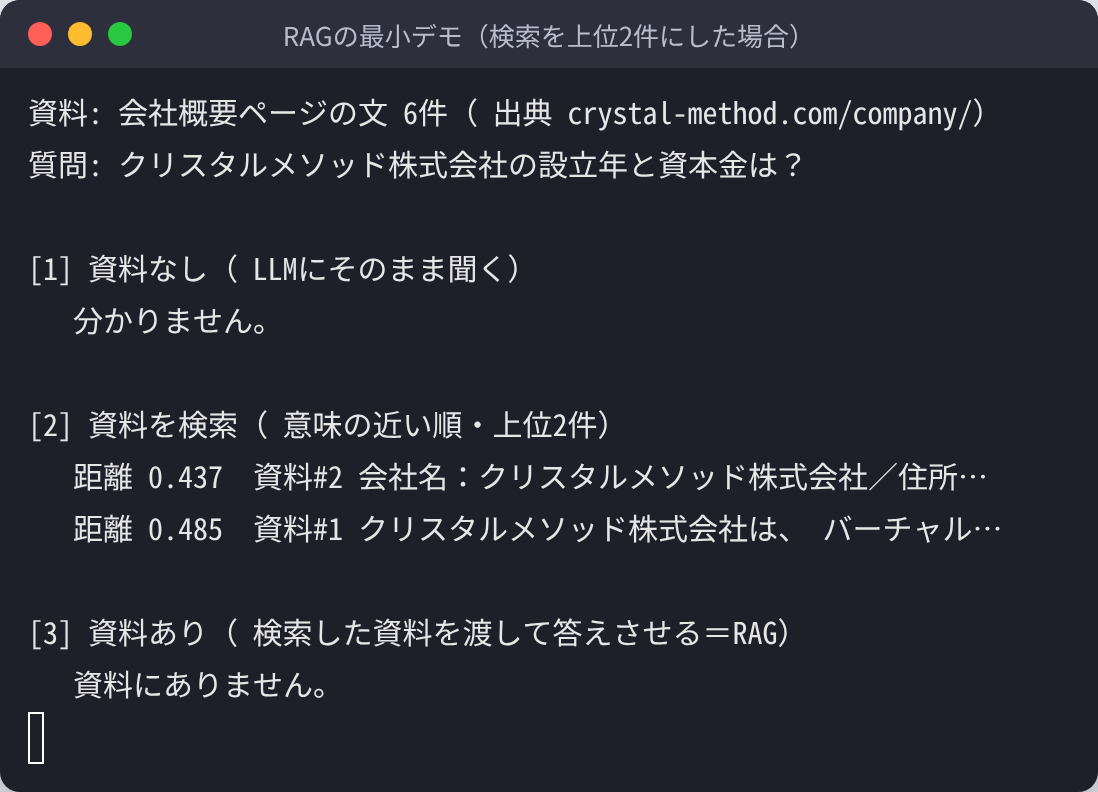
資料の行に「クリスタルメソッド株式会社の設立:2020年」のように主語を含めて切り直す、取り出す件数を増やす、キーワード検索を併用する、のどれでも直せます。この「検索が外れると答えも外れる」が、RAGの品質を考えるときの出発点です。
作り込み②:検索の精度(ハイブリッド検索とリランキング)
意味の近さで探すベクトル検索は、固有名詞・型番・略語のような言葉の完全一致に弱いという弱点があります。実務では、キーワード検索(BM25など)を組み合わせるハイブリッド検索で取りこぼしを減らし、一次検索で多めに取った候補をリランキング(関連の高い順に並べ直す処理)で絞ってからLLMに渡す2段構えが定番です。
作り込み③:評価(何を測れば「効いている」と言えるか)
「なんとなく良くなった」で運用すると劣化に気づけません。最低限、検索が正解の資料を拾えているか(Context Recall)と、回答が資料の内容に忠実か(Faithfulness)を分けて測ります。評価の枠組みにはRagasなどがあり、指標の定義は後述の「うまくいかないときは、どこを見るか」の表にまとめています。検索が外れていれば生成側をいくら調整しても効かないため、先に検索の評価を固めます。
資料の整備と更新のルール:RAGは入れたあとの運用で差がつく
RAGの回答は資料の質で決まるため、最初に入れるだけでなく、整備と更新のルールを決めておきます。
- 表記をそろえる:同じ意味の語(例:「休暇」と「休み」、製品の旧名と新名)が混在すると、検索で取りこぼしが出ます。用語集を作り、資料側の表記をそろえます。
- 古い版を残さない:改定前の規程と改定後の規程が両方入っていると、古い方を根拠に答えることがあります。版と日付を管理し、古い資料は検索対象から外します。
- 更新のたびに索引も作り直す:AWS公式の解説(2026年10月19日確認)でも、最新の情報を取得できるように、ドキュメントとその埋め込み表現を更新し続ける必要があり、自動のリアルタイム処理か定期的なバッチ処理で行うと説明されています。更新頻度の高い資料はリアルタイム、変わりにくい資料は夜間のバッチ、のように分けます。
- 閲覧権限を資料に付ける:誰がどの資料を見てよいかを資料側に持たせ、検索の段階で絞り込みます。
小さく始める順番
- pgvectorなど導入しやすい構成で最小のRAGを動かす(この記事のデモのように、数件の資料と1つの質問で十分です)
- 検索の再現率を測り、資料の切り方・オーバーラップ・埋め込みモデルを調整する
- 固有名詞の取りこぼしがあればハイブリッド検索を足す
- 上位の並びが甘ければリランキングを足す
- 生成側の忠実性を評価し、プロンプトと渡す資料の量を調整する
自分のパソコンで試したい方はOllamaでのローカル構築、費用をかけずに試したい方は無料で使えるRAGツール、フレームワークを使う場合はLlamaIndexでのRAG構築が入口になります。
導入の進め方:小さな検証(PoC)から本番まで
社内で進めるときは、技術よりも「何を良しとするか」を先に決めると迷いません。
- 対象を絞る:問い合わせの多い業務を1つ選び、使う資料と想定質問(20〜30問程度)を決めます。
- 合格ラインを決める:「想定質問のうち、正しい資料を取り出せた割合」「回答が資料に沿っている割合」「担当者が回答を探す時間」など、測れる指標を先に決めます。
- 現場の担当者と検証する:実際にその業務を担当している人に使ってもらい、外れた質問を集めて資料の切り方や検索を直します。
- 限定公開して運用を整える:一部の部署で公開し、利用ログと利用者の声をもとに、資料の更新担当と更新頻度を決めます。
- 対象を広げる:指標が合格ラインを超えたら、資料と部署を増やします。
注意したいのは費用と人手です。LLMの利用料に加え、資料の整備と更新を続ける担当者が必要になります(費用の考え方は後述の「RAGの費用は何で決まるか」を参照)。
部品の選び方:埋め込みモデルとベクトルデータベース
RAGを実際に組むときの中核部品は、「埋め込みモデル」と「ベクトルデータベース」の2つです。
- 埋め込みモデル(Embedding):文章を「意味のベクトル(数値の並び)」に変換する部品です。日本語主体のデータでは、日本語に強いモデルを選べるかどうかが検索精度を大きく左右します。機密データを外部のAPIに出せない場合は、オープンソースのモデルを自社で動かす構成になります。
- ベクトルデータベース:変換したベクトルを保存し、意味の近い順に高速に探す部品です。小〜中規模ならPostgreSQLの拡張であるpgvectorのように既存のデータベースに足す形が導入しやすく、大規模・高速性を重視するなら専用製品が候補になります。製品の比較と選び方はベクトルデータベースの解説にまとめています。
最初から大規模向けの構成を組むより、小さく始めて「狙った文書がちゃんとヒットするか」を測りながら調整していくほうが失敗が少なくなります。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
クラウドのマネージドサービスで作る場合
自分で部品を組まずに、クラウドの用意したサービスを使う方法もあります。AWS公式の解説(2026年10月19日確認)では、次の2つが挙げられています。
- Amazon Bedrock のナレッジベース:基盤モデルをRAGのデータソースにつなぐ機能で、ベクトル変換・検索・回答の生成が自動で処理されると説明されています。
- Amazon Kendra:機械学習を使った企業向け検索サービス。独自にRAGを管理している組織向けに、Retrieve API を提供し、SharePoint や Confluence などへのコネクタや、利用者の権限に応じた回答の絞り込みに対応すると説明されています。
ほかのクラウドにも同様のサービスがあります。料金や対応範囲は変わるため、導入時は各社の公式ページで確認してください。
RAGの発展形:Advanced・Graph・Agentic RAG
基本形(質問→検索→回答)だけでも動きますが、精度を上げるための発展形がいくつもあります。名前だけでも知っておくと、製品資料が読みやすくなります。
- Naive RAG:質問→ベクトル検索→プロンプトに差し込み→生成、という基本の流れです。シンプルなFAQや社内Q&Aに向きますが、検索漏れが起きやすい形です。
- Advanced RAG:質問の言い換え・ハイブリッド検索・リランキングを足した形です。曖昧な質問や大きな資料群に強くなりますが、処理は増えます。
- Modular RAG:検索・生成・評価の部品を組み替えられる形です。要件が多様なときに向きますが、設計と運用の手間が増えます。
- Graph RAG:人・組織・製品などの関係をグラフにして検索する形です。複数の文書にまたがる関係の分析に向きますが、グラフを作る手間がかかります。
- Agentic RAG:検索するかどうか・何回検索するかの判断をLLM自身に任せる形です。多段の推論に向きますが、制御が難しくなります。
それぞれの選び方と、フレームワーク・ベクトルデータベース・クラウドサービスの比較はRAG比較(アーキテクチャ・ツール選定)にまとめています。
RAGの費用は何で決まるか:公式の単価を使った試算例
RAGの費用は、大きく4つの要素で決まります。
| 費用の要素 | 何にかかるか | 増える要因 |
|---|---|---|
| 文書のベクトル化(埋め込み) | 資料を検索できる形に変換する処理。最初にまとめて行い、資料を更新したときに追加で行う | 資料の量、更新の頻度 |
| ベクトルデータベース | 変換したデータの保存と検索 | 保存する件数、検索の回数。既存のデータベースに拡張機能を足す構成なら、追加費用を抑えられる |
| 回答の生成(LLMの利用料) | 質問と、検索で見つけた資料をLLMに渡して回答を作る処理 | 質問の回数、1回に渡す資料の量、選ぶモデル |
| 構築・運用 | 資料の整備、精度の確認、改善の作業 | 対象業務の広さ、求める精度 |
このうち、使い方で大きく変わるのが「回答の生成」です。RAGでは検索で見つけた資料をプロンプトに入れるため、ふつうのチャットより入力が長くなります。
試算例:月1万回の質問に答える場合
次の仮定で、LLMの利用料だけを計算してみます(仮定を置いた計算例であり、実測値ではありません)。
- 質問は月10,000回
- 1回あたりの入力は4,000トークン(質問+検索で見つけた資料の抜粋)、出力は500トークン
- 単価はAnthropic公式の料金(2026年10月13日確認・100万トークンあたり。Haiku 5.5 は入力10万トークンまでの単価)
| モデル | 入力(月4,000万トークン) | 出力(月500万トークン) | 合計(月額) |
|---|---|---|---|
| Claude Sonnet 5.5(入力$2/出力$10) | $80 | $50 | $130 |
| Claude Haiku 5.5(入力$0.10/出力$0.50) | $4 | $2.5 | $6.5 |
同じ使い方でも、モデルの選び方で月額は20倍ほど変わります。また、1回に渡す資料を半分にすれば、入力の費用も半分になります。費用を抑える基本は、①検索の精度を上げて渡す資料を絞る、②簡単な質問は軽いモデルに回す、③同じ前置き(指示文)はプロンプトキャッシュを使う、の3つです。埋め込みとベクトルデータベースの費用は、使うサービスの料金ページで別途確認してください(出典:Anthropic公式 Pricing)。
RAGに関するよくある質問
RAGは何の略ですか?
Retrieval-Augmented Generation(検索拡張生成)の略です。「検索(Retrieval)で見つけた資料で、生成(Generation)を強化(Augmented)する」という名前のとおりの仕組みです。
ChatGPTをそのまま使うのと何が違うのですか?
ChatGPT単体は、あなたの会社の文書を知りません。RAGは回答の前に自社の資料を検索して渡すので、「社内のことに、根拠つきで答えられる」ようになります。汎用知識で足りる用途なら、RAGなしでも十分です。
導入は何から始めればよいですか?
「対象の文書」と「想定する質問」を絞ることからです。よくある質問トップ20と、その根拠になる文書を揃えて小さく検証するのが定石です。検証だけなら、ローカル環境での構築や無料で試す方法から始められます。
RAGを使えば、ハルシネーション(もっともらしい誤り)はなくなりますか?
なくなりはしませんが、減らせます。RAGは回答の根拠になる資料をAIに渡す仕組みなので、資料に書かれている内容については誤りが出にくくなります。一方、検索で的外れな資料を拾った場合や、資料に答えが無い場合は誤ることがあります。「資料に無ければ『わからない』と答える」と指示し、回答に出典を付けさせるのが基本の対策です。
RAGとファインチューニングは、どちらを選べばよいですか?
社内の資料や最新の情報にもとづいて答えさせたいならRAG、文体や出力の形式など「答え方」を変えたいならファインチューニングが向いています。資料が頻繁に変わる場合は、資料を差し替えるだけで済むRAGのほうが運用しやすくなります。
RAGの費用は何で決まりますか?
文書のベクトル化、ベクトルデータベース、回答を作るLLMの利用料、構築・運用の4つです。使い方で大きく変わるのはLLMの利用料で、質問の回数、1回に渡す資料の量、選ぶモデルで決まります。
社内の資料をRAGで使うと、情報が外に漏れませんか?
資料の内容は、回答を作るときにLLMへ送られます。クラウドのLLMを使う場合は、送ったデータが学習に使われるか、どこに保存されるかを契約と設定で確認します。外に出せない資料は、自社で動かすLLM(ローカルLLM)と組み合わせる方法があります。あわせて、閲覧権限のない人に資料の内容が答えとして出ないよう、検索の段階で権限による絞り込みを入れます。
まとめ:資料を持たせれば、AIは自社の即戦力になる
RAGは、「AIにカンペを渡してから答えさせる」というシンプルな発想で、生成AIの弱点(古い・知らない・間違える・根拠がない)をまとめて補う技術です。難しい理論より先に、「この文書群に、この質問」という小さな組み合わせで一度動かしてみるのがおすすめです。関連記事に、構築手順・事例・無料での試し方をまとめています。
参考文献
- Lewis, P. ほか「Retrieval-Augmented Generation for Knowledge-Intensive NLP Tasks」(RAGの原論文・2020年)arXiv:2005.11401 https://arxiv.org/abs/2005.11401
- J-STAGE「Comparison of dictionary-type RAG and RAG using Japanese and English knowledge graphs in article translation」人工知能学会 SWO 研究会 2023 https://www.jstage.jst.go.jp/article/jsaisigtwo/2023/SWO-062/2023_01/_article/-char/en
- Anthropic 公式「Pricing」(試算の単価・2026年10月13日確認)https://platform.claude.com/docs/en/about-claude/pricing
- Ragas 公式ドキュメント「Available metrics」(評価指標の定義)https://docs.ragas.io/en/stable/concepts/metrics/available_metrics/
関連記事(rag 詳細ガイド)
- OllamaでRAGをローカル構築
- マルチモーダルRAGの仕組みと構築
- RAGの導入事例・活用事例
- RAGでハルシネーション対策
- 無料で使えるRAGツール
- LlamaIndexでRAG構築
- RAGの土台=ベクトルDBの基礎
- RAGの実装手順(7工程パイプライン)
- RAG比較2026年版(アーキテクチャ・ツール選定)
LLM・ローカルLLMの業務導入をご検討の方へ
クリスタルメソッドは、オープンモデル・ローカルLLMの選定からRAG構築・PoC・本番導入までのAI開発を支援しています。「機密データを外部に出さずにLLMを使いたい」「自社の業務に合うモデルを選びたい」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
RAG(検索拡張生成)は無料で作れる?無料ツールの選び方と構築手順【2026年版】
RAG(検索拡張生成)は、無料で作れます。コードを書かずに試すなら Google NotebookLM、アプリとして形にするなら Dify、機密資料を外に出さず...
-
RAG比較2026年版——タイプ別の選び方とサービス比較・技術アーキテクチャ完全ガイド
「RAGを導入したいが、どのサービスを選べばよいか分からない」——多くの企業担当者が最初にぶつかるのはこの疑問だ。RAG(Retrieval-Augmented...
-
RAGとは?仕組みと実装方法を7工程で解説
RAG(Retrieval-Augmented Generation)の基本概念や定義については RAGとは何か――基本概念と全体像 を先に参照されたい。本記事...