
blog
AIブログ
RAG(検索拡張生成)は無料で作れる?無料ツールの選び方と構築手順【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
RAG(検索拡張生成)は、無料で作れます。コードを書かずに試すなら Google NotebookLM、アプリとして形にするなら Dify、機密資料を外に出さずに作るなら Ollama と Chroma を使った完全ローカル構成が、費用をかけずに始める代表的な方法です。無料枠の条件は変わることがあるため、この記事では公式ページで確認した内容を日付つきで示します。
RAG(検索拡張生成)は無料で作れる?先に結論
RAG(ラグ/Retrieval-Augmented Generation=検索拡張生成)は、質問に関係する資料を先に検索し、その内容をAIに渡してから答えさせる仕組みです。無料で作れます。コードを書かずに試すなら Google NotebookLM、アプリとして形にするなら Dify、機密資料を外に出さずに作るなら Ollama と Chroma を使った完全ローカル構成が、費用をかけずに始める代表的な方法です。
この記事は「無料で作る」ことに絞ったページです。RAGそのものの定義・仕組み・似た手法との違い・限界はRAG(検索拡張生成)とは?で説明しているので、ここでは無料ツールの選び方と構築手順に集中します。
無料枠は変更されることがあるため、この記事の条件はすべて2026年10月20日に各社の公式ページで確認した内容です。目的別の選び方は次の表のとおりです。
| やりたいこと | 無料の選択肢 | 無料の範囲(公式) | 注意点 |
|---|---|---|---|
| まず試したい(コード不要) | Google NotebookLM | 無料の標準プランで、1ユーザー100ノートブック・1ノートブックあたり50ソース(Googleヘルプ) | API連携やチャンク設定のカスタマイズはできません |
| ノーコードでアプリにしたい | Dify(Cloud の Sandbox、またはセルフホスト) | Cloud の Sandbox は、メッセージクレジット200・アプリ5・ナレッジ文書50・ナレッジ容量50MB(Dify公式料金ページ) | 小規模な検証向け。それ以上は有料プランかセルフホスト |
| 機密資料を外に出したくない | Ollama+Chroma(完全ローカル) | ソフトウェアは無料。費用はPCの電気代や性能の範囲 | PCの性能が回答速度を決めます。この記事の構築手順で作れます |
| 無料APIで日本語の回答を試したい | Gemini API の無料枠 | 公式料金ページで、Gemini 3.5 Flash-Lite や 2.5 Flash など複数のモデルが無料枠(入力・出力とも無料)として案内されています | 無料枠では入力が製品改善に使われる場合があると公式に記載されています。機密資料は送らないでください |
RAGの仕組みそのもの(なぜ必要か・どう動くか)はRAGとは?仕組み・メリットをわかりやすく解説で説明しています。この記事は「無料でどこまでできるか」と「実際の構築手順」に絞っています。
無料ツールの中からどのタイプを選べばよいかは、RAG比較2026年版で解説しています。
関連記事RAG導入の設計判断の核心は?
RAGのメリットと活用例:無料で作ると何に使えるか
RAGのメリット(4つ)
- 最新の情報や社内の資料を答えに使える:AIモデル自体を再学習しなくても、資料を差し替えるだけで答えの内容を更新できます。
- 根拠を示せる:検索で取り出した資料を出典として一緒に表示すれば、答えが正しいかを人が確かめやすくなります。
- もっともらしい誤り(ハルシネーション)を減らす助けになる:「資料にあることだけで答える」よう指示すれば、資料にない内容を作り話で埋めにくくなります。ただし、誤りが完全になくなるわけではありません。
- 費用と手間が軽い:ファインチューニングのような学習用のGPUやデータ整備が要らず、無料の道具の組み合わせでも始められます。
無料のRAGで試しやすい活用例
- 社内ヘルプデスク:就業規則・業務手順書・よくある質問の資料を入れて、社員の質問に資料の該当部分つきで答えさせます。
- カスタマーサポートのFAQ検索:製品マニュアルや過去の回答集を入れて、問い合わせへの回答案を作ります。
- 製品マニュアル・技術文書の検索:PDFが多く、目次をたどるのが大変な資料の中から、必要な箇所を見つけます。
- 個人の調べ物:読みたい論文やメモを入れて、質問しながら内容を整理する(NotebookLMのように、コード不要で試せます)。
社内の資料に使うときの注意
- 資料の送信先を確認する:Gemini APIの無料枠は、公式の料金ページに「入力が製品改善に使われる」と書かれたモデルがあります。機密資料はローカル構成(Ollama+Chroma)で扱い、外部のAPIには送らないでください。
- 見せてよい人にだけ見せる:チャンクごとに公開範囲を記録しておき、質問した人が読める資料だけを検索対象にします。無料の構成の多くは、この権限管理を自分で作る必要があります。
- 古い資料を残さない:資料を更新したら、保存したベクトルも作り直してください。古い版が検索に残ると、古い内容を根拠に答えてしまいます。
小さく始める順番
まずNotebookLMで、少数の資料に対して質問が当たるかを確かめます。次に、自分の資料をDifyまたはこの記事の構築手順で取り込み、チャンクの切り方や検索の件数を調整します。利用者や資料の数が増えて無料枠やPCの性能が足りなくなったら、後の「ドキュメント規模が増えたときの移行判断」のとおり有料プランや専用のベクトルデータベースへ移ります。クラウドのRAG向けサービス(Amazon Bedrock Knowledge Bases・Azure AI Search・Google Cloud の Vertex AI Vector Search など)も、その次の選択肢です。
RAGとセマンティック検索の違い
セマンティック検索は、意味の近い資料を探して見せるところまでです。RAGはその検索結果をAIに渡し、資料にもとづく文章の答えまで作らせる点が違います。つまり、RAGの中に検索(セマンティック検索)が含まれています。
次に読む:RAGの実装は何工程で進める?
RAGツールを無料で選ぶ前に押さえるべき構造的な前提
RAG(Retrieval-Augmented Generation)は、ユーザーの質問に対して外部ドキュメントをリアルタイムで検索し、その内容をLLMのプロンプトに組み込んで回答を生成する手法です。ファインチューニングと異なり、モデルの重みを変更せずに最新情報や社内固有知識を扱える点が実装上の利点です。
RAGシステムは大きく三つのコンポーネントで構成されます。①ドキュメントのベクトル化(Embedding)、②ベクトルデータベースへの格納と類似検索(Retrieve)、③LLMによる回答生成(Generate)だ。「無料でRAGを動かす」とは、これら三層を無料のツールで埋めることを意味します。各層に独立した無料選択肢が存在するため、組み合わせ次第で完全ゼロコストの構成が成立します。
なお、デジタル庁が推進するガバメントAI「源内」においても、RAG技術を用いた行政文書の活用が検討されており(デジタル庁「ガバメントAI源内」)、RAGは個人検証にとどまらず公的領域でも採用される技術として位置づけられています。また、国立国会図書館向けのRAGシステムをDifyで構築した事例が学術論文として報告されており(図書館情報学会誌 vol.70 No.3)、オープンソースのRAGツールが実用水準に達していることが示されています。
RAGの仕組みそのものを基礎から理解したい場合はRAGとはを、検索の土台になるベクトルの保存と検索についてはベクトルデータベースとはを参照してください。
RAGツール無料で使える主要選択肢を層ごとに整理する
「無料のRAGツール」を検討する際、単一のツール名だけで判断するのは危険です。何が無料で、どこに上限があり、どの層を担うのかを層ごとに整理しなければ、構成が組めません。以下に実用的な選択肢を整理する(2026年10月20日に各社の公式ページで確認した内容です。無料枠の条件は変更される場合があるため、導入前に公式サイトで確認してください)。
LLM層:無料で使える言語モデル
| ツール・サービス | 無料の条件 | 主な制限 | RAG用途の適性 |
|---|---|---|---|
| Ollama(ローカル実行) | 完全無料・OSS | モデルが大きいほどメモリが必要です(Llama 3.2の3Bは配布サイズ約2.0GB、Ollama公式)。CPUだけだと低速 | 機密データ向き。回数の制限がない |
| Google Gemini API(無料枠) | Google AI Studioで無料のAPIキーを取得。公式料金ページで、Gemini 3.5 Flash-Lite・2.5 Flashなど複数モデルが無料枠として案内(2026年10月20日確認) | 回数・トークン数に上限あり。無料枠では入力が製品改善に使われる場合があると公式に記載 | 日本語で試しやすく、PoC向き。機密資料は不可 |
| Groq(無料枠) | Free Planで利用可(公式のレート制限ページに Free Plan Limits あり) | モデルごとにRPM・RPD・TPM・TPDなどの上限。具体値は公式ページやアカウント画面で確認 | 高速推論。開発・検証用途 |
| Hugging Face Inference Providers | 無料ユーザーには月額の無料クレジットがなく、クレジット購入かPROが必要(PROは月2ドル分のクレジット、公式) | 従量課金(プロバイダの料金をそのまま請求) | 無料のまま使いたい場合は他の選択肢を推奨 |
Embedding層:無料で使えるベクトル化モデル
| モデル・サービス | 無料条件 | 日本語対応 | 推奨用途 |
|---|---|---|---|
| sentence-transformers (multilingual-e5系) |
完全無料・OSS・ローカル実行 | 対応 | 日本語RAG・本番用途 |
| BAAI/bge-m3 | 完全無料・OSS・ローカル実行 | 対応 | 多言語RAG・高精度が必要な場面(Ollamaでは bge-m3 として配布。約1.2GB・100以上の言語・コンテキスト8K) |
| Nomic Embed(Ollama経由) | ローカル版は完全無料 | 一定対応 | Ollama統合環境での利用(配布サイズ274MB・コンテキスト2K。対応言語は公式ページに記載なし) |
| Google Embedding API | AI Studio無料枠内 | 対応 | Gemini LLM連携時(公式料金ページで Gemini Embedding 2 が無料枠と案内) |
ベクトルDB層:無料で使えるベクトルストア
| DB名 | 無料条件 | 特徴と注意点 |
|---|---|---|
| Chroma | 完全無料・OSS・ローカル | Pythonプロセスに組み込み可。開発・中規模用途に最適 |
| FAISS(Meta製) | 完全無料・OSS | 大規模・高速検索に強いです。永続化は自前で実装が必要 |
| Qdrant(OSS版) | OSS版は完全無料。Qdrant Cloudにも「Free forever」の1ノード(0.5vCPU・1GBメモリ・4GBディスク) | 本番利用にも耐えうる高機能。Docker運用推奨。無料クラウドは試作用 |
| Pinecone(無料枠) | Starter(無料):保存2GB・書き込み月200万・読み取り月100万・インデックス5つまで。リージョンはAWSのus-east-1のみ | マネージドで運用が楽。有料のStandardは月額最低利用料が50ドル |
| Weaviate Cloud(Free) | 無料プランは期限なし:1クラスタ・10万オブジェクト・メモリ1GB・ディスク10GB・コレクション1・テナント3 | 埋め込み生成は1日2,000リクエストまで。有料のFlexは月額45ドルから |
| Chroma Cloud(Starter) | 月額0ドル+従量課金。5ドル分の無料クレジット付き | 保存は1GiBあたり月0.33ドル、書き込みは1GiBあたり2.50ドル(公式料金ページ) |
| Zilliz Cloud(Free) | 1組織1クラスタ・保存5GB・月250万vCU | Milvusのマネージド版。無料枠の細目(コレクション数など)は公式ドキュメントで確認 |
RAGツール無料で始める:LangChain+Chroma+Ollamaの構築手順
最も再現性が高く完全ゼロコストで動かせる構成として、LangChain + Chroma + Ollama(LLMは Llama 3.2、埋め込みは bge-m3)の組み合わせを示します。インターネット接続はインストールとモデル取得のときだけ必要で、実行はすべてローカルで完結します。
ステップ1:Ollamaのセットアップ
公式サイト(ollama.com)からOSに合ったインストーラーを入手し、インストールします。その後ターミナルで以下を実行します。
# LLMとして Llama 3.2(3Bパラメータ・配布サイズ約2.0GB)を取得
ollama pull llama3.2

# Embeddingモデル(100以上の言語に対応・約1.2GB)も取得
ollama pull bge-m3
Llama 3.2 の公式の対応言語は英語・ドイツ語・フランス語・イタリア語・ポルトガル語・ヒンディー語・スペイン語・タイ語で、日本語は含まれていません(Ollama公式ページ、2026年10月20日確認。公式は「より広い言語で学習している」とも書いています)。日本語の回答の品質が足りないときは、ここのモデルだけ別のものに差し替えてください。後の手順のコードは、モデル名を変えるだけで動きます。
ステップ2:Python環境とライブラリのインストール
Python 3.10以上を使います。仮想環境を作成してから、必要なライブラリを導入します。
python -m venv rag_env
source rag_env/bin/activate  # Windowsは rag_env\Scripts\activate

pip install langchain-ollama langchain-chroma langchain-text-splitters pypdf
以前の手順にあった langchain 本体・sentence-transformers・chromadb の個別インストールは不要です(langchain-chroma が Chroma を取り込みます)。
ステップ3:ドキュメントの読み込みとチャンク分割
RAGの検索精度はチャンク設計に大きく依存します。チャンクが大きすぎるとノイズがLLMに流れ込み、小さすぎると文脈が失われます。500〜1000トークン、オーバーラップ50〜100トークンが出発点として実用的です。日本語ドキュメントを扱う場合は区切り文字を明示的に指定しなければ精度が落ちます。
from pypdf import PdfReader
from langchain_core.documents import Document
from langchain_text_splitters import RecursiveCharacterTextSplitter

# PDFをページごとに読み込む
reader = PdfReader("target_document.pdf")
documents = [
    Document(page_content=page.extract_text(), metadata={"page": i + 1})
    for i, page in enumerate(reader.pages)
]

# 日本語向けに区切り文字を明示指定
splitter = RecursiveCharacterTextSplitter(
    chunk_size=800,
    chunk_overlap=80,
    separators=["\n\n", "\n", "。", "、", ""]
)
chunks = splitter.split_documents(documents)
ステップ4:ベクトルDBへの格納
from langchain_chroma import Chroma
from langchain_ollama import OllamaEmbeddings

embeddings = OllamaEmbeddings(model="bge-m3")

vectorstore = Chroma.from_documents(
    documents=chunks,
    embedding=embeddings,
    persist_directory="./chroma_db"
)
ステップ5:検索した資料を渡して質問に答えさせる
from langchain_ollama import ChatOllama

llm = ChatOllama(model="llama3.2", temperature=0)
retriever = vectorstore.as_retriever(search_kwargs={"k": 4})

question = "製品の保証期間は何年ですか?"
docs = retriever.invoke(question)                       # 質問に近いチャンクを検索
context = "\n\n".join(d.page_content for d in docs)
prompt = (
    "次の資料だけを根拠に、日本語で簡潔に答えてください。"
    "資料に無ければ「資料にありません」と答えてください。\n\n"
    f"【資料】\n{context}\n\n【質問】{question}"
)
print(llm.invoke(prompt).content)
以前の手順で使っていた RetrievalQA(langchain.chains)は、現行のLangChainでは langchain-classic という別パッケージに移されています。上のコードは検索と回答生成を自分で書く形にしてあり、追加のチェーン用パッケージは要りません。
実際に動かして確認した結果(2026年10月20日)
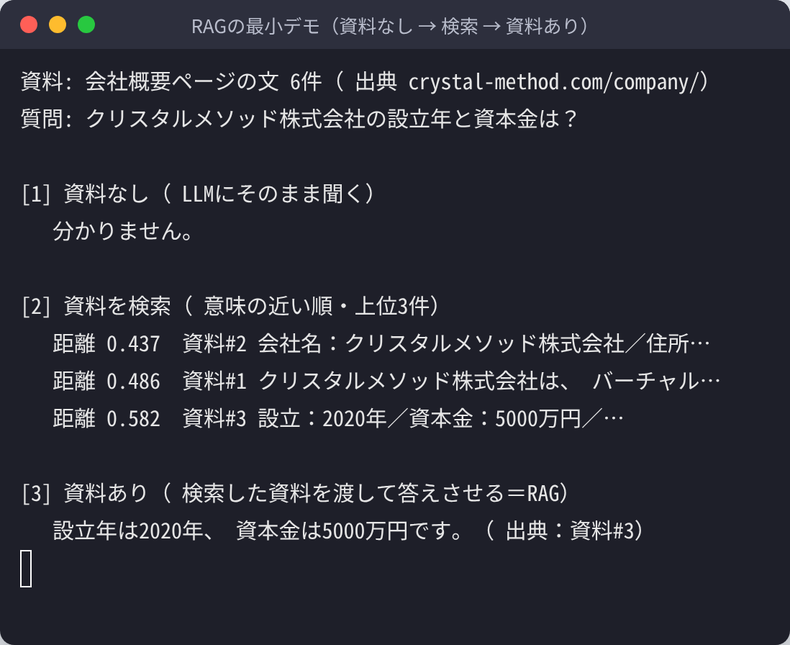
上のコードを実際に動かしました(実行環境:Ollama+Llama 3.2の3B+bge-m3、LangChain系パッケージは pip で取得した最新版)。PDFの読み込みとチャンク分割、Chromaへの保存・検索まで動くことを確認したうえで、会社概要の短い文(設立・資本金などを書いた5段落)を入れ、質問を「設立年と資本金は?」に変えて実行すると、次のように答えました。
設立年は2020年、資本金は5000万円です。検索で資料の該当部分が渡されたため、モデルが元から知らない会社の情報にも答えられています。同じ仕組みをより小さく作り、資料なし・資料ありを比べた画面が次です(こちらはSQLiteの検索拡張とクラウドのLLMを使った別の最小構成で、LangChainは使っていません)。
この構成は外部APIを一切使いません。資料の内容がインターネットに出ることはなく、ソフトウェアの費用はかかりません。機密資料の検証に向いています(PC自体の管理は別途必要です)。
チャンク分割や評価の細かい調整はRAGの作り方、Ollamaでの構築はOllamaでRAGを作る方法で扱っています。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
ノーコードで使えるRAGツール無料選択肢の比較
コードを書かずにRAGを検証したい場合や、非エンジニアのチームメンバーが参照するPoC環境を素早く構築したい場合には、以下のサービスが実用的です。
Google NotebookLM
PDFやGoogleドキュメントをアップロードするだけで、そのドキュメントに基づくAI質問応答が使えます。技術的なセットアップは不要で、Googleアカウントのみで完全無料で動作します。日本語対応の品質は高く、社内ドキュメントの即時検証に向いています。ただし、独自システムへの組み込みやAPI連携、チャンク設定のカスタマイズはできません。
Dify(セルフホスト版)
RAGアプリケーションをWeb UIで構築できるOSSプラットフォームです。Dockerで自前サーバーに立ち上げれば完全無料で利用でき、ドキュメントのアップロードからチャンク設定、LLM接続、チャットUIの生成まで、コードなしで操作できます。LLM部分はOllamaやGeminiの無料枠に接続可能で、柔軟な構成を組めます。クラウド版にも無料プランがあるが月間メッセージ数に上限があります。図書館向けRAGシステムの実装事例でも採用実績が報告されており(図書館情報学会誌 vol.70 No.3)、実用水準にあります。
Flowise
LangChainをベースにしたビジュアルノーコードビルダーで、ドラッグ&ドロップでRAGパイプラインを構築できます。チャンク分割・Embedding・ベクトルDB・LLMの各ノードをつなぐだけで動作します。セルフホストで費用は一切かかりません。
RAGFlow
InfiniFlowが開発するRAG専用のOSSプラットフォームです。PDFの複雑なレイアウトや表形式データを高精度でパースする点が特徴で、社内ドキュメントの構造が複雑な場合に強みを発揮します。Dockerによるセルフホスト運用が基本で、すべて無料で使えます。
| ツール | コード要否 | 無料条件 | 日本語対応 | 向いている用途 |
|---|---|---|---|---|
| Google NotebookLM | 不要 | 完全無料 | 高品質 | 即時検証・非エンジニア |
| Dify(セルフホスト) | 最小限 | OSS版は完全無料 | 対応 | チーム共有・PoC |
| Flowise | 不要(UI操作) | OSS版は完全無料 | 対応 | パイプライン可視化・教育 |
| RAGFlow | 最小限 | OSS版は完全無料 | 対応 | 複雑PDFの高精度解析 |
| LangChain+Chroma+Ollama | 必要(Python) | 完全無料 | 設定次第で高品質 | カスタマイズ・本番展開 |
RAGツール無料構成の実用上の限界と対処法
無料でRAGを動かす際には、見落としがちな技術的制約があります。構築前に理解しておくことで、後から手戻りが生じにくくなります。
API無料枠はレート制限が本番障壁になる
GeminiやGroqの無料枠には1分あたりのリクエスト数・トークン数に上限があります。複数ユーザーが同時にアクセスする環境や、大量のドキュメントをバッチ処理する場面では、この上限にすぐに達します。無料枠は開発・プロトタイプ・個人用途と割り切り、チーム展開や本番サービスへの移行段階では有料プランを検討するのが現実的です。
ローカルLLMはスペックがボトルネックになる
Ollamaで動かすモデルは、大きいほど多くのメモリが必要です。この記事で使うLlama 3.2の3Bは配布サイズが約2.0GBで、小さめのPCでも試しやすい大きさです(Ollama公式)。GPUがあれば推論速度は大幅に向上しますが、CPUだけでも動作します。ただし、CPUだけでは応答に時間がかかることを許容する必要があります。本番サービスとしての応答速度が求められる用途では、クラウドGPUインスタンスの利用を視野に入れるべきだ(OptiMax「RAG構築の手順と費用」)。
日本語RAGに固有のチャンク設計の問題
日本語テキストは英語と異なりスペースによる単語区切りがないため、デフォルトのチャンク分割設定では文脈が不自然に切断されやすいです。RecursiveCharacterTextSplitterのseparatorsに["\n\n", "\n", "。", "、", ""]を明示的に指定することで精度が改善します。また、Embeddingモデルはmultilingual-e5-baseやbge-m3など日本語を含む多言語対応モデルを必ず選んでください。英語特化モデルを使うと日本語文書の類似検索精度が著しく低下します。
機密データには完全ローカル構成が唯一の安全策
社内の機密ドキュメントをRAGに使う場合、外部APIにドキュメント内容を送信することはリスクになります。GeminiやGroqを使う構成では、ドキュメントのチャンクがAPIプロバイダのサーバーを経由します。機密情報を扱うならば、Ollama(ローカルLLM)+sentence-transformers(ローカルEmbedding)+Chroma/FAISS(ローカルVectorDB)の「完全ローカルRAG」構成のみが選択肢となります。これはゼロコストで実現できます。
ドキュメント規模が増えたときの移行判断
ドキュメント数が数千件を超えるとChromaのローカルモードでは検索速度が低下しやすいです。この段階では、Qdrantのローカル版(OSS、無料)を採用するか、スケールに応じてQdrant CloudやPineconeの有料プランへの移行を検討します。大規模なベクトル検索にはマネージドサービスの方が運用コストを抑えやすいです。
無料構成でも回答の誤りは起こります。誤りを減らす考え方はハルシネーションの防止策にまとめています。
無料RAGツールで構築後の品質評価:Ragasによる定量評価
RAGを構築した後、「回答が正しいかどうか」を勘で判断し続けるのは開発の持続性に欠けます。RAG専用の評価フレームワークRagas(完全OSS・無料)を使えば、以下の指標を自動で数値化できます。
- Faithfulness(忠実性):回答が取得した文書の内容に基づいているか
- Answer Relevancy(回答の関連性):回答が質問に対して適切に答えているか
- Context Precision(文脈の精度):取得した文書が実際に有用だったか
評価用のLLMにもGeminiやGroqの無料枠を使えます。構築→評価→改善のサイクルを回すことで、チャンクサイズやEmbeddingモデルの選択が検索精度に与える影響を定量的に把握できます。
また、LangChainが提供するLangSmith(開発者向け無料枠あり)を使えば、RAGパイプラインのどのステップで問題が起きているかをトレースログで可視化できます。取得文書の内容・プロンプト・レスポンスを一元的に記録でき、デバッグ効率が上がります。
AIの業務活用・導入をご検討の方へ
クリスタルメソッドは、LLM・RAG・AIアバターを活用した業務へのAI導入を支援しています。自社の課題にどう活かせるか、まずはお気軽にご相談ください。
参考文献
- Google「Gemini API 料金」(2026年10月20日確認)
https://ai.google.dev/gemini-api/docs/pricing - Pinecone「Pricing」(2026年10月20日確認)
https://www.pinecone.io/pricing/ - Qdrant「Pricing」・Weaviate「Pricing」・Chroma「Pricing」・Dify「Pricing」(いずれも2026年10月20日確認)
https://qdrant.tech/pricing/・https://weaviate.io/pricing・https://www.trychroma.com/pricing・https://dify.ai/pricing - Ollama「llama3.2」・「bge-m3」・「nomic-embed-text」(2026年10月20日確認)
https://ollama.com/library/llama3.2 - Hugging Face「Inference Providers Pricing」(2026年10月20日確認)
https://huggingface.co/docs/inference-providers/pricing - デジタル庁「ガバメントAI『源内』」
https://www.digital.go.jp/policies/genai - 図書館情報学会誌 vol.70 No.3「DifyでRAG型図書館サービス質問回答システムを構築した事例」(jstage.jst.go.jp)
https://www.jstage.jst.go.jp/article/jpla/70/3/70_90/_pdf/-char/ja - OptiMax「RAG構築の手順と費用|失敗しない実装ガイド【2026年】」
https://www.optimax.co.jp/ai-information/rag-implementation-steps/ - Apidog「2026年 おすすめオープンソースRAGフレームワーク15選」
https://apidog.com/jp/blog/best-open-source-rag-frameworks/ - taskhub「RAGを無料で構築する方法完全ガイド!おすすめツール5選と自作手順」
https://taskhub.jp/useful/rag-free/
Read next
あわせて読みたい
-
RAGとは?仕組みと実装方法を7工程で解説
RAG(Retrieval-Augmented Generation)の基本概念や定義については RAGとは何か――基本概念と全体像 を先に参照されたい。本記事...
-
RAG比較2026年版——タイプ別の選び方とサービス比較・技術アーキテクチャ完全ガイド
「RAGを導入したいが、どのサービスを選べばよいか分からない」——多くの企業担当者が最初にぶつかるのはこの疑問だ。RAG(Retrieval-Augmented...
-
RAG導入事例から学ぶ設計判断の核心【2026年版】
RAG(Retrieval-Augmented Generation:検索拡張生成)の活用事例は、社内問い合わせ、コールセンター、自治体の庁内QA、製薬の手順書...