
blog
AIブログ
RAG導入事例から学ぶ設計判断の核心【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
RAG(Retrieval-Augmented Generation:検索拡張生成)の活用事例は、社内問い合わせ、コールセンター、自治体の庁内QA、製薬の手順書検索など、文書が多い業務で広がっています。この記事では、企業や自治体が公式に公開している事例と、総務省の調査資料を実際に読んで確認できた内容だけを、業務別に整理します。
検討中の方が知りたいのは、「どの業務に、どんな構成で使われ、数字で何が示されているか」と「どこでつまずいたか」の2点です。結論から言うと、活用事例は「問い合わせ・サポート」「自治体の庁内QA」「社内ナレッジ検索」「製薬・金融のように規程や手順書が多い業務」の4つに集まっています。そこで各事例について、使われた構成と公式に書かれた効果の数値を原文のとおり記載し、数値が書かれていない事例は「数値の記載なし」と明記します。
RAGの基本的な仕組みや他手法との違いは RAG総合ガイド で解説しています。本記事は「実際にどう使われているか」に絞ります。各事例の内容は、記事末尾の公式ページを2026年10月29日に確認したものです。
RAG活用事例の早見表:公式ページで確認できた16件
結論(2026年10月29日時点):社名つきで公式に確認できたRAG活用事例は、カスタマーサポート、自治体、社内ナレッジ、製薬、金融、製造業(保守・技術継承)、営業(検索・提案書づくり)の分野にあります。教育は問い合わせ対応の取り組み報告までで、法務・小売・ECと新人オンボーディング専用の事例は、社名と効果が読める公式資料を確認できませんでした。
公式ブログ・公式の導入事例ページ・省庁の公開資料に載っている16件を、業務・構成・公表された効果の順に並べました。効果の数値は、各ページに書かれた表現をそのまま転記しています(導入企業や公式ブログによる掲載で、第三者の検証ではありません)。
| 事例 | 業務・用途 | 使われている構成 | 公式に書かれた効果(原文) |
|---|---|---|---|
| セゾンテクノロジー | HULFT製品のテクニカルサポートの回答作成 | Amazon Bedrock、階層化チャンク、キーワード検索+ベクトル検索 | 回答作成時間が最大30%短縮/回答精度はKendra利用のRAG比14%、Knowledge Bases比22%向上 |
| クリエイティブ・ウェブ | コールセンターの過去対応履歴の検索 | Amazon Bedrock、Amazon OpenSearch Service | 初回解決率が約30%増加/平均対応時間が従来比約40%削減/過去事例の検索時間が5分から1分以下 |
| 香川県「CatBot」 | 庁内QA(職員向け) | Azure OpenAIのAPI、QA単位のナレッジ登録 | 数値の記載なし(課題と運用上の制約が記載) |
| 三菱重工業 | 社内データを使う社内向け生成AI | Azure OpenAI Service、Azure AI Search(フルカスタマイズ) | 1日あたり200〜300のアクティブユーザー |
| NTT西日本 | 営業担当者向けマニュアル検索ボット | Amazon Bedrock Knowledge Bases、Amazon OpenSearch Serverless | 数値の記載なし(アンケートで「マニュアルを探す時間が減った」との声) |
| 日本テレビ放送網 | 社内ドキュメント検索 | Vertex AI Search、検索の前後でGeminiによる分類 | RAG単体の数値の記載なし |
| IQVIAサービシーズ ジャパン | 臨床試験の社内Q&A検索 | Amazon Bedrockのナレッジベース、Q&A単位の分割 | 約2ヶ月で社内ユーザー321人/月あたりの検索・調査時間を93%削減 |
| 三菱UFJ銀行 | 全社員向けの社内生成AI | Azure OpenAI Service、文書を前処理してからRAGに格納 | 全社員約3万人が利用できる環境を2023年11月に提供(効果の数値の記載なし) |
| 東京海上日動システムズ | 社内FAQ・マニュアル・問い合わせ履歴の検索 | Amazon Bedrock Knowledge Bases、独自実装のRAGとの使い分け | 数値の記載なし |
| 中外製薬 | 医薬安全性本部のSOP(標準作業手順書)検索 | Google Cloud上のRAG、マルチモーダルRAGを検証 | 数値の記載なし |
| 日立パワーソリューションズ | 保守作業員向けの知識検索(ベテランの保守知識の継承) | Amazon Kendra、Amazon Bedrock | 回答精度が開発初期の約40%から約90%に向上(報告書作成での検証)/構築・効果検証が6か月想定から3か月に短縮 |
| ヤンマーホールディングス | 社内の技術資料・手順書の統合ナレッジ検索(技術継承) | Amazon Bedrock、Amazon Kendra | 社内内規の検索で1人あたり月20分短縮(利用者60数人)/カスタマーサービスで月100分短縮 など |
| 常陽銀行 | 営業ソリューション検索サービス(取引先の課題に合う提案の検索) | Azure OpenAIのChatGPT上のRAG | 効果の数値の記載なし(提案を経験や知識への依存から平準化するねらい) |
| あいち銀行(NTTデータが提供) | 融資稟議書の素案作成 | NTTデータのRAG「LITRON Generative Assistant on finposs」 | 最大で年間13,400時間の業務削減を見込む(見込みの値)/審査役の評価で指摘数が約25%減 |
| KDDIアジャイル開発センター | 営業の議事録から、社内商材と競合製品を検索して提案骨子を作る | Amazon Bedrock、Amazon Bedrock Knowledge Bases | 営業担当者の評価で、議事録と提案書の作成時間が最大1時間短縮 |
| ITbook株式会社 | 提案書の本文生成(過去の提案内容をナレッジとして検索) | Amazon Bedrock、Amazon OpenSearch Service | 提案書の骨子づくりが約10日から半日程度に |
効果の数値が公開されているのは16件中9件(セゾンテクノロジー、クリエイティブ・ウェブ、三菱重工業、IQVIA、日立パワーソリューションズ、ヤンマーホールディングス、あいち銀行、KDDIアジャイル開発センター、ITbook)で。ただし、あいち銀行の値は見込みで実測ではありません。測っているものもそれぞれ違います。数字を横並びで比べるのではなく、「どの業務で、何を測ったか」を見るのが安全です。
RAGの設計判断を種類別に決めるときは、タイプ別の選び方と技術アーキテクチャで解説しています。
関連記事RAGを無料で構築するには?
RAGとは何か:事例を読む前の最小限の整理
RAG(検索拡張生成)は、質問を受けたときに、まず社内の文書などから関係する部分を検索し、その内容をLLMに渡して回答を作らせる方式です。LLMが学習していない社内の規程・マニュアル・過去の対応履歴にも答えられるようになり、回答に使った文書を示せるため、確認しやすいことが特徴です。
- 検索:質問に近い文書の断片(チャンク)を、キーワードや意味の近さで探します。
- 拡張:見つかった断片を質問と一緒にLLMへ渡します。
- 生成:LLMが、渡された文書の内容にもとづいて回答します。根拠のページへのリンクを付ける事例もあります。
LLM単体では、社内にしかない情報や最新の改訂に答えられず、知らないことでももっともらしく答えてしまう(ハルシネーション)ことがあります。RAGが必要とされる背景は、この限界を、参照する文書と回答の根拠で補えるためです。ファインチューニング(モデルの追加学習)は文書が変わるたびにやり直しが必要ですが、RAGは参照する文書を差し替えれば更新できます。ただし、検索で正しい文書を取り出せなければ回答も外れるため、後述のとおり文書の切り方と検索の設計が成否を分けます。詳しい仕組みは RAG総合ガイド をご覧ください。
次に読む:RAGの実装は何工程で進める?
カスタマーサポート・問い合わせ対応の事例:セゾンテクノロジーとクリエイティブ・ウェブ
問い合わせ対応は、過去の対応履歴やマニュアルという「答えの元」がすでに社内にあるため、RAGの活用事例が具体的に公開されている領域です。ここでは公式に掲載された2件を取り上げます。
セゾンテクノロジー:HULFT製品のテクニカルサポート
AWS公式ブログ(2024年7月8日掲載)によると、サポートエンジニアは数万ページに及ぶマニュアル、FAQ、過去の問い合わせ履歴から情報を探して回答を作成しており、若手の育成と回答作成時の心理的負担が課題でした。Amazon Bedrockを使い、Slackでボットに質問すると回答が返る仕組みを構築しています。検索から回答までの流れは次のとおりです。
- Claude 3 Haikuが質問から検索語を広げ、複数の検索クエリを作る(クエリ拡張)
- sudachiによるキーワード検索で、関連する文書を絞り込む
- 細かい粒度のチャンクで検索し、その上位階層のチャンクを取得して文脈を保つ(階層化チャンク)
- FAISSによるベクトル検索で、意味の近い上位の文書に絞る
- Cohere Command R+が回答を作り、Slackに返す。Guardrails for Amazon Bedrockで製品のシリアル番号などの入力を制限する
開発初期にはAmazon KendraやKnowledge Bases for Amazon Bedrockも検証しており、関係のない情報が混ざる、日本語の分かち書きの精度が不十分、取得トークン数の制限で文脈が分断される、といった課題から採用を見送ったと書かれています。掲載されている効果は、回答作成時間が最大30%短縮、回答精度がKendraを使ったRAGと比べて14%・Knowledge Bases for Amazon Bedrockと比べて22%向上、サポートセンター全体で導入前と比べて約10%の効率化です。
クリエイティブ・ウェブ:コールセンターのお問い合わせ管理
AWS公式ブログ(2025年10月22日掲載)では、問い合わせ内容や対応方法の記録が属人的で、類似ケースの検索と参照に時間がかかることが課題とされています。Amazon BedrockとAmazon OpenSearch Serviceで過去の対応履歴をインデックス化し、キーワード検索とセマンティック検索を組み合わせて類似事例を取り出します。問い合わせの複雑さに応じて、Amazon Nova、Claude 3 Sonnet、Claude 3 Haikuを使い分ける構成です。
掲載されている効果は、初回解決率が約30%増加、平均対応時間が従来比で約40%削減、過去事例の検索時間が5分から1分以下に短縮、です。2件とも、キーワード検索と意味検索を併用している点が共通しています。
自治体・公共機関の事例:総務省の調査と香川県「CatBot」
自治体については、全国の状況を示す調査と、1つの県の運用実態の資料がそれぞれ公開されています。
総務省の調査:導入されているカスタマイズ方法はRAGが最多
総務省「自治体における生成AI導入状況」(令和7年6月30日版)には、実証実験を含めて自治体が導入している生成AIのカスタマイズ方法の内訳があります。「生成AIのモデルはそのままで、外部ソースとして業務知識を参照させている(=RAG)」が244件で最も多く、APIやファインチューニングなどで特定の行政分野に対応した環境を構築しているものは41件、その他が36件でした。
香川県の職員開発システム「CatBot」
総務省に掲載された香川県の資料(令和7年3月)によると、香川県は2023年9月に、対話型の文書生成機能と庁内QA機能(RAG)を持つ「CatBot」を職員が開発し、庁内で生成AIの利用を始めました。職員開発の利点として、主な費用がAzure OpenAIのChatGPT API利用料のみで安いこと、庁内IDでシングルサインオンできること、認証情報・QAナレッジ・ログを庁内側に保持できるためセキュリティ確保が容易なことが挙げられています。
この資料は効果の数値を載せていない代わりに、庁内QA機能の課題を具体的に書いています。
- ナレッジをファイル単位で登録すると回答精度が落ちるため、QA単位(規程は条項などの単位)に細分化して登録する仕組みにしているが、それでも精度を上げるには限界がある
- 登録するQAナレッジは、業務分野全体を網羅し、重複のない内容にする必要がある。特別な事例だけでなく、ごく当たり前のQAも一通り用意する
- 質問と類似度の高いQAだけを生成AIに参照させる仕組みのため、的確な回答生成には限界がある。回答文までは生成せず、類似度の高いQAナレッジの一覧を表示するにとどめる方が実用的かもしれない
また同資料は、全国の自治体の状況として、外部サービスの利用には数千万円単位の費用が必要なのに効果が未知数で、導入に苦慮している団体が多いのではないか、とも述べています。
社内ナレッジ検索の事例:三菱重工業・NTT西日本・日本テレビ放送網
社内の規程・マニュアル・資料を検索して答える用途は、業種を問わず事例が多い領域です。ここでは製造業、通信、放送の3社を取り上げます。
三菱重工業:Azure AI Searchを使ったフルカスタマイズのRAG
Microsoftの導入事例によると、三菱重工業は社内ChatGPTアプリ(2023年7月)の次の段階として、自社データを社内で活用できる機能に力を入れました。Azure OpenAI Service on your dataも評価しましたが望む結果が得られず、パートナーのゼンアーキテクツとともに、検索エンジンにAzure AI Searchを使うフルカスタマイズのRAGを構築しています。ゼンアーキテクツ側の説明として、最も重要なのは社内データの整備、次が検索エンジンの精度で、Azure OpenAI Serviceは「ひとつのパーツ」だと書かれています。
公表されている効果は「1日あたり200〜300のアクティブユーザー」で、精度やコストの数値の記載はありません。
NTT西日本:営業担当者向けのマニュアル検索ボット
AWS公式ブログ(2025年11月20日掲載)では、営業担当者が多様な商材のマニュアルを参照するため、情報が複数のシステムに散在して検索に時間がかかること、問い合わせ窓口の社内ヘルプデスクがすべての問い合わせに即時対応しにくいことが課題でした。Amazon Bedrock Knowledge Bases、Amazon OpenSearch Serverless、Amazon S3、AWS Lambdaを使い、ビジネスチャットから質問できる形にしています。
- マニュアルのPDFをページ単位に分割してMarkdownに変換し、S3のオブジェクトキーからカテゴリなどのメタデータを作る
- メタデータで関連する商材のマニュアルだけを検索対象にして、回答精度を高める
- 回答に関連マニュアルのページへのリンクを付け、根拠を確認しやすくする
- 回答後に「解決した/解決していない」を聞き、未解決ならヘルプデスクに誘導する
数週間のトライアル後のアンケートでは、「知りたい情報に素早くアクセスできる」「マニュアルを探す時間が減った」という声が多かったと書かれています。解決率などの数値の記載はありません。
日本テレビ放送網:Vertex AI Searchによる社内ドキュメント検索
Google Cloudの導入事例では、生成AIプロジェクト「FACTly-Mate」の第2フェーズとして、Vertex AI Searchを使った社内ドキュメント検索機能(RAG)を実装しています。当初は精度を出すのに苦労したものの、適切なプロンプトの設定に加えて、検索の前段・後段でGeminiを呼び出し、きちんと分類させてから検索する処理を作ることで、期待していた精度が得られたと書かれています。検索対象の文書は現時点では限定的で、今後広げる予定です。RAG単体の効果を示す数値の記載はありません(同ページにある2024年5月時点のユニークブラウザ数約2,000という数字は、チャット機能全体のものです)。
製薬分野の事例:IQVIAサービシーズ ジャパンと中外製薬
製薬分野は、手順書・規制文書・Q&Aが膨大で、正しい文書に当たる必要がある点でRAGと相性のよい業種として、公式の事例が出ています。
IQVIAサービシーズ ジャパン:臨床試験の社内Q&A検索
AWS公式ブログ(2024年11月13日掲載)によると、臨床試験や製造販売後調査では省令・規制など公開文書の確認が頻繁に発生し、臨床試験プロジェクトでは社内に蓄積されたQ&Aを人手で検索するために、臨床開発モニターが月合計204時間を費やしていました。Amazon Bedrockのナレッジベースを採用した理由は、チャンキング、インデクシング、ベクトルDBとLLMの連携をマネージドに任せられる点で、当初は自前実装も試したと書かれています。Q&Aは質問と回答が対応した形でQ&A単位に分割して投入し、アプリはAWS Amplify、AWS Lambda、Amazon DynamoDBのサーバーレス構成です。
検証から構築まで担当者1名・約2ヶ月で実現し、約2ヶ月で社内ユーザー321人に達し、月あたりの検索・調査に費やす時間を93%削減した、と掲載されています。
中外製薬:SOP(標準作業手順書)検索システム
Google Cloud公式ブログ(2025年3月13日掲載)によると、医薬安全性本部(約210名)には、国内の製造販売後の安全管理業務手順だけで40点以上のSOPがあり、必要な情報を探して正しい手順で業務を進めることが負担でした。2024年3月頃にRAGを使ったSOP検索システムの構築を始め、同年11月に全社向けの「Chugai AI Assistant」の機能の1つとして使えるようになっています。
記事が挙げる最大の課題は、製薬会社の文書には図表が多く、それを正しく認識できないことです。そのためマルチモーダルRAGの構築が急務となり、2024年の春と夏にGoogle Cloudのコンサルティングチームと、表・図・フローチャートなど性質の異なる情報をどう取り込むかを検証したと書かれています。記事掲載時点はリリースに向けた環境構築の段階で、効果の数値の記載はありません。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
金融・保険分野の事例:三菱UFJ銀行・東京海上日動システムズ・あいち銀行(融資稟議書)
金融機関は規程やマニュアルが多く、社外へ出せない情報も多いため、社内向けのRAGが先に進んでいる分野です。公式に公開された社内検索の2件と、融資の稟議書づくりにRAGを使う1件を取り上げます。
三菱UFJ銀行:文書を前処理してからRAGに格納
Microsoftのセミナーレポート(2024年3月1日掲載)によると、三菱UFJ銀行はAzure OpenAI Serviceを使って社内向けの生成AI環境を構築し、2023年11月から全社員約3万人が使えるシステムを提供しています。RAGについては、2023年10月末時点で約5万件のドキュメントを前処理したうえでRAGに格納して検証している状況で、「RAGにドキュメントをそのまま読み込ませても上手く回答されないことがわかってきました」と述べられています。社内にはファイル形式や構造がさまざまな文書があるため、加工してから格納する方針です。効果の数値の記載はありません。
東京海上日動システムズ:複雑なレイアウトのマニュアルを扱う
AWS公式ブログ(2025年11月28日掲載)では、全社向けの生成AIアプリケーション実行基盤の上で、社内FAQサイト・社内マニュアル・過去の問い合わせ履歴を対象にしたRAGを構築しています。対象は数千〜数万ファイル規模で、社内マニュアルには二段組、図表とテキストの混在、階層的な構造があります。
- レイアウトが複雑な文書は、Amazon Bedrock Knowledge Basesの機能でレイアウトを解析してからベクトル化する
- データソースごとに埋め込みモデルを検証し、一部ではオープンソースのモデルのほうが検索精度が高かったため、Amazon SageMaker AIで独自に運用する
- 文書の特性に応じて、マネージドのRAGと独自実装のRAGを使い分ける
- 生成AIアプリごとにAWSアカウントを分け、入出力のフィルタリングやログ監視は共通のアカウントに集約する
定量的な効果の記載はなく、ドキュメント単位のアクセス権限についても記載はありません。
あいち銀行:融資稟議書の素案を作る(NTTデータが提供)
NTTデータのニュースリリース(2026年7月9日)によると、同社はRAG(検索拡張生成)の「LITRON® Generative Assistant on finposs®」を活用した融資稟議書作成AIサービスを、あいち銀行に2026年7月27日から提供開始します。地域金融機関向けに法人営業から融資審査までを支援する案件としては3例目の商用採用で、京都銀行は2026年2月25日に導入が発表されています。
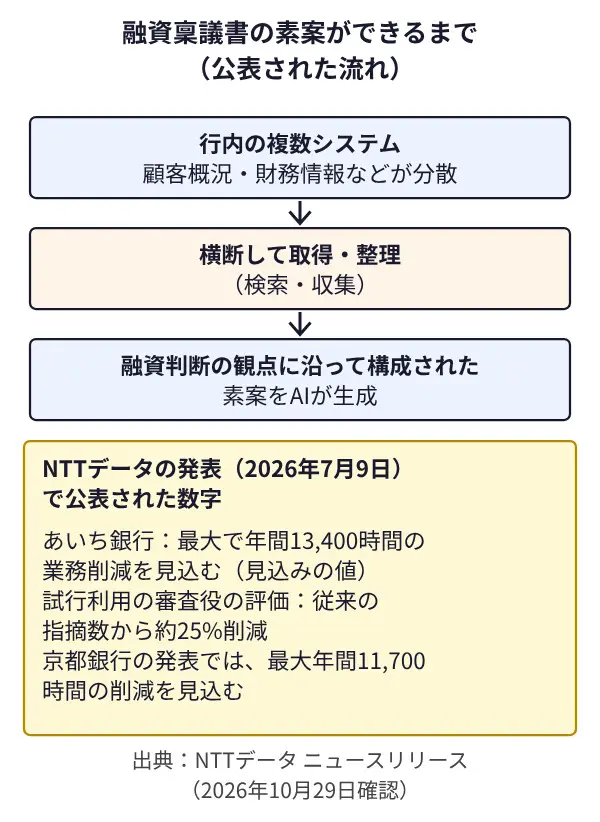
- 検索・収集:行内に分散する顧客概況や財務情報などを、複数の社内システムから横断的に取得・整理します。
- 生成:融資判断に必要な観点に沿って構成された稟議書の素案をAIが自動生成します。
- 公表された効果:あいち銀行は最大で年間13,400時間の業務削減を見込んでいます(見込みの値)。試行利用では作成時間の削減が確認され、審査役の評価では従来の指摘数から約25%削減できたとされています。京都銀行の発表では最大年間11,700時間の削減を見込んでいます。
- 基盤:FISC安全対策基準に対応した高セキュリティー環境で融資関連データを扱うとされています。
稟議書づくりへの生成AI:RAGの記載があるものとないもの
稟議書の作成に生成AIを使う公式発表は他にもあります。ただし、RAGを使ったと書かれているのはNTTデータの件だけです。次の表は、公式発表に書かれていることだけを並べました(2026年10月29日確認)。
| 発表 | 時期・状況 | 公表された効果 | RAGの記載 |
|---|---|---|---|
| NTTデータ × あいち銀行(公式) | 2026年7月9日発表。7月27日から提供開始 | 最大で年間13,400時間の削減を見込む。審査役の指摘数が約25%減 | あり(RAGと明記) |
| 横浜銀行 × 日本IBM(公式) | 2024年11月7日発表。6週間の実証実験 | 最大で年間19,500時間の効率化を見込む(月約8時間/担当行員。実測値ではない) | 記載なし |
| 宮崎銀行 × 日本IBM(公式) | 2024年6月13日発表。2024年4月から一部店舗で本番利用 | 稟議書作成の作業時間を95%削減と記載(何の時間かの内訳は記載なし) | 記載なし |
横浜銀行と宮崎銀行の発表には、RAGや社内文書の検索という言葉は出てきません。これらを「RAGの事例」と呼ぶのは正確ではないため、稟議書の自動化という用途の参考として並べています。
製造業・営業・教育の事例:公式資料で確認できたものと、確認できなかったもの
「自社の業種や部署の事例はあるか」という疑問に答えるため、業種・部署ごとに、公式の資料で確認できた範囲を整理します。導入事例として公開されているものと、デモや取り組み報告にとどまるものは区別して書きます。
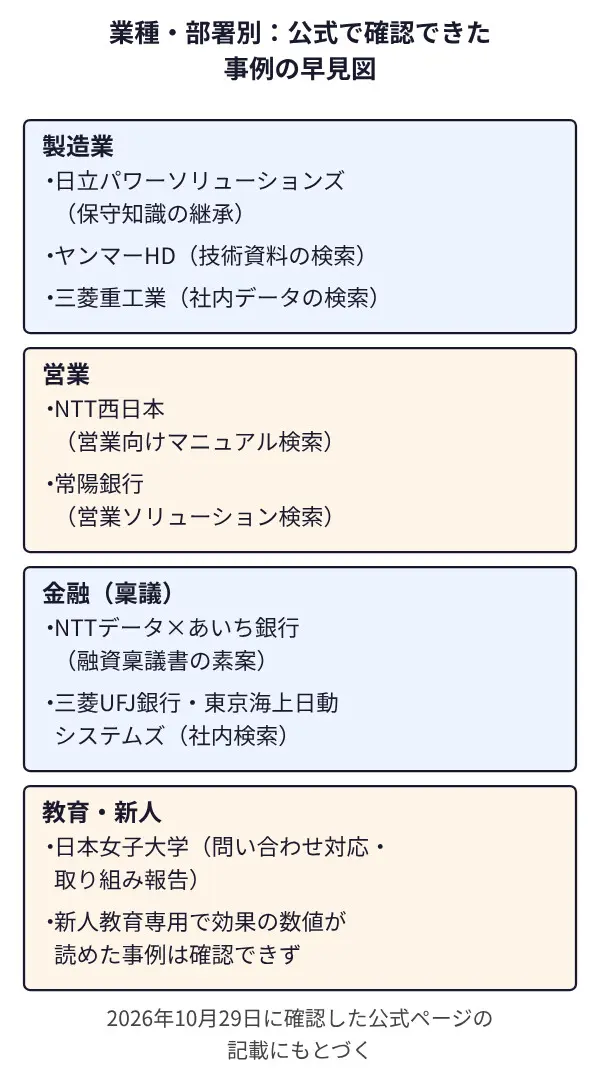
| 業種・部署 | 公式資料で確認できたもの | 種類 | 公表された効果 |
|---|---|---|---|
| 製造業(保守知識の継承) | 日立パワーソリューションズ(保守作業員向けの知識検索) | AWS公式ブログ | 回答精度が約40%から約90%に向上 |
| 製造業(技術資料の検索) | ヤンマーホールディングス(統合ナレッジ検索) | AWS導入事例 | 社内内規の検索で1人あたり月20分短縮 など |
| 製造業(社内データ) | 三菱重工業(社内向け生成AI) | Microsoft導入事例 | 1日あたり200〜300のアクティブユーザー |
| 製造業(技能伝承のサンプル) | AWSが公開したプラント保守向けのサンプル | デモの公開(導入事例ではない) | 記載なし |
| 営業(マニュアル・提案の検索) | NTT西日本、常陽銀行 | 導入事例/プレスリリース | 記載なし |
| 営業(提案書づくり) | KDDIアジャイル開発センター、ITbook株式会社 | AWS公式ブログ | 作成時間が最大1時間短縮/骨子づくりが約10日から半日程度に |
| 教育(大学) | 日本女子大学(問い合わせ対応のRAG型チャットボット) | 取り組み報告 | 記載なし(応答精度は「良好」と記載) |
| 新人教育・オンボーディング専用 | 社名と効果の数値が公式資料で読めたものは確認できませんでした | ー | ー |
| 法務・小売・EC | 公式の導入事例は確認できませんでした | ー | ー |
製造業・技術継承:日立パワーソリューションズ(AWS公式ブログ)
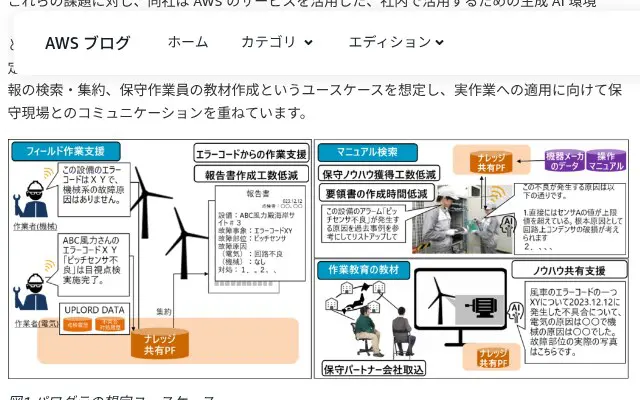
AWS公式ブログ(2024年9月25日掲載)によると、日立パワーソリューションズは、風力発電から工場の生産設備まで幅広い機器を保守しており、シニア層が保守作業員の約10%を占めるため、ベテランの退職による知識の喪失に危機感がありました。そこで社内向けの生成AI環境「Power AI Ground」を構築しています。
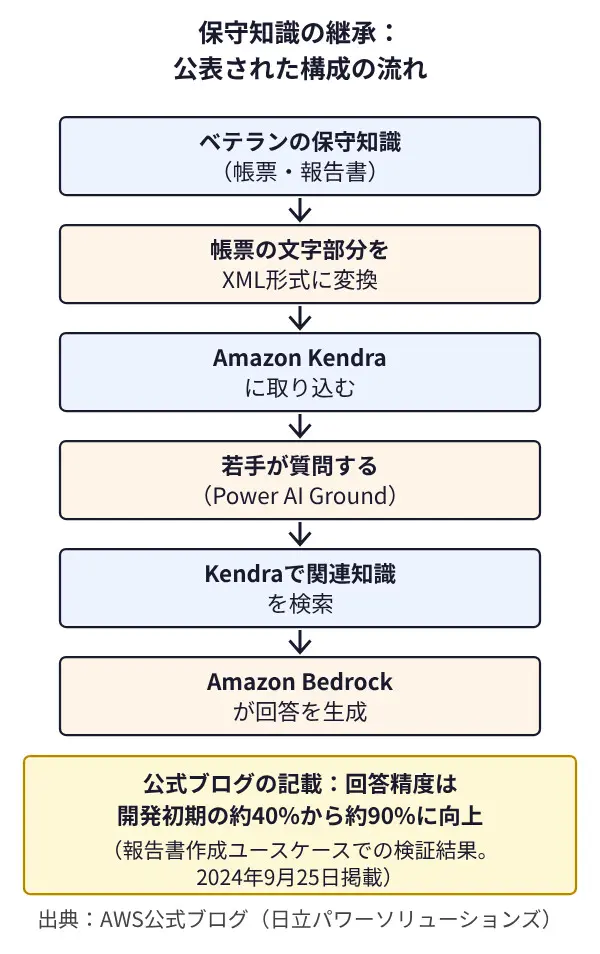
- 構成:帳票のテキスト部分をAWS LambdaでXML形式に変換してからKendraに取り込む工夫が書かれています。
- 効果:回答精度は開発初期の約40%から約90%に向上し(報告書作成での検証結果)、構築・効果検証の期間は当初想定の6か月から3か月に短縮されました。文書作成時間の削減は今後の見込みで、具体的な数値は書かれていません。利用者数の記載もありません。
製造業・技術資料の検索:ヤンマーホールディングス(AWS導入事例)
AWS導入事例ページによると、ヤンマーホールディングスは製品の使い方や不具合対処法などの技術資料が活用しにくく、経験の浅い社員が情報を探せないことが課題でした。2023年12月ごろからAWS上で評価を始め、2024年3月にRAGでの開発を決め、Amazon BedrockとAmazon Kendraで統合ナレッジ検索基盤を構築しています。構築には約3週間かかったとされています。社内の情報共有基盤に文書を保存すると自動で読み込まれ、チャットで質問すると参照元リンク付きの回答が得られます。
| 用途 | 公表された効果 |
|---|---|
| 社内内規の検索(エンジン事業) | 1人あたり月20分の短縮。利用者は60数人、全体で月1,200分程度 |
| マニュアルや対応履歴の活用(エネルギーシステム事業) | カスタマーサービスで月100分の短縮 |
| 過去設計資料の活用(エンジン開発事業) | 1人あたり月20分の効果 |
ページには、数値化されていない効果として属人化の解消や新人教育の支援も挙げられています。ベテランの技や知見の継承が経営課題であることも書かれています(公開日の記載はページ本文にありません)。
製造業・社内データの検索:三菱重工業と、技能伝承のサンプル
三菱重工業は、前の節のMicrosoft導入事例のとおりAzure AI Searchで社内データを検索対象にしており、公表された効果は「1日あたり200〜300のアクティブユーザー」です。技能伝承については、AWS公式ブログ(2024年11月11日掲載)が、AWS Summit Japan 2024のデモから、プラント保守の知見を検索して答えるサンプルを汎用化して公開しています。これは導入事例ではなく、サンプルソースの紹介で、知見で解決できない場合は熟練者とビデオ通話して、その内容を新しい知見として追加する構成です。効果を示す数値は書かれていません。
営業:マニュアル検索から、提案書づくりまで
営業部門で公式に確認できた事例は4件あり、使い方は「社内の文書を検索して示す」から「検索した結果をもとに提案の下書きを作る」まで広がっています。
| 事例 | 使い方(公式の記載) | 公表された効果 |
|---|---|---|
| NTT西日本 | 営業担当者が多様な商材のマニュアルを参照する検索ボット。回答に関連マニュアルのページへのリンクを付け、解決しなければヘルプデスクへ案内 | 数値の記載なし(アンケートの声のみ) |
| 常陽銀行(プレスリリース、2025年9月18日) | 閉域環境のChatGPT(Azure OpenAI)にRAG環境を構築し、取引先の事業課題やニーズに適したソリューションを回答する「営業ソリューション検索サービス」。対象は行員 | 数値の記載なし。ねらいはソリューション提案の平準化(月間1,000人以上=全行員の約31%はChatGPTの利用実績) |
| KDDIアジャイル開発センター「議事録パックン」(AWS公式ブログ、2024年9月6日) | 案件名と議事録を入力すると、社内の関連商材と他社の競合製品を自動で検索し、比較表と次回訪問に向けた提案骨子を出力。社内文書はAmazon Bedrock Knowledge Basesから検索する | KDDIの営業担当者の評価で、議事録と提案書の作成時間が最大1時間短縮 |
| ITbook株式会社(AWS公式ブログ、2026年7月1日) | 提案依頼書などから要件を抽出してアウトラインを作り、過去の提案内容などを別に「ナレッジ」として登録して、本文の生成時に検索して参照する。人が確認・修正する設計 | 提案書の骨子づくりが約10日から半日程度に。付加価値の検討に使える時間が平均約2日から5日以上に |
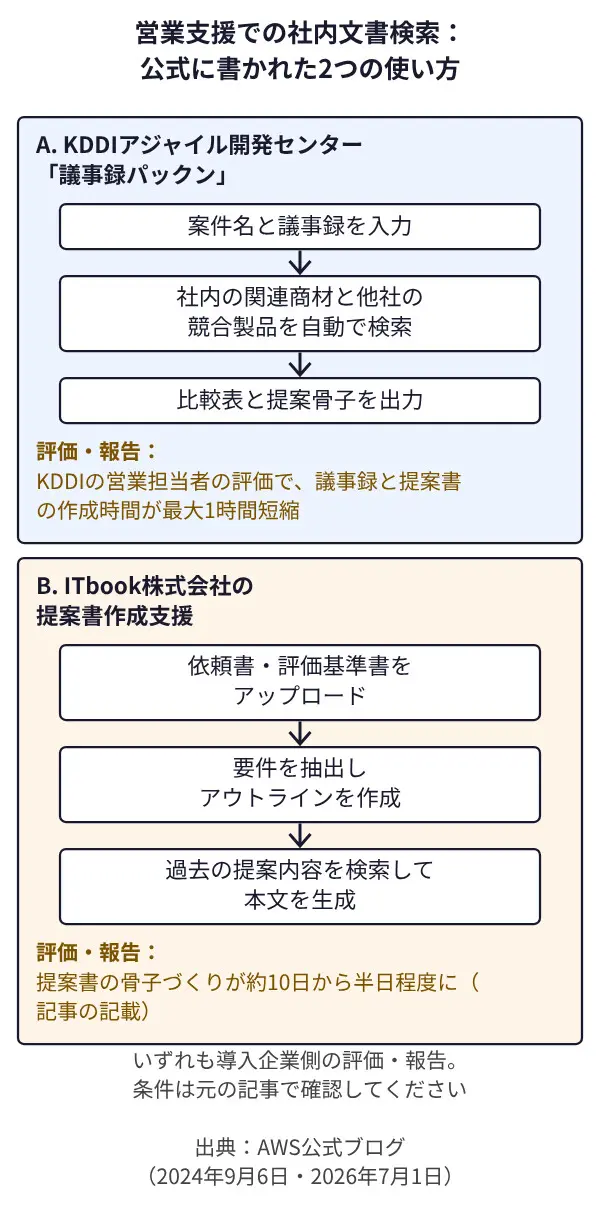
KDDIの記事には「RAG」という語は出てきませんが、社内文書を格納したAmazon Bedrock Knowledge Basesを検索して使う構成が書かれています。ITbookの記事も「RAG」とは書かれておらず、生成時にナレッジを検索して参照する点がRAGと同じ考え方です。どちらも、効果は導入企業側の評価や報告で、第三者の検証ではありません。
- 質問・入力の例(KDDI):入力は案件名と、対象とする議事録です。出力は比較表と提案骨子です。
- 検索の対象(ITbook):過去の提案内容や都道府県のガイドラインを、アップロードする資料とは別に「ナレッジ」として登録します。利用者は参照するナレッジや資料の時点を選べます。
- 人の確認:両方とも、生成結果を人が確認・修正する前提です。KDDIの記事には、録音の習慣づくりやファイルのアップロード待ち時間が課題として挙げられています。
失注案件の検索や商談記録の検索を専用に扱った公式の導入事例は、今回の確認では見つかりませんでした。
教育・新人のオンボーディング:日本女子大学と、ヤンマーの記載
教育機関では、日本女子大学管理部システム課などによる取り組み報告「検索拡張生成(RAG)で実現する生成AI型チャットボット導入に向けた取組」(PDF)が公開されています。学生・教職員からの問い合わせの一次窓口を想定し、従来のシナリオ分岐型のチャットボットより柔軟に応答できるとしています。
- 検証の内容:ICT関連の相談を受けるメディアセンターのQA履歴(2023年4月〜2024年7月)とホームページの情報をベクトルデータベースに格納して、応答を検証しています。
- 結果:応答精度は良好だったと書かれています。RAGでは入力トークン数が入力文字数の数千〜1万倍に増えると推定されましたが、実運用に問題のないコストだったとされ、メディアセンターのスタッフ向けに先行運用を始めています。
- 今後:2024年9月から各課の職員でプロジェクト体制を作り、回答の元になる文書の準備と、想定質問と回答の評価を行い、2025年度1月にトライアル運用を始める予定と書かれています。学生向けの展開も見据えるとされています。
授業の指導や学習支援そのものにRAGを使った公式の導入事例は、今回の確認では見つかりませんでした。教育分野は、問い合わせ対応のような事務の用途から先に進んでいる様子がうかがえます。
新人のオンボーディングについては、前述のヤンマーのページに、数値化されていない効果として新人教育の支援が挙げられているのを確認できました。一方、オンボーディングを専用の用途として、社名と効果の数値まで公式資料で読めた事例は確認できませんでした。
事例に共通する設計の工夫
ここまでの事例を並べると、業種が違っても同じ種類の工夫が繰り返し出てきます。公式ページに書かれていた内容だけを、工夫ごとに整理します。
| 工夫 | 書かれている事例 | 内容 |
|---|---|---|
| 文書の切り方を業務に合わせる | 香川県、セゾンテクノロジー、IQVIA、NTT西日本 | QA・条項単位、階層化チャンク、Q&A単位、ページ単位に分割して登録する |
| メタデータで検索範囲を絞る | NTT西日本、IQVIA | カテゴリなどのメタデータで、関連する文書だけを検索対象にする |
| キーワード検索と意味検索を併用する | セゾンテクノロジー、クリエイティブ・ウェブ | 語句の一致と意味の近さの両方で候補を取り出す |
| 検索の前後にLLMの処理を挟む | セゾンテクノロジー、日本テレビ放送網 | 質問から検索語を広げる、検索の前後で分類させる |
| 回答の根拠を示す・人に引き継ぐ | NTT西日本 | 該当マニュアルのページへのリンクを付け、未解決ならヘルプデスクへ誘導する |
| 図表を含む文書を扱う | 中外製薬 | 表・図・フローチャートの取り込みを、マルチモーダルRAGとして検証する |
| 回答を生成しない選択肢を残す | 香川県 | 回答文まで作らず、類似度の高いQAの一覧表示にとどめる案が示されている |
共通しているのは、LLMを選ぶことより前に、「どの文書を、どの単位で、どう検索させるか」を業務に合わせて決めている点です。三菱重工業の事例でも、最も重要なのは社内データの整備と説明されています。
事例から見るRAGの作り方:準備から運用までの流れ
公式資料に共通する流れを、準備から運用まで順に整理します。各段階で、どの事例が何を書いていたかを併記します。
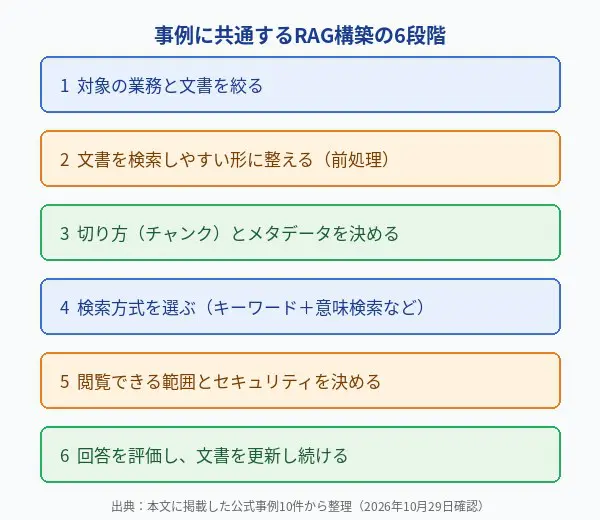
- 対象の業務と文書を絞る。IQVIAはまとまったQ&Aファイル、NTT西日本は営業担当者向けのマニュアル、日本テレビ放送網は限定した社内ドキュメントから始めています。
- 文書を検索しやすい形に整える。三菱UFJ銀行は文書を前処理してから格納し、NTT西日本はPDFをページ単位に分けてMarkdownに変換、香川県はQA・条項の単位に細分化しています。
- 切り方(チャンク)とメタデータを決める。セゾンテクノロジーは細かいチャンクで検索して上位階層を取得し、NTT西日本はカテゴリのメタデータで検索範囲を絞っています。
- 検索方式を選ぶ。セゾンテクノロジーとクリエイティブ・ウェブは、キーワード検索と意味検索を併用しています。
- 閲覧できる範囲を決める。香川県は認証情報・ナレッジ・ログを庁内側に保持し、東京海上日動システムズは入出力のフィルタリングとログ監視を共通のアカウントに集約しています。部署や役職ごとに見せる文書を分ける場合は、検索の段階で絞れる仕組みを選ぶ必要があります。
- 回答を評価し、文書を更新し続ける。NTT西日本は回答後に「解決した/していない」を聞き、香川県はナレッジの網羅と重複の整理を課題に挙げています。文書の改訂に合わせた差し替えと、表記ゆれや重複の整理を担当する人を決めておくことが、運用で効いてきます。
データ整備:正本と表記ゆれ
香川県の資料は、ナレッジに重複があると回答が揺れるため、網羅しつつ重複させないことを課題としています。同じ内容の文書が複数あるときは、どれを正とするかを決めて古い版を検索対象から外す、同じ意味の用語は表記をそろえる、といった整理が、検索の精度に直接効きます。
セキュリティと利用規約の確認
三菱重工業は顧客データが学習に使われないサービスを選んで導入し、香川県は認証情報・ナレッジ・ログを庁内側に保持しています。外部のLLMサービスを使う場合は、送った文書が学習に使われないか、保存されるかを、事前に利用規約で確認することが前提になります。個人情報や機密を含む文書は、検索対象に入れる前に除外するか、閉じた環境で扱います。
改善サイクルと運用体制
NTT西日本は回答後に「解決した/していない」を記録し、未解決はヘルプデスクへ引き継ぎ、数週間のトライアル後にアンケートで改善要望(回答速度の向上、対象サービスの拡大)を集めています。回答の評価を記録し、外れた質問を文書の追加や切り方の見直しにつなげる担当と頻度を、導入時に決めておきます。
各段階の手順や、無料で試す方法は RAGの実装方法・構築手順ガイド と RAGの無料・低コスト実装ガイド で解説しています。
RAGの実装パターン比較:事例から見る選択基準
事例の構成をRAGの代表的なパターンに当てはめて整理します。表は一般的な分類で、事例との対応は次のとおりです。セゾンテクノロジーとクリエイティブ・ウェブはキーワード検索と意味検索を併用する「ハイブリッド」型、NTT西日本はメタデータで範囲を絞る構成、香川県は認証情報・ナレッジ・ログを庁内側に保持する構成にあたります。
| パターン名 | 構成上の特徴 | 主な採用ユースケース | 注意すべきトレードオフ |
|---|---|---|---|
| ナイーブRAG | クエリ→ベクトル検索→LLM生成の一本道 | PoC・小規模FAQ・社内Q&A | クエリと文書の表現ギャップに弱い |
| ハイブリッドRAG | ベクトル検索+BM25などスパース検索を統合 | 医療・法律・技術ドキュメント | スコアの統合方法(RRF等)に調整が必要 |
| 再ランキング付きRAG | 取得後にCross-Encoderで再スコアリング | 高精度が求められる業務系・コールセンター支援 | レイテンシが増加する |
| Agentic RAG | 複数ステップで検索・推論を繰り返す | 複雑な調査・多段階推論・規制文書対応 | コスト・デバッグ難易度が上がる |
| アクセス制御付きRAG | ユーザー属性でメタデータフィルタを動的適用 | 自治体・法務・金融の機密文書管理 | 権限モデルの設計ミスが情報漏洩に直結 |
| Graph RAG | ナレッジグラフで関係性ベースの検索 | エンティティ間関係が重要な調査・製薬 | グラフ構築コストが高く、小規模では過剰になりやすい |
各パターンの詳細な評価軸は RAG実装パターン比較ガイド で扱っています。
閲覧権限の設計と、ファインチューニングとの使い分け
事例を読んで次に浮かぶ疑問が、「部署ごとに見せてよい文書が違う場合はどうするか」と「追加学習(ファインチューニング)ではだめなのか」の2つです。公式の資料で確認できる範囲を整理します。
閲覧権限:検索の段階で、見てよい文書だけに絞る
Microsoft Learnの「Security Filter Pattern – Azure AI Search」には、文書ごとの閲覧権限を検索結果に反映する方法が書かれています。文書の登録時に、閲覧できるグループなどの識別子を専用の項目に保存しておき、検索のときに、質問した人が所属するグループの識別子で結果を絞り込みます。許可されていない文書は、検索結果にも回答の根拠にも出てきません。
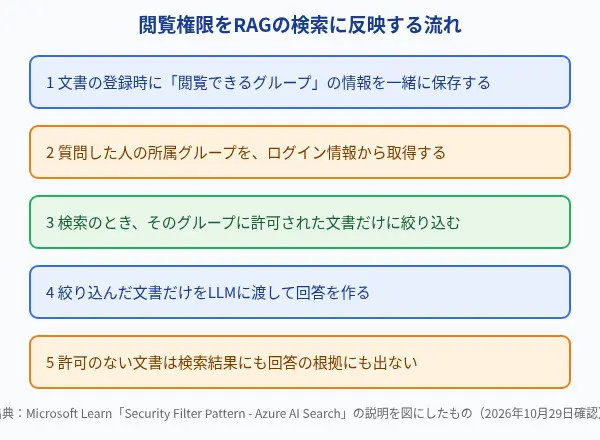
同じ資料には、この方法では識別子は検索の絞り込みに使う文字列にすぎず、利用者の認証や権限の確認そのものは別に行う必要があること、また、Azure AI Searchには組み込みのアクセス制御リスト(ACL)の機能もあることが書かれています。事例では、日本女子大学がMicrosoft Entra IDのセキュリティグループで利用権限を付与し、東京海上日動システムズが共通のアカウントでログを監視しています。
RAGとファインチューニングの違い
AWSの「検索拡張生成(RAG)とは」によると、組織固有のデータで基盤モデルを再学習させるには計算コストと金銭コストが高く、RAGはそれより費用対効果の高い方法とされています。比べやすいように整理します。
| 観点 | RAG | ファインチューニング(再学習) |
|---|---|---|
| 新しい情報の取り込み | 文書を更新すれば反映できる。再学習は不要 | モデルの再学習が必要 |
| 費用 | 再学習より安価な方法とされている | 計算コスト・金銭コストが高い |
| 回答の根拠 | 出典を付けられ、利用者が元の文書を確認できる | ー(確認した資料に記載なし) |
| 機密情報の扱い | 権限に応じて、検索できる情報を制限できる | ー(確認した資料に記載なし) |
社内の規程やマニュアルのように、更新が続く文書に答えさせる用途では、この表のとおり、事例の多くがRAGを選んでいます。
回答の評価:事例が測っていたもの
回答の良し悪しは、事例ごとに別の指標で見ています。セゾンテクノロジーは回答精度を従来構成と比較し、クリエイティブ・ウェブは初回解決率と平均対応時間を測り、NTT西日本は回答後に「解決した/していない」を聞いています。日本女子大学は、想定質問と回答の評価を実運用の前に行う計画を書いています。何を測るかは、導入前に決めておく項目です。
事例で報告されている課題と、取られた対処
公式ページには成功した数字だけでなく、つまずいた点も書かれています。ここでは公式資料に書かれていた課題と、取られた対処を整理します。
文書の登録単位で精度が変わる
香川県は、ファイル単位で登録すると回答精度が落ちるため、QA単位(規程は条項などの単位)に細分化して登録しています。セゾンテクノロジーは取得トークン数の制限で文脈が分断される問題があり、階層化チャンクで上位階層を取得して文脈を保つ構成にしました。
最初は精度が出ない
日本テレビ放送網は当初精度を出すのに苦労し、プロンプトの調整と、検索の前後でGeminiに分類させる処理で期待した精度を得ています。セゾンテクノロジーは、マネージドの検索サービスでは関係のない情報が混ざるなどの課題があり、検索の工程を自前で組みました。三菱重工業もAzure OpenAI Service on your dataを評価して望む結果が得られず、フルカスタマイズに進んでいます。
図表を含む文書
中外製薬は、図表が多い手順書を正しく認識できないことを最大の課題とし、マルチモーダルRAGの検証を続けています。表や図が多い文書を対象にする場合は、検索の前に取り込み方の検証が必要になることを示す事例です。
回答の根拠と、人への引き継ぎ
NTT西日本は、回答に関連マニュアルのページへのリンクを付け、解決しなかった場合はヘルプデスクに誘導する仕組みを入れています。利用者が回答を確かめられる導線を最初から作った例です。
ナレッジの網羅と重複
香川県は、QAナレッジは業務分野全体を網羅しつつ重複しない内容にする必要があり、特別な事例だけでなく当たり前のQAも用意すべきとしています。登録する側の運用負荷が、回答の品質を左右するという指摘です。
事例が示す、導入前の注意点
公式資料から、導入前に確認したい点を整理します。
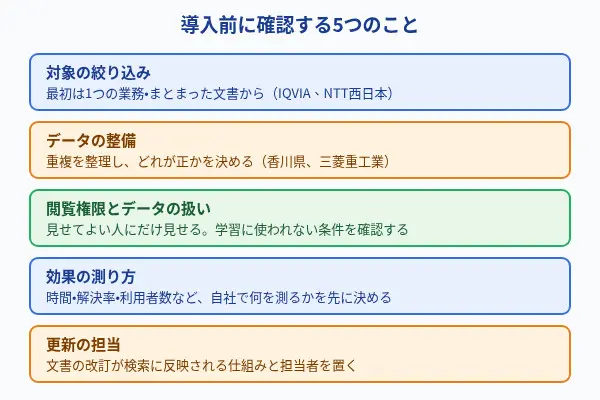
小さな範囲から始めている。IQVIAは担当者1名・約2ヶ月で、まとまったQ&Aファイルを対象に構築しています。NTT西日本は数週間のトライアルとアンケートを経ており、日本テレビ放送網も検索対象の文書は現時点で限定的です。
マネージドか自前かは、評価して決めている。IQVIAはマネージドのナレッジベースの手軽さを選び、セゾンテクノロジーと三菱重工業は評価の結果、より作り込んだ構成に進みました。どちらが正解というより、対象の文書で試した結果で決めています。
効果の測り方は事例ごとに違う。時間の削減、初回解決率、利用者数、アンケートの声など、測るものが異なります。数値が書かれていない事例も半数あり、他社の数字をそのまま自社の期待値にしないことが重要です。
費用の目安は公開されているものがある。セゾンテクノロジーの記事には、サポートエンジニアからの質問1,000件あたり30ドル以下と書かれています。香川県の資料では、職員開発の主な費用はAPI利用料のみとされる一方、外部サービスの利用には数千万円単位の費用が必要としています。
データ整備が土台になる。三菱重工業の事例では、社内データの整備が最も重要と説明されています。文書の整理と更新の担当を決めておくことが、検索精度の前提になります。
実装の進め方は RAGの実装方法・構築手順ガイド、無料・低コストで試す方法は RAGの無料・低コスト実装ガイド で解説しています。
まとめ:RAG 導入事例から導かれる設計原則
カスタマーサポート、自治体、社内ナレッジ、製薬、金融と、業務ごとに制約は違いますが、公式に公開された事例に共通するのは、LLMの回答を社内の文書という根拠に結びつけ、その文書の切り方・検索の方法・根拠の見せ方を業務に合わせて作り込んでいる点です。総務省の調査でも、自治体が導入しているカスタマイズ方法はRAGが244件で最多でした。
効果の数値が公開されている事例は、時間の削減、解決率、利用者数など測るものがそれぞれ異なります。まずは対象の文書を絞って試し、自分たちの業務で何を測るかを決めてから広げるのが、事例から読み取れる進め方です。実装パターンの比較は RAG比較ガイド をご覧ください。
AIの業務活用・導入をご検討の方へ
クリスタルメソッドは、LLM・RAG・AIアバターを活用した業務へのAI導入を支援しています。自社の課題にどう活かせるか、まずはお気軽にご相談ください。
参考文献
- 総務省「自治体における生成AI導入状況」(令和7年6月30日版、PDF)
https://www.soumu.go.jp/main_content/001018084.pdf - 総務省に掲載された香川県の資料「香川県での生成AI活用の取組」(令和7年3月、PDF)
https://www.soumu.go.jp/main_content/000997286.pdf - AWS公式ブログ「セゾンテクノロジー様の AWS 生成 AI 事例」(2024年7月8日)
https://aws.amazon.com/jp/blogs/news/gen-ai-usecase-saison-technology/ - AWS公式ブログ「株式会社クリエイティブ・ウェブ様の AWS 生成 AI 事例」(2025年10月22日)
https://aws.amazon.com/jp/blogs/news/genai-case-study-creative-web/ - AWS公式ブログ「NTT西日本の AWS 事例:Amazon Bedrock Knowledge Bases を活用した営業支援 AI ボットの開発」(2025年11月20日)
https://aws.amazon.com/jp/blogs/news/aws-genai-usecases-nttwest-elgana-rag/ - AWS公式ブログ「IQVIAサービシーズ ジャパン合同会社 の AWS 生成 AI 事例」(2024年11月13日)
https://aws.amazon.com/jp/blogs/news/genai-usecase-iqvia-serviceis/ - Microsoft「金融機関向け AI Transformation セミナーレポート」(2024年3月1日)
https://www.microsoft.com/ja-jp/microsoft-cloud/blog/financial-services/2024/03/01/1206-aoai-seminar-for-financial-services-report/ - AWS公式ブログ「東京海上日動システムズ株式会社様の AWS 生成 AI 事例」(2025年11月28日)
https://aws.amazon.com/jp/blogs/news/genai-case-study-tmn-systems-3/ - Google Cloud「日本テレビ放送網株式会社 の導入事例」
https://cloud.google.com/customers/intl/ja-jp/ntv-genai?hl=ja - Google Cloud公式ブログ「中外製薬: RAG を用いた文書検索や人財育成、メディカル ライティングなどに生成 AI を活用」(2025年3月13日)
https://cloud.google.com/blog/ja/topics/customers/chugai-pharm-generating-ai-to-drive-operational-efficiency-and-value-creation?hl=ja - AWS公式ブログ「製造業における技能継承への生成AI・音声・映像の活用とサンプルソースのご紹介」(2024年11月11日)
https://aws.amazon.com/jp/blogs/news/published-knowledge-transfer-by-genai-sample-source/ - 日本女子大学「検索拡張生成(RAG)で実現する生成AI型チャットボット導入に向けた取組」(PDF)
日本女子大学の取り組み報告(PDF) - AWS「検索拡張生成(RAG)とは」
https://aws.amazon.com/what-is/retrieval-augmented-generation/ - Microsoft Learn「Security Filter Pattern – Azure AI Search」
https://learn.microsoft.com/en-us/azure/search/search-security-trimming-for-azure-search - Microsoft「三菱重工業 Azure OpenAI Service を活用した独自アーキテクチャ構築」導入事例
https://www.microsoft.com/ja-jp/customers/story/1772636025129504407-mhi-azure-openai-service-discrete-manufacturing-ja-japan - NTTデータ「金融機関向けの融資稟議書作成AIサービスをあいち銀行に提供決定」(2026年7月9日)
https://www.nttdata.com/global/ja/news/topics/2026/070901 - AWS公式ブログ「日立パワーソリューションズ」生成AIで保守知識を共有(2024年9月25日)
https://aws.amazon.com/jp/blogs/news/hitachi-power-solutions-genai/ - AWS導入事例「ヤンマーホールディングス」
https://aws.amazon.com/jp/solutions/case-studies/yanmar-case-study/ - 常陽銀行「生成AI『ChatGPT』のバージョンアップおよびRAGを活用した『営業ソリューション検索サービス』の取り扱い開始について」(2025年9月18日)
https://prtimes.jp/main/html/rd/p/000000033.000081984.html - 日本IBM「横浜銀行の生成AIを活用した融資審査業務における稟議書作成の実証実験」(2024年11月7日)
https://jp.newsroom.ibm.com/2024-11-07-Bank-of-Yokohama-PoC-of-loan-approval-documents-using-generative-AI - 日本IBM「宮崎銀行と日本IBM、融資業務における生成AIの活用を開始」(2024年6月13日)
https://jp.newsroom.ibm.com/2024-06-13-Miyazaki-Bank-and-IBM-Japan-begin-using-generative-AI-in-loan-operations - AWS公式ブログ「KDDIアジャイル開発センターの AWS 生成 AI 事例:Amazon Bedrock で営業活動をサポート」(2024年9月6日)
https://aws.amazon.com/jp/blogs/news/aws-genai-usecases-kddi-agile-minutes/ - AWS公式ブログ「ITbook 株式会社様のAWS 生成 AI 活用事例」(2026年7月1日)
https://aws.amazon.com/jp/blogs/news/case-study-genai-itbook/
上記は2026年10月29日に確認しました。
Read next
あわせて読みたい
-
RAG比較2026年版——タイプ別の選び方とサービス比較・技術アーキテクチャ完全ガイド
「RAGを導入したいが、どのサービスを選べばよいか分からない」——多くの企業担当者が最初にぶつかるのはこの疑問だ。RAG(Retrieval-Augmented...
-
RAGとは?仕組みと実装方法を7工程で解説
RAG(Retrieval-Augmented Generation)の基本概念や定義については RAGとは何か――基本概念と全体像 を先に参照されたい。本記事...
-
RAG(検索拡張生成)は無料で作れる?無料ツールの選び方と構築手順【2026年版】
RAG(検索拡張生成)は、無料で作れます。コードを書かずに試すなら Google NotebookLM、アプリとして形にするなら Dify、機密資料を外に出さず...