
blog
AIブログ
画像生成AIとは?仕組み・種類・できること・著作権の注意点をわかりやすく解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
画像生成AIとは、文章(プロンプト)や参考画像を入力すると、AIが新しい画像を自動でつくり出す技術です。大量の画像とその説明文を学習したAIが、学んだ特徴をもとに「これまで存在しなかった画像」を一から描き起こします。現在の主流は、ノイズを少しずつ取り除いて画像に仕上げる「拡散モデル」という仕組みです。
この記事では、画像生成AIの仕組み・種類・できること・著作権と商用利用の注意点・始め方を、初めての方向けに順を追って説明します。サービスごとの違いを比べたい方は画像生成AI 比較ガイド、実際の操作手順は画像生成AIの使い方ガイド、料金は画像生成AIの料金ガイドをご覧ください。サービスの名称・条件は、2026年10月に各社の公式ページで確認した内容です。
画像生成AIとは――定義と基本的な仕組み
画像生成AIとは、機械学習モデルが大量の画像データを学習し、新しい画像を生成する人工知能技術の総称です。単なる画像の検索や加工ではなく、学習したパターンをもとに「存在しなかった画像」をゼロから作り出す点が最大の特徴です。
生成の仕組み(種類)は、大きく次の3つに分けられます。
ノイズから少しずつ画像を復元する逆拡散プロセスで生成。Stable Diffusionなどが代表例で、現在の主流です。
「生成器」と「識別器」が競い合いながら品質を高めます。StyleGANが有名。リアルな顔生成に強みを持ちます。
画像を潜在空間に圧縮し、そこから再構成して生成。他モデルの補助技術としても広く使われます。
拡散モデルの動作フロー
現在最も普及している拡散モデルの処理の流れを示します。
プロンプトを
テキストエンコーダで
ベクトル化
ランダムノイズを
初期状態として
用意
U-Netが段階的に
ノイズを除去し
形状を復元
潜在空間から
ピクセル画像へ
変換・出力
重要なのは「潜在空間(Latent Space)」の概念です。Stable Diffusionなどの潜在拡散モデルは、ピクセル空間ではなく圧縮された潜在空間上で拡散処理を行うため、計算コストを大幅に抑えながら高品質な画像を生成できます。
プロンプトとクロスアテンション
テキストを画像に反映するカギがクロスアテンション機構です。CLIPなどのテキストエンコーダが言語を意味ベクトルに変換し、U-Netの各層にそのベクトルを注入することで、「青空の下に立つ白い建物」といった指示を画素レベルで反映できます。プロンプトの書き方(プロンプトエンジニアリング)が出力品質に直結するのはこの仕組みによるものです。
関連記事画像生成AIの料金は1枚いくら?無料枠と比較 / 画像生成AIの使い方はツールごとにどう違う?
拡散モデルはなぜ「ノイズ」から絵を描けるのか
いまの画像生成AIの中心にある拡散モデル(Diffusion Model)は、「きれいな画像に少しずつノイズを足していく過程」を逆再生することで絵を作ります。初心者が最もつまずくのは、なぜ砂嵐のようなノイズから狙った絵が現れるのかという点です。そこでこの記事では、拡散モデルの動きを工程として分解し、直感的に理解できるようにします。
学習フェーズ:わざと画像を壊して「戻し方」を覚える
- 順方向(ノイズ付加):学習時に、元画像へ段階的にランダムなノイズを加え、最終的にほぼ完全な砂嵐にします。壊す手順は決まっているので「正解の戻し方」が分かります。
- 逆方向(ノイズ除去):AIは各段階で「いまの画像からどれだけノイズを引けば1つ前の状態に戻るか」を予測できるように訓練されます。
- 結果として、完全なノイズを渡しても、少しずつノイズを引き算して画像を復元できるようになります。これが「生成」の正体です。
なぜ「言葉」で狙った絵が出るのか
ノイズを引くだけなら、なんとなくの絵しか出ません。そこでプロンプト(テキスト)を数値の並び(埋め込み)に変換し、ノイズ除去の各ステップへ「この方向に寄せろ」という条件として与えます。AIは「猫」という条件に沿う形で毎回わずかにノイズを引くため、最終的に猫らしい画像へ収束します。同じ文章でも仕上がりが毎回変わるのは、出発点のノイズが乱数で異なるからです。Stable Diffusionをはじめとする一部の主要モデルは、画像そのものではなく圧縮した「潜在空間」でこの計算を行います。処理を軽くして生成を速くするための工夫ですが、モデルによっては画像空間(ピクセル空間)で直接ノイズ除去を行う方式もあり、すべての拡散モデルに共通する仕組みというわけではありません。
拡散モデルと旧来手法の発想の違い
| 観点 | 拡散モデル | GAN(旧来型の発想) |
|---|---|---|
| 作り方 | ノイズを段階的に除去して近づける | 一発で生成し、本物かを見分ける役と競わせる |
| 学習の安定性 | 比較的安定させやすい | バランスが崩れやすく調整が難しい |
| 途中での操作 | ステップ途中で条件を効かせやすい | 途中に介入しにくい |
この「少しずつ直す」という発想を押さえておくと、後述する得意・不得意や、生成が揺らぐ理由も自然に理解できます。
次に読む:画像生成AIのおすすめはどれ?9サービスを比較
仕組みから見た、画像生成AIの向き・不向き
「絵が描けるAI」と聞くとイラスト制作を思い浮かべがちですが、拡散モデルは“それらしい画像を確率的に量産する”という性質を持つため、実務では試作・検討段階の可視化で幅広く使われています。どの業界でどう使われているかは後述の「産業別の活用事例」にまとめたので、ここでは仕組みから来る向き・不向きに絞って説明します。
仕組み上、まだ苦手なこと
拡散モデルは「確率的にそれらしく仕上げる」ため、次のような“厳密さ”を求める場面では崩れやすくなります。これは欠陥というより、生成の仕組みから来る性質ですが、精度はモデルや世代によって差があるため、最新の状況は利用するツールの公式情報で確認してください。
- 正確な文字:ロゴや看板など細かな文字は崩れやすい傾向があります。文字を「意味」ではなく「形の並び」として扱う仕組みに起因するもので、特に旧世代のモデルで顕著です。近年のモデルでは改善が進んでいるものもありますが、確実に正確な文字が出る保証はありません。
- 手指・本数の整合:指の本数や左右対称など、厳密な数を保つのは従来から苦手とされてきました。近年のモデルでは改善が進んでいるものもありますが、依然として崩れが生じることがあります。
- 同一対象の一貫性:同じキャラクターや商品を、別カットで完全一致させにくい傾向があります。
- 寸法・図面の正しさ:見た目が整っていても、実寸や設計としての正確さは保証されません。
だから、どう使うと外さないか
- 「決定稿」よりもアイデア出し・叩き台として使います。
- 正確さが要る部分(文字・寸法・ブランドロゴ)は人が最終仕上げする前提にします。
- 領域ごとに「どこまでAI・どこから人」の線引きをあらかじめ決めておきます。
仕組みの得意・不得意を先に知っておくと、ツール選びや作り方の学習に進んだときも、期待とのズレを避けられます。
画像生成AIでできること――主な活用方法
画像生成AIの機能は「テキストから画像を作る」だけにとどまりません。現在の主要機能を整理すると、以下の通りです。
- テキスト→画像(txt2img):最も基本的な機能です。プロンプトを入力するだけで画像を生成します。
- 画像→画像(img2img):参照画像をもとに構図・色調を維持しながら別スタイルに変換。
- インペインティング:画像の一部をマスクして、その部分だけ生成・修正します。不要物の除去や背景変更に有効。
- アウトペインティング:既存画像の外側を拡張して生成。画角変更やワイドスクリーン化に利用。
- ControlNet(条件付き生成):ポーズ・輪郭・デプスマップなど構造情報を与えてレイアウトを制御。
- 超解像(Upscaling):生成した画像を高解像度に拡大しディテールを補完。
- 画像から動画(img2vid):静止画を入力として短い動画クリップを生成。動画生成AIという別ジャンルのサービスで提供されています。
実際に生成してみた例
下の画像は、この記事のために2026年10月14日にOpenAIの画像生成API(gpt-image-1)で実際に生成したものです。最新のモデルではありません(最新の名称は前の節の表を参照してください)が、「文章から画像をつくる」「できた画像を文章で直す」という基本の動きは同じです。
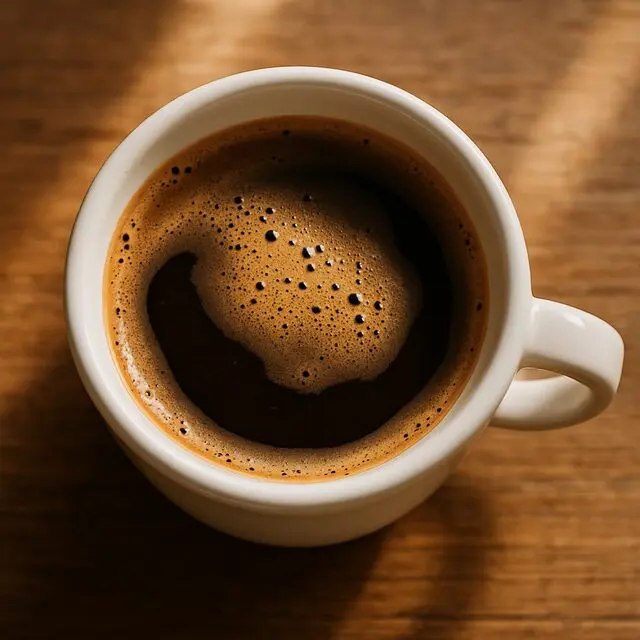
A close-up of a white ceramic coffee cup on a wooden table, soft natural light, photorealistic, shallow depth of field, overhead view
動画・画像生成AIの業務活用をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
産業別の活用事例
画像生成AIは特定業界のニッチな技術ではなく、多くの産業で具体的な業務変革をもたらしています。
| 業界 | 活用例 | 得られる効果 |
|---|---|---|
| 広告・マーケティング | バナー・SNS投稿用ビジュアル、A/Bテスト用クリエイティブの大量生成 | 制作コスト・期間を大幅削減 |
| ゲーム・エンタメ | キャラクターデザイン、背景アート、コンセプトアート量産 | 開発サイクル短縮、世界観の試作コスト低減 |
| ファッション・EC | 商品着用イメージ、バーチャル試着、パターンデザイン生成 | 撮影コスト削減、カラー展開の即時視覚化 |
| 建築・インテリア | 外観パース、インテリアイメージのラフ提案 | クライアントへの早期ビジュアル提示 |
| 医療・製薬 | 医療画像の合成データ生成による学習データ拡張 | 診断AIのトレーニングデータ不足を補完 |
| 出版・メディア | 書籍表紙、記事のアイキャッチ、イラスト素材 | ストック素材費用の削減 |
| バーチャルヒューマン・XR | 仮想キャラクターの外観生成、メタバース用アバター素材 | 3Dモデリングコストの削減と表現の多様化 |
バーチャルヒューマンの制作でも、キャラクターの表情・服装・背景などのビジュアル素材を画像生成AIで高速試作し、3Dモデルへの落とし込み前に多数のデザイン案を比較するワークフローが広がっています。
代表的な画像生成AIサービスと、選ぶときの見方
画像生成AIは、サービスごとに得意なことと利用条件が違います。ここでは2026年10月時点で公式ページを確認できた代表的なサービスを、「どんな種類があるか」を知るための範囲で紹介します。性能・料金・画質の細かな比較は画像生成AI 比較ガイドで扱っています。
| サービス/モデル | 提供元 | 公式で確認できた特徴 | 商用利用についての公式の記載 |
|---|---|---|---|
| Stable Diffusion 3.5 | Stability AI | モデルを自分の環境に導入して使える形で提供されています。 | Communityライセンスは年間売上が1M米ドル未満なら無料で商用利用でき、超える場合はEnterpriseライセンスが必要です。非商用は無料です。 |
| Midjourney V8.2 | Midjourney | 公式ドキュメントで現在の標準バージョンとされています(2026年7月24日から)。Discordまたはウェブから利用します。 | 有料プラン(月額10〜120米ドル)で、作った画像は利用者のものとされています。年間売上100万米ドルを超える企業が会社として商用利用する場合は、ProまたはMegaプランが必要です。 |
| GPT-Image-2.5(Sunburst/Flare) | OpenAI | APIで文章から画像を作る・編集できます。Sunburstは編集の精度を重視、Flareは速さと日常用途向けと説明されています。 | この公式ガイドのページには記載がありません。利用規約で確認してください。 |
| Nano Banana 2.1 | Geminiの画像生成・編集のモデルです。以前のImagenは、公式ドキュメントでは提供終了と案内されています。 | この公式ページには記載がありません。利用するプランの規約で確認してください。 | |
| Adobe Firefly | Adobe | Adobe独自のモデルは、Adobe Stockなどのライセンス済みコンテンツと、著作権の切れた公有コンテンツで学習したと説明されています。Google・OpenAIなど他社のモデルも選べます。 | ベータ表示のない機能の生成物は商用プロジェクトで使えるとされ、対象プランでは知的財産の補償もあります(条件あり)。「商用でも安全」とされるのはAdobe独自のモデルです。 |
| FLUX.2 [dev] | Black Forest Labs | 32Bパラメータのオープンウェイト(重みを公開)のモデルです。 | モデルの重みの利用は非商用ライセンスで、商用利用には別のライセンスが必要です。生成物は商用を含めて使えると明記されています。 |
確認日:2026年10月14日。各社の公式ページ(OpenAI・Google・Stability AI・Black Forest Labs・Adobe・Midjourney)で読んだ内容で、料金や規約は変わることがあります。
ファインチューニングとLoRA
既存モデルをベースに特定のスタイルや被写体を学習させる手法がファインチューニングです。特にLoRA(Low-Rank Adaptation)は少量のデータと低コストで追加学習できるため、企業がブランドイメージに合わせたモデルを構築する際に広く採用されています。自社キャラクターや商品の外観を学習させ、一貫したビジュアルを量産するといった用途が代表的です。
目的別に詳しく読む――この記事の次に開くページ
この記事は「画像生成AIとは何か」を全体像でつかむためのページです。次に知りたいことが決まったら、目的に合うページへ進んでください。
- どのサービスを選ぶか比べたい:画像生成AI比較ガイド(主要サービスの無料枠・料金・商用利用を表で比較)
- まず無料で試したい:画像生成AI 無料のおすすめ(無料枠の違いと、実際に無料で生成した画面)
- 無料のサイトを見比べたい:画像生成AIの無料サイト比較(ChatGPT・Gemini・Canva・Fireflyなど)
- 料金を知りたい:画像生成AIの料金ガイド
- 操作手順を見たい:画像生成AIの使い方ガイド
画像生成AIのメリットと限界
技術を正しく活用するには、強みだけでなく限界も理解しておく必要があります。
主なメリット
- 制作コストと時間の大幅削減:デザイナーに依頼すると費用と日数がかかる下書きの作業が、数秒から数分で形になることがあります。
- アイデアの高速試作:複数のスタイルや構図を短時間で比較・検討でき、クリエイティブの意思決定が加速します。
- スケーラビリティ:同一品質の画像を大量に生成できるため、A/Bテスト用クリエイティブや多言語展開のビジュアルを一括生成可能。
- 非専門家でも利用可能:テキスト入力のみで高品質な画像が得られるため、デザインスキルがなくても活用できます。
- 個人化・カスタマイズ:LoRAや特定スタイルの学習により、ブランドに合った一貫したビジュアルを量産できます。
現時点での主な限界・課題
- 細部の精度:手指の本数や文字の描写、複雑な構造物の整合性が崩れることがある(改善は急速だが完全ではない)。
- 著作権・学習データの問題:学習に使用された画像の権利関係が不透明なモデルも存在し、生成物の著作権帰属についても法整備が追いついていません。
- 出力の不確定性:同じプロンプトでも毎回異なる結果が生成されるため、厳密な再現性が求められる用途には工夫が必要。
- プロンプト依存性:意図した画像を得るには適切なプロンプト設計が必要で、習熟に時間がかかる場合があります。
- 計算リソース:ローカルで高品質な生成を行う場合、GPU性能が要求されます。クラウドAPIを使う場合はコストが発生します。
画像生成AIを「使う/使わない」を先に決める――向く場面・向かない場面
ツールを比べる前に、そもそもその作業が画像生成AIに向いているかを見極めると失敗が減ります。生成AIは「一意の正解が無く、量とバリエーションが要る」用途で強く、「事実の再現性が絶対」の用途では弱いのが基本的な傾向です。下の早見で当たりを付けてから、具体的なサービス選定に進んでください。
画像生成AIが向く場面
- アイデア出し・ラフの量産――バナーやLPのビジュアル案、ムードボードなど、複数案を短時間で並べて比較検討したいとき。
- 実在しない汎用ビジュアル――抽象イメージ、背景、コンセプトアートなど、特定の人物・製品・ロゴを厳密に再現しなくてよいとき。
- 素材コストを抑えたい社内・下書き用途――企画書や検証用モックのように、最終公開前の叩き台として使うとき。
画像生成AIが向かない場面
- 事実・正確さが問われる図版――製品の実物写真、正確な人体・文字・図解・地図など、細部の再現性が求められるとき(指や文字が崩れやすい弱点が出やすい)。
- 実在の人物・ブランドの再現――特定個人の肖像や他社ロゴを模す用途は、権利・炎上リスクが高く避けるべきとき。
- 権利関係を厳密に説明する必要がある納品物――学習データや商用利用条件の説明責任が重い案件では、素材の由来が追える手段のほうが安全なとき。
用途別の選び方――押さえるべき4つの軸
向いていると判断できたら、次の4軸で候補を絞ると比較が速くなります。
| 選び方の軸 | 確認するポイント | 重く効く用途 |
|---|---|---|
| 商用利用の可否 | 生成物を業務・販売に使える利用規約か、有料/無料でライセンスが変わらないか | 広告・販促・受託制作 |
| 制御性・再現性 | 構図やスタイルを指定・固定できるか、同じ雰囲気を再現しやすいか | ブランド統一・シリーズ制作 |
| 編集の柔軟さ | 部分修正(インペイント)や既存画像の加工に対応するか | 既存素材の手直し・合成 |
| 導入のしやすさ | ブラウザ完結か、学習コスト・日本語対応・チーム共有のしやすさ | 非デザイナー・社内展開 |
「まず案を大量に出したい」なら制御性より速さと手軽さを、「ブランドの世界観を崩したくない」なら制御性と商用利用条件を優先する、というように、用途ごとに軸の重みを変えるのが実務的な選び方です。各サービスの具体的な違いは本記事の比較表もあわせて確認してください。
画像生成AIの著作権・商用利用・倫理の注意点
技術の急速な普及に伴い、倫理的・法的な論点も複雑化しています。利用者として最低限押さえるべき論点を整理します。
著作権問題
日本では、文化庁が2024年(令和6年)3月に「AIと著作権に関する考え方について」を取りまとめ、同年7月には「AIと著作権に関するチェックリスト&ガイダンス」も公表しています(いずれも文化庁の公式ページで公開されています)。この資料では、AIで作った画像が既存の著作物と似ていて著作権侵害になるかどうかは、従来と同じく「類似性」(創作的な表現が共通しているか)と「依拠性」(既存の著作物をもとにしたといえるか)で考えるとされています。利用者が既存の作品を知っていて、それに似せるように指示して作った場合は依拠性が認められやすく、知らないうちに似てしまった場合の扱いも整理されています。ただし、これは文化庁の考え方であって法的拘束力のある解釈ではなく、個別の判断は裁判所が行います。海外では、学習データの扱いをめぐる訴訟も起きています。
商用利用のとき、最初に確認すること
作った画像を仕事や販売に使えるかどうかは、サービスごとの利用規約・ライセンスで決まります。公式ページで確認できた例を挙げると、Stable Diffusion 3.5はCommunityライセンスで「年間売上1M米ドル未満なら商用も無料」、FLUX.2 [dev]はモデルの重みが非商用ライセンス、Midjourneyは年間売上100万米ドルを超える企業が会社として商用利用するにはProまたはMegaプランが必要です。同じ「画像生成AI」でも条件が違うため、使う前に次の点を確認してください。
- 商用利用が認められているか(無料プランと有料プランで条件が違わないか)
- 自社や自分の売上規模による条件がないか
- 生成物の権利が誰に帰属すると書かれているか
- 学習データの出どころがどう説明されているか(Adobe Fireflyのように、公式が説明しているサービスもあります)
- 実在の人物・他社のロゴ・既存のキャラクターに似せていないか

ディープフェイクと悪用リスク
画像生成AIは、実在人物に似せた偽画像(ディープフェイク)の生成に悪用されるリスクを持ちます。非合意の成人向けコンテンツ、政治的なフェイク情報、なりすまし詐欺などへの応用が社会問題化しており、EUのAI規則(AI Act)をはじめ、規制の整備が各地で進んでいます。多くのサービスが利用規約やコンテンツポリシーで実在人物の模倣などを制限しており、生成した画像にC2PA(Content Credentials)などの来歴情報を付ける取り組みも広がっています(GoogleのNano Banana 2.1の公式ドキュメントにも、C2PAのコンテンツクレデンシャルが機能として載っています)。
バイアスと多様性
学習データに含まれる社会的バイアスが生成画像に反映される問題も指摘されています。「医師」と入力すると特定の人種・性別の画像が多く生成されるといった事例がその典型です。モデル開発者は学習データの多様化やフィルタリングで改善を進めていますが、利用者側も出力を無批判に使用しないリテラシーが求められます。
クリエイターへの影響
イラストレーター、写真家、グラフィックデザイナーなどのクリエイターの仕事への影響は現実的な課題です。一方で「AIが下案を出し、人間が方向性を決めてブラッシュアップする」協働モデルが定着しつつあり、AIを使いこなす新しいスキルセットを持つクリエイターの需要が生まれています。代替と協働の両側面が同時に進行している状況です。
画像生成AIの始め方――最初の1枚をつくる流れ
初めて画像生成AIを業務や個人制作に取り入れるときの流れは、次の4ステップです。具体的な操作画面はサービスごとに違うため、ここでは共通する考え方と、確認すべき公式ページを示します(個別の操作手順は使い方ガイドで説明しています)。
- 目的を決める:何に使う画像かを先に決めます(アイデア出しの下書きか、公開する素材か)。公開する素材なら、商用利用の条件を最初に確認します。
- サービスを選ぶ:下の表と比較ガイドを見て、候補を絞ります。無料で試せるサービスは画像生成AIの無料ガイドにまとめています。
- プロンプトを書いて生成する:下の「効果的なプロンプトの書き方」の5つの要素を入れ、1回で決めようとせず、数枚つくって比べながら言葉を足したり削ったりします。
- 確認してから使う:手指・文字の崩れ、実在の人物やロゴに似ていないかを確認し、必要なら修正してから使います。
指示の書き方で、結果はこう変わる(実際に生成した例)
同じ「コーヒーカップ」でも、指示の書き方で仕上がりが変わります。次の3枚は、2026年10月14日にOpenAIの画像生成API(gpt-image-1)で実際に生成したものです。短い指示でも画像は出ますが、構図・光・画風まで決めたいときは指示に書き込みます。
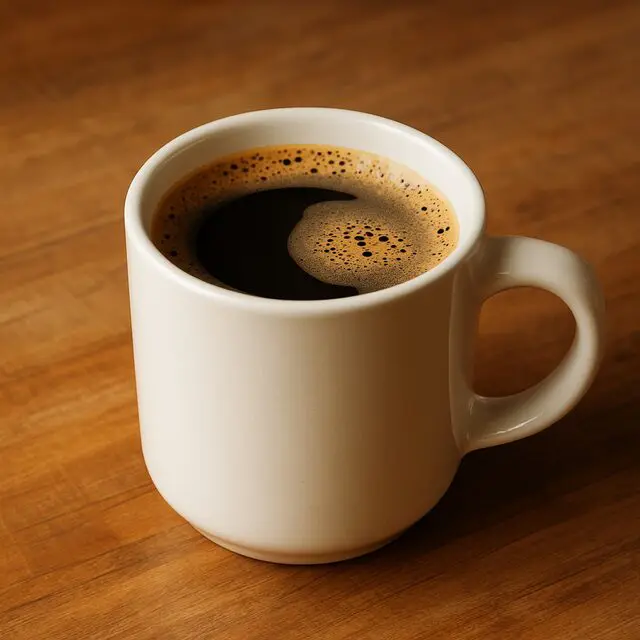
a coffee cup。カップの向きや光は、AIが決めていますA close-up of a white ceramic coffee cup on a wooden table, soft natural light, photorealistic, shallow depth of field, overhead view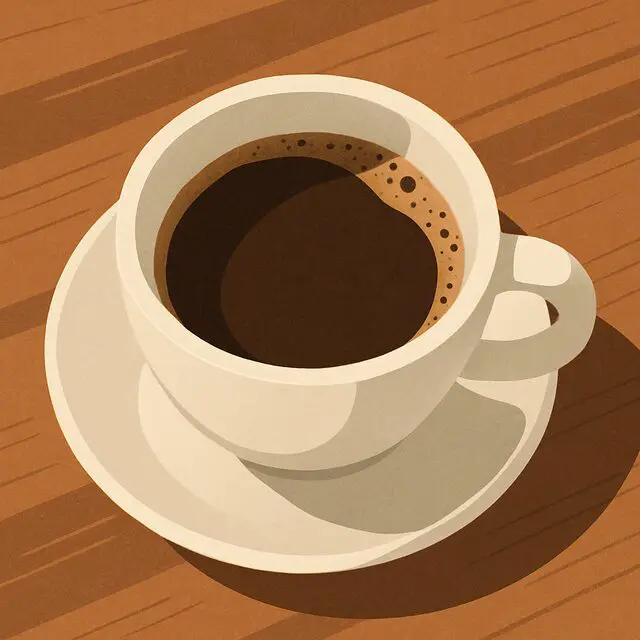
flat illustration style, simple shapes に変えた指示。構図の指定はそのままで、写真がイラストになりましたツール選択の基準
目的に応じたツール選択が最初のステップです。
| 目的 | 推奨ツールの方向性 |
|---|---|
| 商用利用の安全性を最優先 | Adobe Firefly(Adobe独自のモデル)など、学習データと商用利用の条件を公式が説明しているサービス |
| 芸術的・クリエイティブな表現 | Midjourneyなど、画の雰囲気づくりを重視するサービス |
| カスタマイズ・ローカル実行 | Stable Diffusion 3.5やFLUX.2のように、モデルが公開されているもの(ライセンスの条件は要確認) |
| テキスト指示への忠実な生成 | OpenAIのGPT-Image-2.5、GoogleのNano Banana 2.1など、大手各社の最新の画像生成モデル |
| 既存ツールとの統合 | Adobe Firefly(Photoshop統合)、API経由の組み込み |
効果的なプロンプトの書き方
プロンプトの品質が出力を左右します。基本的な構成要素として以下を意識すると、意図に近い画像が得られます。
- 被写体:何を生成したいかを具体的に(「A close-up of a white ceramic coffee cup」など)。
- スタイル・画風:「oil painting」「photorealistic」「flat illustration」「anime style」など。
- 照明・色調:「golden hour lighting」「soft natural light」「high contrast」など。
- 構図・視点:「overhead view」「wide angle」「portrait orientation」など。
- ネガティブプロンプト:含めたくない要素(「blurry, text, watermark, low quality」など)を明示。
日本語で指示できるサービスは増えています。まず日本語で試し、思いどおりにならないときは表現を具体的にしてみてください(サービスによっては、英語のほうが安定することもあります)。
思いどおりにならないときの直し方(よくある失敗と対処)
初めて使うと、1回目で理想の画像が出ないことのほうが普通です。多くの場合は、次のように指示を足したり、構図を変えたりして直せます。
| うまくいかないとき | 直し方 |
|---|---|
| 文字が崩れる・読めない | 画像の中に入れる文字を短くし、画像に入れたい語を「」で明示します。それでも崩れるときは、文字なしで生成して、文字は後からデザインツールで重ねます。 |
| 手指・小物の形がおかしい | 手を大きく写さない構図(引きの構図・後ろ姿・物で隠れる角度)に変えるか、崩れた部分だけをインペインティングで作り直します。 |
| 狙った構図にならない | 「真上から」「横から」「中央に1つだけ」のように、視点と配置を指示に足します。1回で決めず、数枚つくって近いものを選びます。 |
| 雰囲気が思っていたのと違う | 画風(写真風・水彩・イラスト)と光(朝の光・夕方・曇り)を言葉で指定します。下の作例のように、画風の語だけを入れ替えて比べると違いが分かります。 |
| 人物・ロゴ・キャラクターに似てしまう | 実在の人物・他社のロゴ・既存のキャラクターに似せる指示は避けます。似ていないかを必ず目で確認してから使います(著作権の節を参照)。 |
| 同じ指示でも毎回変わる | 出発点のノイズが毎回違うためです(仕組みの節を参照)。気に入った1枚が出たら、その画像を元に「ここだけ変えて」と文章で直します。 |
画風の言葉を変えると、同じ場面がこう変わる(実際に生成した作例)
次の4枚は、同じ場面(朝のパン屋の外観)の指示を共通にして、画風の語だけを入れ替え、2026年10月19日にgpt-image-2.5(API名 gpt-image-2.5-flare)で生成したものです。共通の指示は A small bakery storefront on a quiet street at sunrise, wooden door, bread on display in the window, no text, no signs, no people で、各画像の下に末尾の画風の指示を載せています。構図は毎回少しずつ変わりますが、画風の語を入れ替えるだけで仕上がりの方向がはっきり変わることが分かります。
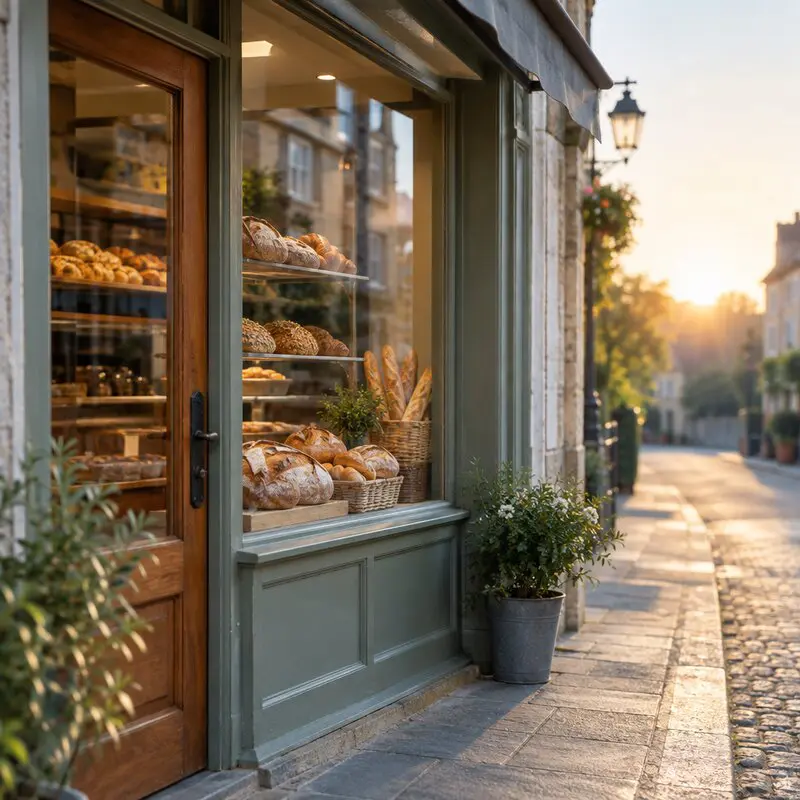
photorealistic photograph, soft morning light, shallow depth of field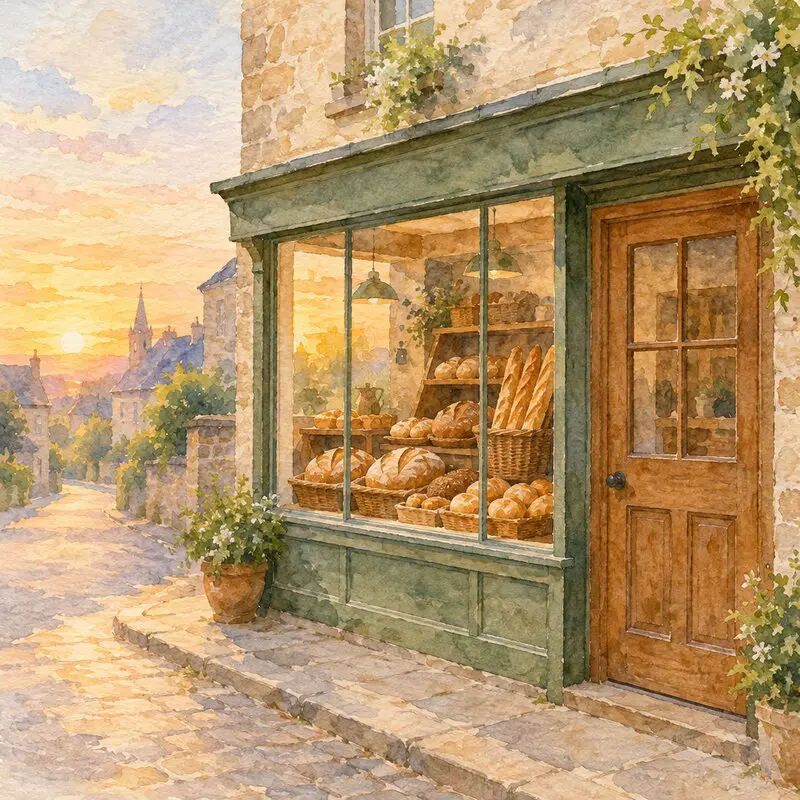
watercolor painting, soft washes of color, visible paper texture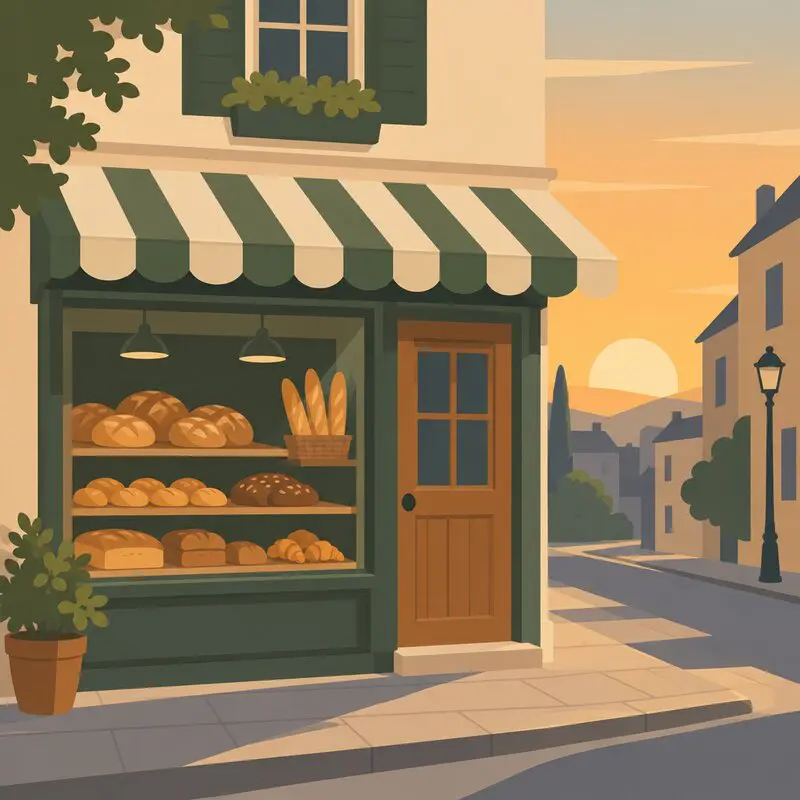
flat illustration style, simple shapes, limited color palette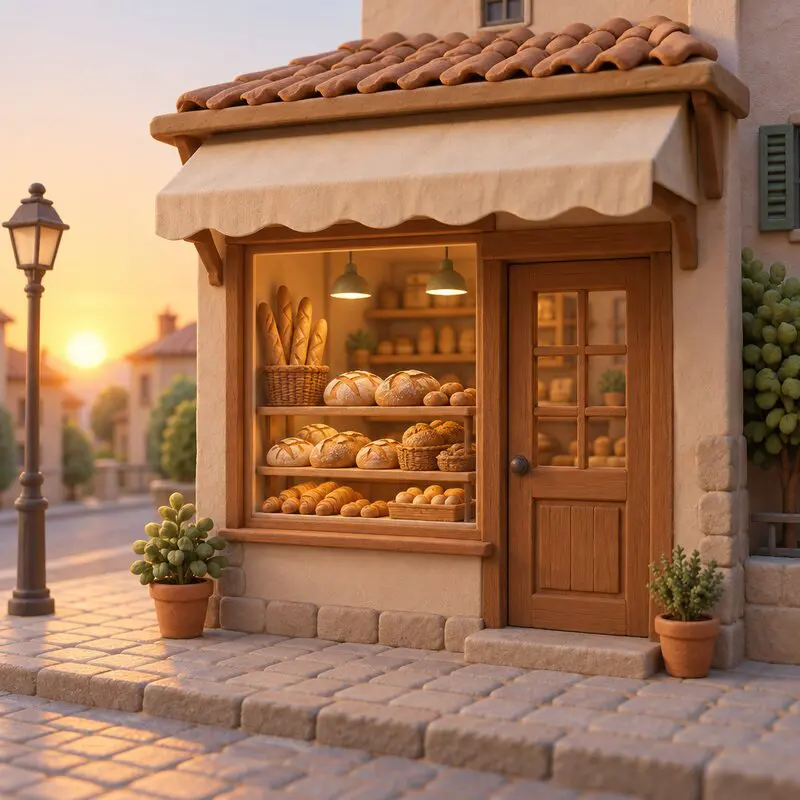
3D clay render, soft studio lighting, miniature diorama look生成画像の品質チェックと修正
生成された画像をそのまま使用するのではなく、手や文字などの細部を確認し、必要に応じてインペインティングや人間のデザイナーによる修正を組み合わせることが実務上のベストプラクティスです。完全にAIに任せるのではなく、人間の確認・編集が入った「ヒューマン・イン・ザ・ループ」のワークフローを組むことで品質と安全性を担保できます。
今後の技術トレンドと展望
画像生成AIの技術進化は2026年以降も継続しており、以下のトレンドに注目が集まっています。
- マルチモーダル統合:テキスト・画像・音声・動画を統合的に扱うモデルが主流化し、「画像生成AI」と「動画生成AI」の境界が曖昧になりつつあります。
- リアルタイム生成:StreamDiffusionなど低レイテンシ技術の進化により、インタラクティブなリアルタイム画像生成がXR・ゲーム分野で実用化段階に入っています。
- コンシステンシー(一貫性)の向上:同一キャラクターや商品を異なるシーンで一貫して生成する技術(IP-Adapter、Consistent Characterなど)が精度を増し、ブランドコンテンツ制作への応用が拡大。
- 生成画像の真正性証明:C2PA規格によるContent Credentialsの普及が加速し、AIが生成した画像かどうかを透明化する仕組みが業界標準になりつつあります。
- エッジ・オンデバイス生成:モデルの軽量化(量子化・蒸留)によりスマートフォンや組み込み機器でのローカル生成が現実的になっており、クラウド依存を脱したプライバシー重視の用途が広がります。
- 規制の法制化:EUのAI規則など、AIが生成した画像であることの表示といった透明性を求める規制の整備が各地で進んでいます。
画像生成AIのよくある質問
画像生成AIと「生成AI」は同じですか?
生成AIは、文章・画像・音声・動画などを新しくつくるAIの総称で、画像生成AIはその中で画像をつくるものを指します。
画像生成AIは無料で使えますか?
サービスによって異なり、無料で試せるものも、有料プランが必要なものもあります。条件は変わることがあるため、各公式ページで確認してください。無料で使えるサービスは画像生成AIの無料ガイド、料金は料金ガイドで扱っています。
画像生成AIで作った画像は仕事に使えますか?
使えるかどうかは、サービスごとの利用規約・ライセンスで決まります。あわせて、既存の著作物や実在の人物に似ていないかも確認が必要です。詳しくは「画像生成AIの著作権・商用利用・倫理の注意点」の節をご覧ください。
どのサービスを選べばよいですか?
用途(下書きか、公開する素材か)と商用利用の条件で絞るのが近道です。サービスごとの違いは画像生成AI 比較ガイドで比べています。
まとめ
画像生成AIとは、拡散モデルやGANなどの深層学習技術を用いて、テキストや参照画像から新しい画像を自動生成する技術です。Stable Diffusion・Midjourney・OpenAIのGPT-Image・GoogleのNano Banana・Adobe Firefly・FLUXなど、さまざまなサービスがあり、広告・ゲーム・ファッション・医療・バーチャルヒューマンなどで使われています。
制作コスト削減・高速試作・スケーラビリティといった大きなメリットがある一方、著作権の不確実性・ディープフェイクリスク・細部の精度・バイアスといった課題も厳然と存在します。技術を正しく活用するには、仕組みを理解したうえで目的に合ったツールを選び、ヒューマン・イン・ザ・ループのワークフローを整備することが重要です。
技術の進化スピードは今後も落ちず、マルチモーダル統合・リアルタイム生成・一貫性向上・規制対応が主な焦点になっていきます。「使うか使わないか」ではなく、「どう安全に・効果的に使いこなすか」を問われる段階に、画像生成AIはすでに入っています。
関連記事
動画・画像生成AIの業務活用をご検討の方へ
クリスタルメソッドは、動画・画像を生成するAIやAIアバターの開発と業務導入を支援しています。「広告・研修動画の制作を効率化したい」「自社サービスに画像・動画生成を組み込みたい」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
画像生成AI比較|おすすめ主要9サービスの料金・無料枠・商用利用をわかりやすく解説【2026年10月版】
画像生成AIのおすすめは、目的によって変わります。まず無料で試すならChatGPT(ChatGPT Images 2.5)・Gemini・Adobe Firef...
-
画像生成AIの料金を徹底比較|無料枠・API料金・1枚あたりコスト【2026年版】
「画像生成AIを使ってみたいけど、料金がよくわからない」「無料で使えると聞いたが、実際どこまで使えるのか」——そんな疑問を持つ方は多いでしょう。画像生成AIのサ...
-
画像生成AIの使い方|ツール別の操作手順とプロンプトの書き方
本ページは「画像生成AIの使い方・操作手順」に特化し、DALL·EやStable Diffusionの具体的な操作手順・プロンプトの書き方・商用利用の注意点を実...