
blog
AIブログ
Llama(ラマ)とは?無料で使えるMetaのAIをやさしく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
「Llama(ラマ)ってよく聞くけど、何ができるAIなの?」「無料って本当?どう使うの?」——そんな方に向けて、このページでは正体・できること・使い方・料金を、専門用語をできるだけ避けてやさしくまとめます。AIにくわしくない方でも、読み終えるころには「自分や自社で何に使えそうか」がイメージできるはずです。
最新モデルの細かい仕様や導入手順、他AIとのくわしい比較は、それぞれの専用記事にリンクします。まずはここで全体像をつかんでください。
Llamaとは?ひとことで言うと「無料で公開された、Metaの賢いAI」
Llamaは、Facebook・Instagramを運営するMeta(メタ)社が開発しているAI(大規模言語モデル)です。ChatGPTやClaudeと同じように、質問に文章で答えたり、文章やコードを作ったりできます。
いちばんの特徴は、モデルそのものが無料で公開(オープンウェイト)されていること。多くのAIが「会社のサーバー越しにしか使えない」のに対し、このモデルは自分のPCや自社サーバーにダウンロードして動かせます。だからデータを外に出さずに使えたり、自社用に改造(ファインチューニング)したりできます。2026年時点の最新世代は「Llama 4」です。なお、Metaは2026年4月にクローズドウェイト・API専用の推論モデル「Muse Spark」も発表しており、こちらは別系統のフロンティアモデルとして位置づけられています。
※よく混同されますが、「Llama」はAIモデルの名前、「Ollama(オラマ)」はそれを手軽に動かすためのツールです。動かし方は Ollamaの解説 をご覧ください。
名前の由来と読み方(LLaMAからLlamaへ)
最初の発表(2023年2月24日)で、Metaは「LLaMA」と書き、「Large Language Model Meta AI」の略としていました。同年7月の第2世代の発表では「Llama」と表記されており、以降はこの綴りです。読み方のカタカナは公式ページに記載が見つからなかったため、本ページでは日本語で一般的な「ラマ」と表記しています(出典:Meta AI Blog(2023年2月)・Meta Newsroom(2023年7月)、2026年10月23日確認)。
どのモデルを自社で使うか迷ったときは、Llama vs Qwen 比較で解説しています。
🔥 Llamaを使うとこんなに変わる(before → after)
「無料で公開」と言われてもイメージしづらいので、何がうれしいのかを具体的に並べてみます。
- 高性能AIはコストが心配:今まで=高機能AIは従量課金が積み上がる → 無料で公開されており、自分の環境で動かせばAPI料金がかからない
- 社内データを外に出したくない:今まで=クラウドAIに機密を送るのが不安 → 自社サーバーやPC内で完結でき、データを外に出さずに使える
- 自社専用にカスタマイズしたい:今まで=既製のAIは中身をいじれない → オープンなので自社データで追加学習して専用AIにできる
- 動かすのが難しそう:今まで=環境構築が大変 → Ollamaなどのツールを使えばコマンド一つで動かせる
「自社のあの用途に合わせて使えそう」と思えたら、それがこのモデルの使いどころです。
次に読む:Llamaは無料でどこまで使える?
Llamaで何ができる?(主な活用)
文章の作成・要約、翻訳、プログラミング支援、社内文書を使った質問応答(RAG)、自社専用AIの構築など、はば広く使えます。RAGなどの応用には LlamaIndex(ラマインデックス)の解説、自社データでの追加学習には LLaMA-Factoryの使い方 が役立ちます。最新モデルの中身は Llama 4の詳細解説 で紹介しています。
いまのLlamaはどれ?(現行ラインナップ 2026年9月時点)
現行の最新世代はLlama 4(2025年4月発表)です。MoE(Mixture-of-Experts)アーキテクチャを採用し、画像とテキストの両方を理解できる、同シリーズ初のネイティブマルチモーダル世代です。
| モデル | 位置づけ | 特徴 |
|---|---|---|
| Llama 4 Maverick | 旗艦(マルチモーダル主力) | 17Bアクティブ・128エキスパート(総パラメータ約400B)。画像+テキストを理解する主力モデル。性能重視ならこれ |
| Llama 4 Scout | 軽量・超長文特化 | 17Bアクティブ・16エキスパート。単一NVIDIA H100 GPU 1枚で動くコンパクト設計。最大1,000万トークンの超長コンテキストをうたう |
| Llama 3.3(70B) | テキスト専用の実用モデル | 提供は70Bのみ(Meta公式のモデルカードによる)。軽量な8Bを使う場合は3.1の8Bを選びます。文章用途で今も現役。Llama APIでも提供 |
なお、3.1/3.2や第2世代は旧世代です。中身をくわしく知りたい方は Llama 4の詳細解説 をご覧ください。
バージョンの歴代一覧(発表日とサイズ)
Metaの公式発表をもとに、各世代の発表日とサイズ(B=10億パラメータ)を並べました。
| 世代 | 発表日 | サイズ | 公式発表の要点 |
|---|---|---|---|
| 初代(LLaMA) | 2023年2月24日 | 7B・13B・33B・65B | 研究用途に絞った非商用ライセンス |
| 2 | 2023年7月18日 | 7B・13B・70B(モデルカードの記載) | 研究・商用とも無償。Microsoftを優先パートナーとして発表 |
| 3 | 2024年4月18日 | 8B・70B | 15兆トークン超で学習 |
| 3.1 | 2024年7月23日 | 8B・70B・405B | 128Kコンテキスト、8言語 |
| 3.2 | 2024年9月25日 | 1B・3B(テキスト)、11B・90B(画像対応) | 初の画像対応と、端末向けの軽量版 |
| 3.3 | 2024年12月6日(モデルカードの記載) | 70B | 128Kコンテキスト、多言語の対話向け |
| 4 | 2025年4月5日 | Scout(有効17B・総109B)、Maverick(有効17B・総400B) | MoE構成と画像対応。Behemothはプレビュー(学習中) |
出典:初代・第2世代・3・3.1・3.2・3.3(モデルカード)・4(いずれもMeta公式、2026年10月23日確認)。
学習データの量と出典(初代と第2世代)
初代はMeta AIの論文(arXiv 2302.13971)によると、公開データだけで学習しています。学習量は65Bと33Bが1.4兆トークン、7Bと13Bが1.0兆トークンです。65Bの学習には、A100 80GBを2048枚使って約21日かかったと書かれています。データの内訳(サンプリング比率)は次のとおりです。
| データ | 比率 | ディスクサイズ |
|---|---|---|
| CommonCrawl | 67.0% | 3.3TB |
| C4 | 15.0% | 783GB |
| GitHub | 4.5% | 328GB |
| Wikipedia | 4.5% | 83GB |
| Books | 4.5% | 85GB |
| ArXiv | 2.5% | 92GB |
| StackExchange | 2.0% | 78GB |
第2世代はMetaのモデルカードによると、公開されたオンラインデータ2.0兆トークンで事前学習しています(データの期限は2022年9月、コンテキストは4K)。GPU時間はA100 80GBで合計約330万時間で、7Bが184,320時間、13Bが368,640時間、70Bが1,720,320時間です。調整用には公開の指示データと、新たに作成した100万件超の人手注釈の例を使い、Metaのユーザーデータは含まないとされています(出典:初代の論文・第2世代のモデルカード、2026年10月23日確認)。
3・3.1・3.2・3.3・4の特徴(学習データと対応言語を含む)
- 3:8Bと70Bの2サイズ。15兆トークン超の公開データで学習。公式記事は、より長いコンテキストを今後のリリースで提供するとしています。
- 3.1:405Bを追加し、128Kコンテキストと8言語に対応。ツール使用と推論を強化し、405Bの出力を他モデルの改善に使うことをライセンスで認めています。安全対策としてLlama Guard 3とPrompt Guardも同時に公開されました。
- 3.2:11Bと90Bは同シリーズ初の画像対応(グラフの読み取りや画像の説明)。1Bと3Bはスマートフォンなどの端末で動かす想定で、128Kコンテキストです。
- 3.3:70Bのみ。128Kコンテキストで、多言語の対話向けに最適化されています(モデルカードの記載)。
- 4:事前学習データは30兆トークン超で、3の2倍以上。200言語を含み、3より多言語のトークンが10倍以上とされています(公式発表)。
公式ベンチマーク(開発元の公式発表による)
次の数値は、Metaが4の公式モデルカードに載せている指示調整モデルの結果です(開発元の公式発表による数値で、第三者による検証ではありません)。表の見出しは、3.3は70B、3.1は405B、ScoutとMaverickは4の2モデルです。画像を扱えない世代は「-」としています。
| ベンチマーク | 3.3 | 3.1 | Scout | Maverick |
|---|---|---|---|---|
| MMLU Pro | 68.9 | 73.4 | 74.3 | 80.5 |
| GPQA Diamond | 50.5 | 49.0 | 57.2 | 69.8 |
| LiveCodeBench | 33.3 | 27.7 | 32.8 | 43.4 |
| MGSM | 91.1 | 91.6 | 90.6 | 92.3 |
| MMMU(画像) | - | - | 69.4 | 73.4 |
出典:Meta公式モデルカード(4)、2026年10月23日確認。
Metaの新しいAIモデル「Muse」とLlamaの関係
2026年9月時点で、Meta公式ドキュメントが載せている最新世代はLlama 4です(その前が3・2)。一方でMetaは、別の名前の新しいモデル群「Muse」も提供しており、開発者向けサイトのトップはMuse中心の構成になっています。
- Muse Spark:MetaのAPI(Meta Model API)で使うモデル。エージェントやコーディング向けで、1.1/1.2/1.3の版があり1.3が最新
- Muse Glimmer:自分のPCやサーバーで動かせる公開モデル。300億パラメータで、Apache 2.0ライセンスで提供され、GPU1枚やMacで動くとされています。Muse Sparkをもとに小型化したモデルです
「無料で手元のPCで動かせるMetaのAI」という点では同じ役割ですが、Muse Glimmerは独自ライセンスではなく一般的なオープンソースライセンス(Apache 2.0)を採用している点が大きな違いです。これからMetaのモデルを選ぶ場合は、Llama 4とMuse Glimmerの両方を候補に入れて比べるとよいでしょう(出典:Meta公式ドキュメント・Muse Glimmer公式ページ、2026年9月29日確認)。
料金はかかる?無料で使える?
モデル自体は無料で公開されており、自分の環境で動かすぶんにはAPI料金はかかりません(電気代・サーバー代などの実費は別途)。ただし商用利用にはライセンス条件があるため、業務で使う前に確認が必要です。料金・ライセンスの詳細は 料金・ライセンス解説 にまとめています。
| 使い方 | 費用 | 補足 |
|---|---|---|
| 自分のPC・自社サーバーで動かす | モデル代は無料 | 公式サイトやHugging Faceから無償ダウンロード。電気代・サーバー代などの実費のみ |
| Meta公式のAPI | 使った分だけのトークン課金 | 自前でGPUを用意したくない開発者向けのホスト型API(llama.developer.meta.com) |
| サードパーティのAPI経由 | 参考: Scout 入力約$0.08/出力約$0.30、Maverick 入力約$0.15/出力約$0.60(100万トークンあたり) | DeepInfra・Fireworks等、提供事業者により変動。契約前に最新の単価を要確認 |
ライセンスは「Llama 4 Community License」という条件付きのオープンライセンスです。完全なMIT/Apacheライセンスではなく、ほとんどの企業は無償で商用利用できますが、月間アクティブユーザーが7億人を超えるような超大手事業者は別途Metaの許諾が必要という制限条項があります(2026年7月時点)。
「オープンソース」か「オープンウェイト」か
モデルが無料で公開されていても、それが「オープンソース」かどうかは別の話です。オープンソースの定義を管理するOSI(Open Source Initiative)は、2023年7月20日の公式記事で、第2世代のライセンスについて「Open Sourceのライセンスではない」と明言しました。理由として、利用者や用途による差別を認めないオープンソースの定義に、商用利用の制限と利用規定(Acceptable Use Policy)の用途制限が合わないことを挙げています。この記事は第2世代のライセンスを対象にしたもので、現行ライセンスの扱いは公式の条文で確認してください。本ページが「オープンウェイト」と書くのは、このためです(出典:OSI公式記事、2026年10月23日確認)。
始め方・動かし方(はじめての方へ)
いちばん手軽なのは、Ollamaなどのツールでダウンロードして動かす方法です。導入の手順は 導入ガイド に、APIサーバーとして動かす方法は サーバー化の解説 に、モデルを高速に動かす中核エンジンは 実行エンジンの解説、モデルの入手元は Hugging Faceでの入手方法 にまとめました。
手元のPCで動くかの目安:一般的な8Bクラスのモデル(量子化版)は、GPUなしのCPUのみでもシステムRAM16GB以上あれば動作し、体感速度は毎秒3〜5トークン程度(チャット向けにはやや待たされる速さ)です。GPUがあれば大きく改善し、VRAM 6GB程度(RTX 3060クラス)でも快適な速度域に入ります。「まずCPUだけで試して、遅いと感じたら中古GPUを足す」という段階的な進め方が現実的です。
クラウド経由で使う(Bedrock・Azure・watsonx・Databricks)
自分のPCで動かせない大型モデルは、大手クラウドの提供サービスから使う方法があります。Metaは3の発表時点で、AWS・Databricks・Google Cloud・Hugging Face・IBM WatsonX・Microsoft Azureなどでの提供を案内していました。現在の対応モデルは各社の公式ページで次のとおり確認できます(2026年10月23日確認)。提供モデルは入れ替わるため、契約前に最新の一覧を見てください。
- Amazon Bedrock(AWS):3・3.1・3.2・3.3・4のInstructモデルを、InvokeModel操作で呼び出せます。入力は
prompt・temperature(既定0.5)・top_p(既定0.9)・max_gen_len(既定512、最大2048)。3.2の11B/90Bと4は、アカウントの国とリクエスト元の国で利用が制限されます(AWS公式ドキュメント) - Microsoft Foundry(Azure):「Azureが販売するモデル」に、4のMaverick・Scout、3.3の70B Instruct、3.2、3.1などが掲載されています(Microsoft Learn)
- watsonx.ai(IBM):4のMaverick・Scout、3.3の70B Instructなどを掲載。モデルにより従量課金か「オンデマンドのデプロイのみ」かが分かれます(IBM公式)
- Databricks:Foundation Model APIsの対応モデルに、4のMaverick、3.3の70B Instruct、3.1の8B Instructが載っています。従量課金の枠では3.3の70Bが3.1の70Bに置き換わっています(Databricks公式ドキュメント)
実際に動かすコマンド例(Ollama)
Ollamaをインストール済みなら、ターミナルで次のコマンドを打つだけでダウンロード・起動します(初回はモデルのダウンロードがあります。既定の llama4 は約67GBあるため、回線の速さと空き容量によっては時間がかかります)。
# Llama 4を起動(既定は llama4:16x17b=Scout。約67GB)
ollama run llama4

# 大きい Maverick を指定する場合(llama4:128x17b。約245GB)
ollama run llama4:128x17b

# 起動後はそのままチャット形式で質問できる
>>> 日本語で自己紹介してください
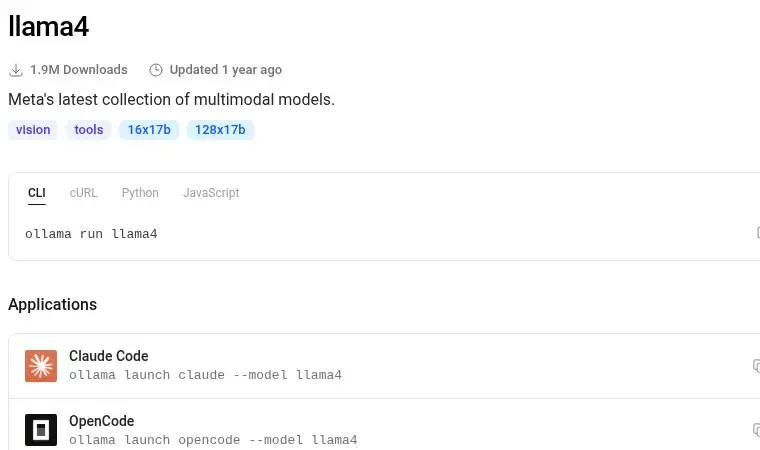
ollama run llama4 の1行で始められます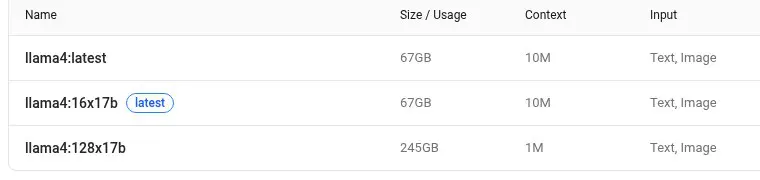
まず手元のPCで軽く試すなら、Ollama公式にある ollama run llama3.2(3B版で2.0GB・1B版で1.3GB)から始める方法もあります(2026年10月23日に確認)。
Ollama本体のインストール手順は導入ガイドにまとめています。
企業での活用例——Llamaが選ばれる典型パターン
「無料で・手元で・改造できる」という性質から、企業利用で特に選ばれています。代表的なパターンは次の4つです。
- 社内チャットボット:機密データを外部に送信せず、社内サーバー内で完結するAIアシスタントを構築する
- 社内文書のAI検索(RAG):規程集やマニュアルを読み込ませ、根拠付きで答える社内ヘルプデスクを作る(LlamaIndexの解説)
- 自社専用AIの構築:自社の言い回しや業務知識を追加学習させ、専用モデルに仕立てる(LLaMA-Factoryの使い方)
- 開発コストの圧縮:試作段階は無料で検証し、必要に応じて商用APIと使い分けてAPI費用を抑える
ChatGPTや他のAIと何が違う?
大きな違いは、モデルが公開されていて自分で動かせること、そして無料で・自社専用に改造できることです。「コストを抑えたい」「データを社内で完結させたい」「自社用にカスタマイズしたい」なら、このモデルという選び方ができます。他モデルとの比較は 比較解説、Qwenとの比較は Qwenとの比較記事 をご覧ください。
よくある質問
Q. 無料で使えますか?
A. モデルは無料で公開されています。自分の環境で動かせばAPI料金はかかりません(商用利用はライセンス条件を確認)。
Q. 「Llama」と「Ollama」は何が違いますか?
A. 前者はAIモデルの名前、Ollamaはそれを手軽に動かすツールです。
Q. 動かすのにプログラミングは必要ですか?
A. Ollamaなどを使えば、ほぼコマンド操作だけで動かせます。
Q. 日本語でも使えますか?
A. 使えます。日本語の質問・文章作成にも対応しています。
Q. 最新バージョンはどれですか?
A. 2026年9月時点の最新世代はLlama 4(MaverickとScout)です。テキスト専用では3.3(70B)や3.1(8B)も現役で使われています。なお、Metaは別に新しいモデル群「Muse」(APIのMuse Spark、公開モデルのMuse Glimmer)も提供しています。
Q. 商用利用はできますか?
A. 多くの企業は無償で商用利用できます。ただし完全な自由ライセンスではなく「Llama 4 Community License」という条件付きで、超大規模事業者(月間アクティブユーザー7億人超)は別途Metaの許諾が必要です。
Q. どのくらいのPCが必要ですか?
A. 3.1の8Bや3.2の1B・3Bなど軽量モデルなら一般的なPCでも動かせます。Llama 4 Maverickのような大型モデルは高性能GPUが必要で、手元で難しい場合はクラウドGPUやホスト型APIを使う方法があります。
Q. ChatGPTの代わりになりますか?
A. 用途によります。データを社内に留めたい・コストを固定したい・カスタマイズしたい場合は有力です。最高水準の応答品質を常に求めるなら商用AIとの併用が現実的です。
まとめ
このモデルは、「無料で公開され、自分の環境で動かせる」という他にない強みを持つMetaのAIです。現行世代のLlama 4はマルチモーダル対応と超長コンテキストを特徴としており、テキスト用途には3.3も引き続き活躍しています。まずはOllamaなどで一度動かしてみるところから始めてみてください。「もっとくわしく」と思ったら、このページから各専用記事へ進めば、導入手順・料金・最新モデル・他AIとの違いまで一気に深掘りできます。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
参考文献
- Meta 公式サイト:https://www.llama.com/(2026年7月7日確認)
- Llama 4 モデルページ(公式):https://www.llama.com/models/llama-4/(2026年7月7日確認)
- Meta AI Blog — The Llama 4 herd(公式発表):https://ai.meta.com/blog/llama-4-multimodal-intelligence/(2026年7月7日確認)
- Llama API 公式ドキュメント(モデル一覧):https://llama.developer.meta.com/docs/models/(2026年7月7日確認)
関連記事(Llama)
- 導入ガイド
- 料金・ライセンス解説
- バージョン・他モデル比較
- Ollamaの使い方(モデル実行)
- Ollamaの料金解説
- Ollamaと他ツールの比較
- 高速実行エンジンとは
- LlamaIndexとは(RAG構築)
- Llama 4の詳細解説
- サーバー化(API化)の解説
- Ollamaのモデル一覧と選び方
- Ollama Cloudの解説
- Ollama APIの解説
- WindowsでのOllama導入
- OllamaのGUIツール
- Gemmaとの比較
- LLaMA-Factoryの使い方(追加学習)
- Ollamaの日本語モデルおすすめ
- OllamaをPythonで使う方法
- Ollamaのインストール方法
- Ollamaの量子化解説
- OllamaとLM Studioの比較
- OllamaのOpenAI互換API
- Hugging Faceでの入手
- Qwenとの比較
- OllamaでRAGを作る方法
- MacでのOllama導入
- Ollamaでエージェントを動かす方法
- Meta AIとは?違いを解説
LLM・ローカルLLMの業務導入をご検討の方へ
クリスタルメソッドは、オープンモデル・ローカルLLMの選定からRAG構築・PoC・本番導入までのAI開発を支援しています。「機密データを外部に出さずにLLMを使いたい」「自社の業務に合うモデルを選びたい」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
Llama vs Qwen 比較:2026年版ライセンス・性能・コストの選択指針
llama qwen 比較:2026年時点の基本ポジションと選択の前提 オープンウェイトLLMの実用選択肢として、Meta社のLlamaとAlibaba Clo...
-
llama 料金の全体像|無料範囲・API単価・損益分岐点を整理
llama 料金の前提:月額サブスクリプションは存在しない Meta が開発する Llama は、ChatGPT や Claude のような月額サブスクリプショ...
-
Llama導入ガイド|自社環境での構築・推論・運用判断を解説
本ページはLlamaを自社環境へ「導入・運用」するための実践指針に特化しています。Llamaそのものの基礎知識はLlamaとは?仕組み・活用の解説を、最新世代の...