
blog
AIブログ
Llamaは日本語対応してる?Llama 4の性能と活用戦略を産総研研究から解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
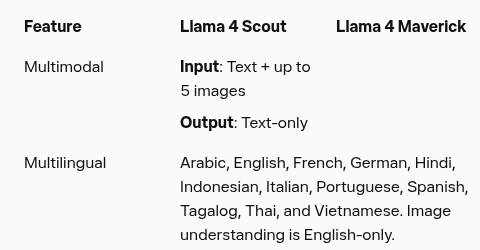
Llama(ラマ)は、Metaが公開している大規模言語モデル(LLM)のシリーズです。最新の世代であるLlama 4(2025年4月発表)は、Meta初のMoE(Mixture-of-Experts)採用世代かつネイティブマルチモーダル世代です。Metaの公式モデルカードが対応言語として挙げるのはアラビア語・英語・フランス語・ドイツ語・ヒンディー語・インドネシア語・イタリア語・ポルトガル語・スペイン語・タガログ語・タイ語・ベトナム語の12言語で、日本語はこの12言語に含まれていない(Meta公式 Llama 4 モデルカード、2026年10月12日確認)。そのためLlamaを日本語の業務で使うには、日本語データで追加学習した派生モデルやRAGで補う設計が前提になります。その具体的な手法を、産業技術総合研究所(産総研)の研究成果を軸に整理します。
Llamaシリーズ全体の歴史的経緯と基本仕様についてはLlamaとは何かで体系的にまとめているため、モデル群の位置づけを把握してから本記事を読むと理解が深まります。
Llama 4は日本語に対応している?
結論として、Llama 4の公式の対応言語は12言語で、日本語は含まれていません。対応言語の外にある言語での品質をMetaは示していないため、日本語の業務で使うなら、自社のデータで精度を確かめたうえで、日本語で追加学習した派生モデルやRAGで補うことが前提になります。
- モデル構成:公開されているLlama 4はScoutとMaverickの2モデルで、どちらもMoE(Mixture-of-Experts)アーキテクチャを採用する(2025年4月発表)。発表時に予告されたBehemothは、公式モデルカードにもHugging Faceの公開一覧にも載っていない(2026年10月12日確認)。
- 日本語の扱い:公式の対応言語はアラビア語・英語・フランス語・ドイツ語・ヒンディー語・インドネシア語・イタリア語・ポルトガル語・スペイン語・タガログ語・タイ語・ベトナム語の12言語で、画像の理解は英語のみとされています。日本語は対応言語の外にあるため、敬語や長文の指示など日本語特有の処理は自社の評価データで確かめる必要があります。
- 実務水準に上げる方法:産業技術総合研究所の「Swallow」に代表される日本語コーパスでの継続事前学習や日本語インストラクションチューニング、社内文書を参照させるRAGを併用します。
- 2026年10月の動き:Metaの最新のオープンウェイトモデルはLlamaではなくMuse Glimmer(30B・Apache 2.0・100以上の言語のデータで学習)です。Llamaの系列ではLlama 4が最新のままになっています。
最終確認日:2026年10月14日(Muse Glimmerの公式ドキュメント、Hugging Faceの公開一覧、Ollama公式のllama4のページ)。Meta公式のモデルカード・ライセンス・利用規定は2026年10月12日に確認しました
公開されているモデルの世代ごとの違いは、Llama バージョン完全比較で解説しています。
Llamaとは?Metaが公開しているモデル群とバージョンの移り変わり
Llamaは、Metaが公開している大規模言語モデルのシリーズです。モデルの重み(学習済みのパラメータ)をダウンロードして自分の環境で動かせる「オープンウェイト」の形で提供されてきました。最初の LLaMA が2023年2月、Llama 2 が2023年7月、Llama 3 が2024年4月、Llama 3.1 が2024年7月、Llama 3.2 が2024年9月、Llama 3.3 が2024年12月、Llama 4 が2025年4月に公開されています(Wikipedia日本語版「Llama」の一覧と、Metaの公式ブログ・Hugging Faceの各モデルのページで照合、2026年10月14日確認)。
| 世代 | 公開時期 | 主なサイズ | コンテキスト長 |
|---|---|---|---|
| LLaMA(初代) | 2023年2月 | 約7B〜65B | 2,048トークン |
| Llama 2 | 2023年7月 | 約7B〜70B | 4,096トークン |
| Llama 3 | 2024年4月 | 8B・70B | 8,192トークン |
| Llama 3.1 | 2024年7月 | 8B・70B・405B | 128K |
| Llama 3.2 | 2024年9月 | 1B・3B・11B・90B | 128K |
| Llama 3.3 | 2024年12月 | 70B | 128K |
| Llama 4 | 2025年4月 | Scout(約109B)・Maverick(約400B) | Scout 10M・Maverick 1M |
初代〜Llama 3.3 の数値は Wikipedia 日本語版の一覧によるものです。Llama 3.1 と Llama 3.3 の公開日・コンテキスト長・対応8言語(日本語は含まれません)は、Metaの公式ブログと Hugging Face の公式ページで確認しました。Llama 4 のサイズとコンテキスト長は、本記事の後半の表のとおりです。2026年10月の時点で、Llamaの系列でいちばん新しいのは Llama 4 です。
Llamaの主な特徴
- 重みを取得して自分の環境で動かせる:ChatGPTのようにサービス経由で使うだけでなく、ライセンスの条件の範囲で、自社のサーバーやPCに置いて動かせます。
- MoE(Mixture-of-Experts)構成:Llama 4のScoutとMaverickは、入力ごとに一部の専門家(エキスパート)だけを使う構成です。
- 画像も扱えるマルチモーダル:Llama 4はテキストと画像を入力できます。ただしMetaのモデルカードでは、画像の理解は英語のみとされています。
- 長いコンテキスト長:Scoutは10M、Maverickは1Mトークンです(Ollama公式のページ、2026年10月14日確認)。
- 系列が複数のサイズに分かれている:Llama 3.2の1B・3Bのような小型から、Llama 3.1の405Bまで、用途に合わせて選べます。
Llamaはどんな用途に向くか
社内の文書を外部に出さずに扱いたい場合や、特定の業務向けに追加学習したい場合に向きます。反対に、日本語の文章を手間なく作りたいだけなら、日本語に対応した提供元のサービスのほうが手軽です。Llamaで日本語を扱うときの考え方は、次の節以降で説明します。
LLM(大規模言語モデル)とは:Llamaの仕組み
LLMは、大量の文章で事前学習し、それまでの文脈から次に来る言葉(トークン)を予測して文章を生成するAIです。Llamaも同じ仕組みで、事前学習のあとに指示への従い方を追加学習(ファインチューニング)した「Instruct」版が、対話や質問応答に使われます。Hugging Faceのmeta-llamaでも、Llama 4はBase・Instructなどの版に分かれて公開されています(2026年10月19日確認)。
Llamaから生まれた主な派生モデル
Llamaは重みが公開されているため、他の組織が追加学習した派生モデルが多くあります。日本語を強化したものは、本記事の産総研「Swallow」の節でも扱います。
| モデル | 公開時期 | 概要 |
|---|---|---|
| Alpaca | 2023年3月13日 | スタンフォード大学のCRFM。初代LLaMA-7Bをファインチューニングしたモデル |
| Code Llama | 2023年8月24日 | プログラミング向けの生成AI。サイズは6.7B〜69B |
| ELYZA-japanese-Llama-2-7b | 2023年8月29日 | ELYZAがLlama 2 7Bをもとに日本語の性能を高めたモデル |
| Llama-3-ELYZA-JP | 2024年6月26日 | ELYZAによる日本語向けモデル(8Bと70B) |
| Llama-3.1-ELYZA-JP-70B | 2024年10月25日 | ELYZAによる日本語向けモデル(Llama 3.1ベース) |
出典:Wikipedia日本語版「Llama」(2026年10月19日確認)。
次に読む:Llama と Qwen、どちらを選ぶ?
Llama 4 日本語対応の現状——12言語サポートの意味と構造的限界
Llama 4の公式モデルカードは、対応言語をアラビア語・英語・フランス語・ドイツ語・ヒンディー語・インドネシア語・イタリア語・ポルトガル語・スペイン語・タガログ語・タイ語・ベトナム語の12言語と明記しています。日本語・中国語・韓国語は入っていません。画像の理解は英語のみとされる(Meta公式 Llama 4 モデルカード、2026年10月12日確認)。つまり「12言語サポート」は日本語対応を意味しません。対応言語の外にある言語について、Metaは品質の目安を示していません。
ひとつ前の世代も同じで、Hugging Faceの公式の登録情報では、Llama 3.3 70BとLlama 3.1 8Bの対応言語は英語・ドイツ語・フランス語・イタリア語・ポルトガル語・ヒンディー語・スペイン語・タイ語の8言語です。Llamaシリーズを日本語で使うには追加学習が要る、という構図はLlama 3世代から変わっていません。
追加学習の効果を示す国内の一次情報が、産総研が公開している「Llama 3.1 Swallow」です。産総研は2024年10月、Llama 3.1をベースとした日本語特化モデル「Llama 3.1 Swallow」を公開し、継続事前学習によってオープンソースLLMの日本語能力が大幅に向上することを確認した(産総研、2024年10月)。継続事前学習を施す前のベースモデルには、日本語性能に改善の余地があることを示す結果です。
また2026年3月には、産総研AIRCが推論型大規模言語モデルへの継続事前学習に関する研究成果を報告しており(産総研AIRC、2026年3月)、日本語での多段階推論精度の向上が継続的な研究課題として取り組まれていることが確認できます。Swallowの開発チームがHugging Faceで2026年に公開したモデルは、Qwen3やGPT-OSSを土台にしたものが中心で、Llama 4を土台にしたSwallowは公開一覧に見当たらない(Hugging Face tokyotech-llm、2026年10月12日確認)。それでも、Swallowが確立した手順は、Llama系のモデルを日本語化する際の参照軸になります。
Llama 4のモデル構成と日本語タスクへの適合性
日本語ユースケースに即して、Llama 4の各モデルの特性を整理します。Llama 3世代の代表的なモデルと合わせた比較を以下の表に示します。
| モデル名 | アクティブパラメータ | 総パラメータ | 最大コンテキスト長 | 日本語タスクでの特性 |
|---|---|---|---|---|
| Llama 4 Scout | 17B | 約109B(16E MoE) | 最大10Mトークン | 長文の一括処理に強み。INT4量子化版はNVIDIA H100 1枚で動作(Meta公式モデルカード)。日本語は対応言語に含まれない |
| Llama 4 Maverick | 17B | 約400B(128E MoE) | 最大1Mトークン | テキスト+画像(最大5枚)の入力に対応。対応言語は12言語で日本語は含まれません。画像の理解は英語のみ(Meta公式モデルカード) |
| Llama 4 Behemoth | 288B | 約2T | 未公開 | 2025年4月の発表時に予告(Meta公式、2025年4月)。公式モデルカードとHugging Faceの公開一覧には載っていない(2026年10月12日確認) |
| Llama 3.3 70B | 70B(密モデル) | 70B | 128k | テキスト専用のモデル。公式の対応言語は8言語で、日本語は含まれない |
| Llama 3.1 8B | 8B(密モデル) | 8B | 128k | 軽量・高速なテキスト専用モデル。公式の対応言語は8言語で、日本語は含まれない |
日本語ユースケースで特に注目すべき点として、Scoutの最大10Mトークンというコンテキスト長がある。日本語は英語に比べて1トークンあたりの情報密度にばらつきがあるため単純比較は難しいが、10Mトークンという規模は長大な日本語業務文書・法律文書・研究論文群を一括処理するシナリオで制約になりにくい水準である(llama.com、2026年10月12日確認)。従来のチャンク分割+再結合アプローチで生じていた文脈の断絶を減らせる点は利点です。ただし日本語は対応言語に含まれないため、長文の日本語で精度が保てるかは別に検証が要ります。
MaverickはEarly Fusion方式によるマルチモーダル対応(テキスト+画像の同時処理)が特徴であり、文書画像・図表・スキャン帳票の解析といったユースケースが想定されます。ただし公式モデルカードは画像の理解を英語のみとしており、日本語の帳票の読み取りは対応範囲の外にあります。Behemothは2026年10月時点でも一般向けに提供されていないため、日本語性能の評価対象としては考慮しない(Meta公式ブログ、2025年4月)。
【2026年10月時点】Metaの最新のオープンウェイトモデルはMuse Glimmer。Metaの開発者向けサイトは現在Museシリーズが中心で、llama.comのLlamaのページもdev.meta.aiへ転送されます。自前の環境で動かせるモデルとしてはMuse Glimmerが公開されています。公式ドキュメントによると、30Bパラメータの密な(MoEではない)マルチモーダルモデルで、テキストと画像を入力でき、コンテキスト長は標準で128Kトークン、100以上の言語のデータで学習し、重みはApache License 2.0で公開されている(Meta公式 Muse Glimmer ドキュメント、2026年10月12日確認)。Hugging Faceでの公開は2026年8月です。対応言語の一覧は公式ドキュメントに載っておらず、日本語の品質は公式には示されていません。
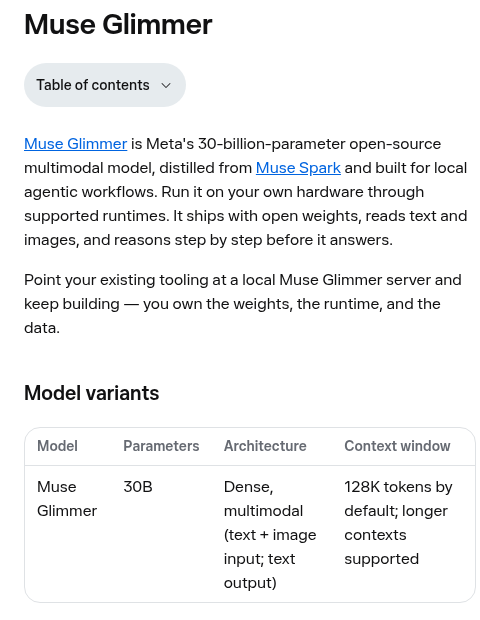
Llamaの系列で最新なのはLlama 4のままです。これから日本語のシステムを組むなら、Llama 4だけでなくMuse Glimmerも候補に入れ、同じ日本語の評価データで比べるのがよいです。Apache License 2.0は、次に述べるLlama 4のコミュニティライセンスより条件が少ない点も判断材料になります。
産総研「Swallow」が示す——Llama 日本語強化の具体的手法
国内の一次情報として、産総研が2023年12月に公開した「Swallow」(Llama 2ベースの日本語特化モデル)の研究成果がある(産総研、2023年12月)。その後Llama 3.1をベースとした「Llama 3.1 Swallow」へと発展し、さらに2026年3月には推論型LLMへの継続事前学習研究も報告された(産総研AIRC、2026年3月)。
Swallowの研究から得られる手法上の示唆は以下の3点に集約されます。
- 継続事前学習(Continual Pre-training):英語中心で学習されたベースモデルに大量の日本語コーパスを追加学習し、日本語語彙の内部表現を再構築します。翻訳的な処理ではなく日本語ネイティブに近い推論経路が形成されやすくなります。
- 日本語インストラクションチューニング(SFT):継続事前学習後のモデルに日本語の指示—応答ペアでSFTを施すことで、複雑な日本語タスクへの追従精度が向上します。
- 推論型モデルへの展開:2026年3月の産総研報告では、継続事前学習を思考チェーンを生成する推論型LLMへ応用する取り組みが示されており、日本語での多段階推論精度の向上が継続的な研究課題として取り組まれています。
Llama 4はMoEアーキテクチャを採用しており、継続事前学習の際にはエキスパートルーターの挙動を含めた調整が必要になる点が従来の密モデルよりも複雑です。これはLlama 4日本語ファインチューニングの研究的課題として注目される領域であり、Swallowの実績がそのまま適用できるわけではないが、手法の基本構造は参照軸として有効です。
LLM-jpが公開する「日本語LLMまとめ」(llm-jp.github.io)は、一般公開されている日本語LLMおよび日本語評価ベンチマークの包括的なリストを提供しており、Llama 4日本語派生モデルの動向を追うための参照先として有用です。Swallowの開発チーム自身も、2026年にはQwen3やGPT-OSSを土台にした日本語モデルを公開しています。Llama 4の日本語性能がオープンウェイトモデルの中でどの位置にあるかは、各ベンチマークで継続的に確かめる必要があります。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
Llama 4 日本語の実務強化戦略——ファインチューニングとRAGの選択基準
Llama 4の日本語性能を実務水準に引き上げるための主なアプローチを、効果・コスト・制約の観点から比較します。
| アプローチ | 日本語改善の主な効果 | 主な制約・コスト | 推奨シナリオ |
|---|---|---|---|
| 継続事前学習 | 語彙・内部表現の根本的な再構築。産総研Swallowが実証済み | 大規模な計算資源と時間が必要。MoEモデルはルーター調整も要する | 研究機関・大規模プロダクト開発 |
| SFT(指示チューニング) | 日本語の指示追従・出力品質の向上 | 高品質な日本語アノテーションデータの整備が必要 | 特定ドメインの業務用途 |
| LoRA / QLoRA | 特定ドメインの日本語表現に特化しやすい | フルSFTほどの汎用日本語改善は期待しにくい | リソース制約のある中小チーム |
| RAG(検索拡張生成) | ドメイン固有の日本語知識を即時補完できる | モデル自体の日本語生成力は変わらない | 社内知識ベースの参照が中心の用途 |
| 英語プロンプト→日本語出力 | 推論の質を英語処理経路で高めつつ日本語出力 | プロンプト設計のコスト。出力の自然さに限界あり | 開発初期の検証・プロトタイプ段階 |
産総研の研究が示す通り、継続事前学習+SFTの組み合わせが日本語改善として最も根本的な効果をもたらします。ただしLlama 4はMoEアーキテクチャであり、エキスパートルーターの挙動を含めた調整が必要になる点が従来の密モデルより複雑であることは前述の通りです。
リソースに制約のある実務チームには、まずRAGと英語プロンプト構成を試し、性能が要件に届かない場合にLoRA/QLoRAによるドメイン特化ファインチューニングへ段階的に進む判断が現実的です。産総研の研究を参照しながら、Llama 4世代の日本語特化派生モデルの公開動向を継続的に監視することも重要な戦略オプションとなります。
具体的なセットアップ手順についてはLlamaの導入ガイドで詳述しています。また、AIが製造業・金融業の実務にどのように統合されつつあるかは、製造業へのAI活用および金融分野へのAI活用でも取り上げているため、業種別の文脈でLlama 4日本語の位置づけを検討したい読者はあわせて参照してください。
Llama 4を実際に動かす方法——Ollama・重みの取得・クラウド
Llama 4 を使い始める方法は大きく3つあります。どの方法でも、公式の対応言語に日本語は入っていないので、日本語で使う前に自社の評価データで品質を確かめてください。
- Ollamaで動かす:Ollamaを入れた環境で
ollama run llama4を実行します。Ollama公式のページには、タグがllama4:16x17b(67GB・コンテキスト10M・入力はテキストと画像)とllama4:128x17b(245GB・コンテキスト1M)の2種類載っています(2026年10月14日確認)。ダウンロードだけで数十GB以上になるので、保存先の空きと使えるメモリを先に確認します。 - 重みを取得して自分の環境で動かす:Hugging Face の meta-llama で Llama 4 の Scout と Maverick が公開されています。ライセンスへの同意と申請のあとにダウンロードします。Meta公式のモデルカードには、Scout の INT4 量子化版が NVIDIA H100 1枚で動くと書かれています。
- クラウドのサービスで使う:AWSの公式ページには、Llama 4 が Amazon Bedrock で利用できると載っています。自前でGPUを用意せずに試せますが、料金は提供事業者ごとに違うので、各社の公式の料金ページで確認してください。
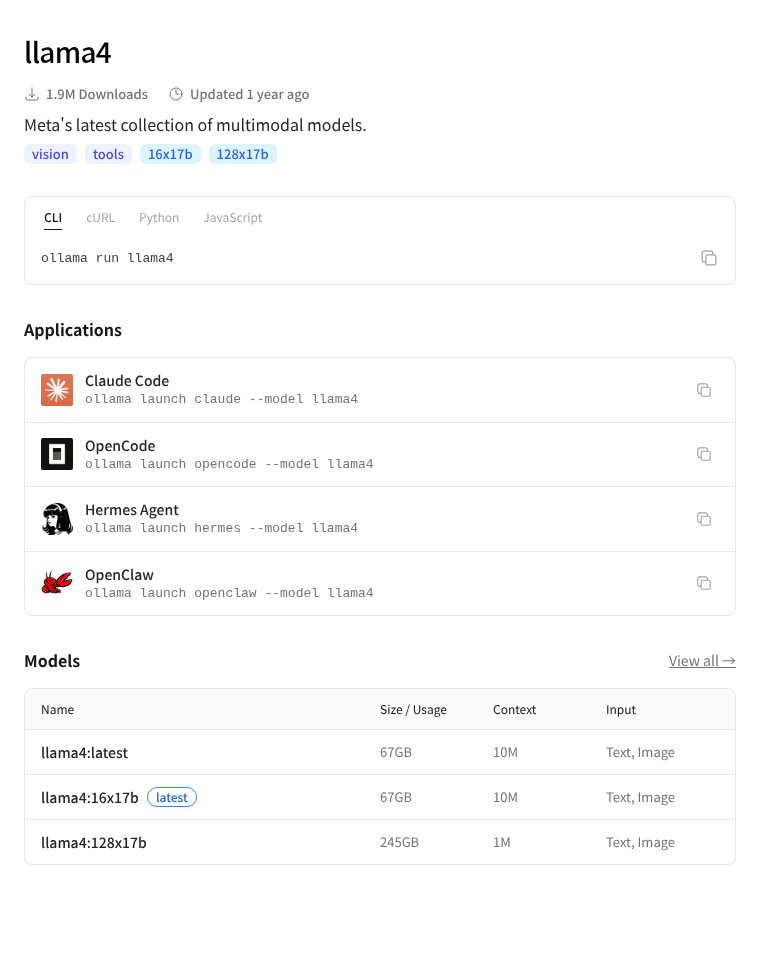
Ollama公式のllama4のページ(出典:ollama.com・2026年10月14日撮影)
実際に動かした画面:Ollamaで Llama 3.2 3B を入れて質問する
Llama 4 は最小のタグでも67GBあるため、手元のPCで手順を確かめるには小さい世代が向いています。ここでは Ollama公式ライブラリの llama3.2:3b(約2.0GB)を、GPU(NVIDIA RTX 3090・24GB)を積んだLinuxのPCで実際に動かした画面を載せます(2026年10月19日に実行・Ollama 0.40.6)。
- Ollamaを入れる:Ollama公式の Linux 用ドキュメント(docs.ollama.com/linux・2026年10月19日確認)には、インストールスクリプトと手動インストールの2通りが載っています。今回は手動インストールの案内にあるアーカイブ(ollama.com/download/ollama-linux-amd64.tar.zst)を管理者権限なしでホーム内に展開し、
ollama serveを起動しました。 - モデルを取得する:
ollama pull llama3.2:3bを実行します。完了後にollama listで入ったことを確認します。 - 中身を確認する:
ollama show llama3.2:3bで、パラメータ数3.2B・量子化Q4_K_M・コンテキスト長131072・ライセンス(LLAMA 3.2 COMMUNITY LICENSE AGREEMENT)が表示されます。 - 質問する:
ollama run llama3.2:3b "質問"で日本語の質問を渡します。
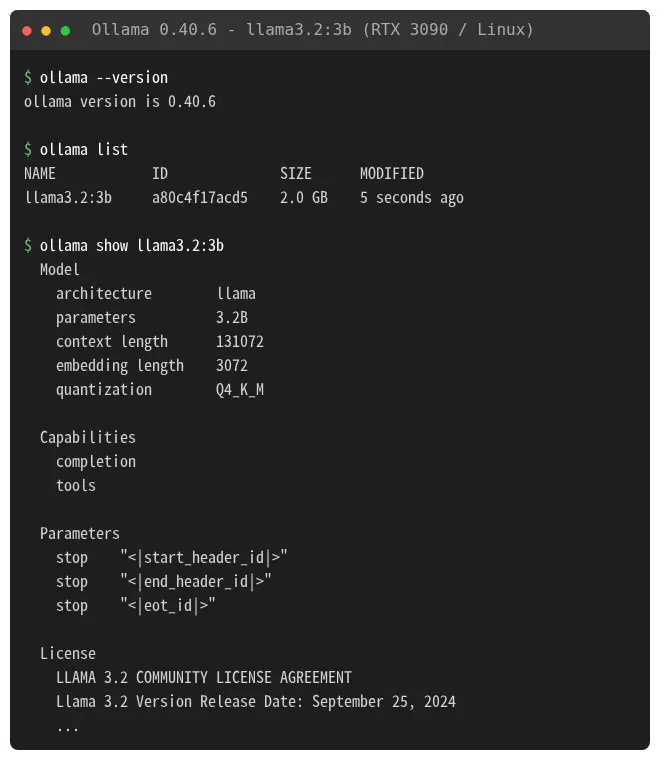
ollama list と ollama show の実行結果(検証用のPCで2026年10月19日に実行した画面)
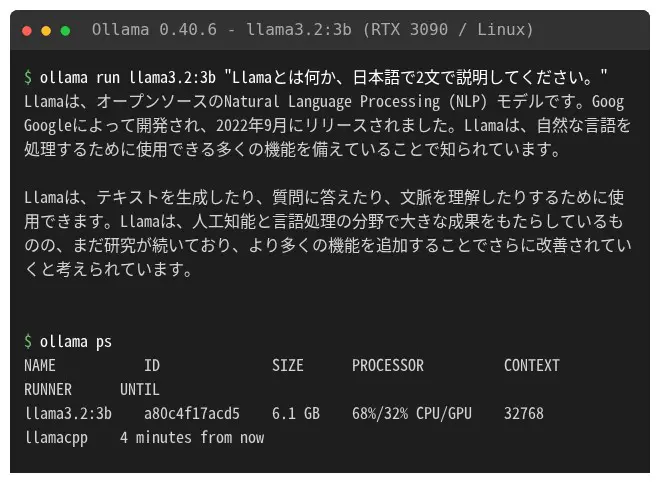
ollama run と ollama ps の実行結果(同日・同じPC)
この画面から分かること:ollama ps の表示では、このモデルは約6.1GBのメモリを使い、処理はCPUとGPUに分かれていました(CPU 68%/GPU 32%・コンテキスト32768)。同じPCで別のプログラムがGPUメモリを使っていたため、GPUに載り切らなかった結果です。使える空きメモリによって速度が変わる点は、事前に確認しておきたいところです。
注意:小さなモデルは事実を誤ります。上の画面の回答は、LlamaをGoogleが2022年に開発したモデルと説明していますが、これは誤りです。LlamaはMetaのモデルです(Meta公式のモデルカード)。3Bクラスの小型モデルは日本語の事実確認に向かないので、業務で使う前に自社の質問で必ず確かめてください。
手順を細かく知りたい方は、Llamaの導入ガイドを参照してください。
Llama 4 の仕様と学習データ(Meta公式モデルカード)
Meta公式のモデルカード(github.com/meta-llama/llama-models・2026年10月19日確認)の記載を表にしました。学習データは、公開されているデータ・ライセンスを受けたデータ・Metaのサービス上の情報(InstagramやFacebookの公開投稿、Meta AIとのやり取りを含む)を混ぜたものと書かれています。公式の対応言語は前の節のとおり12言語です。リリース日は2025年4月5日、ライセンスはLlama 4 Community License Agreementです。
| 項目 | Llama 4 Scout | Llama 4 Maverick |
|---|---|---|
| パラメータ数(有効/総数) | 17B/109B | 17B/400B |
| エキスパート数 | 16 | 128 |
| コンテキスト長 | 10M | 1M |
| 事前学習のトークン数 | 約40T | 約22T |
| 学習データの時点(Knowledge cutoff) | 2024年8月 | 2024年8月 |
| 入力/出力 | 入力は多言語のテキストと画像・出力は多言語のテキストとコード | 同左 |
Meta公式モデルカードのベンチマーク(Llama 4)
性能の数値は、Metaが公開しているLlama 4のモデルカード(github.com/meta-llama/llama-models・2026年10月19日確認)の「Instruction tuned models」の表から、掲載されている値をそのまま抜き出したものです。評価条件はMeta側のもので、自社の業務データでの結果とは別物です。
| ベンチマーク(指標) | Llama 3.3 70B | Llama 3.1 405B | Llama 4 Scout | Llama 4 Maverick |
|---|---|---|---|---|
| MMLU Pro(推論・知識) | 68.9 | 73.4 | 74.3 | 80.5 |
| GPQA Diamond(推論・知識) | 50.5 | 49.0 | 57.2 | 69.8 |
| LiveCodeBench(コード・pass@1) | 33.3 | 27.7 | 32.8 | 43.4 |
| MGSM(多言語の数学) | 91.1 | 91.6 | 90.6 | 92.3 |
| MMMU(画像推論) | 画像非対応 | 画像非対応 | 69.4 | 73.4 |
| ChartQA(画像理解) | 画像非対応 | 画像非対応 | 88.8 | 90.0 |
読み方の目安:Maverick は MMLU Pro・GPQA Diamond・LiveCodeBench で表中の4モデルの中で最も高く、Scout は表中の旧世代2モデルと近い水準です。多言語の数学(MGSM)は4モデルとも90前後で大きな差はありません。ただしこれは数学問題の正答率で、日本語の文章の品質を示す数値ではありません(日本語が公式の対応言語に入っていないことは前の節のとおりです)。
ChatGPT・Gemini・Claudeとの違い
ChatGPT・Gemini・Claudeは、提供元のアプリやAPIを通して使うサービスです。Llamaは、重みを取得して自分の環境に置き、ライセンスの条件の範囲で動かせる点が大きな違いです。社内のデータを外部に出さずに使いたいときや、モデルを自社の用途に合わせて追加学習したいときは、Llamaのようなオープンウェイトのモデルが選択肢になります。その代わり、動かす環境の用意と運用、日本語の品質の確認は自分たちで行う必要があります。
ライセンスと提供形態——日本語システム組み込み前に確認すべき点
Llama 4は「Llama 4 Community License(コミュニティライセンス)」の下で公開されており、MITライセンスやApache 2.0のような無制限のオープンライセンスではない(Llama 4 Community License Agreement、2026年10月12日確認)。日本語特化モデルの構築を含む実務利用を検討する際に特に注意すべき条件を以下に整理します。
| 条件項目 | 内容 |
|---|---|
| 商用利用 | 原則可能。ただし月間アクティブユーザーが7億人超の事業者は別途Metaの許諾が必要 |
| 改変・ファインチューニング | 可能。日本語継続事前学習・SFT・LoRAなどは許諾範囲内 |
| 派生モデルの配布 | 可能。配布するときはライセンス文を添え、関連するサイトや製品資料などに「Built with Llama」と表示する |
| 出力を別のモデルの学習に使う | 禁止する条項はありません。ただし、Llamaやその出力を使って作成・学習・改良したAIモデルを配布・公開する場合は、モデル名の先頭に「Llama」を付ける |
| EUでの利用(マルチモーダルモデル) | EUに居住する個人と、EUに主たる事業所を置く企業には、マルチモーダルモデルのライセンスが付与されません。組み込んだ製品のエンドユーザーは対象外(利用規定) |
| モデルウェイトの取得 | Hugging Faceなどで申請・同意後にダウンロード可能(無料) |
訂正:以前の本記事は「Llama 4の出力を別のLLMの学習データに使うことは禁止」と書いていたが、Llama 4のライセンス本文にその条項はなく、誤りだったため訂正します。ライセンスが定めているのは名前の付け方で、Llamaやその出力を使って作成・学習・改良したAIモデルを配布・公開する場合に、モデル名の先頭に「Llama」を付けることを求めています。産総研の「Llama 3.1 Swallow」のようにLlamaで始まる派生モデルの名前は、この種の条件に沿った付け方です。日本語特化モデルの自社構築を計画する場合は、名前の付け方・表示・EUでの利用制限を、ライセンス本文と利用規定に照らして法務部門と確認することを勧めます。
提供形態は「オープンウェイト(重みの無料ダウンロード)」が基本であり、月額サブスクリプションは存在しません。API経由で利用する場合は、Llama 4を提供する各ホスティングサービスのトークン従量課金になります。単価は事業者ごとに違い、改定も多いため、本記事では金額を載せません。利用する事業者の公式の料金ページで確認してほしいです。なおMeta自身のMeta Model APIの料金ページに載っているのはMuseシリーズで、Llama 4は載っていない(2026年10月12日確認)。
DeepAIとLlama 4——バーチャルヒューマンへの応用可能性
クリスタルメソッド株式会社が開発するDeepAIは、実在の人物の容姿・表情・声・振る舞いをデジタル空間で再現するバーチャルヒューマン/AIアバターソリューションです。リップシンク・表情生成・音声合成・対話AIを組み合わせ、接客・研修・面接練習・広報などの用途で活用される製品です。
Llama 4のような高性能オープンウェイトLLMは、こうしたバーチャルヒューマンの対話エンジンとして組み込む際の選択肢の一つとなりえます。データをクローズドな環境で保持しながら高品質な日本語対話を実現したい場合、プロプライエタリAPIへの依存を避けられるオープンウェイトモデルは設計上の自由度を高めます。ただし、日本語での自然な対話品質を担保するには、前述の継続事前学習や日本語特化派生モデルの採用が現実的な前提条件となります。AIアバター・バーチャルヒューマン技術の応用についてはAI技術の応用事例もあわせて参照してください。
また、AIの技術的加速がもたらす産業・社会的インパクトの全体像についてはシンギュラリティ2045の解説記事でも取り上げています。
まとめ——Llama 4 日本語活用で押さえるべき3点
Llama 4の公式の対応12言語に、日本語は含まれません。日本語の業務で使うには、用途に応じた補強と自社データでの検証が前提になります。
- 産総研Swallowが実証した継続事前学習+SFTが最も根本的な改善手法である。Llama 4を土台にしたSwallowは2026年10月時点で公開一覧に見当たらないため、既存のSwallow系モデルや、Metaの新しいオープンウェイトモデルMuse Glimmerと並べて、同じ日本語の評価データで比べることが重要です。
- Scoutの10Mトークンというコンテキスト長は、長大な文書の一括処理で利点になる。法律文書・業務マニュアル・研究論文群をチャンク分割なしに扱える可能性があります。ただし日本語は公式の対応言語に含まれないため、長文の日本語で精度が保てるかは自社のデータで確かめる必要があります。
- ライセンスで確認すべきは、名前の付け方・表示・EUでの利用制限である。Llamaやその出力を使って作ったモデルを配布するなら名前の先頭に「Llama」を付け、「Built with Llama」と表示します。出力を別のモデルの学習に使うこと自体を禁止する条項はありません。
Llamaシリーズ全体の基礎から体系的に学びたい読者はLlamaとは何かを、具体的なセットアップ手順はLlama導入ガイドを、製造業での活用については製造業AIの基礎をそれぞれ参照してください。
Llamaのよくある質問
Llama(ラマ)とは何ですか?
Metaが公開している大規模言語モデル(LLM)のシリーズです。モデルの重みを取得して自分の環境で動かせる「オープンウェイト」の形で提供されています。世代ごとの違いは「Llamaとは?」の節の表にまとめています。
最新のLlamaはどれですか?
Hugging Faceのmeta-llamaには、Llama 4(ScoutとMaverick)が最新の世代として載っています(2026年10月19日確認)。Llamaの系列でそれより新しい世代は見当たりません。
Llama 4は日本語で使えますか?
Metaが公式に挙げる対応言語は12言語で、日本語は含まれていません。使う場合は、自社の評価データで品質を確かめたうえで、日本語で追加学習した派生モデルやRAGで補います。
Llamaはどうやって使い始めますか?
Ollamaで動かす、Hugging Faceで重みを取得する、AWSのAmazon Bedrockなどのクラウドで使う、の3つが主な方法です。手順は「Llama 4を実際に動かす方法」の節にまとめています。
ChatGPTとの違いは何ですか?
ChatGPTは提供元のサービス経由で使いますが、Llamaは重みを取得して自分の環境に置ける点が大きな違いです。代わりに、環境の用意と運用、日本語の品質確認は自分たちで行います。
AIの業務活用・導入をご検討の方へ
クリスタルメソッドは、各種LLM・ローカルAI・RAG・AIアバターを活用した業務へのAI導入を支援しています。「自社の業務でどう使えるか」をまずはお気軽にご相談ください。
参考文献
- 産業技術総合研究所「日本語に強い大規模言語モデル『Swallow』を公開」(2023年12月)
https://www.aist.go.jp/aist_j/press_release/pr2023/pr20231219/pr20231219.html - 産業技術総合研究所「オープンソースLLMの日本語能力を高めた『Llama 3.1 Swallow』を公開」(2024年10月)
https://www.aist.go.jp/aist_j/press_release/pr2024/pr20241008_2/pr20241008_2.html - 産総研AIRC「継続事前学習による推論型大規模言語モデルの構築」(2026年3月)
https://www.airc.aist.go.jp/seminar_detail/docs/20260316_swallow_aist.pdf - Meta「Llama 4 herd 公式発表ブログ」(2025年4月)
https://ai.meta.com/blog/llama-4-multimodal-intelligence/ - llama.com「Llama 4モデル一覧」(2026年10月12日確認)
https://www.llama.com/models/llama-4/ - Meta「Llama 4 モデルカードとプロンプト形式」(2026年10月12日確認)
https://dev.meta.ai/llama/docs/model-cards-and-prompt-formats/llama4 - Meta「Llama 4 Community License Agreement」(2026年10月12日確認)
https://www.llama.com/llama4/license/ - Meta「Llama 4 Acceptable Use Policy(利用規定)」(2026年10月12日確認)
https://www.llama.com/llama4/use-policy/ - Meta「Muse Glimmer」公式ドキュメント(2026年10月12日確認)
https://dev.meta.ai/docs/muse-glimmer/ - Hugging Face「meta-llama」公開モデル一覧(2026年10月12日確認)
https://huggingface.co/meta-llama - Hugging Face「tokyotech-llm」(Swallowの公開元・2026年10月12日確認)
https://huggingface.co/tokyotech-llm - LLM-jp「日本語LLMまとめ」
https://llm-jp.github.io/awesome-japanese-llm/
Read next
あわせて読みたい
-
Llama バージョン完全比較|選定基準・世代差・日本語対応を解説
本記事は「Llamaのバージョン選定」に特化した解説です。Llamaの基礎概念はLlamaとは?仕組み・活用の解説を、最新Llama 4単体の詳細はLlama ...
-
Llama vs Qwen 比較:2026年版ライセンス・性能・コストの選択指針
llama qwen 比較:2026年時点の基本ポジションと選択の前提 オープンウェイトLLMの実用選択肢として、Meta社のLlamaとAlibaba Clo...
-
Llama導入ガイド|自社環境での構築・推論・運用判断を解説
本ページはLlamaを自社環境へ「導入・運用」するための実践指針に特化しています。Llamaそのものの基礎知識はLlamaとは?仕組み・活用の解説を、最新世代の...