
blog
AIブログ
オープンソースLLM比較一覧|主要モデルの選び方とライセンス【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
オープンソースLLMとは:重みが公開され、自社の環境で動かせる大規模言語モデル
オープンソースLLMとは、学習済みモデルの重み(パラメータ)が公開され、利用者が自分のサーバーやパソコンにダウンロードして動かせる大規模言語モデルのことです。商用で使えるかどうかはモデルごとのライセンスで決まります。Apache 2.0やMITのように制約の少ないものから、利用者数や名称表記に条件があるものまであります。
この記事では、2026年10月時点で公式ページ・モデルカードを確認できた主なモデルを、公開元・サイズ・ライセンスで一覧にし、選び方、ライセンスと商用利用の注意、ローカルでの動かし方までを順に整理します。定義や基礎はオープンソースLLMとは、機械学習全般の位置づけは機械学習の基礎と導入判断で解説しています。
「オープンソース」とは具体的に何を指すのかは、オープンソースLLMの定義・仕組みで解説しています。
オープンソースとオープンウェイトの違い:OSIの定義で見る
OSI(Open Source Initiative)の「Open Source AI Definition 1.0」は、AIシステムを使う・調べる・改変する・共有する、という4つの自由が認められていることを条件にしています。そして、改変するために必要な形として、次の3つが公開されていることを求めています。
- データ情報:学習データの出どころ、取得・選別・加工の方法など、同等のシステムを作れる程度に詳しい情報
- コード:学習と実行に使った完全なソースコード
- パラメータ:重み(ウェイト)などのモデルパラメータ
重みだけを公開し、学習データやコードは公開しないモデルは、一般に「オープンウェイト」と呼ばれます。この記事の一覧では、重みを入手して自社の環境で動かせるモデルを広くオープンソースLLMとして扱っています。OSIの定義に照らすと、次のように分かれます。
- 独自ライセンスのモデル:Llama 4(Llama 4 Community License)、Kimi K3(Kimi K3 License)、Gemma 3(Gemma Terms of Use)、PLaMo(PLaMo Community License)は、独自の利用規約で公開されています。定義はパラメータがOSI承認の条件で公開されることを求めているため、これらをOSIの定義を満たすモデルとは言えません。
- Apache 2.0・MITのモデル:Qwen3.8、Gemma 4、gpt-oss、Mistral Large 3、DeepSeek-V4-Pro、GLM-5.2などは、重みがApache 2.0またはMITで公開されています。ただし、学習データの情報とコードまで定義の要件どおりに公開されているかは、公式ページに記載がないため、この記事では判断していません。
- OLMo 2:重みに加えて、訓練コードと訓練データへのリンクがモデルカードで公開されています。この記事の一覧では最も定義に近い例ですが、OSIの定義を満たすと認められているかは確認していません。
| 比較項目 | オープンソースLLM | クローズドLLM(API提供) |
|---|---|---|
| 重みの入手 | ダウンロードして使えます | 非公開で、APIのみです |
| 実行環境 | 自社サーバー、ローカル、オンプレミス | 提供元のクラウド |
| データの扱い | 外部に送らない運用ができます | 入力がAPIに送信されます |
| 費用 | トークン課金はなく、GPUなどのインフラ費と運用の人手がかかります | 利用したトークン量に応じて課金されます |
| 追加学習 | 自由に実施できます | 提供元のファインチューニングAPIの範囲です |
| 更新管理 | モデルの入れ替えを自分で判断します | 提供元が更新します |
| 商用利用 | ライセンスによって異なります | 利用規約に従います |
金融・医療・法律・官公庁のように機密データを扱う場面や、独自の業務データで深くカスタマイズしたい場面では、データを自社で管理できることが導入の大きな理由になります。
次に読む:オープンソースLLMの商用利用条件は?

オープンソースLLM 一覧:2026年10月時点の主要モデル
新しいモデルは3〜6か月ごとに出てくるため、ここでは各社の公式ページとHugging Faceの公式モデルカードで、公開元・サイズ・ライセンスを確認できたものだけを載せています。サイズは「総パラメータ数(推論時に動く有効パラメータ数)」の順で、コンテキスト長はモデルカードに記載のあるものだけ書いています。
最新世代のモデル
| モデル | 公開元 | サイズとコンテキスト | ライセンス |
|---|---|---|---|
| Qwen3.8-27B | Alibaba(Qwen) | 27B。標準262,144トークン、最大1,000,000トークンまで拡張できます。画像・動画を扱える視覚言語モデルです | Apache 2.0 |
| Gemma 4 | E2B・E4B・12B・26B A4B(MoE、総25.2B・有効3.8B)・31B(密、30.7B)。コンテキストはE2B・E4Bが128K、12B・26B A4B・31Bが256Kです | Apache 2.0 | |
| gpt-oss-120b / gpt-oss-20b | OpenAI | 総117B(有効5.1B)/総21B(有効3.6B)。120bは単一の80GB GPU、20bは16GBのメモリで動作するとされています | Apache 2.0 |
| DeepSeek-V4-Pro / V4-Flash | DeepSeek | Proは総1.6T(有効49B)、Flashは総284B(有効13B)。どちらもコンテキストは1Mです | MIT(Proのモデルカードで確認) |
| GLM-5.2 | Z.ai | 総753B。コンテキストは1Mです | MIT |
| Kimi K3 | Moonshot AI | 総2.8T(有効104B)。コンテキストは1,048,576トークンです | Kimi K3 License(独自) |
| Mistral Large 3 | Mistral AI | 総675B(有効41B)のMoE。コンテキストは256K、入力はテキストと画像です | Apache 2.0 |
| Llama 4 Scout / Maverick | Meta | Scoutは総109B(有効17B、コンテキスト10M)、Maverickは総400B(有効17B、コンテキスト1M) | Llama 4 Community License |
Gemma 4は、前世代のGemma 3がGemma Terms of Useだったのに対し、Apache 2.0で公開されています。Gemma 4は2026年4月2日にGoogleの公式ブログで発表され、gpt-ossは2025年8月5日にOpenAIが公開しました。ほかのモデルは、モデルカードに公開日の記載がないため日付を省いています。
前世代・用途特化のモデル
| モデル | 公開元 | サイズとコンテキスト | ライセンス |
|---|---|---|---|
| Gemma 3 | 1B・4B・12B・27B。コンテキストは4B以上が128K、1Bが32Kで、入力はテキストと画像です | Gemma Terms of Use | |
| Phi-4 | Microsoft | 14B。コンテキストは16Kです(2024年12月12日) | MIT |
| OLMo 2 | Ai2(Allen Institute for AI) | 7B・13B。コンテキストは4,096トークンです。重みに加え、訓練コードと訓練データへのリンクが公開されています | Apache 2.0 |
| Llama 3.1 Swallow | 産業技術総合研究所・東京科学大学ほか | 8B・70B(Llama 3.1に日本語で追加学習。2024年10月8日発表) | Llama 3.1ライセンス |
DeepSeekはV4の前にV3とR1を公開しており、Mistralも以前は研究用ライセンスのモデルを出していました。Mistralは汎用モデルでApache 2.0を使い続ける方針を発表しており、Large 3もApache 2.0です。古い記事に載っている旧世代のライセンスは、最新のモデルカードで確かめてから判断してください。
オープンソースLLMの選び方:用途と環境から絞り込む
最も点数の高いモデルを選ぶのではなく、ライセンス、動かせる環境、言語、入力の種類、コンテキスト長の順に条件を絞ります。ベンチマークの比較は、この条件で候補を2〜3個に絞ってから、自社のデータで確かめる作業です。
| 条件 | 候補 | 理由 |
|---|---|---|
| 1台のGPUで動かしたい | gpt-oss-120b / gpt-oss-20b | 120bが単一の80GB GPU、20bが16GBのメモリで動作するとされています |
| 画像も入力したい | Gemma 4、Qwen3.8-27B、Mistral Large 3 | Gemma 4はテキストと画像(E2B・E4Bは音声も)、Qwen3.8-27Bは画像と動画、Mistral Large 3はテキストと画像を入力できます |
| 長い文書をまとめて読ませたい | DeepSeek-V4、GLM-5.2、Kimi K3、Llama 4 Scout | コンテキストが1M以上、ScoutはInstruct版で10Mです |
| 制約の少ないライセンスで商用利用したい | Apache 2.0またはMITのモデル | Qwen3.8、Gemma 4、gpt-oss、Mistral Large 3、DeepSeek-V4-Pro、GLM-5.2が該当します |
| 小さなモデルで試したい | Gemma 4のE2B・E4B、gpt-oss-20b | Gemma 4のE2B・E4Bは実効2.3B・4.5Bで、軽量な用途向けのサイズです |
| 学習データや訓練コードまで確認したい | OLMo 2 | 重みに加えて、訓練コードと訓練データへのリンクが公開されています |
動かすのに必要なメモリの目安
モデルの重みを置くのに必要なメモリは、パラメータ数に1パラメータあたりのバイト数を掛けて見積もれます。これは計算上の目安で、実際にはこれに加えて、会話の履歴を保持する領域と実行環境の分が必要です。
| 精度 | 1パラメータあたり | 27Bモデル | 70Bモデル |
|---|---|---|---|
| FP16 | 2バイト | 約54GB | 約140GB |
| 8bit | 1バイト | 約27GB | 約70GB |
| 4bit | 約0.5バイト | 約13.5GB | 約35GB |
MoEのモデルは、動くのは有効パラメータ分ですが、重みとしては総パラメータ分をメモリに置く必要があります。たとえばgpt-oss-120bは総117Bですが、公開元は4bit系の量子化(MXFP4)にして単一の80GB GPUに収まると説明しています。
日本語で使うモデル
日本語を重視する場合は、日本の組織が公開しているモデルも候補になります。いずれも公式のモデルカードやプレスリリースで確認した内容です。
| モデル | 公開元 | サイズ | ライセンス |
|---|---|---|---|
| Llama 3.1 Swallow | 産業技術総合研究所・東京科学大学ほか | 8B・70B | Llama 3.1ライセンス |
| Sarashina2.2 | SB Intuitions | 0.5B・1B・3B(instruct版を確認) | MIT(テキストLLM) |
| PLaMo | Preferred Networks | 2・3世代は8B〜31B級などを公開 | PLaMo Community License |
Sarashina2.2は、同じシリーズでも音声合成モデルは非商用ライセンスのため、モデルごとにライセンスを確認してください。PLaMoの新しい世代はHugging Faceで規約への同意が必要で、商用利用には事前登録が必要です。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
ライセンスと商用利用の注意点
ライセンスの確認は、モデル選定の最初のフィルタです。商用で使う場合は、Apache 2.0かMITのモデルが最も扱いやすく、それ以外は条件を読んでから採用を決めます。
| ライセンス | 代表的なモデル | 主な注意点 |
|---|---|---|
| Apache 2.0 | Qwen3.8、Gemma 4、gpt-oss、Mistral Large 3、OLMo 2 | 商用利用・改変・再配布ができます。著作権表示とライセンス文の同梱が必要です |
| MIT | DeepSeek-V4-Pro、GLM-5.2、Phi-4、Sarashina2.2(テキストLLM) | 著作権表示の維持が条件で、制約が最も少ないライセンスのひとつです |
| Llama 4 Community License | Llama 4 Scout / Maverick | 前月の月間アクティブユーザーが7億人を超える場合はMetaへの許諾申請が必要です。配布する製品や文書に「Built with Llama」の表示が必要で、派生モデルの名称は「Llama」で始める必要があります |
| Gemma Terms of Use | Gemma 3 | Gemma 4と異なり独自の利用規約です。組み込む前に規約全文を確認してください |
| Kimi K3 License | Kimi K3 | 独自のライセンスです。条件はモデルに同梱されたLICENSEで確認してください |
| PLaMo Community License | PLaMo 2以降 | 商用利用には事前登録が必要です。再配布では「Built with PLaMo」の表示が求められ、派生モデルの名称にもPLaMoを含める必要があります |
ライセンスとは別に、学習データに著作権で保護されたコンテンツや個人データが含まれていた場合のリスクは、利用する事業者の側で考える必要があります。同じ名前のモデルでも、サイズや派生版ごとにライセンスが異なることがあるため、導入するモデルのカードを必ず確認してください。
ローカルで動かす・追加学習する・守る:導入時の三つの論点
ローカルでの動かし方と量子化
自分のパソコンやサーバーで動かすには、Ollama、LM Studio、llama.cppのような実行ツールを使うのが一般的です。量子化は、重みを16bitから4bitなどの低いビット数で表して、メモリ使用量を減らす方法です。llama.cppのGGUF形式ではQ4_K_Mがよく使われますが、ビット数を下げるほどメモリは減る一方で、品質は下がる方向に動きます。用途に合うかは、自社のデータで比べて判断してください。
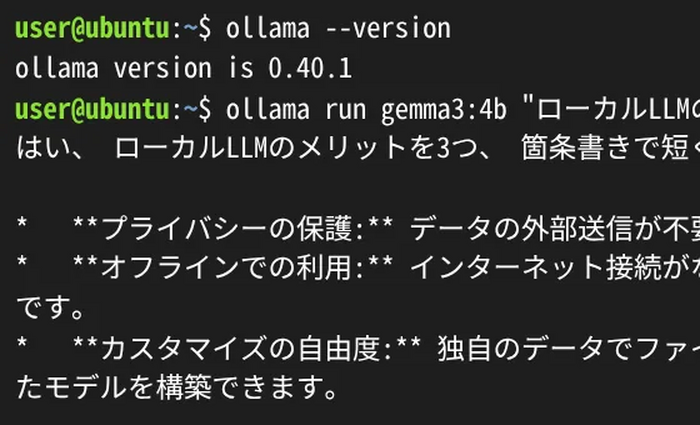
インストールから基本コマンドまでの手順はOllamaのインストール方法、日本語で使うモデルの選び方はOllamaの日本語モデルの選び方で解説しています。
追加学習(ファインチューニング)の主な方法
- フルファインチューニング:全パラメータを更新します。品質は得やすい一方で、GPUと時間の負担が大きい方法です。
- LoRA(Low-Rank Adaptation):元の重みを固定し、小さな差分だけを学習します。必要なメモリを抑えられ、Hugging FaceのPEFTライブラリで実装できます。
- QLoRA:LoRAを4bit量子化と組み合わせて、さらにメモリを抑える方法です。
- DPO(Direct Preference Optimization):好ましい回答と好ましくない回答の比較から、企業のルールや文体に沿った出力を学習させる方法です。
セキュリティと運用上の留意点
オンプレミスで運用すれば、データを外部に出さずに済みます。一方で、次のリスクは自分たちで管理する必要があります。
- 脆弱性管理:推論フレームワーク、コンテナ、OSのパッチを自組織で適用します。
- プロンプトインジェクション:悪意のある入力で挙動を操作されるおそれがあるため、入力の検証と出力の確認が必要です。
- アクセス制御:APIエンドポイントの認証・認可を実装しないと、内部ネットワークから無制限に使われるおそれがあります。
- ハルシネーション:クローズド・オープンを問わず起こるため、事実確認が必要な用途ではRAGなどの併用と、人によるレビューの仕組みが必要です。
新しいモデルが短い周期で出るため、特定のモデルに依存しないように、OllamaやvLLMのような実行層を挟んで、モデルを差し替えやすい構成にしておくと、長期の運用で手戻りを減らせます。
まとめ:オープンソースLLM 一覧から最適なモデルを選ぶ判断軸
最終的には、自社のデータと業務で評価した結果が最も重要です。候補を2〜3個に絞り、実データでPoC(概念実証)を行ってから導入を判断してください。
- 商用利用の自由度を優先するなら:Apache 2.0またはMITのモデル(Qwen3.8、Gemma 4、gpt-oss、Mistral Large 3、DeepSeek-V4-Pro、GLM-5.2)
- 1台のGPUで動かすなら:gpt-oss-120b(80GB)、gpt-oss-20b(16GB)
- 画像も扱うなら:Gemma 4、Qwen3.8-27B、Mistral Large 3
- 長い文書を扱うなら:コンテキスト1M以上のDeepSeek-V4、GLM-5.2、Kimi K3、Llama 4
- 日本語を重視するなら:Llama 3.1 Swallow、Sarashina2.2、PLaMo(ライセンスは個別に確認)
- 学習データや訓練コードまで確認したいなら:OLMo 2
なお、クリスタルメソッド株式会社が開発するDeepAIは、実在の人物の容姿・表情・声・振る舞いをデジタル空間で再現するバーチャルヒューマン/AIアバターソリューションです。対話AIの部分にオープンソースLLMを組み合わせることで、プライバシー要件の厳しい用途にも対応を検討できます。
参考文献
- Google「Gemma 4」公式ブログ(2026年4月2日)
https://blog.google/innovation-and-ai/technology/developers-tools/gemma-4/ - Google AI for Developers「Gemma 4 model card」
https://ai.google.dev/gemma/docs/core/model_card_4 - OpenAI「gpt-oss-120b」Hugging Faceモデルカード
https://huggingface.co/openai/gpt-oss-120b - Qwen「Qwen3.8-27B」Hugging Faceモデルカード
https://huggingface.co/Qwen/Qwen3.8-27B - DeepSeek「DeepSeek-V4-Pro」Hugging Faceモデルカード
https://huggingface.co/deepseek-ai/DeepSeek-V4-Pro - Z.ai「GLM-5.2」Hugging Faceモデルカード
https://huggingface.co/zai-org/GLM-5.2 - Moonshot AI「Kimi K3」Hugging Faceモデルカード
https://huggingface.co/moonshotai/Kimi-K3 - Mistral AI「Mistral-Large-3-675B-Instruct-2512」Hugging Faceモデルカード
https://huggingface.co/mistralai/Mistral-Large-3-675B-Instruct-2512 - Meta「Llama 4 Community License Agreement」
https://dev.meta.ai/llama/llama4/license/ - Meta「The Llama 4 herd」
https://ai.meta.com/blog/llama-4-multimodal-intelligence/ - Microsoft「phi-4」Hugging Faceモデルカード
https://huggingface.co/microsoft/phi-4 - Ai2「OLMo-2-1124-13B」Hugging Faceモデルカード
https://huggingface.co/allenai/OLMo-2-1124-13B - SB Intuitions「sarashina2.2-3b-instruct-v0.1」Hugging Faceモデルカード
https://huggingface.co/sbintuitions/sarashina2.2-3b-instruct-v0.1 - Open Source Initiative「Open Source AI Definition 1.0」
https://opensource.org/ai/open-source-ai-definition - Preferred Networks「PLaMo 3 NICT」Hugging Faceモデルカード
https://huggingface.co/pfnet/plamo-3-nict-2604-31b-base - 産業技術総合研究所(AIST)「オープンソースLLMの日本語能力を高めた『Llama 3.1 Swallow』を開発」(2024年10月)
https://www.aist.go.jp/aist_j/press_release/pr2024/pr20241008_2/pr20241008_2.html - IPA「オープンソースソフトウェア(OSS)最新情報」
https://www.ipa.go.jp/archive/digital/kaihatsu/oss/news.html - Classmethod DevelopersIO「2026年のローカルLLM事情を整理してみた」
{"@context":"https://schema.org","@type":"BlogPosting","headline":"オープンソースLLM 一覧|主要モデルの仕様・ライセンス・用途を徹底解説【2026年版】","description":"オープンソースLLM 一覧を提供元・パラメータ規模・ライセンス・日本語対応・代表用途まで網羅。Llama・Mistral・Qwen・DeepSeek・Gemma・Phi・Swallowなど主要モデルを比較表と各論で詳解。導入判断に必要な情報を経営・事業責任者の視点で整理する。","image":["https://crystal-method.com/wp2020/wp/wp-content/uploads/2026/06/open-source-llm-list-photo.jpg.webp"],"datePublished":"2026-06-03T02:00:13+00:00","dateModified":"2026-10-23T11:12:45+00:00","author":{"@type":"Person","name":"河合 継","jobTitle":"代表取締役","worksFor":{"@type":"Organization","name":"クリスタルメソッド株式会社"}},"publisher":{"@type":"Organization","name":"クリスタルメソッド株式会社","url":"https://crystal-method.com/","logo":{"@type":"ImageObject","url":"https://crystal-method.com/inc/img/logo.webp"}},"mainEntityOfPage":{"@type":"WebPage","@id":"https://crystal-method.com/blog/open-source-llm-list/"}}LLM・ローカルLLMの業務導入をご検討の方へ
クリスタルメソッドは、オープンモデル・ローカルLLMの選定からRAG構築・PoC・本番導入までのAI開発を支援しています。「機密データを外部に出さずにLLMを使いたい」「自社の業務に合うモデルを選びたい」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-

オープンソースLLMとは?定義・仕組み・主要モデルを基礎から解説
本記事は「オープンソースLLMとは何か」という問いに絞り、定義・仕組み・ライセンスの構造を体系的に解説することを目的としています。具体的なモデルの網羅的な一覧や...
-
オープンソースLLM商用利用の条件整理|Llama・Gemma・Apache系のライセンス注意点
オープンソースLLMの商用利用——「フリー」という言葉が隠す三層構造 「オープンソースLLM 商用利用」を調べる経営・事業責任者の多くが最初に直面するのは、「モ...
-
VOICEVOX 使い方|インストールから音声生成まで【2026】
VOICEVOXは無料?商用利用・クレジット表記の結論 VOICEVOXは、商用・非商用を問わず無料で使える音声合成ソフトです。ただし「VOICEVOXを利用し...