
blog
AIブログ
ベクトルデータベースとは?仕組み・主要DB比較・選び方をわかりやすく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
ベクトルデータベースとは、文章や画像などをAIで数値の並び(ベクトル)に変換して保存し、キーワードの一致ではなく「意味の近さ」で高速に検索できるデータベースです。RAG(検索拡張生成)や類似検索、レコメンドの土台として使われています。
「ベクトルデータベース」という言葉を耳にする機会が増えたものの、従来のデータベースと何が違うのか、なぜ今これほど注目されているのか、疑問をお持ちの方も多いのではないでしょうか。本記事では、ベクトルデータベースの仕組みから種類・用途・選び方までを、実際に動かした結果と、各社の公式ページで2026年10月20日に確認した無料枠・提供形態を交えて、体系的に解説します。
迷ったらこの3タイプから選びます(結論)
| タイプ | 代表例 | 向く場面 | 費用のかかり方 |
|---|---|---|---|
| フルマネージドの専用DB | Pinecone、Zilliz Cloud(Milvus)、Weaviate Cloud、Qdrant Cloud、Vertex AI Vector Search | 運用の手間を減らして、数千万件規模まで伸ばしたい | 保存量や読み書きの量に応じた従量課金が中心 |
| OSSを自前で運用 | Milvus、Qdrant、Weaviate、Chroma | 機密データを自社環境に置きたい、構成を細かく決めたい | ソフトは無料。サーバー代と運用の手間がかかる |
| 既存DBの拡張 | pgvector(PostgreSQL)、sqlite-vec(SQLite) | いまのDBを使っていて、件数が数万件程度から始めたい | 拡張は無料。いまのDBの費用の範囲で動く |
まず既存DBの拡張で試し、件数や応答速度が足りなくなったら専用DBへ移す順番が、過剰投資を避けやすい進め方です。製品ごとの違いは「主要8製品の比較」、一覧はベクトルデータベース一覧にまとめています。
ベクトルデータベースとは:従来のデータベースとの違い
ベクトルデータベースとは、データを「ベクトル(多次元の数値配列)」という形式で格納し、ベクトル間の類似度を高速に検索するために特化したデータベースです。テキスト・画像・音声・動画など、あらゆる非構造化データをAIモデルが生成した数値表現(Embedding:埋め込みベクトル)として保存し、「意味的に近いデータ」を瞬時に見つけ出せる点が最大の特徴です。
従来のリレーショナルデータベース(RDB)は「東京都在住のユーザーを全員抽出せよ」のような条件完全一致型の検索を得意とします。一方、ベクトルデータベースが得意とするのは「この文章と意味が似ているドキュメントを探せ」という曖昧・類似検索です。この違いが、生成AI時代における急速な普及を後押ししています。
なぜ今注目されているのかは、主に3つの変化が重なったためです。①ChatGPTなどの生成AIが広がり、社内資料や最新情報をLLMに参照させるRAG(検索拡張生成)の需要が増えたこと。②文書・画像・音声といった、表にしにくい非構造化データが業務で大量に扱われるようになったこと。③キーワードの一致では拾えない「言い換え」や「文脈の近さ」で探したいというニーズが、検索やレコメンドで強まったことです。
データベース比較:従来型 vs ベクトルデータベース
| 比較軸 | リレーショナルDB(RDB) | ベクトルデータベース |
|---|---|---|
| 格納形式 | 行・列(表形式) | 高次元ベクトル(数値配列) |
| 検索方式 | 完全一致・範囲条件(SQL) | 近似最近傍探索(ANN) |
| 得意なデータ | 構造化データ(数値・日付・カテゴリ) | 非構造化データ(テキスト・画像・音声) |
| 検索の性質 | 条件が合えば正確 | 意味・文脈の類似度で検索 |
| 主な用途 | 業務システム・在庫管理・会計 | RAG・推薦・類似画像検索 |
NoSQL・全文検索エンジンとの違い
「RDBではなくNoSQLなら足りるのでは」と考える方もいます。MongoDBのようなドキュメントDBやキーバリューストアなどのNoSQLは、柔軟な形のデータをキーや項目の条件で素早く取り出すことが得意で、「意味が近いものを探す」ことを目的に作られているわけではありません。一方で近年は、検索エンジンやクラウドの検索サービスにもベクトル検索が組み込まれています。たとえばAmazon OpenSearch Serviceは k-NN 機能で、ユークリッド距離またはコサイン類似度による近傍検索ができます(AWS公式ドキュメント)。Azure AI Searchも、ベクトル検索と全文検索を同じリクエストで実行するハイブリッド検索に対応しています(Microsoft公式ドキュメント)。つまり「専用のベクトルデータベースを選ぶか、使っているDBや検索エンジンの機能で足りるか」が、実際の選択の分かれ目になります。
ベクトルデータベースを無料で試し始めるときは、無料プランで選ぶベクトルデータベース比較で解説しています。
ベクトル(Embedding)の仕組み:なぜ数値配列で意味を表せるのか
ベクトルデータベースの前提として、まず「Embedding(埋め込み)」の仕組みを理解する必要があります。Embeddingとは、テキストや画像などの情報を、AIモデルが多次元の数値配列に変換したものです。
たとえば「犬」「猫」「自動車」という3つの単語があるとします。Embeddingでは、意味的に近い「犬」と「猫」は数値空間上でも近い位置に、意味的に遠い「自動車」は離れた位置にマッピングされます。この「意味の近さ=数値の近さ」という関係性こそが、ベクトル検索の根幹です。
Embeddingの生成からベクトル検索までの流れ
ベクトルどうしの近さは、主にコサイン類似度・ユークリッド距離(L2距離)・内積の3つで測ります。文章の検索ではコサイン類似度が広く使われます。3つの違いと使い分けは、後半の「距離尺度の使い分け」で解説します。
次に読む:ベクトルデータベースは用途別にどう選ぶ?
近似最近傍探索(ANN):大規模データでも高速に検索できる理由
数百万・数億件のベクトルを格納した場合、全件と距離を計算する「全探索(KNN)」では時間がかかりすぎます。そこでベクトルデータベースが採用しているのが近似最近傍探索(Approximate Nearest Neighbor:ANN)です。ANN は厳密には最も近いベクトルでなくても、十分に近いベクトルを高速に返すアルゴリズムです。
実務上、ANNアルゴリズムの選択はパフォーマンスに直結します。主要なアルゴリズムを以下に整理します。
| アルゴリズム | 概要 | 特徴 | 主な採用DB |
|---|---|---|---|
| HNSW | 階層的グラフ構造 | 検索速度・精度のバランスが良いです。メモリ消費大 | Weaviate、Milvus、pgvector |
| IVF(転置ファイル) | クラスタリング+検索 | 大規模データに強いです。クラスタ数の調整が必要 | FAISS、Milvus |
| PQ(積量子化) | ベクトルを圧縮保存 | メモリ効率が高いです。精度はやや低下 | FAISS、Milvus |
| ScaNN / DiskANN | ScaNNはGoogle、DiskANNはMicrosoftが開発したANN | 超大規模向け。ディスクベースで省メモリ | Vertex AI Vector Search |
RAGシステムの実務では、HNSWを用いる場面が最も多く、検索レイテンシを数十ミリ秒以内に抑えながら十分な再現率を得られています。ただしデータ量が数千万件を超える場合はIVFとPQを組み合わせたメモリ効率重視の設計に切り替えることも選択肢に入ります。
ベクトルデータベースのメリット
- 言い換え・表記ゆれに強い:「自動車」と「クルマ」のように文字が違っても、意味が近ければ見つかります。
- 文章・画像・音声などをそのまま検索対象にできる:AIモデルで数値のベクトルにすれば、表形式にしにくいデータも同じ方法で探せます。
- 件数が増えても速い:近似最近傍探索(ANN)で、全件と比べずに近いものを返します。
- LLMに社内の資料を渡せる:RAGで、質問に関係する資料だけを探してLLMに文脈として渡せます。
反対に、完全一致や数値の範囲での検索はRDBや全文検索のほうが向いています。使い分けは後の「導入判断」の章で整理しています。
ベクトルデータベースのデメリット・限界と注意点
ベクトルDBは万能ではありません。正確な理解のために、主な制約も把握しておきましょう。
- 検索結果の説明可能性が低い:なぜその文書がヒットしたのかをSQLのように明示的に説明しにくいです。ブラックボックス的な側面があります
- Embeddingモデルの品質に依存する:使用するEmbeddingモデルが低品質だと、どれだけ高性能なDBを使っても検索精度は上がりません。モデル選定と評価が重要です
- 数値・日付の範囲検索は苦手:「売上が100万円以上の案件を検索せよ」という条件検索はRDBのほうが得意です。ハイブリッド構成やメタデータフィルタで補う必要があります
- ベクトルのストレージコスト:1536次元のOpenAI Embeddingは1件あたり約6KBのフロート配列。数億件になるとストレージ・メモリコストが無視できません。量子化(PQ)による圧縮が有効ですが、精度とのトレードオフがあります
- インデックス再構築コスト:大量のデータ追加・更新時にHNSWインデックスの再構築が必要な場合があり、その間の検索精度低下やコストも考慮する必要があります
ベクトルデータベースの主な活用事例
ベクトルデータベースはすでにさまざまな領域で実用されています。それぞれの事例とともに、なぜベクトルDBが必要なのかを整理します。
RAG(検索拡張生成):LLMの知識を補完する
最も注目度の高い用途がRAGです。GPTやClaude、Geminiといった大規模言語モデル(LLM)は学習データのカットオフ以降の情報や、社内固有の専門知識を持ちません。RAGでは「質問をベクトル化 → 社内ドキュメントのDBから関連チャンクを検索 → LLMへ文脈として渡す」というパイプラインを組み、LLMがその文脈に基づいて回答を生成します。
これにより、LLMをファインチューニングするコストをかけずに「社内FAQに答えるチャットボット」「最新の製品仕様を踏まえた問い合わせ対応」が実現します。実務でも、社内ナレッジをベクトルDBに格納してLLMと連携させるRAG構成が最も導入効果を実感しやすいパターンです。どのLLMを選ぶかによってRAGの精度も変わるため、主要なAIモデルの比較も参考にしてください。
ベクトルデータベースでハルシネーションは減らせるか
ベクトルデータベース自体が誤りを減らすわけではありません。減らす助けになるのは、そこから取り出した資料を根拠として渡し、「資料にあることだけで答える」よう指示するRAGの使い方です。ただし、検索で関係のない資料が上位に来れば、的外れな根拠から答えてしまいます。誤りを減らすには、埋め込みモデルの選定・チャンクの切り方・ハイブリッド検索で検索の質を上げることと、取り出した資料を出典として画面に出し、人が確かめられるようにすることが大切です。
レコメンデーションエンジン
ECサイトや動画配信プラットフォームにおける「あなたへのおすすめ」機能は、ユーザーの行動履歴や商品の特徴をベクトル化し、類似ベクトルを持つアイテムを返すことで実現されています。従来の協調フィルタリングに比べて「コールドスタート問題(新商品・新規ユーザーへの対応)」を緩和できる点が評価されています。
セマンティック検索(意味検索)
キーワード検索では「自動車」と「クルマ」は別のトークンとして扱われますが、ベクトル検索では同じ意味領域のベクトルとして近くにマッピングされます。そのため表記ゆれ・同義語・言い換えを自動吸収した検索体験が実現します。ドキュメント管理システム・社内Wiki・法律文書の検索などで特に威力を発揮します。
画像・マルチモーダル検索
CLIP(OpenAI)などのマルチモーダルモデルを使えば、テキストと画像を同じベクトル空間にマッピングできます。「テキストで画像を検索」「似た画像を検索」という用途に活用され、ファッションECの類似商品検索や医療画像の検索システムで実用化されています。
異常検知・不正検出
正常なデータのベクトル群から大きく外れた点(アウトライア)を検出する手法として活用されます。ネットワークの不審な通信パターンや金融取引の不正検知に用いられます。
主要ベクトルデータベース8製品の比較と料金の考え方
「ベクトルデータベース 比較」で検索する方の多くは、まず主要製品の全体像を横並びで把握したいはずです。各社公式サイトで確認できた提供形態・検索方式のみを一覧にしました(未確認の料金・処理速度などの数値は記載していません)。
| 製品名 | 提供形態 | クラウド/マネージド版 | ハイブリッド検索(キーワード+ベクトル) |
|---|---|---|---|
| Pinecone | マネージドサービス(SaaS) | あり | 対応(ベクトル・キーワード・フィルタリングを組み合わせ可能) |
| Weaviate | OSS | あり(Weaviate Cloud) | 対応(hybrid()メソッドでネイティブ提供) |
| Milvus | OSS | あり(Zilliz Cloud) | 対応(密ベクトルと疎ベクトルを組み合わせるマルチベクトルのハイブリッド検索) |
| Qdrant | OSS | あり(Qdrant Cloud/Hybrid Cloud/Private Cloud) | 対応(Dense+Sparseのネイティブハイブリッド検索、BM25・SPLADE++等サポート) |
| Chroma | OSS | あり(Chroma Cloud) | 対応(Chroma CloudのSearch APIで、密ベクトルと疎ベクトルの結果をRRFで統合) |
| pgvector | OSS(PostgreSQL拡張) | 各種マネージドPostgreSQLサービス経由で利用可 | PostgreSQLの全文検索機能と組み合わせて実装可能 |
| OpenSearch | OSS | あり(Amazon OpenSearch Service等) | ベクトル検索エンジンを搭載(ハイブリッド構成は個別設定で対応) |
| Vertex AI Vector Search | Google Cloud提供サービス | GCP上で提供 | 対応(意味検索とキーワード検索を組み合わせるハイブリッド検索を公式がサポート) |
料金の考え方
費用のかかり方は、提供形態で大きく3つに分かれます。金額は各社の料金ページで変わるため、ここでは考え方だけを整理します。
| 提供形態 | 費用のかかり方 | 気をつける点 |
|---|---|---|
| 既存のデータベースに足す(pgvector・sqlite-vecなど) | 拡張機能そのものは無料。いま使っているデータベースの費用の範囲で動く | 件数が増えると、メモリやディスクの増強が必要になる |
| OSSを自分で運用する(Milvus・Qdrant・Weaviate・Chromaなど) | ソフトウェアは無料。サーバー代と運用の手間がかかる | 監視・バックアップ・バージョンアップを自分たちで行う |
| マネージドサービス(Pinecone、各OSSのクラウド版など) | 保存量や読み書きの量に応じた従量課金が中心 | 無料枠の範囲、最低利用料の有無、データの置き場所(国・リージョン)を確認する |
主なマネージドサービスの無料枠(公式)
各社の公式料金ページで確認した無料の範囲です(2026年10月20日確認)。無料枠は変更されるため、契約前に必ず公式ページで確認してください。
| サービス | 無料の範囲 | 有料の目安・注意点 |
|---|---|---|
| Pinecone(Starter) | 保存2GB・書き込み月200万・読み取り月100万・インデックス5つまで | リージョンはAWSのus-east-1のみ。Standardは月額最低利用料50ドル |
| Qdrant Cloud(Free) | 1ノード(0.5vCPU・1GBメモリ・4GBディスク)。公式に「Free forever」 | 用途は試作・テスト向けと案内。有料は従量課金 |
| Weaviate Cloud(Free) | 1クラスタ・10万オブジェクト・メモリ1GB・ディスク10GB・コレクション1・テナント3 | 期限のない無料プラン。埋め込み生成は1日2,000リクエスト。Flexは月額45ドルから |
| Chroma Cloud(Starter) | 月額0ドル+従量課金。5ドル分の無料クレジット付き | 保存1GiBあたり月0.33ドル・書き込み1GiBあたり2.50ドル |
| Zilliz Cloud(Free) | 1組織1クラスタ・保存5GB・月250万vCU | Milvusのマネージド版。無料枠の細目は公式ドキュメントで確認 |
大手クラウドのベクトル検索サービス(公式)
専用のベクトルデータベースを新たに契約せず、すでに使っているクラウドの機能で始める選択肢もあります。各社の公式ドキュメントで確認できた特徴です(2026年10月20日確認)。
| サービス | 特徴(公式の記載) | 向く場面 |
|---|---|---|
| Amazon S3 Vectors | ベクトルを保存・検索できるオブジェクトストア。1インデックスに最大20億ベクトル、1バケットに最大1万インデックス。最も速い暖機後のクエリ遅延は100ミリ秒。Amazon Bedrock Knowledge BasesとのRAG連携を案内 | ベクトルの量が多く、保存コストを抑えたいとき。頻繁に検索するベクトルはOpenSearchへ移す使い方も案内 |
| Amazon OpenSearch Service | k-NN検索に対応し、ユークリッド距離またはコサイン類似度で近傍検索。knn_vectorは1項目に最大1万次元 | すでにOpenSearchで全文検索をしていて、ベクトル検索を足したいとき |
| Azure AI Search | ベクトル検索・ハイブリッド検索・絞り込み付きベクトル検索に対応。ベクトル検索は全リージョン・全階層で追加料金なし(埋め込み生成の費用は別) | Azure上のデータ(Blob・Cosmos DBなど)からRAGを組むとき |
| Google Vertex AI Vector Search | Google Researchの技術に基づく検索エンジンで、ScaNNアルゴリズムを使用。密ベクトルと疎ベクトルを使うハイブリッド検索に対応 | Google Cloud上で大規模な類似検索・推薦を組むとき |
クリスタルメソッドが選定で重視した軸
DeepAIアバターやAI面接・AIロープレでRAG検索を実装する中では、上表のうち「ハイブリッド検索への対応度」と「固有名詞・専門用語の検索精度」を特に重視して製品選定が行われました。後半の「実運用で分かったベクトルデータベースの勘所」で触れるとおり、ベクトル検索単体では固有名詞の完全一致が弱くなる場面があり、キーワード検索と組み合わせられる製品を優先する判断をしています。スペック表の比較だけでなく、こうした自社の実装判断も選定材料に加えることをおすすめします。
導入判断:専用ベクトルデータベースを入れるべきか、見送ってよいか
製品を比べる前に、多くの現場が最初につまずくのは「そもそも専用のベクトルデータベースが必要なのか」という一段手前の判断です。ここを飛ばして製品比較から入ると、既存の仕組みで足りたのにインフラを一つ増やしてしまう、という過剰投資が起きがちです。以下を導入可否のゲートとして使ってください。
導入を前向きに検討すべきサイン(3つ)
- 意味・類似での検索が本質的に必要:キーワード一致では拾えない「言い換え」「文脈の近さ」で引き当てたい(RAGの根拠検索、FAQ・問い合わせの意味マッチ、レコメンドなど)。
- ベクトル件数が増え続け、総当たり計算が現実的でなくなってきた:類似度計算の対象が大きくなり、アプリ側の逐次計算やインメモリ処理でレイテンシが目に見えて悪化しています。
- メタデータ絞り込み+類似検索を同時に、低レイテンシで回したい:「特定ユーザー/期間/カテゴリに限定したうえで近いものを返す」を本番の応答速度で満たす必要があります。
導入を見送ってよい(まず別手段で足りる)ケース(3つ)
- 探すのが完全一致・キーワードで十分:ID検索、タグ・属性の絞り込み、語の一致が要件なら、既存のRDBや全文検索(BM25系)のほうが速く・安く・運用も楽。
- 対象件数が小さく、変化も少ない:扱うベクトルが少量なら、専用DBを立てずライブラリ(FAISS等)やインメモリの近似最近傍で足りることが多いです。運用対象を増やさない判断が有効。
- すでにPostgresを運用していて、要件がその延長で収まる:まずは pgvector で既存DB内に閉じて検証し、規模・レイテンシ要件が超えてから専用DBへ移す、という段階的な入り方が現実的。
「何で検索するか」の1行使い分け
ベクトルデータベースは万能の置き換えではなく、検索方式の選択肢の一つです。要件に応じて次のように住み分けます。
| 検索方式 | 得意なこと | 向く場面(1行) |
|---|---|---|
| キーワード/全文検索(BM25系) | 語の一致・厳密なヒット | 固有名詞・型番・完全一致で確実に当てたいとき。 |
| RDBの絞り込み(WHERE/インデックス) | 属性・範囲での正確な抽出 | ID・カテゴリ・期間など構造化条件で引くとき。 |
| ベクトル検索(ベクトルDB) | 意味・文脈の近さ | 言い換えや文意の類似で拾いたいとき(RAGの根拠検索など)。 |
| ハイブリッド(全文+ベクトル) | 一致と意味の両取り | キーワード一致も意味の近さも両立させたい本番検索。 |
迷ったら「まず既存手段(全文検索・pgvector)で検証 → 規模やレイテンシで頭打ちになったら専用のベクトルデータベースへ移行」という順序が、過剰投資を避けつつ失敗を減らす現実的な進め方です。具体的な製品比較・ユースケース別の選定は、前の章「主要ベクトルデータベース8製品の比較」で整理しています。
ベクトルデータベースの導入時に考慮すべきポイント
ベクトルDBの導入を検討する際は、以下の観点を整理することで適切な選択が可能になります。
データ規模とスケーラビリティ
格納するベクトル数が数万件程度なら、ChromaやpgvectorのシングルノードでもQPS(1秒あたりのクエリ数)は十分に対応可能です。しかし数千万・数億件になると、分散アーキテクチャを持つMilvusやPineconeのマネージドサービスが現実的な選択になります。将来の成長見込みも踏まえて設計しましょう。
Embeddingモデルとの一貫性
ベクトルDBとEmbeddingモデルは一対で設計する必要があります。格納時と検索時に異なるモデルを使うと、ベクトル空間が異なるため検索精度が著しく低下します。モデルの変更は全件の再Embedding(再ベクトル化)を意味するため、モデル選定は慎重に行ってください。
レイテンシとスループットの要件
ユーザー向けのリアルタイム検索では50〜100ms以内のレイテンシが求められることが多いです。バッチ処理での活用なら多少遅くても問題ないため、用途に合わせてインデックスのパラメータ(HNSWのef_constructionなど)を調整します。
メタデータフィルタリングの必要性
「2024年以降のドキュメントのみを対象に類似検索をしたい」「特定のカテゴリ内でのみ検索したい」というケースでは、メタデータフィルタリング機能の充実度が選定のポイントになります。Qdrantは、JSONの属性(Payload)で絞り込みながらベクトル検索ができる機能を備えています。
セキュリティ・データガバナンス
社内の機密情報をベクトル化してSaaSに送信することに懸念がある場合は、OSSをオンプレミスまたは自社管理クラウド環境にデプロイするセルフホスト構成が選択肢になります。MilvusやQdrantはセルフホストが容易なOSSとして実績があります。
ベクトルデータベースの始め方:最小構成で試す3ステップ
ベクトルデータベースは、専用のサービスを契約しなくても試せます。流れは次の3ステップです。
- 文章をベクトルにする:埋め込み(Embedding)モデルに文章を渡し、数値の並びを受け取る
- ベクトルを保存する:元の文章や属性(日付・カテゴリなど)と一緒にデータベースへ入れる
- 近いものを検索する:質問文も同じモデルでベクトルにし、距離が近い順に取り出す
すでにPostgreSQLを使っているなら、拡張機能のpgvectorを足すのが手軽です。次は、pgvectorの公式READMEに載っている最小の例です(3次元のベクトルを保存し、近い順に5件取り出す)。
CREATE EXTENSION vector;

CREATE TABLE items (id bigserial PRIMARY KEY, embedding vector(3));

INSERT INTO items (embedding) VALUES ('[1,2,3]'), ('[4,5,6]');

SELECT * FROM items ORDER BY embedding <-> '[3,1,2]' LIMIT 5;
<-> はL2距離(ユークリッド距離)で並べる演算子です。pgvectorでは、コサイン距離は <=>、内積は <#>(符号を反転した値が返る)で指定します(出典:pgvector 公式README、2026年10月13日確認)。実際の埋め込みは数百〜数千次元になるため、vector(3) の数字を、使うモデルの次元数に合わせます。なお公式READMEでは、インデックス(HNSW・IVFFlat)を作れる vector 型は2,000次元までと書かれています。次元数の多いモデルを使うときは、この上限も確認してください。
件数が少ないうちはこの構成で十分なことが多く、規模や応答速度の要件が厳しくなってから専用のベクトルデータベースを検討しても遅くありません。
実際に動かした結果:言葉が違っても「意味が近い文」が見つかる
ベクトル検索で何が起きるのかを、小さな例で確かめました。SQLiteの拡張機能sqlite-vec(v0.1.9)に、日本語の短い例文5件を埋め込みベクトル(Voyage AIのvoyage-3・1024次元)にして保存し、「クルマを買い替えたい」という質問に近い順に並べています。例文は検証用にこちらで用意した短い文です。
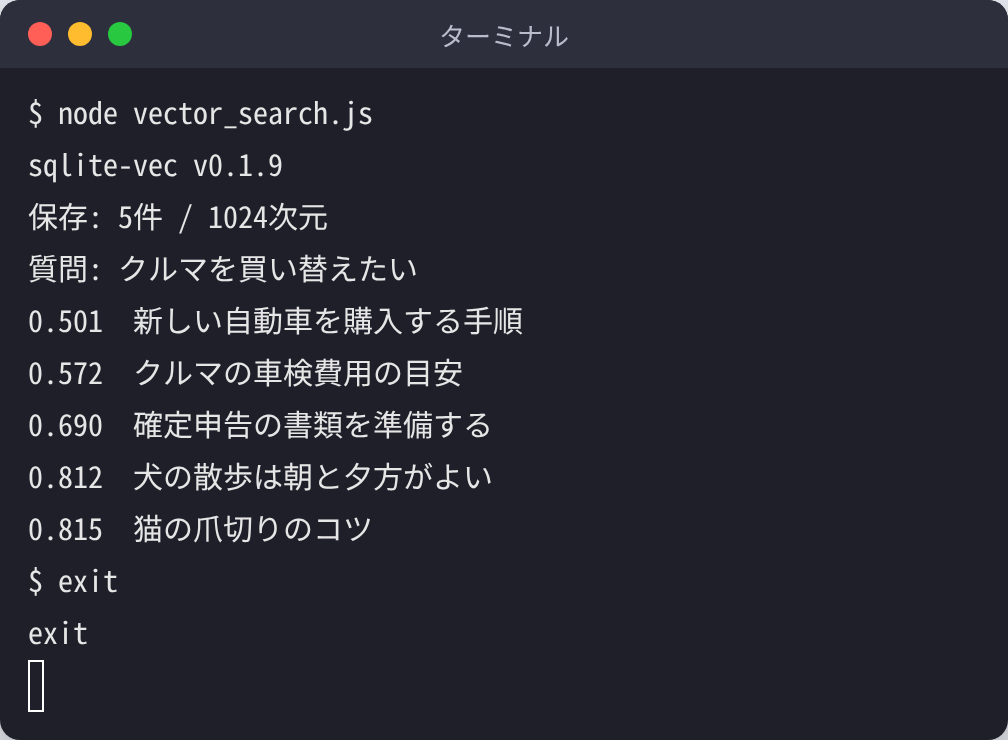
結果は上の画面のとおりです。距離(コサイン距離)は小さいほど近く、質問の「クルマ」と文字が違う「新しい自動車を購入する手順」が最も近い(0.501)と返りました。2位は同じ「クルマ」を含む車検費用の文(0.572)で、確定申告・犬・猫の文は0.69〜0.82と離れています。キーワードの一致ではなく、意味の近さで並んでいることが分かります。
pgvectorを本番で使うときの注意(公式READMEより)
PostgreSQLにすでに慣れているなら、pgvectorで本番まで進める選択もあります。公式READMEで確認できた、移行前に見ておきたい点です(2026年10月20日確認)。
| 確認すること | 公式READMEの記載 | 実務での意味 |
|---|---|---|
| 検索の正確さ | 既定は「完全な最近傍探索」で、再現率は100%。HNSWやIVFFlatのインデックスは、再現率を少し犠牲にして速度を上げる | 件数が少ないうちはインデックスなしでも正確。遅くなったらインデックスを作り、正確さの低下を評価データで確かめる |
| 絞り込みとの組み合わせ | 絞り込みはインデックスを走査した後に適用されるため、返る件数が期待より少なくなることがあります。HNSWの既定(hnsw.ef_search=40)で全体の10%に当たる条件だと、平均で約4件 | メタデータで絞り込む検索では、反復インデックススキャン(0.8.0で追加。hnsw.iterative_scan)の利用を検討する |
| 次元数の上限 | vector型は最大16,000次元。インデックスを作れるのは、vector型で2,000次元、halfvec型で4,000次元まで | 次元数の多い埋め込みモデルを使うときは、半精度(halfvec)への変換などを先に確認する |
| データベースとしての機能 | ACID準拠・ポイントインタイムリカバリ・JOINが使える(PostgreSQLの拡張機能のため) | 業務データとベクトルを同じDBで一貫して扱え、バックアップや権限管理もPostgreSQLの仕組みを使える |
LangChainなどのフレームワークから使う
RAGを組むときは、ベクトルデータベースを直接たたかず、LangChainなどのフレームワーク経由で使うことが多くあります。LangChainにはChroma用の langchain-chroma やOllamaの埋め込み用の langchain-ollama など、サービスごとの統合パッケージがあります(LangChain公式ドキュメント)。Azure AI Searchのように、LangChainなどのオープンソースのフレームワークと組み合わせて使われるサービスもあります(Microsoft公式ドキュメント)。次は、Chromaに保存して近い文章を検索する最小のコードで、2026年10月20日に筆者の環境で動作を確認しました(埋め込みはOllamaのbge-m3)。
from langchain_chroma import Chroma
from langchain_ollama import OllamaEmbeddings

vectorstore = Chroma.from_documents(
    documents=chunks,                          # 分割済みの文書(Document のリスト)
    embedding=OllamaEmbeddings(model="bge-m3"),
)
results = vectorstore.similarity_search("設立年と資本金は?", k=2)RAG全体の組み立て(チャンク分割・LLMへの受け渡し)は、無料でRAGを作る手順で、動かした結果つきで説明しています。
ベクトルデータベースとハイブリッド検索
実務で気づいた重要な点の一つが、「純粋なベクトル検索だけでは精度が不十分なケースが多い」ということです。たとえば固有名詞(人名・商品コード・法律条文番号)はベクトルの意味的類似度よりも完全一致で検索した方が正確です。
そこで現在主流になっているのがハイブリッド検索です。キーワードベースの全文検索(BM25など)とベクトル検索を組み合わせ、両スコアを統合(RRF:Reciprocal Rank Fusionなど)して最終結果を返す手法です。Pinecone・Weaviate・Qdrantなどは、このハイブリッド検索を公式の機能として提供しており、RAGシステムの品質向上に大きく貢献します。
実務Tips:ハイブリッド検索が特に有効な場面
- 製品番号・SKUコードなど固有IDを含む検索
- 人名・地名・法律名など固有表現が重要な文書検索
- 「意味が似ているが表現が全く異なる」文書と「同じ単語を含む」文書を両方ヒットさせたいケース
メタデータフィルタリングとハイブリッド検索の実装差
「2024年以降の文書のみ」「特定部署のドキュメントだけ」といった絞り込み(メタデータフィルタリング)とハイブリッド検索の精度が、実運用の性能を左右します。実装はサービスごとに異なり、Qdrantは任意JSONフィールドへの「ペイロードフィルタ」、WeaviateはBM25+ベクトルのハイブリッド検索、OpenSearchはkNNと全文検索クエリの組み合わせと、設計思想が違います。本番データが増えるほど差が出るため、評価段階で実データに近いサンプルでベンチマークしてください。
ベクトルデータベースの今後:マルチモーダル・エージェントAIとの統合
ベクトルDBの発展方向として注目すべきトレンドが2つあります。
一つ目はマルチモーダルEmbeddingへの対応です。テキストだけでなく、画像・音声・動画・構造化データを同一ベクトル空間で扱えるモデルが増えており、「テキストで画像を検索する」「音声クエリでテキスト文書を探す」といった横断検索が現実のものになりつつあります。
二つ目はAIエージェントとの統合です。LLMが自律的にタスクを実行するエージェント構成では、エージェントが過去の行動・記憶をベクトルDBに格納し、必要に応じて参照する「エージェントメモリ」としての活用が進んでいます。Letta(旧MemGPT)やLangGraphなどのフレームワークではベクトルDBをメモリストアとして組み込む設計が標準的になっています。
開発者向けの補足:距離尺度・埋め込み・RAG設計・実運用の知見
ここから先は、実際にベクトル検索を組む方向けの補足です。入門として読む場合は、次の「よくある質問」までお進みください。
距離尺度の使い分け:意味の「近さ」をどう測るか
ベクトル検索は「クエリに近いベクトルを探す」処理で、「近さ」の測り方は主に3つあります。ここを取り違えると、埋め込みが良くても結果がずれます。
| 尺度 | 見ているもの | 大きさの影響 | 近いほど |
|---|---|---|---|
| コサイン類似度 | 向き(角度) | 無視 | 値が大きい |
| 内積(ドット積) | 向き+大きさ | 受ける | 値が大きい |
| ユークリッド距離(L2) | 位置の隔たり | 受ける | 値が小さい |
各ベクトルを長さ1にそろえるL2正規化をすると、内積とコサイン類似度は実質一致し、ユークリッド距離とも順序が対応します。多くの文埋め込みモデルはコサイン類似度を前提に作られているため、モデルの推奨尺度を確認し、必要なら正規化して内積(=コサイン)で検索するのが素直です。正規化せずに内積で検索すると、ノルムの大きいベクトルが上位に来て、意味的には近くない結果が混じることがあります。
埋め込みの質が検索の当たり外れを決める:モデル・次元数・ドメイン適合
「意味」をベクトルに変換しているのは埋め込み(Embedding)モデルです。どれだけ高性能なベクトルDBを使っても、埋め込みが対象データの意味を捉えられていなければ検索は当たりません。DBは与えられたベクトルの近さを返すだけで、ベクトルの良し悪しは補正しません。
- 汎用モデル:一般的な文章に広く対応。まず試す基準になります。
- 多言語モデル:複数言語を1つの空間に載せ、言語をまたいだ検索がしやすい反面、特定言語への特化度は単一言語モデルに劣る場合があります。
- ドメイン特化モデル:医療・法務など、その分野の語彙で学習され、専門文書で有利になることがあります。
次元数は表現力とコストの綱引きです。高次元ほど細かな差を表せますが、メモリ・計算量・インデックスの負荷が増え、次元を増やせば必ず精度が上がるわけではありません。社内固有の製品名や略語は汎用モデルが取りこぼしやすく、日本語は表記ゆれも多いため、日本語を含むデータで学習・評価されたモデルを選び、対象データで実際に確かめてください。
RAGにおけるベクトルデータベースの役割とデータ設計
RAG(検索拡張生成)でベクトルDBが担うのは「意味の近い文書を探す」一工程です。流れは次のとおりで、ベクトルDBが関与するのは主に③と⑤です。
- ① 文書を適切な単位にチャンク分割する
- ② 各チャンクを埋め込みモデルでベクトル化する
- ③ ベクトルとメタデータをベクトルDBに格納する
- ④ ユーザーの質問を同じモデルでベクトル化する
- ⑤ 近傍検索で意味の近いチャンクを取得する
- ⑥ 取得した文脈をプロンプトに注入し、LLMが回答を生成する
分割は、段落や見出しなど意味のまとまりで区切り、前後を少し重ねる(オーバーラップ)のが一般的な工夫です。各チャンクには出典・文書ID(根拠の明示)、日付・版(古い情報の除外)、権限・公開範囲(閲覧できない情報の除外)といったメタデータを持たせると検索を絞り込めます。近傍検索で候補をおおまかに絞った後は、質問との関連度で並べ替える再ランクを挟むのがよく採られる構成です。RAGの精度はデータ設計と前後処理の質に強く依存し、ベクトルDBはその一翼を担う存在です。
実運用で分かったベクトルデータベースの勘所
クリスタルメソッドは、上場企業の公開データを取り込んだRAG(検索拡張生成)を実際に構築・運用し、企業ごとに特化した模擬面接や営業ロープレの生成に用いています。その現場で繰り返し痛感したのは、ベクトルデータベースの性能を決めるのは「DBそのものの速さ」よりも、その前後の設計だという点です。カタログスペックの比較だけでは見落としやすい、実務上の勘所を3つ共有します。
第一に、チャンク(分割単位)の切り方が検索品質を左右すること。文章を機械的に一定文字数で刻むと、意味のまとまりが途中で切れて的外れな結果が返りやすくなります。見出しや段落など文書構造の区切りを尊重して分割し、実データで想定質問を投げて手応えを確認しながら調整しています。第二に、ベクトル検索単体では固有名詞や型番に弱いこと。意味的に近いものは拾えても、企業名や商品コードの完全一致は取りこぼしがちなため、本文でも触れたキーワード検索とのハイブリッド検索とメタデータでの絞り込みを併用する前提で設計するのが実務的です。第三に、「検索できた=正しく答えられる」ではないこと。取得した文書が本当に質問に沿っているかを人手と実データで検証する工程を挟まないと、生成側がもっともらしい誤りを出します。導入前に、まず自社の実データと想定質問で小さく検証してから本番規模へ広げることを強くおすすめします。
クリスタルメソッドで実際に動かしているベクトル検索の構成
クリスタルメソッドの社内システムでは、用途と規模に合わせて次の構成でベクトル検索を運用しています(2026年10月時点)。
| システム | データベース | 埋め込みモデル | 用途 |
|---|---|---|---|
| SEO分析システム | SQLite+sqlite-vec(1024次元) | Voyage AI voyage-3 | 自社記事どうしの内容の重複検出、記事のグループ分け、内部リンク候補の抽出(約15万ベクトル) |
| SNS投稿管理システム | SQLite+sqlite-vec | Voyage AI voyage-3 | 投稿の重複・類似チェック |
| 開発支援システム(エラー学習) | PostgreSQL+pgvector(ivfflat) | OpenAI text-embedding-ada-002(1536次元) | 過去のエラー事例7,548件から似た事例を検索 |
| 映像生成プロジェクト | PostgreSQL+pgvector(ivfflat、lists=100) | — | 動画キャプションを使ったRAG |
選び方:まず手元のデータベースに「足す」
専用のベクトルデータベースを新たに契約しなくても、ファイル1つで動くSQLiteには拡張機能のsqlite-vec、すでにPostgreSQLを使っている環境にはpgvectorを追加するだけで、ベクトル検索を始められます。クリスタルメソッドでも、単体で動く分析ツールはsqlite-vec、PostgreSQLを持つシステムはpgvectorと、手元のデータベースに合わせて選んでいます。
つまずいた点:距離の種類をそろえる
sqlite-vecの仮想テーブル(vec0)が返す距離はL2(ユークリッド距離)です。一方、文章の意味の近さはコサイン類似度で判定するのが一般的です。そのためSEO分析システムでは、保存したベクトルを取り出してコサイン類似度を計算し直し、「0.9以上なら内容が重複している」と判定しています。pgvectorでは演算子 <=> でコサイン距離を直接使えます(類似度=1−距離)。
よくある質問
ベクトルデータベースとは何ですか?
文章や画像などをAIで数値の並び(ベクトル)に変換して保存し、キーワードの一致ではなく「意味の近さ」で検索できるデータベースです。
従来のデータベース(RDB)とは何が違いますか?
RDBは「条件に一致するものを正確に取り出す」検索が得意です。ベクトルデータベースは「意味や文脈が近いものを順に取り出す」検索が得意で、言い換えや表現の違いがあっても関連する情報を見つけられます。数値や日付の範囲で絞る検索はRDBのほうが向いています。
ベクトルデータベースは無料で使えますか?
使えます。pgvector(PostgreSQLの拡張機能)やsqlite-vec、Milvus・Qdrant・Weaviate・Chromaなどはオープンソースで、ソフトウェア自体は無料です。自分で運用する場合はサーバー代と運用の手間がかかります。
RAGにベクトルデータベースは必須ですか?
必須ではありません。RAGで大事なのは「質問に関係する資料を探して渡す」ことで、件数が少なければ全文検索や既存のデータベースでも実現できます。言い換えに強い検索が必要になり、件数も増えてきた段階で、ベクトル検索が有効になります。
どのベクトルデータベースを選べばよいですか?
まずは今あるデータベースに足す方法(PostgreSQLならpgvector、SQLiteならsqlite-vec)で試し、件数や応答速度の要件が合わなくなったら、専用のデータベースやマネージドサービスを検討する順番が、費用を抑えやすい進め方です。
まとめ
ベクトルデータベースは、非構造化データを高次元ベクトルとして格納し、意味的類似度に基づく高速検索を実現するデータ基盤です。RAGによるLLMの知識補完・推薦エンジン・セマンティック検索・マルチモーダル検索など、生成AI時代の中核インフラとして急速に普及しています。
選定ではデータ規模・Embeddingモデルとの一貫性・レイテンシ要件・ハイブリッド検索の必要性・セキュリティ要件を軸に整理することで、自社のユースケースに最適なソリューションを見つけられます。また、ベクトルDBはRDBの代替ではなく補完的な役割を果たすものであり、両者を組み合わせたアーキテクチャが実務では有効です。
なお、RAGシステムを構成する際にどのLLMを選ぶかも重要な判断ポイントです。主要なAIモデルの性能比較も合わせてご覧いただき、用途に合ったモデル選定にお役立てください。
関連記事
ベクトルデータベースの関連記事
AIの業務活用をご検討の方へ
クリスタルメソッドは、バーチャルヒューマンをはじめAIの開発・業務導入を支援しています。生成AI・AIエージェントの活用や、自社業務へのAI導入をご検討の際は、お気軽にご相談ください。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
ベクトルデータベース比較|無料プランで選ぶ2026年版
sqlite-vecとは?SQLiteだけで無料でベクトル検索を実装する方法 sqlite-vecは、既存のSQLiteに読み込むだけでベクトル検索を追加できる...
-
ベクトルデータベース一覧:主要サービスの比較と用途別の選び方
ベクトルデータベースは、文章や画像を数値の並び(ベクトル)として保存し、意味の近いデータを高速に探せるデータベースです。主な製品には、Pinecone・Weav...
-
ベクトルデータベース入門:RAGでの使い方と最小構成での始め方
ベクトルデータベースとは?まず「何ができるのか」からやさしく解説 ベクトルデータベースとは、文章や画像がもつ「意味の近さ」を数値の列(ベクトル)に変換して保存し...