
blog
AIブログ
Gemma とは?無料で使える Google の軽量 AI を初心者向けにやさしく解説【2026年版】
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
「Gemma(ジェンマ)ってGeminiと何が違うの?」「無料で使えるって本当?どう動かすの?」——そんな方に向けて、このページではGemmaの正体・できること・使い方・料金を、専門用語をできるだけ避けてやさしくまとめます。AIにくわしくない方でも、読み終えるころには「自分や自社で何に使えそうか」がイメージできるはずです。
最新モデルの仕様や導入手順、他AIとのくわしい比較は、それぞれの専用記事にリンクします。まずはここで全体像をつかんでください。
Gemmaを選ぶ前に:向く場面・向かない場面の見極め
Gemmaは「オープンウェイトで手元に置ける軽量モデル」という性格がはっきりしているため、どんな用途でも万能というわけではありません。導入して後悔しないために、まず自分のケースがどちら寄りかを確認してください。
Gemmaが向いている場面
- データを社外に出せない業務:社内文書・顧客情報・医療/法務データなどを、クラウドAPIに送らずローカルや自社サーバー内で処理したいとき。オープンウェイトなので閉じた環境で完結できます。
- 手元のGPU/PCで動かしたいとき:小さいサイズ帯(軽量モデル)が用意されており、常時課金のAPIを契約せず、まず自分のマシンで試したい・検証したい段階に適します。
- 用途に合わせて改造・組み込みたいとき:Gemma 4世代はApache 2.0で提供され、ファインチューニングや自社アプリへの組み込み、RAGの生成部として使うなど、作り込みを前提にした開発に向きます。
Gemmaが向かない場面
- とにかく最高精度を最短で欲しいとき:モデルを自分で用意・運用する手間を避け、常に最上位の回答品質だけを求めるなら、マネージドなクラウドLLM(GeminiやChatGPTなど)のほうが近道です。
- 運用環境を用意できないとき:GPUの確保・量子化・推論サーバーの管理といった運用作業を自分で持ちたくない場合、ローカル運用の恩恵よりも手間が上回りがちです。
- ブラウザから今すぐ使うだけのとき:セットアップなしに対話画面ですぐ使いたいライトな用途なら、Web版のチャットサービスのほうが立ち上がりが速く、Gemmaを選ぶ利点が薄くなります。
迷ったときの切り替え判断(1行の使い分け)
- 機密性・オフライン・カスタマイズが最優先 → Gemma(ローカル運用)。
- 運用ゼロで最高品質を使いたい → GeminiやChatGPTなどのクラウドLLM。
- すでにオープンモデルの資産・ノウハウがある → Gemmaと他のオープンモデル(Llama等)を、ライセンス条件と得意分野で比較して選定。
※ どの選択肢が正解かは「精度」だけでなく、データの取り扱い制約・運用リソース・改造の必要性の3点で決まります。この3点を先に整理してから、上のモデル一覧・比較表に戻ると選びやすくなります。
常時課金せずにGemmaを試すにはどうすればいいかは、Gemmaの料金・無料で使う方法で解説しています。
機密データ向けローカルLLM運用で見るGemmaの選び方
クリスタルメソッドは、社外に出せない機密データを扱う案件で、クラウドに送らず自社環境内で完結させるローカルLLMの運用と、実データを使ったRAG(検索連携)の構築を実際に手がけてきました。Gemmaのような「手元で動かせるオープンモデル」を業務で選ぶときの実務上のポイントを整理します。ここは製品名の暗記より、判断軸として役立つはずです。
まず、「ローカルで動く=無料でうまくいく」ではありません。オープンモデルの利用料自体はかかりませんが、実運用では動かす端末・サーバーのメモリ(GPUなら特にVRAM)が制約になります。求める品質と応答速度、そして手元のハードウェアのバランスで、モデルの大きさ(軽量版か大型版か)を選ぶのが出発点です。大きいほど賢い傾向はありますが、動かせなければ意味がありません。
次に、メモリを節約する量子化には品質とのトレードオフがあります。量子化でより大きなモデルを載せられる一方、圧縮を強めるほど出力の精度や安定性は少しずつ削られます。「載る/載らない」だけでなく「業務で使える品質か」を、自社の実タスクで試して確かめることをおすすめします。
最後に、社内知識を答えさせたいなら、追加学習より先にRAGを検討するのが現実的です。自社の文書やデータを外部検索として連携すれば、モデル本体を作り替えずに専門的な回答を得やすくなります。実務の経験からも、機密性を保ったまま「自社に合う答え」を出す近道は、モデル選定とRAG設計をセットで考えることでした。Gemmaは軽量で手元運用しやすいため、この構成の土台として検討しやすいモデルです。
次に読む:Gemmaの使い方は?AI Studioで試す方法
Gemmaとは?ひとことで言うと「無料で公開された、Googleの軽いAI」
Gemmaは、Google(グーグル)が開発・公開しているAI(大規模言語モデル)です。ChatGPTやClaudeと同じように、質問に文章で答えたり、文章やコードを作ったりできます。Googleの旗艦AI「Gemini」と同じ系統の技術をベースにしつつ、軽量で扱いやすいオープンモデルとして公開されているのが特徴です。
いちばんのポイントは、モデルそのものが無料で公開(オープンモデル)されていて、自分のPCや自社サーバーで動かせること。比較的小さく軽いので、手元のパソコンでも動かしやすく、データを外に出さずに使えます。2026年時点の最新世代は「Gemma 4」で、スマホでも動くような超軽量モデル(E4Bなど)もそろっています。
※よく混同されますが、「Gemini」はクラウド上で使うGoogleの旗艦AI、「Gemma」はその技術をもとに無料公開され、自分の手元で動かせる軽量版、という関係です。違いは GemmaとGeminiの比較 で詳しく解説しています。
「Gemma」という名前の由来
2024年2月21日の公式発表で、Googleは名前について「Latin gemma, meaning “precious stone”」、つまりラテン語の「gemma」(宝石)に由来すると説明しています(出典:Google公式ブログ「Gemma: Google introduces new state-of-the-art open models」・2026年10月23日に確認)。この発表では、GeminiにインスパイアされたモデルとしてGemma 2BとGemma 7Bの2サイズが公開されました。名前を選んだ理由について、これ以上の説明は公式ページで確認できませんでした。
🔥 Gemmaを使うとこんなに変わる(before → after)
「無料で公開された軽いAI」と言われてもイメージしづらいので、何がうれしいのかを具体的に並べてみます。
- 高性能AIは重い・高い:今まで=大きなモデルは高性能なPCや従量課金が必要 → Gemma=軽いので手元のPCでも無料で動かせる
- 社内データを外に出したくない:今まで=クラウドAIに機密を送るのが不安 → Gemmaは自分の環境で完結でき、データを外に出さずに使える
- 自社専用にカスタマイズしたい:今まで=既製のAIは中身をいじれない → Gemmaはオープンなので自社データで追加学習して専用AIにできる
- スマホやエッジでも動かしたい:今まで=端末で動かすのは無理 → 超軽量のE4Bならスマホ級の端末でも動く
「軽くて無料で、手元で動かせるAIがほしい」と思えたら、それがGemmaの使いどころです。
Gemmaで何ができる?(主なモデルと活用)
文章の作成・要約、翻訳、プログラミング支援、画像も扱うマルチモーダルな用途まで、はば広く使えます。最新モデルの構成や性能は Gemma 4の詳細解説、スマホでも動く超軽量モデルは Gemma 4 E4Bの解説、スマホ・エッジでの活用は Gemmaをモバイルで動かす解説 をご覧ください。自社データでのカスタマイズは Gemmaのファインチューニング解説 が役立ちます。
関数呼び出し(function calling)とエージェント機能
Gemma 4は、関数呼び出し(function calling)、構造化JSON出力、システム指示を標準でサポートしており、ツールやAPIを使うエージェントを作れるとGoogleが案内しています(Google公式ブログ「Gemma 4」・2026年10月23日に確認)。仕組みは次の4段階です(出典:Gemma公式ドキュメント「Function calling」)。
- 使わせたい関数を、JSONスキーマ(またはPythonの型ヒントとdocstring付き関数)で定義します。
- モデルは質問とツール一覧を受け取り、文章の代わりに関数呼び出しの形式で出力します。
- アプリ側が関数名と引数を確認し、実際に関数を実行して、結果を
toolロールで会話に追加します。 - モデルがその結果を使って、最終的な回答を返します。
公式ドキュメントは、モデル自身はコードを実行できないため、生成された呼び出しの検証と実行はアプリ側で行う必要があると明記しています。思考モードを有効にすると呼び出しの精度が上がることがあるとも案内されています。下は公式ドキュメントに載っている、関数の定義と呼び出しの例です(ドキュメントのとおりの転載で、このページ上では実行していません)。
weather_function_schema = {
    "type": "function",
    "function": {
        "name": "get_current_temperature",
        "description": "Gets the current temperature for a given location.",
        "parameters": {
            "type": "object",
            "properties": {
                "location": {
                    "type": "string",
                    "description": "The city name, e.g. San Francisco",
                },
            },
            "required": ["location"],
        },
    }
}

text = processor.apply_chat_template(message, tools=[weather_function_schema], tokenize=False, add_generation_prompt=True)
公式ドキュメントで対応が示されているのは、Gemma 4のE2B・E4B・12B・31B・26B A4Bの各instruction-tuned版です。関数呼び出しに特化した小型モデルとして、270MのFunctionGemma(2025年12月18日公開)もあります(出典:Google AI for Developers「Gemma releases」)。
Gemmaのモデル一覧――現行のGemma 4世代と派生モデル
現行世代は2026年3月に公開されたGemma 4です(Gemma 4の詳細解説)。動かす環境や用途に合わせて、次のラインナップから選べます。
| モデル | 特徴・向いている用途 | コンテキスト |
|---|---|---|
| Gemma 4 E2B / E4B | スマホ・エッジ・ブラウザ向けの軽量版。テキスト・画像・動画・音声に対応(E4Bの解説) | 128K |
| Gemma 4 12B Unified | マルチモーダルの主力(2026年6月公開)。エンコーダフリーで画像・動画・音声も扱える | 256K |
| Gemma 4 26B A4B | MoE(Mixture-of-Experts)構成で、高スループットの推論向け | 256K |
| Gemma 4 31B | 最大級の旗艦モデル。サーバーからローカルまで高性能が必要な場面に | 256K |
| Gemma 4 MTP | 投機的デコード用のドラフトモデル(推論の高速化に使う補助モデル) | ― |
このほか、医療向けのMedGemma、安全性分類のShieldGemma 2、視覚特化のPaliGemma 2、埋め込み用のEmbeddingGemma、function calling特化のFunctionGemma、encoder-decoder型のT5Gemmaといった専用モデルも併存しています。Gemma 3以前(3n・270Mを含む)は前世代=レガシー扱いのため、これから選ぶならGemma 4系が基本です。
世代の歴史と公開日
Gemmaは2024年2月の初代から、2026年のGemma 4まで続いています。公開日とサイズは、Google公式の一覧によるものです(出典:Google AI for Developers「Gemma releases」・2026年10月23日に確認)。
| 世代 | 公開日 | サイズ |
|---|---|---|
| Gemma 1 | 2024年2月21日 | 2B・7B(1.1版は2024年4月5日) |
| Gemma 2 | 2024年6月27日(2Bは7月31日) | 9B・27B・2B |
| Gemma 3 | 2025年3月10日(270Mは2025年8月14日) | 1B・4B・12B・27B・270M |
| Gemma 3n | 2025年6月26日 | E2B・E4B |
| Gemma 4 | 2026年3月31日(MTPは4月16日、12B Unifiedは6月3日) | E2B・E4B・26B A4B・31B・12B |
派生モデルの公開日も同じ一覧で確認できます。たとえばCodeGemmaとRecurrentGemmaは2024年4月9日、PaliGemmaは2024年5月14日、ShieldGemmaは2024年7月31日、MedGemmaは2025年5月20日、EmbeddingGemmaは2025年9月4日、TranslateGemmaは2026年1月15日です。
旧世代のサイズと仕様
Gemma 3以前を使う場合の目安です。Gemma 3は公式のモデルカード、Gemma 2とGemma 1は各モデルカードの記載によります(出典:Gemma 3 model card・Gemma 2 model card・Gemma model card)。公式ページに書かれていない項目は「記載なし」としています。
| 旧世代のサイズ | 入力コンテキスト | 学習トークン数 |
|---|---|---|
| Gemma 3 270M | 32K | 6兆 |
| Gemma 3 1B | 32K | 2兆 |
| Gemma 3 4B | 128K | 4兆 |
| Gemma 3 12B | 128K | 12兆 |
| Gemma 3 27B | 128K | 14兆 |
| Gemma 2 2B | 公式ページに記載なし | 2兆 |
| Gemma 2 9B | 公式ページに記載なし | 8兆 |
| Gemma 2 27B | 公式ページに記載なし | 13兆 |
| Gemma 1(2B・7B) | 公式ページに記載なし | 全体で6兆(サイズ別の記載なし) |
Gemma 3は140以上の言語に対応し、テキストと画像を入力できます(4B以上。出力はテキスト)。
公式ベンチマーク(Gemma 4)
次の数値は、開発元であるGoogleの公式発表によるものです。instruction-tuned版・思考モードでの結果で、Googleのモデルカードに載っている数字をそのまま転記しています(出典:Gemma 4 model card・2026年10月23日に確認)。条件が異なる第三者の測定とは直接比べられません。
| 項目 | 31B | 26B A4B | 12B Unified | E4B | E2B | Gemma 3 27B |
|---|---|---|---|---|---|---|
| MMLU Pro | 85.2% | 82.6% | 77.2% | 69.4% | 60.0% | 67.6% |
| AIME 2026(ツールなし) | 89.2% | 88.3% | 77.5% | 42.5% | 37.5% | 20.8% |
| LiveCodeBench v6 | 80.0% | 77.1% | 72.0% | 52.0% | 44.0% | 29.1% |
| GPQA Diamond | 84.3% | 82.3% | 78.8% | 58.6% | 43.4% | 42.4% |
| Codeforces ELO | 2150 | 1718 | 1659 | 940 | 633 | 110 |
| Tau2(3回の平均) | 76.9% | 68.2% | 69.0% | 42.2% | 24.5% | 16.2% |
同じ公式発表では、2026年4月1日時点のArena AIのテキスト部門で、31Bがオープンモデル世界3位、26Bが6位とされています(出典:Google公式ブログ「Gemma 4」)。
手元のPCで動かす手順はローカル実行ガイド、メモリを節約して動かす方法は量子化の解説、日本語での実力は日本語性能の解説にまとめています(出典:Google AI for Developers – Gemma model overview/同 releases・2026年6月時点)。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
ローカル・オンプレRAG基盤に組み込むなら:量子化とメモリ要件の実務チェック
Gemmaをオンプレ環境に組み込む際に最初にぶつかる壁は「精度」ではなく「メモリに乗り切るか」です。特に機密データを外部に出せない案件では、量子化レベルの選定がそのままサーバー構成・コストに直結します。以下はGoogle公式ドキュメント(ai.google.dev)が示すモデルサイズ別のメモリ要件です。
| モデル | BF16(16bit) | SFP8(8bit) | Q4_0(4bit) |
|---|---|---|---|
| Gemma 4 E2B | 11.4 GB | 5.7 GB | 2.9 GB |
| Gemma 4 E4B | 17.9 GB | 8.9 GB | 4.5 GB |
| Gemma 4 12B Unified | 26.7 GB | 13.4 GB | 6.7 GB |
| Gemma 4 26B A4B | 57.7 GB | 28.8 GB | 14.4 GB |
| Gemma 4 31B | 69.9 GB | 34.9 GB | 17.5 GB |
注意したいのは26B A4B(MoE構成)です。実際に計算で使われるのは4Bぶんのパラメータだけですが、メモリには26B全体をロードする必要があるため、「アクティブパラメータが小さい=省メモリ」とは限りません。ローカルRAGでVRAM制約のあるGPUを使う場合は、E2B/E4Bのような小型モデルをQ4_0量子化で動かし、精度が不足する部分だけ埋め込み検索側の設計でカバーする、という組み合わせが現実的な落とし所になります。量子化を上げるほど推論速度は上がりますが応答品質とのトレードオフがあるため、本番投入前には自社データでの検証を必ず行ってください。
出典:Google公式 Gemma ドキュメント(ai.google.dev/gemma/docs/core)
料金はかかる?無料で使える?商用利用は?
Gemmaのモデルは無料で公開されており、自分の環境で動かすぶんにはモデルの利用料はかかりません(電気代・サーバー代などの実費は別途)。料金や無料で使う方法は Gemmaの料金・無料利用の解説 にまとめています。商用利用も可能です。現行のGemma 4はApache 2.0ライセンス(Gemmaとして初)で提供され、ライセンス費用や特別な許諾なしで商用利用・再配布ができます。一方、Gemma 3以前の旧世代は独自の「Gemma利用規約」に基づく条件があるため、旧世代を業務で使う場合は Gemmaの商用利用・ライセンス解説 で確認してください。
始め方・動かし方(はじめての方へ)
いちばん手軽なのは、Ollamaなどのツールでダウンロードして動かす方法や、ブラウザのGoogle AI Studioで試す方法です。難しい設定は不要で、実質コマンド一つで試せます。
- Ollamaをインストール:公式サイト(ollama.com)からインストーラをダウンロードして実行するだけ(Windows/Mac/Linux対応)。
- ターミナルで1行打つ:
ollama run gemma4:e4bと打つだけで、初回は自動でモデルがダウンロードされ、そのままチャットが始まります。Ollama公式の一覧では、gemma4:e4b の大きさは6.6GB〜9.5GB、より軽い gemma4:e2b は4.6GB〜7.5GBです(2026年10月23日に確認)。 - そのまま質問する:ダウンロードが終わると入力待ちの状態になるので、「自己紹介して」のように打てば応答が返ってきます。会話を終えるときは
/byeと入力します。
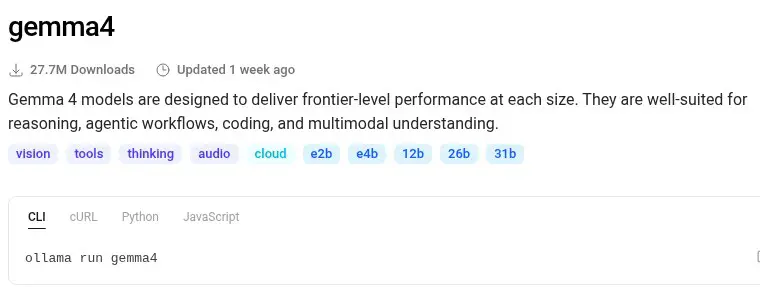
ollama run gemma4 の1行で始められ、e2b・e4b・12b・26b・31b の大きさから選べます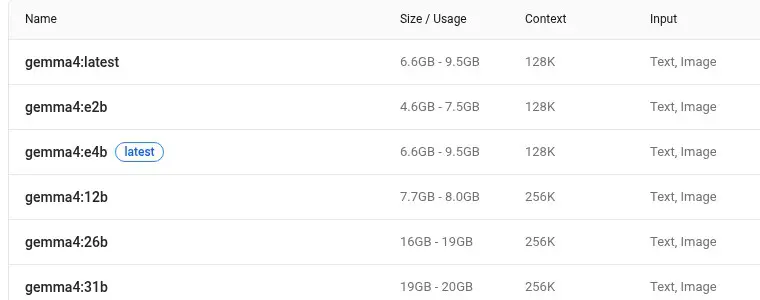
ブラウザだけで試したい場合はインストール不要のGoogle AI Studioが手軽です。より詳しい導入手順(Ollama/LM Studio/transformers)は Gemma 環境構築・インストール に、クラウドのAPIで使う方法は Gemmaの使い方(AI Studio・API)、本格的にローカル運用する設計は Gemma ローカル実装ガイド、モデルの入手元は Hugging FaceでのGemma入手 にまとめました。
Gemmaを入手・利用できる場所の一覧
Gemma 4は、用途に合わせて次の経路から使えます。表の内容は、Google公式ブログ・公式ドキュメントの記載です(出典:Google公式ブログ「Gemma 4」・Gemma公式ドキュメント・Run Gemma with the Gemini API・Google DeepMind「Gemma」・2026年10月23日に確認)。
| 入手・利用の場所 | 使えるもの(公式の記載) |
|---|---|
| Google AI Studio | 31B・26B A4B(ブラウザで試せます) |
| Gemini API | gemma-4-31b-it・gemma-4-26b-a4b-it |
| Vertex AI(Google Cloud) | 公式ブログが、Cloud Run・GKEと並ぶ本番向けの経路として挙げています |
| Hugging Face・Kaggle | 重みのダウンロード(Kaggleには公式のQATチェックポイントもあります) |
| Google AI Edge Gallery | E2B・E4B(端末上で動かす用途) |
| その他 | LM Studio・MLX・Keras・Unsloth など(公式ドキュメントが挙げる実行環境) |
手軽さで選ぶなら、まずブラウザのGoogle AI Studioか、手元のPCで動かせる小型のE2B・E4Bです。自社のアプリから呼び出すならGemini APIかVertex AI、重みを自分の環境に置きたいならHugging FaceかKaggleから取得します。なお、公式ドキュメントのページには、新しい案内先としてgemma.aiが示されています。
GeminiやChatGPT・Llamaと何が違う?
大きな違いは、軽くて手元で動かせるオープンモデルであることです。クラウド専用のGeminiやChatGPTと違い、Gemmaは無料で・自分の環境で・自社用に改造して使えます。同じオープンモデルのLlamaとの比較は GemmaとLlamaの比較、各モデルとの比較・選び方は Gemmaを他モデルと比較 をご覧ください。
よくある質問
Q. Gemmaは無料で使えますか?
A. モデルは無料で公開されています。自分の環境で動かせばモデルの利用料はかかりません。
Q. 「Gemma」と「Gemini」は何が違いますか?
A. Geminiはクラウドで使うGoogleの旗艦AI、Gemmaは手元で動かせる無料の軽量オープン版です。
Q. 商用利用できますか?
A. 可能です。現行のGemma 4はApache 2.0ライセンスのため、商用利用・再配布ができます。旧世代(Gemma 3以前)は独自の利用規約の条件があるため、事前の確認をおすすめします。
Q. 日本語でも使えますか?
A. 使えます。日本語での質問・文章作成にも対応しています。
Q. 「Gemma」は何と読みますか?
A. 「ジェンマ」と読みます。「Google Gemma」「Gemma AI」と呼ばれることもありますが、同じモデルを指します。
あなたのケースにGemmaは向く? 使う前の「適性チェック」
「無料で軽量」と聞くと万能に思えますが、Gemmaは“手元で動かす自由”と引き換えに、環境の準備や運用を自分で担うことが前提のモデルです。用途によっては、クラウド型のAIサービスをそのまま使うほうが結果的に早く・安く済む場合もあります。始める前に、自分の目的がGemmaの強みと噛み合っているかを確かめておくと、遠回りを避けられます。まずは下の対応表で、あなたのケースがどちら寄りかを見てください。
「手元で動かすGemma」が向く場面・向かない場面
| 判断軸 | Gemmaを手元で動かすのが向く | クラウド型AIサービスが向く |
|---|---|---|
| データの扱い | 社外に出せない情報を扱う/オフラインでも動かしたい | 公開情報が中心で、外部送信に制約がない |
| コスト構造 | 利用量が多く、従量課金を自前の設備コストに置き換えたい | 使う頻度が低く、必要なときだけ払いたい |
| 技術環境 | 自分でPCやGPUの環境を用意・管理できる | 環境構築は避け、登録してすぐ使いたい |
| タスクの性質 | 要約・分類・抽出といった定型処理を数多く回す | 込み入った推論を、できるだけ高い精度で求める |
| カスタマイズ | 自社データで微調整して専用化したい | 汎用のまま使えれば十分 |
ざっくり言えば、Gemmaが力を発揮しやすいのは「データを外に出せない」「同じ処理を大量に繰り返す」「自分好みに調整したい」の三つが絡む場面です。逆に、たまに難しい質問を投げるだけなら、環境を自分で抱える手間のほうが上回りがちです。どの程度の精度・速度が出るかはモデルの世代やサイズ、動かす環境によって変わるため、最終判断は公式情報やご自身の検証で確認してください。
始める前の5つの自己チェック
- 扱うデータに、外部サービスへ送れない制約があるか
- 動かすPC・サーバのメモリやGPUに、おおよその見当がついているか
- 求める品質は「実用十分」でよいか、それとも「最高精度」が絶対条件か
- 一度きりの利用か、継続的に大量に処理を回す用途か
- 導入後の更新や動作確認まで、面倒を見られる人がいるか
チェックが「向く」側に多く当てはまるなら、Gemmaは有力な候補のひとつです。判断がついたら、具体的な導入手順や動かし方は、それぞれの解説記事や公式ドキュメントを参照してください。
型番と派生モデル名の読み解き方 ― 迷わず「自分に合う一つ」へたどり着く地図
Gemmaは単一のモデルではなく、サイズ・用途・調整方法の違いで枝分かれした“ファミリー”です。ダウンロード先には似た名前がずらりと並び、初めてだと「どれを選べばいいのか」で手が止まりがちです。ただ、名前に含まれる数字や記号にはそれぞれ意味があり、そこを読めるようになると、大量の選択肢のなかから自分に合う一つへ近づきやすくなります。なお世代構成やラインナップは更新されていくため、最新情報は必ず公式サイトで確認してください。
名前を構成する4つの要素
| 要素 | 表記の例 | 読み取れること |
|---|---|---|
| 世代 | Gemma 2 / Gemma 3 など、続く数字 | 公開された世代の新しさの目安。数字が大きいほど新しい系統(最新の世代は公式サイトで確認) |
| サイズ | 末尾の「B」(例: 2B・9B・27B など) | パラメータ規模の目安。一般に大きいほど高性能な傾向があるが、必要なメモリも増える。実際に用意されているサイズは世代・モデルにより異なるため公式サイトで確認 |
| 調整の有無 | -it / -pt | it=指示に沿って会話用に調整済み(instruction-tuned)、pt=調整前の素の状態(pretrained)を指す表記 |
| 省メモリ表記 | 頭の「E」(例: E2B・E4B など、一部モデルに採用) | 端末上で軽く動くことを狙った設計に使われる表記。対応モデルや詳細な仕組みは公式サイトで確認 |
たとえば「会話にそのまま使いたい」なら、名前に-itが付いたものがまず検討しやすい選択肢です。逆に-pt(素のモデル)は、自分で調整して使う人向けです。この読み方を押さえておくと、名前を見ただけで用途とおおよその重さの見当がつけやすくなります。
用途に特化した派生モデルもある
- コード生成に寄せた系統(例:CodeGemma)
- 画像も入力として扱えるビジョン対応の系統(例:PaliGemma)
- 入出力の安全性チェックに使う系統(例:ShieldGemma)
頭の「Gemma」は共通でも、後ろの言葉が用途を表しています。文章のやり取りが目的なら、まず標準のGemma本体から検討すれば十分です。派生モデルの対応状況やサポート範囲は変わることがあるため、利用前に公式情報を確認してください。
迷わないための選ぶ順序
- ①用途を決める:会話・コード・画像のどれか → 系統を絞る
- ②手元のメモリを見る:動かせるサイズの上限を見積もる
- ③会話用途なら -it を選ぶ
- ④環境が非力なら E系統(省メモリ設計、Gemma 3nなど一部モデル)も検討する
各サイズや各版の細かな違い、最新のラインナップは個別の解説記事や公式ドキュメントにゆずります。ここでは全体を見渡す“地図”として、名前の読み方だけ持ち帰ってください。それだけで、選択肢の海で迷子になりにくくなります。
まとめ
Gemmaは、「軽くて・無料で・手元で動かせる」Googleのオープンモデルです。まずはOllamaやGoogle AI Studioで一度動かしてみるところから始めてみてください。「もっとくわしく」と思ったら、このページから各専用記事へ進めば、モデル構成・導入手順・料金・他AIとの違いまで一気に深掘りできます。
関連記事(Gemma)
- gemma 使い方
- gemma ローカルllm
- gemma ファインチューニング 方法
- gemma 日本語 性能
- gemma api 使い方
- gemma vs llama 比較
- gemma 量子化
- gemma 無料 商用利用
LLM・ローカルLLMの業務導入をご検討の方へ
クリスタルメソッドは、オープンモデル・ローカルLLMの選定からRAG構築・PoC・本番導入までのAI開発を支援しています。「機密データを外部に出さずにLLMを使いたい」「自社の業務に合うモデルを選びたい」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
Gemmaの料金は?無料で使う方法を解説【2026年版】
Gemmaの料金と無料利用を完全解説|ライセンス・実コスト・活用方法まで 「Gemmaは無料で使えるのか」「商用利用にはコストがかかるのか」「どのプラットフォー...
-
Gemmaの使い方|Google AI Studioで手軽に試す方法【2026年版】
Gemmaを「まず触ってみたい」なら、いちばんかんたんなのはブラウザだけで使えるGoogle AI Studioです。インストールもコードも不要で、ページを開い...
-
Gemma と Gemini の違いを技術軸で整理|選定判断ガイド
Gemma と Gemini の違いを正確に把握する前提 「Gemma と Gemini、どちらを使うべきか」という問いに答えるには、まず両者がそもそも同じ土俵...