
blog
AIブログ
ローカルLLM比較|主要モデル・ツールの選び方とおすすめ
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
本ページはローカルLLMの「比較」(モデル・ランタイム・UIの選び方とおすすめ)に特化した記事です。導入の手順や全体像は、ローカルLLMの導入|始め方とおすすめツールをご覧ください。
結論:メモリ(VRAM)16GB前後なら gpt-oss-20b・Qwen3.5 9B・Gemma 4 12B から、24GB以上あれば最新世代の Qwen3.8 27B(配布18GB)や Gemma 4 26B/31B が本命候補です。コードならQwen3-Coder 30Bです。いずれも公式の配布ページ・モデルカードで、Apache 2.0などの商用利用しやすいライセンスが確認できます(確認日:2026年10月29日)。本記事は、その根拠となるモデル・ランタイム・UIの比較と、PCスペック別・用途別の選び方をまとめたものです。
【結論】ローカルLLMおすすめ早見表|用途別・PCスペック別(2026年10月)
最初に答えです。下の表は、Ollama公式ライブラリの配布ページとHugging Faceのモデルカードで確認した内容(確認日:2026年10月29日)だけで作っています。サイズは配布ファイルの大きさで、実行時はこれに加えて会話の長さに応じたメモリが必要です。
用途別のおすすめ
| 用途 | おすすめ | 配布サイズ | 理由 |
|---|---|---|---|
| まず試したい | gpt-oss-20b | 14GB | 16GBメモリで動作と公式に記載。推論に対応 |
| 軽く・画像も | Gemma 4 E4B/12B | 6.6〜9.5GB | 画像入力と思考モード。128K〜256K |
| 長文・多言語 | Qwen3.5 9B | 6.6〜7.6GB | 256K文脈。201言語・方言に対応と記載 |
| コード生成 | Qwen3-Coder 30B | 活性3.3B | 活性が小さいMoE。256K文脈 |
| 品質優先 | Qwen3.8 27B | 18GB | 最新世代。画像・思考・256K。24GB以上向け |
| 日本語重視 | GPT-OSS-Swallow 20B | 20B級 | 日本語・英語に最適化と記載(日本語の節で詳述) |
Phi-4とDeepSeek-R1蒸留版はMIT、それ以外の上記モデルはApache 2.0です(モデルカードで確認)。
PCのメモリ(VRAM・ユニファイドメモリ)別のおすすめ
| メモリ | 候補 | 備考 |
|---|---|---|
| 〜8GB | Qwen3.5 4B、Gemma 4 E2B | 軽い要約・チャット向け |
| 16GB前後 | Qwen3.5 9B、Gemma 4 12B、gpt-oss-20b | 個人利用の標準帯 |
| 24〜32GB | Qwen3.8 27B(18GB)、Qwen3.5 27B、Gemma 4 26B/31B | 配布サイズ+文脈分の余白が必要 |
| 64GB以上 | gpt-oss-120b(65GB)、Qwen3.5 122B(81GB) | サーバー・大容量Mac向け |
同じ7Bでも量子化で必要量が変わります。詳しい見積りは後半の「VRAMと量子化」の節をご覧ください。
ローカルLLMを実際に動かすまでの流れは、ローカルLLMの導入(始め方とツール)で手順を説明しています。
関連記事Phi-3の性能と使い方は?
ローカルLLMとは?クラウドLLMとの違い
ローカルLLMとは、公開されている重み(モデルファイル)を自分のPCやサーバーにダウンロードして動かす大規模言語モデルです。入力した文章が外部のAPIに送られないため機密情報を扱いやすく、API従量課金がかからない代わりに、動かすためのメモリ(VRAM)と電力を自前で用意します。全体像はローカルLLMとは、導入手順はローカルLLMの導入にまとめています。
| 観点 | ローカルLLM | クラウドLLM |
|---|---|---|
| データ | 自分の環境内で完結 | 事業者のAPIへ送信 |
| 費用 | 機材・電力・運用の工数 | トークン量に応じた従量課金 |
| 性能 | 手元のメモリ量が上限 | 最新の大型モデルを利用可 |
| 更新 | 自分でモデルを入れ替え | 事業者が随時更新 |
次に読む:無料で使えるローカルLLMはどれ?
おすすめローカルLLMモデルの比較表(サイズ・ライセンス・コンテキスト)
モデル選定は「サイズ(パラメータ数)」「量子化ビット数」「ライセンス」「得意タスク」で判断します。以下に2025〜2026年時点の主要候補をまとめます。
| モデル | 配布サイズ(Ollama) | ライセンス/文脈 | 強み |
|---|---|---|---|
| Qwen3.8 | 27B(18GB) | Apache 2.0/256K | 最新世代。画像入力・思考モード対応。コード・長文・エージェントに強いと公式に記載 |
| Qwen3.5 | 4B〜35B(3.3〜22GB)、122B(81GB) | Apache 2.0/256K | 画像入力対応。201言語・方言に対応と記載 |
| gpt-oss | 20B(14GB)/120B(65GB) | Apache 2.0/128K | 20Bは16GBメモリで動作と公式に記載。推論・ツール呼び出し |
| Gemma 4 | E2B〜E4B(〜9.5GB)、12B(約8GB)、26B MoE・31B(16〜20GB) | Apache 2.0/128K〜256K | 画像入力・思考モード・関数呼び出し。26BはMoE(活性3.8B) |
| Qwen3-Coder | 30B(総30.5B・活性3.3B) | Apache 2.0/256K | コード生成・エージェント用途向けのMoE |
| DeepSeek-R1蒸留版 | 1.5B〜70B | MIT(ベースの規約も継承) | 推論(思考)重視。14BはQwen2.5ベース |
| Phi-4 | 14B | MIT/16K | 小型で推論・数学に強い。文脈は短め |
| Llama 4 Scout | 109B MoE(配布67GB) | Llama 4 Community License/最大10M | 超長文向き。大容量メモリが前提。独自条件あり。公式対応言語に日本語は含まれない |
| 旧世代(Gemma 3・Qwen3) | Gemma 3 27B(17GB)、Qwen3 30B(19GB) | Gemma Terms of Use/モデルによる | 定番で事例が多い。新規なら上の新世代から |
| 国内モデル(ELYZA、LLM-jp等) | モデルによる | モデルによる | 日本語特化。詳細は日本語の節 |
モデル選定の実践的な判断基準
- メモリ(VRAM)量が最大の制約:Ollamaの配布サイズが目安です(例:Qwen3.5 9Bは約6.6〜7.6GB、Gemma 4 12Bは約7.7〜8.0GB、gpt-oss-20bは約14GB)。実行時は会話の長さに応じたKVキャッシュ分の余白が別に必要です。
- 量子化でトレードオフ:4bit系(Q4_K_M等)はFP16の約4分の1のメモリで動かせ、8bit(Q8)は品質重視です。複雑な推論では高ビットが安定します。
- 日本語の品質は公式の対応言語だけで決めない:自分のプロンプトで比べるのが確実です。
- コード生成:Qwen3-Coder 30B(活性3.3B)のようなコード特化モデルを候補にします。
パラメータ数・MoE・活性パラメータの読み方
モデル名の「30B」「A3B」といった表記は、メモリと速度の見方が違います。Mixture of Experts(MoE)のモデルでは、全部の重みの数(総パラメータ)と、1トークンごとに実際に使う数(活性パラメータ)が別々に書かれます。
| 用語 | 意味 | 効くところ |
|---|---|---|
| 総パラメータ | モデルが持つ重みの総数 | 必要メモリ(配布サイズ) |
| 活性パラメータ | 1トークンの生成で使う重みの数 | 生成の計算量(速度) |
| エキスパート | MoEの中の専門ブロック。入力ごとに一部だけが選ばれる | 活性が小さくても総量は大きいまま |
例えばQwen3-30B-A3Bのモデルカードには「30.5B in total and 3.3B activated」、エキスパート128個のうち8個を使うと書かれています(Hugging Face)。Gemma 4の26Bは総25.2B・活性3.8Bで、Ollamaの配布サイズは16〜19GBです。12Bの約8GBと比べると、活性が小さくても、メモリは総パラメータに引っ張られることが分かります。選ぶときは「メモリは総パラメータで決まり、速さは活性パラメータで決まる」と覚えてください。
日本語で使うおすすめのローカルLLM|日本語特化モデルの比較
日本語の品質は、公式の対応言語の記載だけでは決まりません。多言語対応を公式に明記しているモデルと、日本語向けに追加学習されたモデルに分けて考えます。下表はHugging Faceのモデルカードで確認した内容です(2026年10月29日確認)。
| モデル | 区分・サイズ | ライセンス | 公式の記載 |
|---|---|---|---|
| Qwen3.5 | 多言語・4B〜122B | Apache 2.0 | 201言語・方言に対応 |
| Gemma 4 | 多言語・E2B〜31B | Apache 2.0 | 140以上の言語で事前学習、35以上を標準サポート |
| GPT-OSS-Swallow 20B | 日本語向け追加学習・約21B | Apache 2.0 | 日本語・英語に最適化。文脈は32Kまで学習・評価 |
| ELYZA-Thinking-1.0-llm-jp-4-32b-a3b | 日本語向け・総32B(MoE) | Apache 2.0 | llm-jp-4-32b-a3bをベースに、日本語の推論・指示追従・知識を改善 |
| Sarashina2.2 3B instruct | 日本語モデル・3B | MIT | SB Intuitionsが学習した日本語の自己回帰モデル |
選び分けの目安は、メモリが小さければSarashina2.2の3B、16GB前後ならQwen3.5 9BやGemma 4 12B、日本語の質を優先して大きめを使えるならGPT-OSS-SwallowやELYZAの32B級です。GPT-OSS-Swallowはモデルカード、ELYZAはモデルカードで条件を読めます。どれを選ぶ場合も、同じ日本語プロンプトを10件ほど流して出力を並べると違いが分かります。
Llama 4は日本語で使えるか
Meta公式のモデルカードでは、Llama 4(Scout・Maverick)の公式対応言語は12言語で、アラビア語・英語・フランス語・ドイツ語・ヒンディー語・インドネシア語・イタリア語・ポルトガル語・スペイン語・タガログ語・タイ語・ベトナム語です。日本語は公式対応言語に含まれていません。同じカードには、12言語より幅広い言語で学習されており、ライセンスと利用規約を守れば他の言語向けにファインチューニングしてよいとも書かれています。
つまり「日本語がまったく扱えない」とは書かれていませんが、日本語の品質を公式が保証してはいません。日本語の業務利用では、上の表のように多言語対応を明記したモデルか日本語向けに追加学習されたモデルを先に試し、Llama 4を使う場合は自分の文書で品質を確かめてから決めてください。配布サイズはScoutが67GB、Maverickが245GBで、長いコンテキスト(Scoutは10M)が必要な場面向けです。
出典:Meta Llama 4 モデルカード、Ollama Llama 4(2026年10月29日確認)。
MacでローカルLLMを選ぶなら|ユニファイドメモリから逆算する
Apple SiliconのMacは、CPUとGPUが同じメモリ(ユニファイドメモリ)を共有します。WindowsのVRAMに相当するのは、Macに積んだメモリ全体です。選び方は「配布サイズ+会話の長さ分の余白+OSやほかのアプリの分」が収まるモデルを探すのが基本です。
OllamaはApple Silicon向けに、AppleのMLXを使うエンジンを2026年3月30日にプレビュー公開しています(Ollama公式ブログ)。配布ページにも「-mlx」のタグが並びます。
| Macのメモリ | 選びやすいモデル | 配布サイズ |
|---|---|---|
| 16GB前後 | Gemma 4 12B(MLX)、Qwen3.5 9B | 約7.7GB/6.6〜7.6GB |
| 32GB前後 | Qwen3.8 27B(MLX)、Gemma 4 26B(MLX) | 18GB/18GB |
| 64GB以上 | gpt-oss-120b、Qwen3.5 122B | 65GB/81GB |
Mac Studioの公式仕様では、M5 Maxは36GBが標準で最大128GB、M5 Ultraは96GBが標準で最大512GBまで選べます(Apple公式、2026年10月29日確認)。購入後にメモリは増やせないため、使いたいモデルの配布サイズから逆算して選びます。
おすすめのGPUとPC構成|機種別のVRAMと費用の考え方
NVIDIA公式の比較ページで確認できるGeForce RTX 50シリーズのVRAMは次のとおりです(NVIDIA公式、2026年10月29日確認)。価格は時期で変わるため載せていません。
| GPU | VRAM | 動かせる目安 |
|---|---|---|
| RTX 5090 | 32GB | Qwen3.8 27B(18GB)、Gemma 4 31B(19〜20GB)に余裕 |
| RTX 5080/5070 Ti | 16GB | Qwen3.5 9B、Gemma 4 12B、gpt-oss-20b |
| RTX 5060 Ti | 16GBまたは8GB | 16GB版は上と同じ。8GB版は4B級まで |
費用の考え方(クラウドAPIとの損益分岐)
ローカルは「機材費+電力+運用の工数」、クラウドは「トークン単価×月間使用量」です。使用量が少ないうちはクラウドが安く、大量のバッチ処理や機密データの常時処理が増えるほどローカルが有利になります。比べるときは、自社の月間トークン量と、GPUの購入額・電気代・保守の人件費を同じ期間に直して並べてください。
ランタイム(推論エンジン)の比較
モデルファイルを実際に動かす「ランタイム」の選択は、使いやすさ・速度・API互換性に直結します。
| ツール | 対応OS/GPU | API互換/難度 | 特徴 |
|---|---|---|---|
| Ollama | Win / Mac / Linux / CUDA / Metal / ROCm | API ◎ / ★☆☆(簡単) | コマンド一発でモデル取得・起動。REST APIで即アプリ連携可能。最も普及 |
| llama.cpp | Win / Mac / Linux / CUDA / Metal / Vulkan | API ○(サーバモード) / ★★☆(中程度) | CPU推論の王者。GGUF形式の事実上の標準。最軽量・最カスタマイズ性 |
| LM Studio | Win / Mac / Linux / CUDA / Metal | API ◎ / ★☆☆(簡単) | GUIでモデル検索・管理・チャットまで完結。非エンジニアに最適 |
| vLLM | Linux(主) / CUDA(必須) | API ◎ / ★★★(高度) | 本番サービング特化。PagedAttentionで高スループット。マルチGPU対応 |
| text-generation-webui | Win / Mac / Linux / CUDA / CPU | API ○ / ★★☆(中程度) | Gradio UI内蔵。ファインチューニング(LoRA)もGUIで可能 |
| Jan | Win / Mac / Linux / CUDA / Metal | API ◎ / ★☆☆(簡単) | オープンソースのデスクトップアプリ。Ollamaに近い使用感 |
用途別ランタイムの選び方
- 個人・社内検証の入門:Ollamaが第一選択。
ollama pull qwen3の一行でモデル取得から起動まで完了し、http://localhost:11434のOpenAI互換APIがそのまま使える。 - 非エンジニアがGUIで使いたい:LM Studioはモデル検索・ダウンロード・チャットがGUI一体型。PCスペック確認機能もあり安心。
- 本番API・高並列処理:vLLMは複数ユーザーからの同時リクエストを効率的に捌けるため、社内APIサーバー化に最適。ただしGPUサーバー前提。
- GPU非搭載の省スペースPC・Apple Silicon:llama.cppはCPUのみ・Metal対応で動作し、Raspberry Pi等での実験も可能。
ローカルLLMの導入やRAG構築をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
OllamaとLM Studioを入れて動かす手順(最短)
導入の詳しい手順はローカルLLMの導入にあります。ここでは、公式ドキュメントに書かれた最短の流れだけを示します。
Ollamaの場合
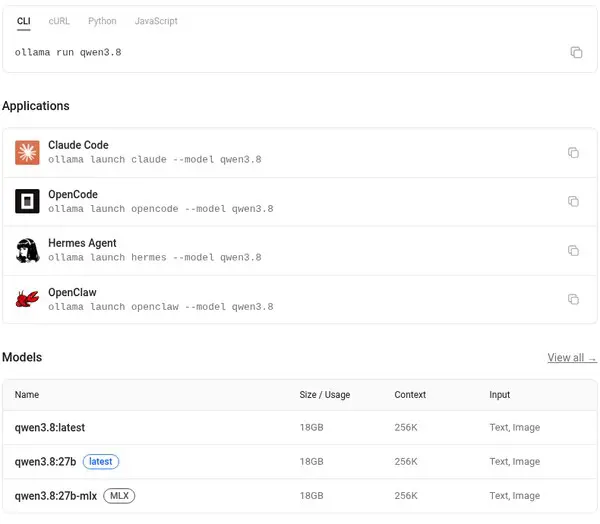
- ollama.com/downloadからmacOS・Windows・Linux向けを入手して、アプリを開く。
- ターミナルで
ollama run gemma4:e2bを実行する。公式のクイックスタートでは、約8GBのVRAMまたはユニファイドメモリが目安で、ダウンロードは約7.2GBと案内されています。 - モデルの取得後にそのまま会話が始まる。終了は
/bye。
Ollamaの基本コマンド集
モデルの取得・確認・削除は次のコマンドで足ります。公式のCLIリファレンスに載っているコマンドだけをまとめました(モデル名は公式の例のgemma4を使っています)。
| やりたいこと | コマンド | 説明 |
|---|---|---|
| 起動して会話する | ollama run gemma4 | モデルがなければ取得してから対話を始める。引用符で質問を付けると1回だけ答えて終わる |
| 取得だけする | ollama pull gemma4 | モデルをダウンロードする(会話は始めない) |
| 取得済みを一覧する | ollama ls | ダウンロード済みのモデルを表示する |
| 動いているモデルを見る | ollama ps | メモリに読み込まれて動いているモデルを表示する |
| モデルを止める | ollama stop gemma4 | 動いているモデルを止めてメモリを空ける |
| モデルを消す | ollama rm gemma4 | ダウンロード済みのモデルを削除してディスクを空ける |
| 自分用に調整する | ollama create -f Modelfile | ベースのモデルとシステムプロンプトを書いたModelfileから、調整済みのモデルを作る |
| サーバーとして起動する | ollama serve | Ollamaのサーバーを起動する。ollama serve --helpで設定できる環境変数が見られる |
| 外部アプリと連携する | ollama launch claude --model qwen3.5 | OpenCode・Claude Code・Codex・VS Code・DroidからOllamaのモデルを使えるように設定して起動する |
モデルを何個も試すと容量が増えるため、ollama lsで一覧を見て、使わないものをollama rmで消すのが基本の整理です。出典:Ollama公式CLIリファレンス(2026年10月29日確認)。
LM Studioの場合
- 公式の基本ガイドで動作要件(Mac M1〜M4、Windows x64/ARM、Linux x64/ARM64)を確認し、lmstudio.ai/downloadから入れる。
- Discoverタブでモデルを選ぶか、名前で検索してダウンロードする。
- Chatタブのモデルローダーで読み込み、チャット欄に入力して会話する。
出典:Ollama公式クイックスタート、LM Studio公式ガイド(2026年10月29日確認)。
フロントエンド・管理UIの比較
ランタイムの上にチャットUIやRAG機能を重ねるフロントエンド層も選択肢が広がっています。
| ツール | 連携ランタイム | RAG/複数人 | 特徴 |
|---|---|---|---|
| Open WebUI | Ollama / OpenAI互換 | RAG ◎(内蔵) / 複数人 ○ | ChatGPT風UI。画像生成・音声入力・プラグインも対応。Dockerで即起動 |
| AnythingLLM | Ollama / LM Studio / OpenAI互換 | RAG ◎(ワークスペース型) / 複数人 ○(チーム向け) | PDFや社内文書のRAGをGUIで構築できる。エージェント機能も内蔵 |
| Dify | Ollama / OpenAI互換他 | RAG ◎ / 複数人 ◎ | ノーコードでRAGアプリ・AIワークフローを構築。本番利用に向いた構成 |
| PrivateGPT | llama.cpp / Ollama | RAG ◎ / 複数人 △ | 完全オフライン前提。機密文書RAGに特化した設計 |
| LibreChat | OpenAI互換全般 | RAG ○ / 複数人 ◎ | 複数LLMの切替・ユーザー管理・会話履歴管理が充実。社内展開に向く |
フロントエンド選定のポイント
社内RAGの構築では、AnythingLLM+Ollama+Qwen3.5などの多言語モデルという組み合わせが、導入の手間が少ない構成の一例です。PDFや社内マニュアルをドラッグ&ドロップでナレッジベースに追加できるため、非エンジニアの担当者でも運用に参加できる点が実務上の大きな利点です。チーム展開が必要な場合はDifyかLibreChatが向いており、Dockerで迅速に環境を整えられます。
失敗しないローカルLLMの選び方|選定の順番
ローカルLLMの選定で押さえておきたいのは、「どのモデルが一番賢いか」から選び始めると、後で作り直しになりやすいということです。実際に採られている選定の順番を、モデル表とは別の実務目線でまとめます。
まず決めるのはモデルでもツールでもなく「機密要件と隔離レベル」です。ローカルで動かす最大の理由がデータを外に出さないことなら、推論を行う端末・サーバーの外部通信可否や、フロントエンドが自動送信するテレメトリの有無まで先に確認します。ここを曖昧にしたまま高性能モデルを選ぶと、せっかくローカル化した意味が薄れます。次に手元のVRAMという「動かせる上限」から逆算してモデルサイズと量子化を絞り込み、最後に自社の実データで少数の出力を人手評価して初めて本採用します。ベンチマークの数字より、この「実データでの数件チェック」が採否を左右することがほとんどです。
もう一点、実務的な勘所として、モデルは差し替え前提で組むことを強くおすすめします。OpenAI互換APIを共通の窓口として使い、新しい有力モデルが出るたびにアプリ側を触らずモデルだけ入れ替えられる構成にすると扱いやすくなります。ローカルLLMは進化が速いため、特定モデルに密結合させないことが、結果的に一番運用コストを下げる選び方です。
性能・ベンチマークの見方と実用的な注意点
MMLU・HumanEval・MATHなどの学術ベンチマークはモデル選定の参考になりますが、実業務での性能とは必ずしも一致しません。
- 日本語ベンチマーク(JCommonsenseQA・JNLI等)を確認する:英語ベンチマーク上位のモデルが日本語では大幅に性能を落とすケースがある。
- コンテキスト長(Context Length):長文書RAGでは8K〜32Kトークン以上が実用水準。モデルによって有効活用できるウィンドウ長に差がある。
- 推論速度(トークン/秒):チャット用途ではVRAM量により10〜80トークン/秒前後が目安。CPU推論はGPUの10分の1以下になる場合が多い。
- 量子化による品質劣化:Q4_K_Mは多くのタスクで実用上問題ないが、複雑な推論・論理問題では誤りが増える傾向がある。重要タスクはQ6以上を推奨。
ベンチマーク指標を実務でどう読むか:速度・品質・コンテキスト長
公開ベンチマークは選定の入口としては便利ですが、数値をそのまま自分の環境の性能予測に使うと外します。ここでは「どの指標を、どんな限界を踏まえて読むか」を実務目線で整理します。
まず見るべき4つの指標と、その落とし穴
| 指標 | 意味と注意 |
|---|---|
| 生成速度(tokens/sec) | 1秒あたりの出力トークン数。体感の速さに直結。注意:プロンプト処理速度と生成速度は別物。バッチや短文と長文で大きく変わる |
| 品質ベンチ | 知識・推論などをテスト形式で採点したスコア。注意:設問形式に最適化されやすく、実タスクの使い勝手とは一致しないことがある |
| コンテキスト長 | 一度に扱える入力+出力の上限。注意:公称の最大長と、精度を保てる実効長は乖離しがち。長文ほど破綻・失速しやすい |
| 量子化後の品質 | 軽量化した状態での実力。注意:量子化で品質は下がる傾向。ベンチ値が非量子化なら手元と条件が違う |
公開ベンチが自分の環境に当てはまらない理由
- 測定条件が違う:ハード、ランタイム、量子化の有無、プロンプト設計が異なれば速度も品質も変わります。
- タスクが違う:汎用ベンチが高くても、あなたの日本語業務・要約・コード補助での実力は別問題です。
- 更新頻度:モデルもランタイムも更新が速く、古い数値は現状を反映しません。
数値の罠(チェリーピック)を避ける
- 好条件のみを切り出した比較でないか(最速ケース・特定設問だけ)を疑う。
- 速度と品質はトレードオフになりやすいので、片方だけの数値で判断しない。
- ライセンスや正確なスコアは二次情報を鵜呑みにせず公式で確認する。
結論:自分のタスクで小さく実測する
最も確実なのは、候補を2〜3本に絞り、実際に使う代表プロンプトを10件ほど用意して手元で回すことです。生成速度・出力品質・長文での安定性を同じ条件で比べれば、公開ベンチのバイアスに左右されず、あなたの用途に最適な1本が見えてきます。
用途別の選定マトリクス|要件からモデルとランタイムを決める
個別の比較表を眺めても「結局どれ」と迷うのは、比較軸が自分の要件に紐づいていないからです。ここでは、比較を「自分の要件で決める表」に落とし込む枠組みだけを扱います。各モデルの詳細スペックやランタイムの機能比較は本記事の他セクションを参照し、ここでは決め方に徹します。
まず決める5つの軸
候補を絞る前に、次を自分の言葉で言語化します。ここが曖昧なままだと比較が発散します。
- 用途:チャット補助/文書要約・分類/コード生成/RAG(社内文書検索)など、主タスクを1つに絞る
- 機密度:外部送信が許されるか。不可なら完全ローカルが前提になり選択肢が変わる
- 日本語要否:日本語の入出力品質が主目的か、英語中心の補助か
- 予算:GPUを新調するか、手持ちCPU/内蔵GPUで回すか(機材詳細は他記事参照)
- 運用体制:個人が試すのか、チームで共有・更新し続けるのか
軸から候補を絞る考え方
- 機密度が高い→クラウドAPIを外し、ローカル完結できるモデル・ランタイムに限定する
- 予算が小さい→小さめパラメータ帯を先に候補化し、大型は保留にする
- 日本語が主目的→日本語評価の情報が多いモデルを優先し、実際は自分の代表プロンプトで試す
- 運用体制がチーム→導入・更新のしやすさ(GUI有無、モデル入れ替えの手間)をランタイム側の判断材料に加える
1つの軸で候補が絞れたら次の軸を重ねる、を繰り返します。すべてを一度に満たそうとせず、外せない軸(多くは機密度)から順に足切りするのがコツです。
決定マトリクスの例(行=用途)
| 用途 | 重視する軸 | 絞り込みの方向 | ランタイムの向き |
|---|---|---|---|
| 個人のチャット補助 | 手軽さ・日本語 | 中小サイズを優先 | GUI付きで開始 |
| 社内文書のRAG | 機密度・日本語 | ローカル完結を必須条件に | API連携しやすいもの |
| コード生成の補助 | 用途特化・予算 | コード向けとされるモデルを候補化 | エディタ連携重視 |
| 要約・分類の自動化 | 安定性・運用 | 小型でタスク特化を検証 | スクリプトから叩ける形 |
※ 表は「軸→絞り込みの向き」を示す枠組みです。具体的なモデル名・ライセンス・性能値は各モデルの公式情報で必ず確認してください。
迷ったときの初手
決めきれないときは、用途を1つに絞り、小さめのモデル+導入の簡単なランタイムで最小構成を動かすのが最短です。自分の代表的な入力を10件ほど流し、日本語品質・速度・手間を体感してから、必要に応じて大型やGPU増強へ進みます。最初から最上位を狙わず、要件に効く軸だけで一巡させることが、比較疲れを避ける近道です。
「自分のGPUで動くか」で候補を先に絞る──VRAMと量子化の判断軸
モデル比較でありがちな失敗は、パラメータ数やベンチマークのスコアだけを横並びにして「一番賢いもの」を選んでしまうことです。ローカルLLMでは、そのモデルが手元のGPUのVRAMに収まって実用速度で動くかが先に決まり、収まらないモデルはどれほど高性能でも候補から外れます。比較表を作る前に、まず自分の環境で動く範囲へ候補を絞り込むのが実務の順序です。
必要VRAMのざっくり見積もり方
重み(モデル本体)の占有量は「パラメータ数 × 1パラメータあたりのバイト数」でおおまかに見積もれます。量子化(重みを低ビットで表す圧縮)によってこのバイト数が変わります。以下はあくまで概算であり、実際の必要量は実装(推論エンジン)や設定によって変動するため、最終的には使用するツールの公式情報や実測で確認してください。
- FP16(無圧縮): 約2バイト/パラメータ。7Bで約14GB、13Bで約26GB(概算)。
- 8bit(Q8系): 約1バイト/パラメータ。7Bで約7GB(概算)。
- 4bit(Q4系): 約0.5バイト/パラメータ。7Bで約4GB前後(概算。実際の量子化フォーマットにより誤差あり)。
これに加えて、会話履歴や入力文書を保持するKVキャッシュがコンテキスト長に比例してVRAMを食います。長文RAGや長い会話を想定するなら、重みだけでVRAMを使い切らず余白を残して候補を選ぶ必要があります。VRAMをはみ出すと一部がCPU/メインメモリにオフロードされ、生成速度が目に見えて低下することがあります。低下の度合いはハードウェア構成や推論エンジンの実装に依存するため一概な数値では言えませんが、「入り切る中で最も品質の高い量子化」を狙うのが判断軸になります。
量子化レベルの選び分け
| 量子化 | VRAM | 品質の傾向 | 向く選択場面 |
|---|---|---|---|
| Q4_K_M など4bit系 | 最小級 | 実用範囲で劣化は小さめとされることが多い | VRAMが厳しい/まず動かして比較したい |
| Q5・Q6系 | 中 | 4bitより余裕がある | VRAMに余裕があり品質を上げたい |
| Q8・FP16 | 大 | 劣化はほぼ無いとされる | 精度検証・出力を厳密に比較したい |
品質の傾向は量子化手法やモデルによって差があるため、上表は一般的な目安として捉えてください。比較の実務では、まず4bitで複数モデルを同条件で走らせて絞り込み、最終候補だけ高ビットで精度を見比べる、という二段構えが効率的です。「同じ7Bでも量子化が違えば別物」という前提を持つだけで、公開ベンチマークの数字を鵜呑みにする比較から一歩抜け出せます。
用途とライセンスで最終候補を1つに絞る|目的別の重み付けとライセンス確認
VRAMで動く範囲まで絞れたら、次は「何に使うか」で評価軸の重みを変えて最終候補を決めます。総合力が高いモデルが自分の用途で最適とは限らず、コード生成・日本語対応・長文RAG・エージェント用途では重視すべき性質が異なります。汎用ランキングをそのまま使わず、自分のタスクに合わせて評価軸を並べ替えるのが選定の要点です。
用途別に重視する評価軸
| 主な用途 | 特に効く性質 | 比較時に見るポイント |
|---|---|---|
| コード生成・補助 | コード特化の学習/長い出力の安定性 | コード系ベンチ、対応言語、指示追従の崩れにくさ |
| 日本語の文章生成 | 日本語データでの学習量・トークナイザ | 日本語出力の自然さを自分のプロンプトで実測 |
| 社内文書RAG | 長コンテキスト・文脈への忠実性 | 対応コンテキスト長、与えた文書外を作らないか |
| エージェント/自動化 | tool calling(関数呼び出し)対応 | 構造化出力・JSON整形の安定度 |
ベンチマークのスコアは出発点にはなりますが、最終判断は自分の代表タスクを複数用意し、候補モデルへ同じプロンプトを投げて出力を並べるのが確実です。ローカルで動かす場合はAPIの従量課金を気にせず繰り返し試せる点が、この実地比較を行いやすくしています(ただし電力・ハードウェアのコストは別途かかります)。
ライセンス(商用利用の可否)の確認手順
用途で品質が拮抗したときに効いてくるのが利用条件です。ローカルLLMは公開モデルごとにライセンスが異なり、寛容な種類のライセンス(例: Apache 2.0 や MIT系)を採用しているものもあれば、独自の利用規約で利用規模・再配布・出力の再学習利用などに条件を付けているものもあります。どのモデルがどのライセンスかは変更されることもあるため、伝聞や本記事の一般論で判断せず、必ず配布元の一次情報で確認してください。
- 配布元のモデルカードと同梱の LICENSE ファイルを直接読む。
- 「商用利用の可否」「大規模利用時の追加条件」「生成物の権利・再利用の扱い」を項目として確認する。
- 派生・ファインチューニング版を使う場合は、ベースモデルのライセンスが継承される点も見る。
- ライセンス条件は改定されることがあるため、最新版を配布元の公式情報で都度確認する。
技術的に動くこと・出力が良いことに加えて、自社の使い方がライセンス条件の内側に収まるかまで確認して初めて、安心して本番採用できる「最終候補1つ」に絞り込めます。
クラウドLLMとローカルLLMの使い分け
ローカルLLMに移行すべきかどうかは、要件に応じて判断が必要です。
- 機密情報・個人情報を含む文書処理
- 大量バッチ処理でAPIコストが膨大
- 社内専用モデルへのファインチューニング
- ネットワーク非接続環境での推論
- レスポンスタイムをコントロールしたい本番システム
- 最高水準の性能が必要なタスク(各社の最新クラウドモデル)
- GPU環境を用意できない場合
- マルチモーダル(高精度な画像・音声)処理
- 少量利用で初期コストを抑えたい場合
- 最新モデルへの追従が必須な用途
なお、クラウドLLMも含めたより広範なモデル比較(GPT・Claude・Gemini等との横断的な比較)については、AIモデルの比較(LLM比較)の記事で詳しく解説しています。ローカルLLMの選定と合わせて参照することで、用途に応じた最適な選択が可能になります。
推奨スペック・GPUの選び方など構築の詳細は → こちらの専門記事にまとめています。
ローカルLLMのおすすめに関するよくある質問
ローカルLLMで今いちばんおすすめのモデルは?
用途とメモリ量で変わります。16GB前後ならgpt-oss-20b、Qwen3.5 9B、Gemma 4 12B、24GB以上なら最新世代のQwen3.8 27B、コード生成ならQwen3-Coder 30Bです。最後は自分の代表的なプロンプトを10件ほど流して比べてください。
日本語で使うならどれを選べばよいですか?
Qwen3.5は201言語・方言、Gemma 4は140以上の言語で事前学習と公式に記載されています。日本語向けに追加学習されたGPT-OSS-Swallowもあります。日本語の自然さは同じプロンプトで出力を並べて比べるのが確実です。
商用利用はできますか?
本記事で挙げたQwen3.8、Qwen3.5、gpt-oss、Gemma 4、Qwen3-CoderはApache 2.0、Phi-4とDeepSeek-R1はMITです。Llama 4はLlama 4 Community Licenseという独自条件があります。ライセンスは改定されるため、利用前に配布元で最新の条文を確認してください。
GPUがなくても動かせますか?
CPUのみでも動かせるランタイム(llama.cppなど)はありますが、GPUの10分の1以下の速度になる場合が多く、小さなモデルが前提です。
モデルはどのくらいの頻度で入れ替わりますか?
進化が速く、本記事の表も数か月で古くなります。OpenAI互換APIを窓口にして、モデルだけを差し替えられる構成にしておくと運用が楽です。
出典(確認日:2026年10月29日)
- Ollama:Qwen3.8/Qwen3.5/gpt-oss/Gemma 4/Llama 4/Gemma 3/Qwen3
- Hugging Face:Qwen3.8-27B/Qwen3.5-9B/gemma-4-12b-it/Qwen3-Coder-30B-A3B-Instruct/phi-4/DeepSeek-R1-Distill-Qwen-14B
まとめ
ローカルLLMの比較では「モデル・ランタイム・フロントエンド」の3層を、メモリ量と用途から選びます。
- 16GB前後で始める:gpt-oss-20b、Qwen3.5 9B、Gemma 4 12B + Ollama。
- 24GB以上・品質優先:Qwen3.8 27B(配布18GB)。
- コード生成:Qwen3-Coder 30B。
- 社内RAG構築:AnythingLLMまたはDify + Ollama。
- 本番の高並列API:vLLM + 大型モデル(GPUサーバー必須)。
ローカルLLMの進化は速く、数ヶ月ごとに有力な新モデルがリリースされています。特定のモデルに深く依存しすぎず、ランタイム(特にOllama)のOpenAI互換APIを抽象化レイヤーとして活用し、モデルを差し替えやすい構成にしておくことが長期的な運用コストを下げる鍵です。クラウドLLMとの比較も含め最適な選択をするには、LLM全体の比較記事も併せてご覧ください。
関連記事
- ローカルLLMとは?メリット・始め方・必要環境を解説【2026年版】
- ローカルllm 導入
- ローカルllm 無料
- AIモデルの比較(LLM比較)
- DeepSeekの仕組みと使い方
- オンデバイスAI(ローカル・ブラウザ・オフライン)
LLM・ローカルLLMの業務導入をご検討の方へ
クリスタルメソッドは、オープンモデル・ローカルLLMの選定からRAG構築・PoC・本番導入までのAI開発を支援しています。「機密データを外部に出さずにLLMを使いたい」「自社の業務に合うモデルを選びたい」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
ローカルLLMの構築・導入|手順とおすすめツール【2026年版】
【結論】ローカルLLMの構築は「Ollamaを入れてモデルを1つ動かす」ところから始めます ローカルLLMを自分のPCに構築するいちばん短い道は、無料の実行ツー...
-
無料で使えるローカルLLM|コストゼロで始めるOSSモデルと手順
本ページは「無料」で使えるローカルLLM(無償ライセンスのOSSモデルとコストゼロ運用)に特化したガイドです。導入全体の流れやおすすめツールは、ローカルLLMの...
-
Phi-3とは?軽量ローカルLLMの性能・使い方【2026年版】
Phi-3とは?Microsoftが生み出した小型高性能LLMの全貌 「小型なのに賢い」という常識破りの評価で注目を集めているのが、MicrosoftのPhi-...