
blog
AIブログ
科学技術特化AIモデル活用事例——CERNとMistralが示す研究・製造業への示唆
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
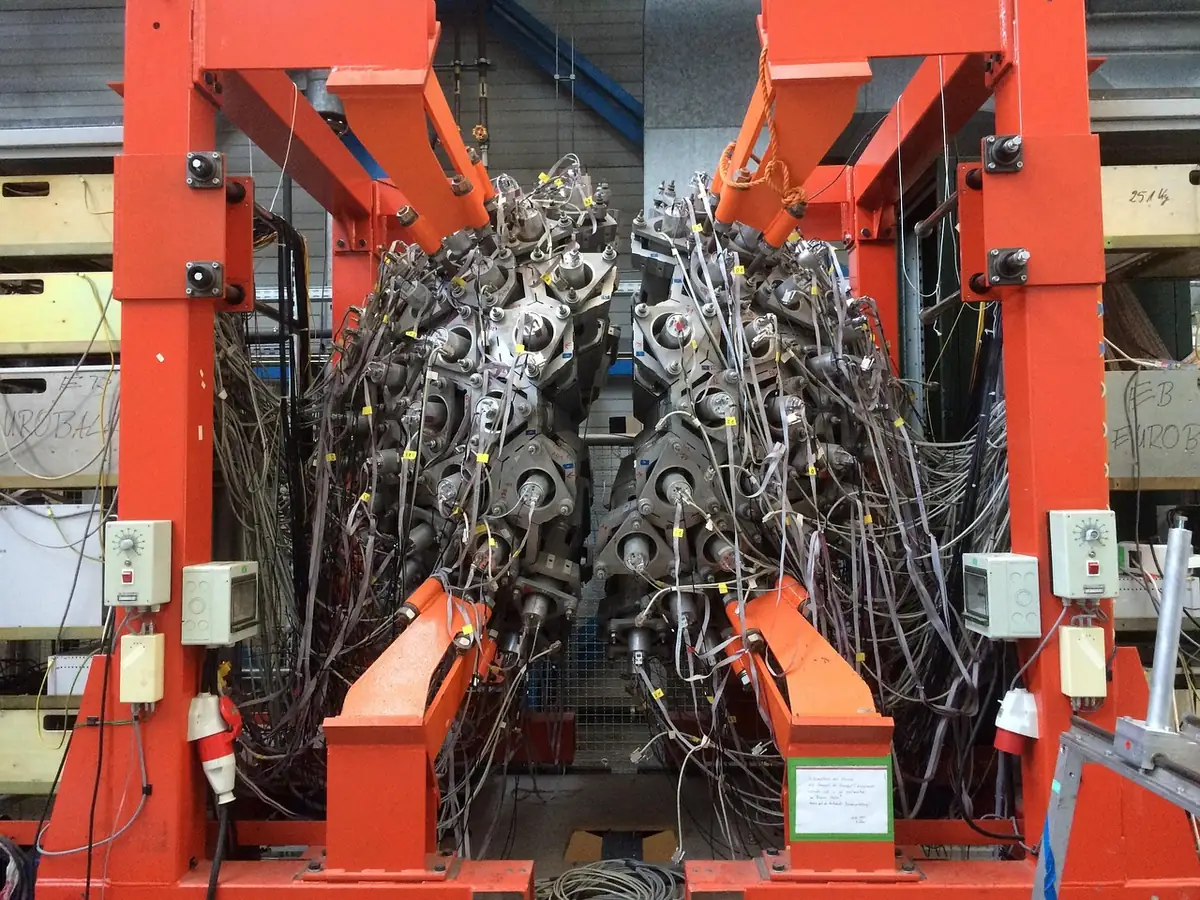
科学技術特化AIモデルの活用事例として注目——CERNとMistral AIの連携
2026年10月15日、欧州原子核研究機構(CERN)とフランスのMistral AIが意向表明書に署名し、高エネルギー物理学に特化した基盤モデル「Flare」(Large Physics Model)の共同開発に乗り出すことを発表した(Times Live、1027wbow.com)。Flareはコライダー物理学向け初の基盤モデルと位置付けられており、LHCが蓄積した約1エクサバイト(100万テラバイト)の実験データを学習基盤とし、衝突再構成・粒子識別・異常検出など複数の専門タスクを単一モデルで担うことを目指す(Crypto Briefing、Token Post)。タイムライン・予算・マイルストーンはいずれも未発表であり、プロジェクトは始動直後の段階にある。
CERN CIOのEnrica Porcari氏は「高エネルギー物理学はAIを厳密に開発・検証できるユニークな環境を提供する」と述べ(Times Live、Token Post)、Mistral CEOのArthur Mensch氏はフロンティアモデルが「科学の進歩に不可欠」とLe Mondeへの寄稿で論じている(Times Live、1027wbow.com)。この連携を単なる研究プロジェクトとして読み過ごすのではなく、「専門ドメインのデータ保有者と大規模モデル開発者が対等に組む」という調達・開発モデルの転換として捉えることが重要である。
関連記事VOICEVOX 使い方|インストールから音声生成まで【2026】 / Grokとは?できること・料金・始め方をやさしく解説【2026年版】 / ディープフェイクとは?仕組み・悪用リスク・見分け方と対策を専門家監修で解説【2026年版】
科学技術特化AIモデルが持つ構造的な意義——汎用LLMとの役割分担
CERNとMistralの事例が浮き彫りにする核心は、汎用大規模言語モデルと科学技術特化モデルの設計思想の根本的な差異にある。
汎用LLMは自然言語の幅広いタスクで高い汎化性能を示す一方、素粒子物理学・材料科学・創薬といった領域では、扱うデータがテキストではなくシミュレーション波形・分子構造・センサーログである。これらは人間の言語とは統計的構造が大きく異なるため、汎用事前学習の恩恵を受けにくい。Flareが「コライダー物理学向け初の基盤モデル」と位置付けられる理由(Times Live)は、ドメイン固有のデータ分布を前提とした設計にある。加えて、LHCの後継であるHL-LHCは2030年頃のアップグレードで衝突数が約10倍に増加する見込みであり(Times Live、Crypto Briefing)、既存の専用アルゴリズムを組み合わせる従来手法が処理限界に達するという切実な課題がこのプロジェクトを駆動している。Flareはその複数の専用アルゴリズムを単一モデルへ統合することで対処しようとしている(Times Live、1027wbow.com)。
科学技術特化AIモデルの活用事例が増加している背景には、「特定ドメインに閉じたデータ量の爆発」と「そのデータを処理するための専門的帰納バイアスの必要性」という二つの構造的要因がある。この傾向は医療画像診断・気象予測・核融合制御など、CERNとは異なる分野でも共通して観察されるパターンである。ディープラーニングの基礎から整理したい場合はディープラーニングの仕組みと最新動向が、マルチモーダルモデルへの理解を深めるにはマルチモーダルAIの概要と活用事例も参照されたい。
科学技術特化AIモデルの活用事例が日本の研究・製造業に示す三つの論点
CERNとMistralの連携が日本の研究機関や製造業の経営・R&D責任者にとって意味するところは、以下の三点に整理できる。
第一に、大規模ドメインデータを持つ組織が特化モデル構築の起点になりうる。CERNが1エクサバイトのLHCデータをMistralに提供して基盤モデルを構築するという構図は、「データ保有者が学習パートナーを選ぶ」時代の到来を示している。日本の素材メーカー・自動車メーカー・精密機器メーカーは、実験ログ・製造センサーデータ・検査画像などの大規模ドメインデータを長年蓄積してきた。このデータが適切に管理・構造化されているかどうかが、特化モデル構築の実現可能性を左右すると考えられる。
第二に、複数の専用アルゴリズムを単一モデルへ統合する発想がR&D部門の工数管理に影響しうる。Flareは衝突再構成・粒子識別・異常検出など、これまで別々のアルゴリズムが担っていたタスクを一元化することを目指している(Times Live)。製造業における非破壊検査・異常検知・プロセス最適化においても同様の統合アプローチが工数の分散を抑えやすくなる可能性がある。ただし、統合によって各タスクの説明可能性や個別調整の柔軟性が下がりうる点は慎重に評価すべきである。
第三に、欧州発オープンウェイトモデルの活用という選択肢が現実味を持ちはじめている。Mistralは2026年10月6日にパラメータ数1兆規模のMistral Large 4をプレビュー公開し(Crypto Briefing)、同月27日には別の新オープンウェイトモデルの一般公開を予定している(Times Live、1027wbow.com)。オープンウェイトモデルはオンプレミス・閉域環境での運用が可能であり、機密性の高い研究データや設計データを扱う日本の製造業・研究機関にとって、データ国外移転リスクを抑えやすい選択肢になり得ると考えられる。生成AIの基礎的な仕組みについては機械学習の概要と実務応用、テキストデータを扱う自然言語処理の基盤技術についてはBERTとNLP入門も参照されたい。
科学技術特化AIモデルの活用事例が示す四つのリスクと限界
CERNとMistralの連携が示す可能性の裏側には、過大評価を避けるべき構造的な制約が存在する。
タイムラインと成果の不確実性
Flareプロジェクトはタイムライン・予算・マイルストーンのいずれも未発表の段階にある(Times Live、Crypto Briefing、Token Post)。科学技術特化モデルの開発は、学習データの品質管理・ラベリング・ドメイン専門家との協調設計に多大な時間と資源を要する。類似プロジェクトを検討する日本の企業も、発表から実用化まで数年単位のスケジュールを前提とした事業計画が必要である。
ドメインデータの品質と管理体制
LHCの実験データは数十億件のシミュレーション衝突データという、整合性が高く大規模な学習基盤を持つ(Crypto Briefing、Token Post)。一方、日本の製造現場で蓄積されてきたセンサーログや検査データは、システム更改・記録フォーマットの断絶・欠損期間を含むことが少なくない。特化モデルの性能はデータ品質に直接依存するため、学習前のデータ整備が最初の関門となる可能性が高い。
説明可能性と規制対応コスト
素粒子物理学の文脈では予測精度と再現性が優先されるが、医薬品承認プロセス・製品安全認証・品質管理の文脈では規制当局への説明可能性が求められる。特化モデルを導入する際には、ブラックボックス性に起因するコンプライアンスリスクを設計段階から織り込む必要がある。スパースモデリングの理解は解釈可能性の観点でも有益であり、スパースモデリングの概要を参照されたい。
ベンダー依存とオープン性のトレードオフ
Mistralはオープンウェイトモデルを志向しているが、CERNとの共同開発モデルFlareの公開範囲・ライセンス形態は現時点で未定である。特定ベンダーとの深い連携は開発速度を高める一方、将来的な乗り換え・内製化の選択肢を狭める可能性がある。調達段階からモデルウェイトの所有権・ライセンス条件を交渉事項に含めることが現実的な対応となる。GANなど生成モデルの構造的理解はGANの仕組みと応用事例で深められる。
日本の研究・製造業が今とるべき実務的な判断軸
CERNとMistralのFlareプロジェクトは、科学技術特化AIモデルの活用事例として「どの組織が、何を目的に、どのようなデータで、いかなるパートナーと組むか」という問いへの一つの具体的な回答を示している。日本の経営・R&D責任者が今できる実務的な準備は、三段階に整理できる。
第一段階:自社データ資産の棚卸し。どのドメインデータが何年分・何件・どのフォーマットで存在するかを定量的に把握する。量だけでなく、時系列的な連続性・ラベルの有無・センサーのバージョン変遷を含めて評価することが、後の学習コスト見積もりの精度を左右する。
第二段階:タスク統合の可否を仮説立案する。現在、異なるチームや異なるアルゴリズムが個別に対応している検査・予測・分類タスクを一覧化し、単一の特化モデルで統合した場合の費用対効果を概算する。この試算が稟議判断の起点となる。
第三段階:パートナー選定の基準を設計する。オープンウェイト志向のモデルプロバイダーを選ぶかクローズドAPIを選ぶかは、データ主権・説明可能性要件・長期コストの三軸で判断することが現実的である。CERN事例が示すのは、データ保有者が対等なパートナーとして開発に参画することで特化性能と知的財産の双方を確保する設計思想である。日本企業が同様の交渉力を持つには、まず自社データの価値を定量化することが前提となる。強化学習やテキストマイニングなど特化モデルと組み合わせる周辺技術については強化学習の基礎と応用およびテキストマイニングの実務活用を参照されたい。AIモデルに関する技術情報の全体像については技術解説ブログのトップページも活用できる。
主要な科学技術特化AIモデルの活用領域比較
現在報告されている科学技術特化AIモデルの主な活用事例を領域別に整理する。各モデルの詳細仕様・ベンチマーク数値は各公式ドキュメントを参照されたい。
| 領域 | 代表的な活用タスク | 主なデータ種別 | 汎用LLMとの主な差分 | 日本企業への転用可能性 |
|---|---|---|---|---|
| 高エネルギー物理学 | 衝突再構成・粒子識別・異常検出 | シミュレーション波形・衝突ログ | 数十億件の非テキストデータで事前学習 | 加速器・放射光施設での研究加速 |
| 創薬・材料科学 | 分子構造予測・特性推定 | 分子グラフ・量子化学計算データ | 化学的帰納バイアスを組み込んだアーキテクチャ | 素材メーカー・製薬企業の研究開発 |
| 製造・品質管理 | 外観検査・異常検知・プロセス最適化 | センサーログ・検査画像 | 少数の異常サンプルでの高精度検出 | 自動車・電機・精密機器メーカー |
| 気象・地球科学 | 数値予報・気候シミュレーション加速 | グリッドデータ・衛星観測 | 物理制約を組み込んだ損失関数 | 気象庁・防災研究機関・エネルギー事業者 |
| 医療画像診断 | 病変検出・セグメンテーション | CT・MRI・病理スライド画像 | 医療特有のアノテーション基準で学習 | 医療機器メーカー・大学病院のR&D |
※ 各モデルの性能数値・ベンチマークは公式一次情報を参照のこと。本表は活用領域の構造的整理を目的とする。
参考文献
- Times Live, “CERN has enlisted the French company Mistral to develop a new AI model for physics” — timeslive.co.za
- 1027wbow.com, 同報道 — 1027wbow.com
- Crypto Briefing, “CERN and Mistral AI partner to build physics AI model Flare” — cryptobriefing.com
- Token Post, “CERN partners with Mistral AI to develop physics-specialized AI model” — tokenpost.com
監修
河合 継(クリスタルメソッド株式会社 代表取締役)
AI・ディープラーニングに関する特許16件の発明者。過去、国立がん研究センターとの共同研究や、テレビ番組でのAI解説実績を持つAI研究者として、AIの研究開発を主導している。
運営会社について | 編集方針
Read next
あわせて読みたい
-
VOICEVOX 使い方|インストールから音声生成まで【2026】
VOICEVOXは無料?商用利用・クレジット表記の結論 VOICEVOXは、商用・非商用を問わず無料で使える音声合成ソフトです。ただし「VOICEVOXを利用し...
-
Grokとは?できること・料金・始め方をやさしく解説【2026年版】
「Grokって最近よく聞くけど、何ができるAIなの?」「ChatGPTと何が違うの?」——そんな方に向けて、このページではGrokのできること・料金・始め方を、...
-
ディープフェイクとは?仕組み・悪用リスク・見分け方と対策を専門家監修で解説【2026年版】
ディープフェイクは、深層学習で実在する人物の顔・声・動作を精密に合成・改変する技術です。映画制作や広告、バーチャルヒューマンといった正当な活用が広がる一方、なり...