
blog
AIブログ
Claude Code ローカルLLM完全ガイド――構成・手順・モデル選定まで
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
Claude Code はローカルLLMでも動かせます。Claude Code は、Anthropic の AI「Claude(クロード)」をターミナルで使う開発ツールですが、送り先を環境変数 ANTHROPIC_BASE_URL で差し替えられます。Ollama・LM Studio・llama.cpp は、Claude Code が話す Anthropic Messages 形式の窓口(/v1/messages)を備えているため、変換用のゲートウェイを挟まずにつながります。ただし Anthropic は「どのゲートウェイを通しても、Claude 以外のモデルへの接続はサポートしない」としており、動作の保証はありません。
この記事では、3つのつなぎ方の手順と実際の画面、モデルの選び方、つまずきやすい点、ローカル運用の限界を、2026年10月14日に確認した公式情報で整理します。
Claude Codeでローカルのllmは使える?
結論として、Claude Code で Ollama や LM Studio などのローカルLLMを使うことは技術的に可能ですが、Anthropic 公式のサポート対象ではありません。ANTHROPIC_BASE_URL に手元の推論サーバーの URL を指定し、認証用の値を ANTHROPIC_AUTH_TOKEN に入れて起動すれば、Claude Code はそのサーバーを Claude の API として扱います。推論サーバーごとの設定は次のとおりです。
| 推論サーバー | Claude Code 側の設定(公式の例) | 変換ゲートウェイ |
|---|---|---|
| Ollama | ollama launch claude で起動。手動なら ANTHROPIC_BASE_URL=http://localhost:11434・ANTHROPIC_AUTH_TOKEN=ollama |
不要 |
| LM Studio(0.4.1以降) | ANTHROPIC_BASE_URL=http://localhost:1234・ANTHROPIC_AUTH_TOKEN=lmstudio |
不要 |
| llama.cpp(llama-server) | ANTHROPIC_BASE_URL=http://localhost:9931(ツールを使うには --jinja を付けて起動) |
不要 |
| OpenAI 互換の窓口だけを持つサーバー | LiteLLM などのゲートウェイの URL(例:http://localhost:4000) | 必要 |
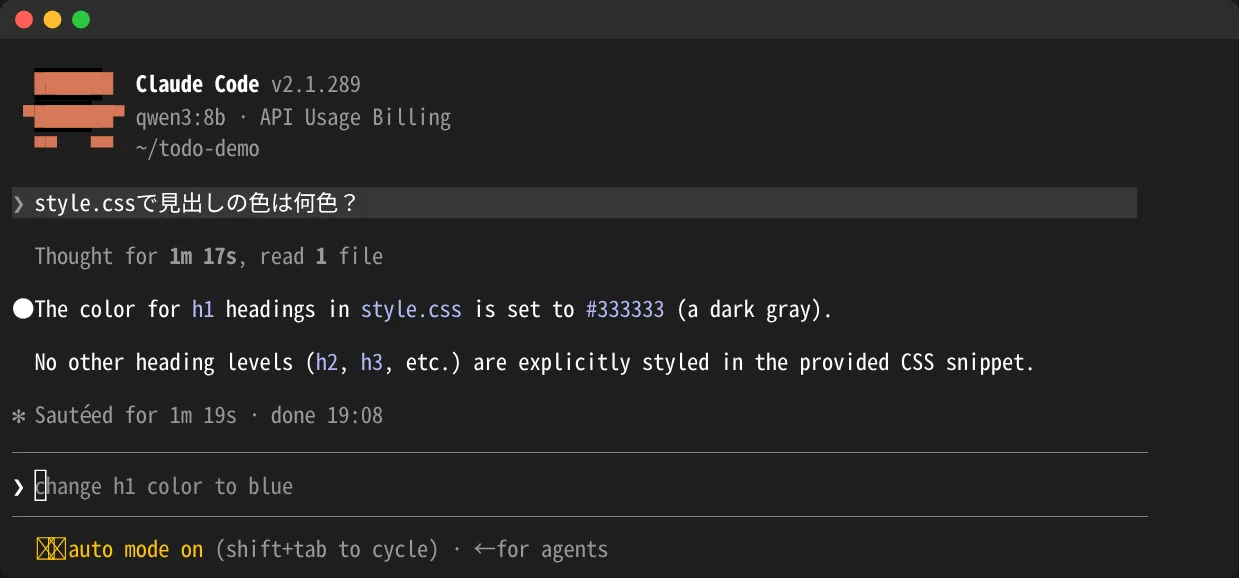
下は、Ollama で ollama launch claude --model qwen3:8b を実行し、手元の qwen3:8b で Claude Code を動かした実際の画面です(2026年10月5日、Ollama 0.34.4・Claude Code v2.1.289 で撮影)。日本語で「style.css で見出しの色は何色?」と聞くと、ファイルを読んで正しく答えましたが、考える時間に1分17秒かかり、回答は英語でした。ローカルの小さなモデルは、速さと日本語の点でクラウドの Claude とは差があると考えてください。
Anthropic の公式ドキュメントは「Anthropic はサードパーティ製のゲートウェイ製品を推奨・保守・監査しておらず、どのゲートウェイを通しても Claude Code を Claude 以外のモデルにつなぐことはサポートしない」と明記しています(Claude Code公式 Other LLM gateways)。Ollama 側も、Anthropic Messages API の「一部」に対応していると説明しており、ツールの選択の指定・遅延読み込みのツール・ホスト型の Web 検索は完全には対応していません(Ollama公式 Anthropic compatibility)。オフラインで動かしたい、コードを外に出したくない、といった目的なら選択肢になりますが、込み入った開発の品質や安定性を求めるならクラウドの Claude を使うのが現実的です。
クラウドのClaudeに送ったコードが学習に使われないようにしたいときは、claude 学習させない 設定で説明しています。
仕組みと公式の立場――ANTHROPIC_BASE_URLで接続先を差し替える
Claude Code は、ふだんは Anthropic の API にリクエストを送り、クラウドの Claude モデルを呼び出します。公式ドキュメントによると、ANTHROPIC_BASE_URL に別の URL を指定すると、Claude Code はそこを Claude の API として扱い、その先にどんなサーバーがあるかは区別しません。認証の値は、ANTHROPIC_AUTH_TOKEN(Authorization: Bearer ヘッダーで送られる)か ANTHROPIC_API_KEY(x-api-key ヘッダーで送られる)に入れます(Claude Code公式 Connect Claude Code to an LLM gateway)。
Claude Code が受け付ける形式は、Anthropic Messages・Amazon Bedrock InvokeModel・Google Cloud’s Agent Platform(旧 Vertex AI)rawPredict の3つです(Claude Code公式 gateway compatibility guide)。ローカルLLMで使うのは、ANTHROPIC_BASE_URL で選ぶ Anthropic Messages 形式です。Ollama・LM Studio・llama.cpp はこの形式の窓口を自前で持つため直接つなげます。それ以外の推論サーバーは、LiteLLM のようなゲートウェイで形式を変換します。
公式にサポートされるのは「Claudeモデルの別ホスティング」
Claude Code が公式に対応している接続先は、どれも Claude モデルを別の環境で動かすものです。Amazon Bedrock、Google Cloud’s Agent Platform(旧 Vertex AI)、Microsoft Foundry、Claude Platform on AWS の4つで、どれを選んでも実際に答えるのは Anthropic の Claude です(Claude Code公式 third-party integrations)。ローカルのモデルに切り替えることとは根本的に違います。Bedrock での設定は Claude Code を Amazon Bedrock で使う方法で解説しています。
ゲートウェイを通してClaude以外のモデルを使うのはサポート外
ゲートウェイ(Anthropic Messages 形式の窓口を持つ中継サーバー)は、本来は組織が認証情報・使用量・費用・監査ログを一か所で管理するためのものです。公式ドキュメントは、どの製品でも「対応する形式の窓口を持つゲートウェイなら動く」としたうえで、Claude 以外のモデルへの接続はサポートしないと書いています(Claude Code公式 Other LLM gateways)。ローカルLLMの構成は、この「動くがサポートはされない」範囲にあります。
なお、OLLAMA_BASE_URL・DEEPSEEK_API_KEY・QWEN_ENDPOINT・LLM_MODEL_OVERRIDE といった環境変数は Claude Code には存在しません(Claude Code公式 環境変数の一覧)。こうした名前を案内している情報を見かけたら、出典を確かめてください。Claude Code 全体の概要はClaude Codeとは、インストールの手順はClaude Codeのインストール手順で解説しています。
次に読む:Claude CodeのAPI料金の仕組みは?
Ollamaでつなぐ手順――いちばん簡単な方法
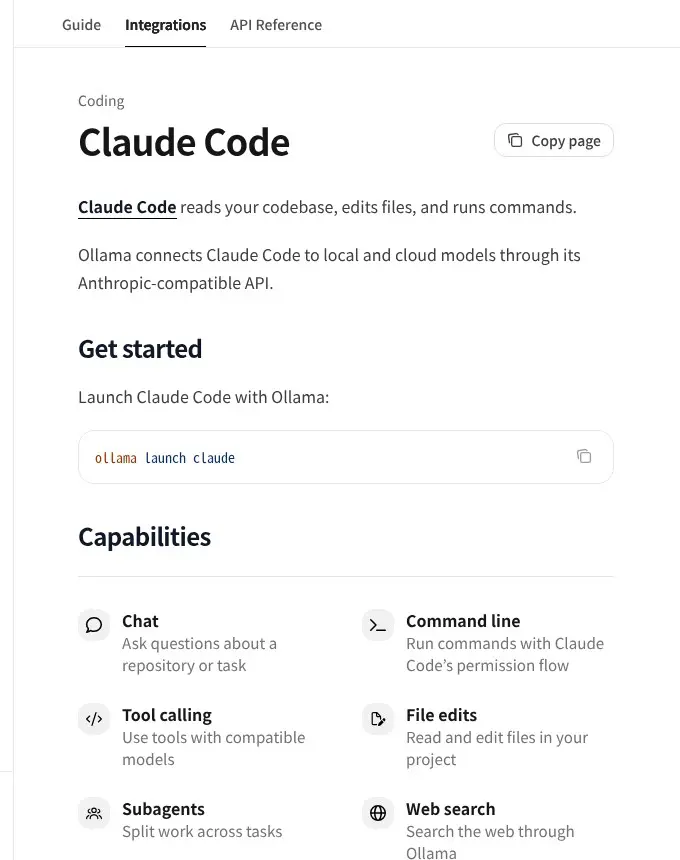
Ollama は Claude Code 向けの公式ガイドを用意しており、手順がもっとも短く済みます(Ollama公式 Claude Code)。2026年10月14日時点の Ollama の最新版は v0.40.4(10月12日公開・公式GitHub)です。
- Ollama をインストールします。macOS・Linux は
curl -fsSL https://ollama.com/install.sh | sh、Windows は PowerShell でirm https://ollama.com/install.ps1 | iexです(Ollama公式 Download)。 - モデルを取得します。例:
ollama pull qwen3.5。ツールを使えるモデル(Ollama のモデル一覧で「tools」と表示されるもの)を選びます。候補は下の「推奨モデル比較」の表を参照してください。 - コンテキスト長を 64K 以上にします。Ollama の既定のコンテキスト長は GPU のメモリで決まり、24GiB 未満なら 4K、24〜48GiB なら 32K、48GiB 以上なら 256K です。公式はコーディングツールでは 64000 トークン以上を勧めています。アプリなら設定画面のスライダー、コマンドなら
OLLAMA_CONTEXT_LENGTH=64000 ollama serveで変えられ、ollama psの CONTEXT 列で確かめられます(Ollama公式 Context length)。 - Claude Code を起動します。
ollama launch claudeを実行するとモデルを選んで起動できます。モデルを決めているならollama launch claude --model qwen3.5です。環境変数で設定する場合は次のとおりです。
export ANTHROPIC_AUTH_TOKEN=ollama
export ANTHROPIC_API_KEY=""
export ANTHROPIC_BASE_URL=http://localhost:11434
claude --model qwen3.5
ANTHROPIC_AUTH_TOKEN=ollama は「値は必要だが中身は使われない」ものです(Ollama公式)。ANTHROPIC_API_KEY="" で空にしておくと、以前に設定した Anthropic の API キーが使われるのを防げます。
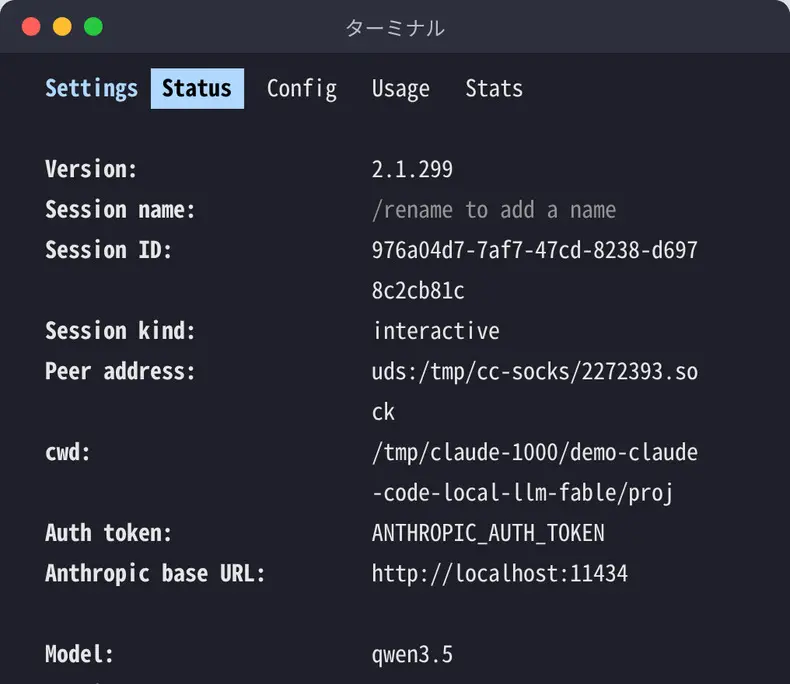
- 接続先を /status で確かめます。Claude Code の中で
/statusを開き、「Anthropic base URL」がhttp://localhost:11434、「Auth token」がANTHROPIC_AUTH_TOKENになっていれば、送り先は手元の Ollama です。公式ドキュメントも、接続の確認に/statusを使うよう案内しています。
Claude Codeにコンテキスト長を伝える(CLAUDE_CODE_MAX_CONTEXT_TOKENS)
Claude Code は、知らないモデル名を指定されると、コンテキスト長を 200K トークンと仮定します。実際に --model qwen3.5 で起動すると、次の警告が出ました。
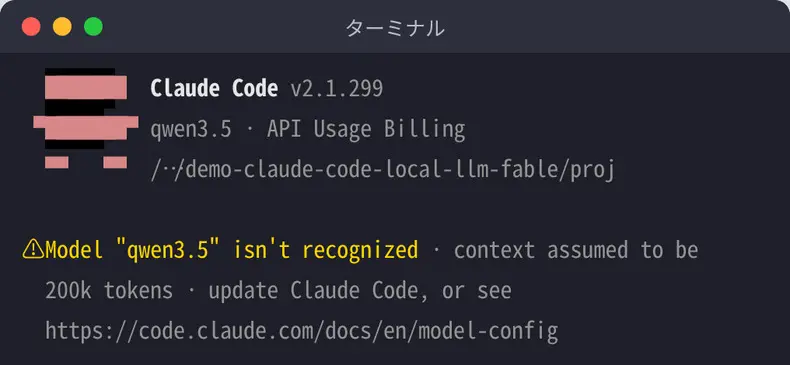
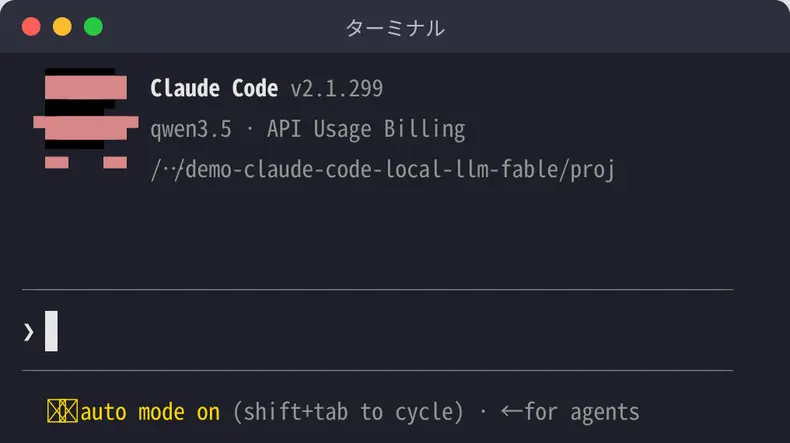
Ollama 側を 64K にしているのに Claude Code が 200K と仮定したままだと、会話が長くなって自動で要約(圧縮)されるタイミングが、実際の上限より後ろになります。公式ドキュメントは、ゲートウェイや独自のモデル名で使うときは CLAUDE_CODE_MAX_CONTEXT_TOKENS に本当のコンテキスト長を入れるよう案内しています(Claude Code公式 Model configuration)。CLAUDE_CODE_MAX_CONTEXT_TOKENS=64000 を付けて同じモデルで起動し直すと、警告は表示されなくなりました。
Ollama には、モデル名の末尾が :cloud の「クラウドモデル」もあります。これは手元ではなく Ollama のサーバーで動くモデルなので、コードを外に出したくない目的には合いません。公式の FAQ では、OLLAMA_NO_CLOUD=1 でクラウドモデルを無効にできると説明しています(Ollama公式 FAQ)。
LM Studio・llama.cppでつなぐ手順
LM Studio(0.4.1以降)
LM Studio は 0.4.1 で Anthropic 互換の /v1/messages を追加し、Claude Code から直接使えるようになりました(LM Studio公式ブログ)。手順は次の3つです。
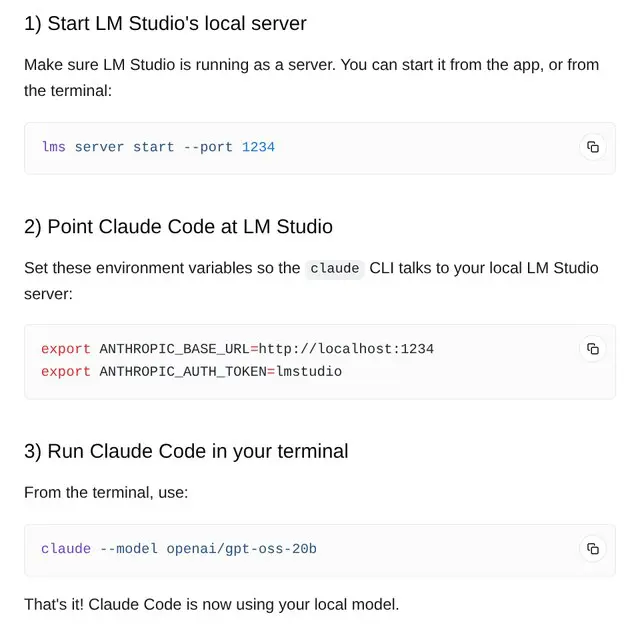
- LM Studio をサーバーとして起動します。アプリから起動するか、ターミナルで
lms server start --port 1234を実行します。 export ANTHROPIC_BASE_URL=http://localhost:1234とexport ANTHROPIC_AUTH_TOKEN=lmstudioを設定します。claude --model openai/gpt-oss-20bのように、LM Studio に読み込んだモデル名を指定して起動します。
LM Studio 公式は、Claude Code は文脈を多く使うため、コンテキストを少なくとも 25K トークンから始めて、増やすほど結果がよくなると説明しています。VS Code の拡張機能で使う場合は、設定の claudeCode.environmentVariables に同じ2つの変数を入れます。うまく動かないときは lms status でサーバーが動いているか、ポート番号(既定 1234)が合っているかを確かめます。LM Studio の設定で「Require Authentication」を有効にした場合は、x-api-key と Authorization: Bearer のどちらのヘッダーでも認証できます(LM Studio公式 Anthropic Compatibility Endpoints)。
llama.cpp(llama-server)
llama.cpp に付属の llama-server も、Anthropic 互換の POST /v1/messages を備えています。ただし公式の README は「Anthropic API の仕様と完全に互換だとは主張しないが、多くのアプリで足りる」という書き方で、ツールを使うには --jinja を付けて起動する必要があります。既定のポートは 9931 です(llama.cpp公式 server README)。
llama-server -m ./model.gguf --jinja -c 65536 --alias local-model
export ANTHROPIC_BASE_URL=http://localhost:9931
export ANTHROPIC_AUTH_TOKEN=local
claude --model local-model-c(--ctx-size)はコンテキスト長の指定で、0 にするとモデルの設定値を使います。--model には、--alias で付けた呼び名(付けない場合はモデルファイルのパス)を指定します。--api-key を付けずに起動した llama-server は認証の値を確かめませんが、Claude Code は認証の値が1つも無いとログインを求めるため、ANTHROPIC_AUTH_TOKEN に任意の文字(上の例では local)を入れておきます(Claude Code公式)。
LiteLLMゲートウェイを挟む構成――Anthropic形式の窓口がないサーバー向け
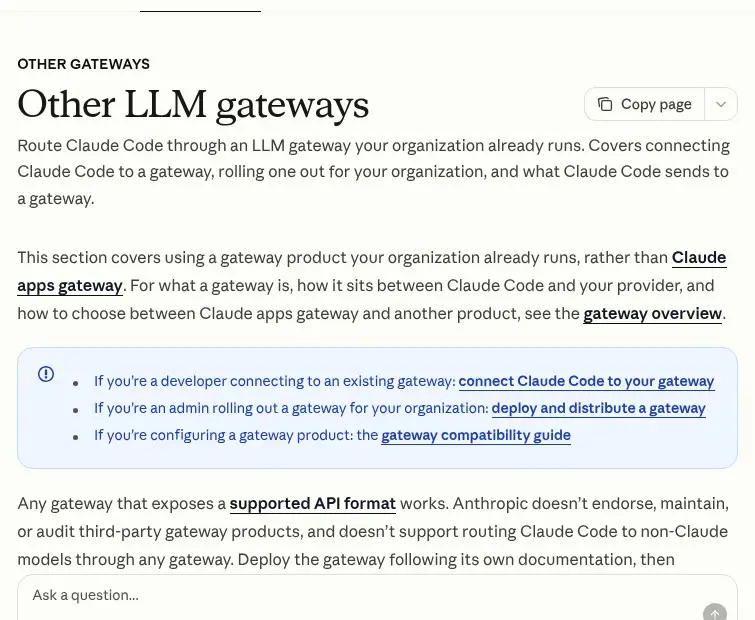
推論サーバーが OpenAI 互換の窓口しか持たない場合や、チームで使う共通の窓口を置きたい場合は、LiteLLM のようなゲートウェイを挟みます。ゲートウェイを置くと、認証情報をサーバー側に置いたまま、開発者ごとの使用量の記録・予算や回数の上限・監査ログを一か所で管理できます(Claude Code公式 Other LLM gateways)。これも Claude 以外のモデルにつなぐ限りサポート対象外の構成で、Anthropic は LiteLLM 自体の動作も保証していません。
- LiteLLM をインストールします。LiteLLM 公式の手順では
uv tool install 'litellm[proxy]'です(LiteLLM公式チュートリアル)。 config.yamlのmodel_listに、つなぎたいモデル(手元の推論サーバーのモデル)を書き、master_keyを決めます。手元のサーバーをどう書くかは LiteLLM 公式のプロバイダの説明に従ってください。litellm --config ./config.yamlで起動します。公式の例ではhttp://0.0.0.0:4000で待ち受けます。- Claude Code 側で
export ANTHROPIC_BASE_URL=http://localhost:4000とexport ANTHROPIC_AUTH_TOKEN=<master_keyの値>を設定し、config.yamlに書いたモデル名を--modelに指定して起動します。
ゲートウェイは anthropic-beta と anthropic-version のヘッダーを変えずに転送する必要があります。転送先がこれらを受け付けずに 400 エラー(Extra inputs are not permitted など)になるときは、Claude Code 側で CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS=1 を設定すると、試験中の機能のヘッダーと項目を送らなくなります(Claude Code公式 環境変数)。
このほか、claude-code-router などのコミュニティ製ツールでつなぐ例もありますが、これらは非公式で保証がなく、Claude Code の更新で予告なく動かなくなることがあります。API キーを中継する構成はセキュリティ上のリスクもあるため、本番での採用は勧めません。
推奨モデル比較と選定基準――2026年10月時点で候補になるローカルモデル
モデル選びで外せない点は3つです。①ツール(function calling)に対応していること:Claude Code はファイルの読み書きやコマンドの実行をツール呼び出しで行うため、対応していないモデルでは作業が進みません。②コンテキスト長が 64K 以上あること(Ollama公式の目安)。③商用利用できるライセンスであること。下の表は、Ollama のモデル一覧(ollama.com/library)に表示されている値を2026年10月14日に写したものです。
| モデル(Ollama のタグ) | ダウンロード容量 | 最大コンテキスト | tools | 向いている使い方・注意点 |
|---|---|---|---|---|
| qwen3.5:9b | 6.6〜7.6GB | 256K | あり | まず試す入口。Ollama公式の手動設定の例で使われるモデル |
| qwen3.5:27b | 17〜20GB | 256K | あり | 24GB 級の GPU 向け |
| qwen3.6:27b/35b | 18〜19GB/23〜24GB | 256K | あり | GMO のブログが 35B-A3B を Claude Code で検証 |
| qwen3-coder:30b | 19GB | 256K | あり | エージェントとコーディング向けと公式が説明 |
| gemma4:12b/26b/31b | 7.7〜8.0GB/16〜19GB/19〜20GB | 256K | あり | GMO のブログが 26B を検証 |
| gpt-oss:20b | 14GB | 128K | あり | LM Studio公式の例で使われるモデル |
| muse-glimmer:30b | 18GB | 128K | あり | Meta 製。Apache 2.0。ツール利用・長い作業向けと公式が説明 |
| llama3.1:8b | 4.9GB | 128K | あり | 軽い動作確認向け |
| qwen3:8b | 5.2GB | 40K | あり | 上の実画面で使用。最大 40K で 64K の目安に届かない |
| qwen2.5-coder:7b | 4.7GB | 32K | あり | 最大 32K で 64K の目安に届かない |
| deepseek-coder-v2:16b | 8.9GB | 160K | 表示なし | Ollama 上で tools の表示がなく、ファイル操作には向かない |
ダウンロード容量はモデルの重さの目安で、実際に必要なメモリはコンテキスト長を広げるほど増えます(Ollama公式)。GMO のエンジニアブログは、十分な GPU メモリのあるデスクトップ PC で Gemma 4(26B-A3B)と Qwen 3.6-35B-A3B を Claude Code から使う手順を公開しています(GMO Next Generationブログ)。量子化でモデルを小さくすれば少ないメモリでも動かせますが(Harmonic Society, 2026/03/22)、量子化を深くするほどコーディングの精度が落ちる恐れがあります。
クラウドの API で Claude Code を使う場合の費用はClaude Code API の料金、料金プランの全体像はClaude Code の料金・プランにまとめています。ローカル運用と費用を比べるときの基準になります。
Claude Code・AIエージェントの業務導入をご検討の方は、自社での開発実例を公開しているクリスタルメソッドの無料相談をご利用ください。
VRAM容量別 推奨構成の早見表
手元の GPU のメモリ(VRAM)から候補を逆引きできるように整理します。「Ollama の既定コンテキスト」は公式の値、候補はダウンロード容量からの目安です。コンテキストを 64K に広げるとその分メモリが要るため、余裕を持って選んでください。
| VRAM | Ollama の既定コンテキスト | 候補(表2より) | 備考 |
|---|---|---|---|
| 8GB 前後 | 4K | llama3.1:8b、qwen3:8b、qwen3.5:9b | 64K に広げると収まりにくい。接続の確認や軽い試用向け |
| 12〜16GB | 4K | qwen3.5:9b、gemma4:12b、gpt-oss:20b(14GB) | 64K に広げて使える組み合わせを ollama ps で確認 |
| 24GB | 32K | gemma4:26b、qwen3.5:27b、qwen3.6:27b、qwen3-coder:30b、muse-glimmer:30b | 既定は 32K なので 64K へ上げる |
| 48GB 以上・大容量メモリの Mac | 256K | qwen3.6:35b など | 既定で 256K。複数のモデルを切り替えて比べられる |
動かしたら ollama ps を実行し、PROCESSOR 列が「100% GPU」になっているかを確かめてください。一部が CPU に回っていると大きく遅くなります。公式も、モデルの最大のコンテキスト長を使い、CPU への退避を避けると性能がよいと説明しています(Ollama公式 Context length)。
セットアップでつまずきやすい点
ローカルLLMをつないだときによく起きる問題と対処をまとめます。エラーの文言と対処は、Claude Code 公式のトラブルシューティング表(Troubleshoot gateway errors)と各推論サーバーの公式ドキュメントに基づきます。
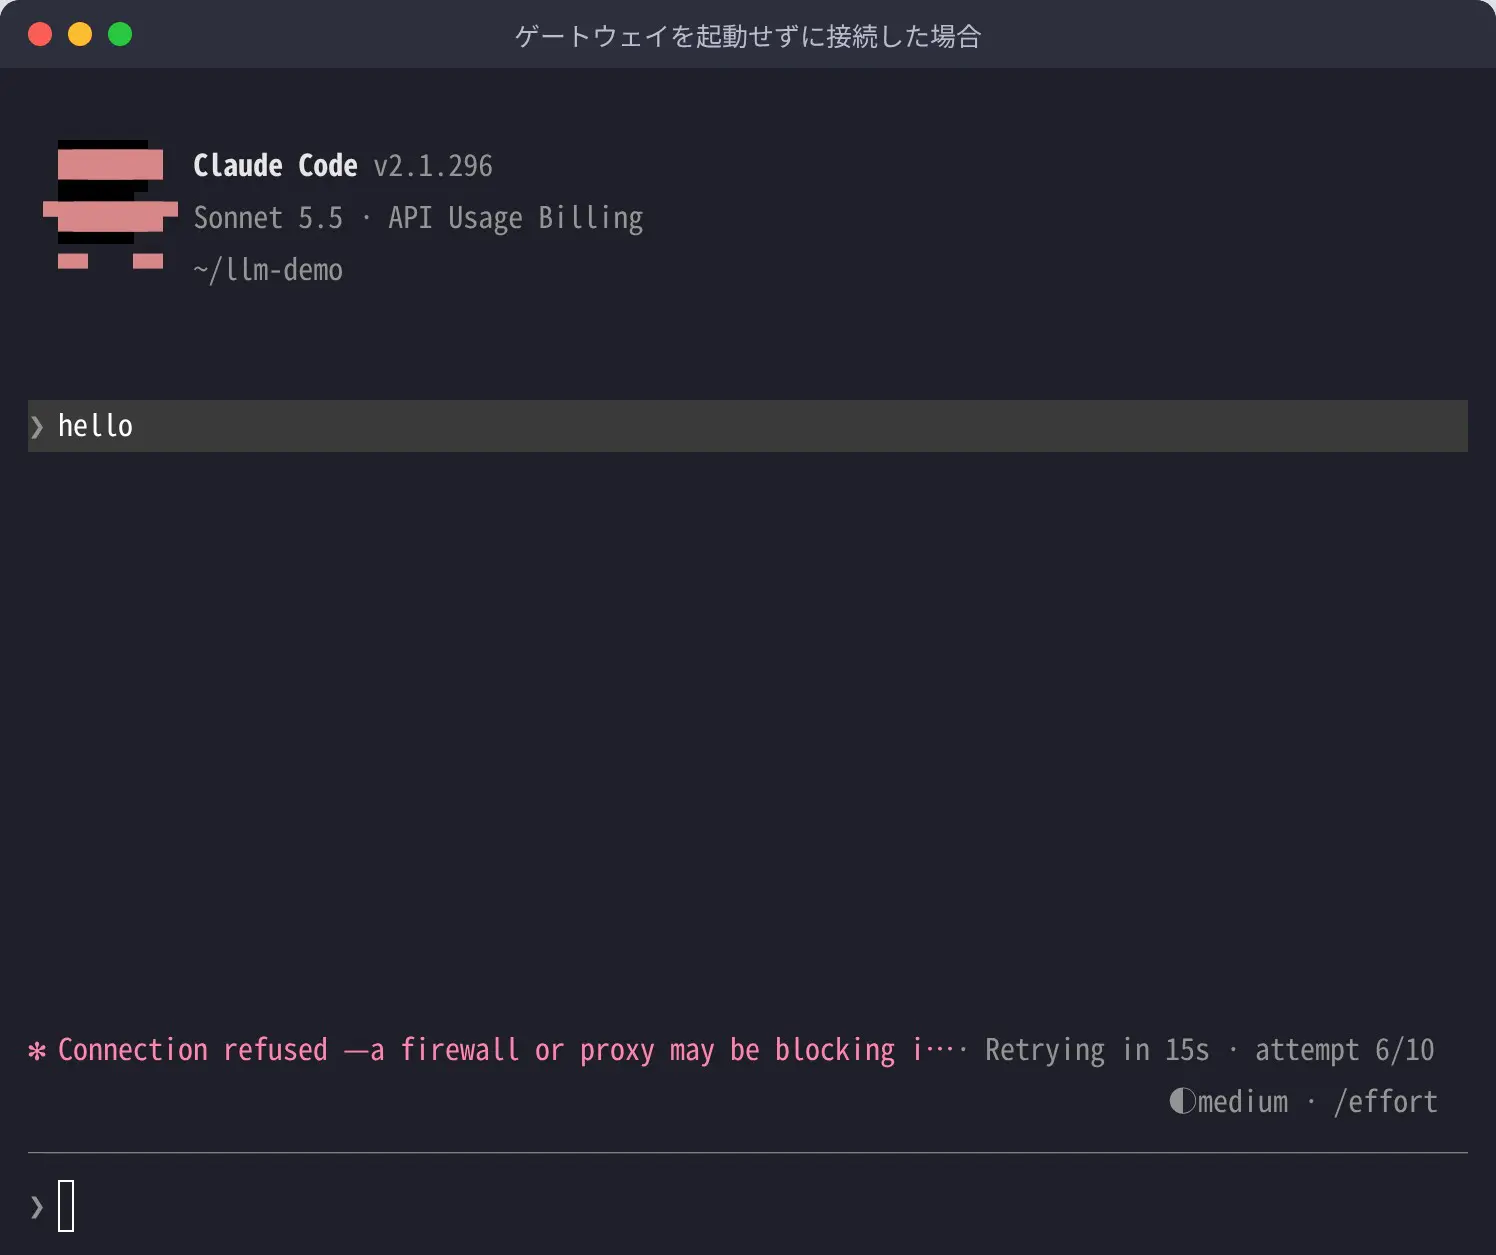
- 推論サーバーが起動していない・ポートが違う:
ANTHROPIC_BASE_URLの宛先で何も待ち受けていないと、上の画面のように「Connection refused」と表示され、再試行が続きます。Esc で止め、Ollama(11434)・LM Studio(1234)・llama-server(9931)・LiteLLM(4000)が起動しているか、ポート番号が合っているかを確かめます。 - URL の末尾に /v1 を付けた:Claude Code は設定した URL に
/v1/messagesを付けて送ります。Claude Code・Ollama・LM Studio の公式の例は、どれもhttp://localhost:11434のように末尾に/v1を付けていません。一方、LiteLLM から OpenAI 互換のサーバーへつなぐ設定では、相手の URL に/v1が要ることが多いので、ゲートウェイ側の設定と混同しないようにします。 - コンテキストが 4K のまま:Ollama は VRAM が 24GiB 未満だと既定が 4K です。長いファイルを読むと途中で文脈が切れます。
OLLAMA_CONTEXT_LENGTHで 64K 以上にし、Claude Code 側にもCLAUDE_CODE_MAX_CONTEXT_TOKENSで同じ値を伝えます。 - ツールに対応していないモデル:会話はできても、ファイルを読んだり編集したりできません。Ollama のモデル一覧で「tools」の表示があるか、配布元のモデルカードを確かめます。llama-server では
--jinjaを付け忘れるとツールが使えません。 - 400 エラー(Extra inputs are not permitted など):Claude Code が送る試験中の機能の項目を、推論サーバーやゲートウェイが受け付けていません。
CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS=1を設定します。thinkingやadaptiveを名指しする 400 エラーは、公式の表では上流(この場合は推論サーバー)を新しくするよう案内しています。 - ログインを求められる・API キーが無視される:ローカルで使うときは、Ollama・LM Studio の公式の例どおり
ANTHROPIC_AUTH_TOKENに値を入れます。ANTHROPIC_API_KEYは対話モードでは一度だけ承認が必要で、過去に断ったキーは黙って無視されます(/configの「Use custom API key」で有効にできます)。 - /model の一覧にローカルのモデルが出ない:ゲートウェイからモデル一覧を取り込む機能は、名前に「claude」か「anthropic」を含むモデルだけを残します(Claude Code公式)。ローカルのモデルは
--modelで名前を指定して起動します。 - ツール本体の版が古い:Ollama は 2026年10月14日時点で v0.40.4、LM Studio は 0.4.1 以降が必要です。
ollama -vで版を確かめ、公式のリリースノートで既知の不具合を確認してから始めると手戻りが減ります。
コスト削減・セキュリティの実態とトレードオフ――ローカル運用の限界を正確に把握する
ローカルLLMをつなぐ動機は主に2つです。API の費用をなくしたいことと、コードやデータを外に送りたくないことです。機密性の高いソースコードや個人情報を扱う案件では、外部への通信を断てる点が決め手になることがあります。
費用の面では、公式ドキュメントによると、ANTHROPIC_AUTH_TOKEN などの認証の値を設定している間、リクエストは claude.ai のログインの代わりにその値で送られ、サブスクリプションの使用量制限は適用されません(Claude Code公式 Subscriptions and gateways)。手元のサーバーに送る限り、Pro や Max の枠は消費しません。上の /status の画面も、claude.ai にログインしていない状態で起動しています。
IPA が2026年3月に公開した「AIセキュリティ短信 2026年3月号」は、LLM を使うシステムでのリスク管理と、データの送り先の管理体制に触れています。組織のセキュリティ方針としてクラウドの LLM を使うかどうかを決めるときの参考になります(IPA AIセキュリティ短信 2026年3月号)。一方で、採用前に知っておくべき制約もはっきりあります。
- 推論の品質の差:複雑なリファクタリング、大きな設計、あいまいな要件からの仕様づくりなど、難しい作業ではクラウドの最新の Claude が優位です。2026年10月時点の現行モデルは Fable 5.1・Opus 5.5・Sonnet 5.5・Haiku 5.5 の4つです(Anthropic公式 Models overview)。簡単なコード生成や補完はローカルでも足りることがあります。
- 使えない機能がある:Ollama はツールの選択の指定・遅延読み込みのツール・ホスト型の Web 検索に完全には対応していません(Ollama公式)。Claude のモデルを前提にした機能(1M トークンの文脈など)は、ローカルのモデルでは再現できません。
- 初期投資と損益分岐点:高性能な GPU や大容量メモリの Mac は数十万円規模になります。API をあまり使わないチームでは、クラウドの費用の総額が機材代を下回り、「ローカル=節約」が成り立たないことがあります。
- 運用の手間:モデルの版の管理、量子化の設定、推論サーバーやゲートウェイの安定稼働など、クラウドにはない管理の手間が増えます。複数人で共有する環境では設計が複雑になります。
- ツール呼び出しの出来の差:同じモデルでも版や量子化の形式で挙動が変わることがあります。導入時の動作確認は欠かせません。
- サポート外の構成であること:Claude Code の更新で、ローカル接続が予告なく動かなくなることがあります。公式のゲートウェイの説明も、Claude Code は版ごとに機能が増え、それを転送できない中継は対応する機能が壊れると書いています。
ローカルLLM接続を現実的にどう使うか(一次情報)
当メディアの監修者・河合継は、Claude Code を2025年2月の公開直後から1年以上、実務で使ってきました。ローカルLLMの接続は魅力的に見えますが、実際に効く場面は限られます。期待と現実の差を補足します。
- 主力の開発はクラウドのモデルに任せ、ローカルは目的を絞ります。込み入った実装や難しいデバッグでは、品質の差がそのまま手戻りになります。ローカルLLMは「外に出せないコードを扱う」「オフラインで動かしたい」といった、品質より制約が優先される場面に絞ると失望が少なくなります。
- 「費用が浮く」は運用と機材の費用まで含めて考えます。API の料金は減っても、動かすマシン・準備・保守の手間が乗ります。本当に得かは扱う量と求める品質しだいで、「ローカル=無料」では計算が合わないことが多いです。
- 機密性が目的なら、通信の経路と権限まで設計します。モデルをローカルにしても、周りの通信や権限の設計がゆるければ意味が薄れます。下の注意点のとおり、経路全体を設計して初めて効果が出ます。
実装上の注意点とセキュリティ設計――本番で使う前に確認すべき事項
ローカルLLMの接続を組織の開発環境や CI に組み込むときは、動作確認だけでは足りません。導入を決める順番は、①機密コードやオフラインの要件があるか、②GPU や大容量メモリの Mac を用意できるか、③ツール対応・コンテキスト長・ライセンスを満たすモデルがあるか、の3点です。どれかが満たせないなら、Amazon Bedrock などの公式の接続先でクラウドの Claude を使う方が現実的です。
| 確認すること | 中身 | 根拠 |
|---|---|---|
| 待ち受けの範囲 | Ollama は既定で 127.0.0.1:11434 のみ。広げるなら OLLAMA_HOST と認証付きのプロキシ |
Ollama公式 FAQ |
| 認証 | LM Studio は「Require Authentication」で x-api-key/Bearer を確認。llama-server は --api-key |
LM Studio公式・llama.cpp公式 |
| クラウドへの送信 | Ollama の :cloud モデルは手元で動かない。OLLAMA_NO_CLOUD=1 で無効化 |
Ollama公式 FAQ |
| 送り先の確認 | /status の Anthropic base URL が手元のサーバーか |
Claude Code公式 |
| ライセンス | 商用利用・再配布の条件をモデルごとに法務で確認 | 各モデルの配布元 |
| ログ | プロンプトに混ざる認証情報・個人情報の保存先と期間を決める | 社内の規程 |
エンドポイント認証とネットワーク分離
Ollama は既定で 127.0.0.1 のポート 11434 だけで待ち受け、外のマシンからは届きません。社内の別のマシンから使うために OLLAMA_HOST で公開範囲を広げるときは、認証付きのリバースプロキシや VPN を前に置きます(Ollama公式 FAQ)。LM Studio は「Require Authentication」を有効にすると、トークンのないリクエストを受け付けなくなります。IPA の AIセキュリティ短信が示すリスク管理の考え方は、ローカルの運用にも同じように当てはまります(IPA AIセキュリティ短信 2026年3月号)。
モデルライセンスの事前確認
商用利用の可否や再配布の条件はモデルごとに違います。Gemma・Qwen・Llama・gpt-oss・Muse Glimmer など、それぞれのライセンスを法務で確認してから採用します。量子化版や GGUF 変換版は元のモデルのライセンスを引き継ぐことが多いものの、条件が変わる場合もあるため個別に確かめてください。
プロンプト・ログの管理
ローカルで動かしても、プロンプトのログは残ります。コードに含まれる認証情報・API キー・個人情報がログに混ざる危険を考え、保存先・保存期間・閲覧できる人を決めておきます。CI で Claude Code を自動実行する場合は、ログの伏せ字処理を組み込むことを勧めます。
量子化精度と実用性のバランス
VRAM が足りないからと Q3_K_S のような深い量子化を選ぶと、コーディングの精度がはっきり落ちることがあります。自社のコードへの機能追加やバグ修正など実際の作業で試し、許せる精度を確かめてから量子化の形式を決めてください。
ほかのツールとの比較はClaude Code と Cursor の比較、Claude Code と Codex の比較を参照してください。初めて Claude Code に触れる方はClaude Code の始め方から読むのがおすすめです。
この記事の検証スタンスについて
この記事は、「公式にサポートされる範囲」と「サポート外だが技術的にはつながる範囲」を分けて書いています。手順・環境変数・エラーの文言は、2026年10月14日に Claude Code・Ollama・LM Studio・llama.cpp・LiteLLM の公式ドキュメントで確認しました。画面は、/status・モデル名の警告・コンテキスト長の指定(10月14日)と、接続先が起動していないときの画面(10月12日)をこの端末の Claude Code で撮りました。この端末には GPU と Ollama が無いため、ローカルモデルが実際に答える画面(10月5日)は別の端末で撮ったものです。モデルの速さや品質の数値は、環境で大きく変わるため載せていません。
よくある質問
Q. Claude CodeでOllamaやLM Studioなどのローカルモデルを使うのは公式にサポートされていますか?
A. いいえ。公式にサポートされているのは、Claude モデルを Amazon Bedrock・Google Cloud’s Agent Platform(旧 Vertex AI)・Microsoft Foundry・Claude Platform on AWS で動かす接続です。Ollama や LM Studio などで Claude 以外のモデルにつなぐ構成は、Anthropic がサポートしないと明記しています。動くかどうかはモデルや版によるため、本番の前に十分に試してください。
Q. LiteLLMなどのゲートウェイは必要ですか?
A. Ollama・LM Studio(0.4.1以降)・llama.cpp の llama-server なら不要です。どれも Claude Code が使う Anthropic Messages 形式の窓口(/v1/messages)を持っているため、ANTHROPIC_BASE_URL を向けるだけでつながります。OpenAI 互換の窓口しか持たない推論サーバーを使う場合や、チームの共通の窓口を置きたい場合に LiteLLM などを挟みます。
Q. ローカルLLMを動かすために最低限必要なVRAMはどれくらいですか?
A. Ollama のダウンロード容量で見ると、llama3.1:8b(4.9GB)や qwen3.5:9b(6.6〜7.6GB)なら 8GB 前後の GPU から試せます。ただし Claude Code ではコンテキストを 64K 以上にするのが目安で、その分メモリが要るため、実用には gemma4:26b や qwen3-coder:30b などが載る 24GB 級が現実的です。
Q. ローカルLLMで使うときもClaudeのPro・Maxの契約やログインは必要ですか?
A. 手元の推論サーバーに送る限り不要です。ANTHROPIC_AUTH_TOKEN などの認証の値を設定している間、リクエストは claude.ai のログインの代わりにその値で送られ、サブスクリプションの使用量制限も適用されません。Ollama の公式の例も、ANTHROPIC_AUTH_TOKEN=ollama を設定するだけです。
Q. 接続はできるのにエラーになる場合、何を確認すればよいですか?
A. まずモデルがツール(function calling)に対応しているか、コンテキスト長が 64K 以上あるかを確かめます。次に ANTHROPIC_BASE_URL の末尾に /v1 を付けていないかを見ます。Extra inputs are not permitted などの 400 エラーなら、CLAUDE_CODE_DISABLE_EXPERIMENTAL_BETAS=1 を設定します。llama-server の場合は –jinja を付けて起動しているかも確認してください。
まとめ
Claude Code は、ANTHROPIC_BASE_URL で送り先を差し替えることでローカルLLMでも動きます。Ollama なら ollama launch claude、LM Studio なら2つの環境変数、llama.cpp なら --jinja 付きの llama-server で、ゲートウェイを挟まずにつながります。OpenAI 互換の窓口しかないサーバーは LiteLLM などで変換します。
どの方法でも、Claude 以外のモデルにつなぐ構成は Anthropic のサポート対象外です(Claude Code公式)。ツール対応・64K 以上のコンテキスト・ライセンスの3点でモデルを選び、Claude Code 側にも CLAUDE_CODE_MAX_CONTEXT_TOKENS で実際のコンテキスト長を伝えてください。品質や安定性が大事な作業は、Amazon Bedrock などの公式の接続先でクラウドの Claude を使い、ローカルは機密やオフラインといった制約のある場面に絞るのが現実的です。
参考文献
- Claude Code公式「Other LLM gateways」 https://code.claude.com/docs/en/llm-gateway
- Claude Code公式「Connect Claude Code to an LLM gateway」 https://code.claude.com/docs/en/llm-gateway-connect
- Claude Code公式「Claude Code gateway compatibility guide」 https://code.claude.com/docs/en/llm-gateway-protocol
- Claude Code公式「Model configuration」 https://code.claude.com/docs/en/model-config
- Claude Code公式「Environment variables」 https://code.claude.com/docs/en/env-vars
- Claude Code公式「Third-party integrations」 https://code.claude.com/docs/en/third-party-integrations
- Anthropic公式「Models overview」 https://platform.claude.com/docs/en/about-claude/models/overview
- Ollama公式「Claude Code」 https://docs.ollama.com/integrations/claude-code
- Ollama公式「Anthropic compatibility」 https://docs.ollama.com/api/anthropic-compatibility
- Ollama公式「Context length」 https://docs.ollama.com/context-length
- Ollama公式「FAQ」 https://docs.ollama.com/faq
- Ollama 公式GitHub「Releases」 https://github.com/ollama/ollama/releases
- Ollama「Library」 https://ollama.com/library
- LM Studio公式ブログ「Use Claude Code with LM Studio」 https://lmstudio.ai/blog/claudecode
- LM Studio公式「Anthropic Compatibility Endpoints」 https://lmstudio.ai/docs/developer/anthropic-compat
- llama.cpp公式「server README」 https://github.com/ggml-org/llama.cpp/blob/master/tools/server/README.md
- LiteLLM公式「Claude Code チュートリアル」 https://docs.litellm.ai/docs/tutorials/claude_responses_api
- IPA「AIセキュリティ短信 2026年3月号」 https://www.ipa.go.jp/digital/ai/security/rcu1hd0000007gji-att/2-1_202603.pdf
- 日経XTECH「ローカルLLMでAIエージェントを試す、『Claude Code』を動かし…」(2026/05/28) https://xtech.nikkei.com/atcl/nxt/column/18/03600/042100004/
- GMO Next Generationブログ(Claude Code をローカルLLMの Gemma 4・Qwen 3.6 で動かす記事) https://recruit.group.gmo/engineer/jisedai/blog/claude-code-local-llm/
- Harmonic Society「【2026年版】ローカルLLMおすすめモデル10選|用途別に徹底比較」(2026/03/22) https://harmonic-society.co.jp/local-llm-recommended-models-comparison/
関連記事
- Claude Codeとは
- Claude Codeの代替・類似ツール比較
- Claude Codeの使用量・制限を確認する方法
- Claude Codeが動かない・起動しない時の対処法
- Claude Codeのベストプラクティス
Claude Code・AIエージェントの業務活用をご検討の方へ
クリスタルメソッドは、Claude Codeを日々の業務で使いながら、AIエージェント・社員AIの導入と開発効率化を支援しています。自社サイトの表示速度をAI社員(Claude Code)で12.89秒→2.03秒に短縮した実例も事例記事として公開しています。「自社の開発・業務にAIをどう組み込むか」といったご相談を承っています。
- 無料相談・お問い合わせ:ご相談はこちら
Read next
あわせて読みたい
-
claude 学習させない 設定|プラン別の正しい設定と見落としポイント
claude 学習させない 設定:プラン別の前提がまず逆になる 「ClaudeにコードやプロンプトをAI学習させない設定はどこにあるか」という問いに対する正確な...
-
Claude Code API料金の全体像|課金体系とコスト試算【2026】
Claude Code API料金の要点(2026年10月時点) この記事は、Claude CodeをAPI従量課金(Claude Consoleのアカウント、...
-
Claude CodeをAmazon Bedrockで使う方法|設定手順・必要な権限・モデル固定・注意点【2026年版】
Claude CodeをAmazon Bedrockで使うには(結論と手順の全体像) Claude Codeは、Anthropicと直接契約しなくても、AWSの...