
blog
AIブログ
動画生成AIとは?仕組み・できること・活用シーンを基礎から解説
文:クリスタルメソッド編集部 監修:河合 継(代表取締役)
動画生成AIとは、文章(プロンプト)や画像などの指示をもとに、AIが映像を自動で生成・変換する技術の総称です。
この記事では、動画生成AIでできることと活用シーン、無料で試せるツール、主要ツールの比較、使い方とプロンプトの型、向く制作・向かない制作の見極め、仕組み、限界と注意点を順に解説します。
動画生成AIとは:画像生成AIとの違い
動画生成AIとは、深層学習モデルが人間の指示(プロンプト)や入力素材をもとに映像を自律的に生成・変換する技術の総称である。静止画生成AIが2次元の画素配列を出力するのに対し、動画生成AIは時間軸を加えた3次元のテンソル(高さ×幅×フレーム数)を出力しなければならない。この時間的一貫性の担保こそが、静止画生成との決定的な技術的差異であり、開発難易度を大きく引き上げている根本的要因である。
入力形式は大きく三類型に整理できる。Text-to-Videoはテキストプロンプトのみから映像を生成する形式であり、最も普及している。Image-to-Videoは静止画に動きを付与して動画化する形式で、既存の写真素材を活かしやすい。Video-to-Videoは既存映像のスタイル変換・延長・補間を行う形式で、編集ワークフローへの組み込みに適している。商用ツールの多くはこれらを組み合わせて提供している。
技術的な系譜をたどると、2020年前後はGAN(敵対的生成ネットワーク)が動画生成研究の主軸を担っていた。しかし2022年以降、拡散モデルの台頭とともに生成品質が飛躍的に向上し、2024年のOpenAI Soraの発表を境に業界は「実用期」へと移行した。2026年現在、商用利用できるツールが各社から多数提供され、企業の広告制作から個人クリエイターの表現活動まで広く普及している。
関連記事動画生成AIツールはどう比較して選ぶ? / 動画生成AIの料金はいくらかかる? / 動画生成AIは業界別にどう活用されている?
動画生成AIでできること・活用シーン
動画生成AIでできることは、大きく3つに分けられます。
| できること | 内容 | 向いている使い方 |
|---|---|---|
| 文章から動画を作る(Text-to-Video) | 「夕暮れの海辺を歩く犬」のような文章から、数秒〜十数秒の映像を作る | イメージ映像、企画のたたき台、撮影が難しい場面 |
| 画像を動かす(Image-to-Video) | 1枚の写真やイラストに、動きやカメラワークを付ける | 商品写真やキャラクターなど、見た目を保ったまま動かしたいとき |
| 動画を変換・編集する(Video-to-Video) | 撮った映像の画風を変える、一部を差し替える、長さを伸ばす | 既存の映像素材の作り直し、雰囲気の統一 |
このほか、原稿を読み上げる人物(アバター)の動画を作るタイプもあります。アバター動画・吹き替え・自動編集まで含めた「AIで作る動画」全体の入口はAI動画とはにまとめているので、この記事では文章や画像から映像を作る「生成モデル」に絞って説明します。場面ごとの使われ方は次のとおりです。
| 活用シーン | 使い方の例 |
|---|---|
| SNS・広告 | 短い縦型動画やバナー用の動く素材を、パターンを変えて複数作る |
| 企画・提案 | 撮影や制作の前に、完成イメージを映像で共有する(絵コンテの代わり) |
| 商品・サービス紹介 | 商品写真を起点に、使用シーンのイメージ映像を付ける |
| 研修・マニュアル・説明動画 | アバターに原稿を読ませ、内容の更新があれば原稿だけ直して作り直す |
| 教育・解説コンテンツ | 文章だけでは伝わりにくい動きや仕組みを、短い映像で補う |
| 映像制作の素材づくり | 背景や挿入カットなど、撮影しにくい素材を補う |
どの場面でも、生成した映像をそのまま完成品にするより、「素材」として作って編集で仕上げる使い方が安定します。向く制作・向かない制作の見極めは、後半の節で整理します。
無料で試せる主な動画生成AI(2026年10月7日 公式確認)
「とにかく無料で動画を作ってみたい」場合に、公式サイトで無料の範囲を確認できた主なツールです。無料枠は変更されることが多いため、使う前に各公式ページも確認してください。
| ツール | 無料で使える範囲(公式記載) | 商用利用 |
|---|---|---|
| Adobe Firefly | プラン契約なしで、画像・動画・音声を毎日無料で生成できる(回数は毎日リセット)(公式) | Fireflyのモデルによる生成物は商用利用に安全と公式が明記 |
| Runway | Freeプラン($0)で125クレジット。毎月の付与ではなく初回のみの使い切り(公式料金) | 公式料金ページに無料プランでの記載なし |
| Pika | Freeプラン($0)はあるが毎月のクレジットは0。生成にはクレジットの購入が必要(公式料金) | 無料プランには商用ライセンスが含まれない |
最初の1本を無料で試すなら、毎日の無料生成があるAdobe Fireflyか、初回クレジットのあるRunwayから始めるのが手軽です。商用で使う場合は、無料プランで商用利用ができるかを必ず確認してください。
上の3件は2026年10月13日にも各公式ページを読み直し、記載に変更がないことを確認しています。なお、GoogleのGeminiアプリの動画生成(Gemini Omni)は、個人アカウントでは有料のGoogle AIプランの定期購入が必要と公式に記載されているため、無料枠の表には載せていません。Canva・Google Vids・Kling・Viduなど、より多くのツールの無料の範囲・透かし・商用利用の条件はAI動画とはと動画生成AIを無料で使う方法で一覧にしています。
主要な動画生成AIツールの比較(2026年10月時点)
2026年現在、商用利用できる主要ツールは品質・機能・価格帯のいずれも急速に多様化しています。以下の比較表は、各社の公式サイトの記載をもとに整理したものです(2026年10月13日確認)。料金・仕様は各サービスの改定により変わることがあるため、最新の情報は必ず各公式サイトで確認してください。
| ツール名 | 提供元 | 主な入力形式 | 料金目安 | 技術的特長・得意領域 |
|---|---|---|---|---|
| Sora | OpenAI(米) | テキスト・画像 | 提供終了(ウェブ版・アプリ版は2026年4月26日、APIは2026年9月24日に終了) | 提供当時は、文章や画像から音声つきの動画を生成できた(現在は利用できない)。終了の経緯と代わりのツールはSora(OpenAI)とはを参照 |
| Runway(Gen-4.5) | Runway(米) | テキスト・画像・動画 | 無料プランあり(初回のみ125クレジット)/有料プランは公式の料金ページを参照 | 自社モデルGen-4.5に加え、他社の画像・動画・音声モデルも同じ画面で使える。文章から動画・画像から動画に対応 |
| Kling AI(Kling 4.0) | 快手(中) | テキスト・画像 | 公式の料金ページを参照 | 文章・画像・参照素材から生成。Kling 4.0は音声つきの映像生成と安定した動きを特長としている |
| Veo 3.1/Gemini Omni(Google) | Google DeepMind・Google(米) | テキスト・画像(Gemini Omniは動画からの編集にも対応) | Geminiアプリの動画生成は、個人アカウントでは有料のGoogle AIプランの定期購入が必要(公式記載)。Veo 3.1は開発者向けのGemini APIなどから利用(詳細は公式参照) | Veo 3.1はGoogle DeepMindの音声つき動画生成モデル。Geminiアプリでは2026年10月13日時点で、Veoに代わり「Gemini Omni 1.1 Flash」が動画の生成・編集を担い、10秒の動画・音声の同時生成・写真(最大5枚)からの生成に対応(公式記載) |
| Hailuo AI(MiniMax H3) | MiniMax(中) | テキスト・画像 | 公式の料金ページを参照 | 文章や写真から動画・画像を生成。現行モデルはMiniMax H3 |
| Pika(Pika 2.5) | Pika(米) | テキスト・画像・動画 | 無料プランあり(毎月のクレジット付与なし)/有料プランは公式の料金ページを参照 | 動画の作成・延長、被写体の差し替え、動きの転写などの機能がある。自社モデルPika 2.5のほか他社モデルも選べる |
| Synthesia | Synthesia(英) | テキスト(スクリプト) | 公式の料金ページを参照 | 企業向けのAI動画プラットフォーム。原稿からアバター動画を作り、吹き替え・翻訳にも対応 |
モデル名と特長は各社の公式サイトの記載による(2026年10月13日確認)。料金は各社の公式ページで確認できた範囲だけを記載し、未確認の金額は載せていません。Soraの終了日はOpenAIの公式情報によります。料金・仕様は随時改定されます。
ツール選びで重要なのは、用途・日本語プロンプトへの対応・商用利用の条件・既存の制作の流れとの相性の4点です。汎用的な映像生成ではGoogle(Gemini Omni/Veo)など、映像編集との統合を重視するならRunway、音声つきの映像ならKling AIやGoogle、アバター動画ならSynthesiaやHeyGenといった使い分けが、2026年時点での実務的な出発点になります。
動画・画像生成AIの業務活用をご検討の方は、AI開発会社クリスタルメソッドの無料相談をご利用ください。
使い方:テキストから動画を作る手順と、プロンプトの型
ツールごとに画面は違いますが、動画生成AIの使い方は共通の流れに整理できます。
- 目的と尺を決める:SNS用の数秒のループか、説明動画の一場面かで、必要な長さと画面比率(縦・横)が変わります。
- 素材を用意する:文章だけ(テキストから動画)か、1枚の画像を動かす(画像から動画)かを選びます。商品や人物を正確に出したい場合は、画像を起点にする方が狙い通りになります。
- プロンプトを書く:下の型に沿って、被写体・動き・カメラ・雰囲気・時間を書きます。
- 複数生成して選ぶ:同じプロンプトでも結果は毎回変わるため、3〜4本生成して良いものを選びます。
- 編集で仕上げる:複数のクリップをつなぎ、字幕・ナレーション・BGMを編集ソフトで載せます。生成AIは「素材づくり」、仕上げは編集、と役割を分けると品質が安定します。
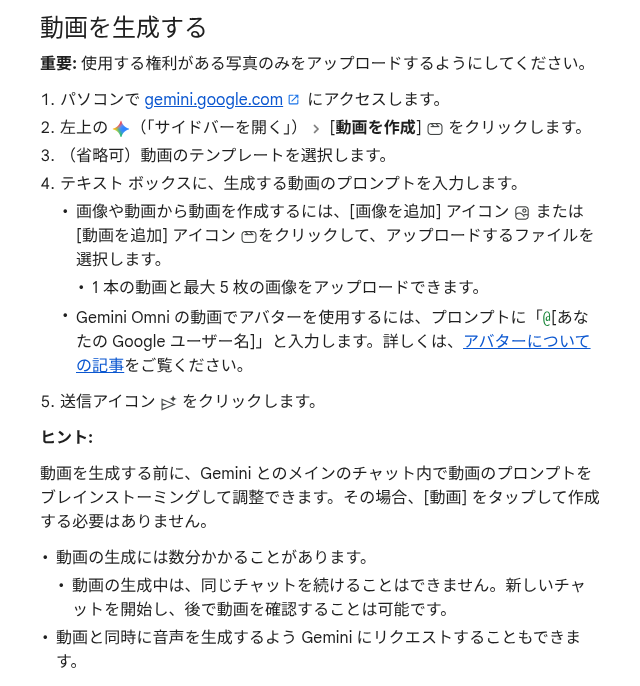
実際の画面の例として、Google公式ヘルプに載っているGeminiアプリの操作手順を示します(2026年10月13日撮影)。ボタンの名前はツールごとに違いますが、「プロンプトを入力する → 必要なら画像や動画を追加する → 送信して数分待つ」という流れはどのツールでもほぼ同じです。
プロンプトの型(5要素)
【被写体】白いシャツを着た20代の女性が
【動き】カフェの窓際でノートPCを開き、ゆっくり顔を上げて微笑む
【カメラ】正面やや斜めから、ゆっくりズームイン
【雰囲気・画風】午後の自然光、実写風、落ち着いた色調
【時間・形式】5秒、16:9
うまくいかないときは、「動き」を1つに絞る、カメラの動きを減らす、画風を具体的な言葉(実写風・アニメ風・水彩風)で指定する、の順に直すと改善しやすくなります。文字(看板・字幕)や細かい手の動きは苦手なので、編集で後から載せる前提にしてください。
動画生成AIが「向く制作」と「向かない制作」の見極め方
どのツールを選ぶかの前に、そもそも動画生成AIという手段が自分の制作に合うかを判断すると、遠回りを避けられます。現状の技術特性(生成のたびに絵が変わりうる、長尺での時間的一貫性が崩れやすい、実在物の厳密な再現が不得手)を踏まえると、向き・不向きは次のように整理できます。
向く場面(AIの強みが活きる)
- 短尺のイメージ映像・案出し:数秒〜十数秒のコンセプト映像や、企画段階のたたき台を大量に試したいとき。撮影を組む前の発想の可視化に強い。
- 実写では撮りにくい絵:宇宙・空想的な世界観・非現実的なカメラワークなど、ロケや大がかりなセットが要る表現をテキスト起点で得たいとき。
- 台本ベースの説明・研修動画:アバター(バーチャルヒューマン)に原稿を読ませる形式など、映像そのものより「情報を届ける」ことが目的の動画。
向かない場面(別手段が無難)
- 実在の人物・商品を正確に映す:自社製品の外観やパッケージ、実在するタレントの顔を寸分違わず再現したい用途。細部の忠実さは実写撮影に分があります。
- 1カットを長く一貫させる長尺:数分続くワンシーンで人物・背景の整合を保ち続ける制作。フレームが進むほど破綻が出やすい。
- 厳密な指示どおりの再現性が要る:確定した絵コンテを一字一句そのまま、修正のたびに同じ結果へ収束させたい制作。生成結果のばらつきが管理コストになりやすい。
迷ったときの一言判断:「絵の正確さ・長さ・再現性」を最優先するなら実写や従来のCG制作を軸に、「速さ・発想の量・撮れない絵」を優先するなら動画生成AIを軸に検討すると、手戻りが減ります。まず短い尺で試作し、想定した品質に届くかを確かめてから本番規模へ広げる進め方が現実的です。
次に読む:動画生成AIツールはどう比較して選ぶ?
動画生成AIの仕組み:拡散モデル・Transformer・GAN・マルチモーダル
動画生成AIの品質と性能は、その基盤となるアーキテクチャ(モデルの構造)で決まります。現在の主要モデルが採用する技術を、原理のレベルから整理します。
拡散モデル(Diffusion Model)
現在の動画生成AIの中核をなす技術です。学習の段階では映像データに段階的にガウスノイズを加えていき(前向き過程)、生成の段階ではランダムなノイズから目的の映像を少しずつ復元します(逆向き過程)。このノイズ除去の過程をニューラルネットワークが担うことで、条件(プロンプト)に沿った映像生成が可能になります。静止画生成でStable DiffusionやMidjourneyが実証した品質を、時間軸の方向に拡張したものが動画生成の拡散モデルの基本構造です。学習原理の詳細はディープラーニングの仕組みも参照してください。
Transformerアーキテクチャとの統合
自然言語処理で広く使われるTransformerのSelf-Attention機構は、動画生成でも2つの役割を果たします。1つはテキストプロンプトの意味の理解、もう1つはフレーム間の時間的な整合性の保持です。OpenAIのSora(提供は2026年に終了)はTransformerと拡散モデルを組み合わせた「Diffusion Transformer(DiT)」型の構造を採用し、物理的に整合性のある映像を生成できることを示した点で、業界に大きな影響を与えました。TransformerとBERTの言語理解の仕組みはBERT・NLPガイドで詳しく説明しています。
GAN(敵対的生成ネットワーク)の現在的役割
生成器と識別器が競い合いながら学習するGANは、拡散モデルが台頭する前の動画生成研究を牽引した技術です。現在でも生成した映像の超解像(アップスケーリング)、フレーム補間、動画の後処理で使われており、拡散モデルと組み合わせたハイブリッド構成も研究されています。
マルチモーダル学習
テキスト・画像・音声・動画を横断して統合的に学習するマルチモーダルAIの技術が、動画生成AIの表現力を支えています。プロンプトで指定した色彩・照明・カメラワーク・雰囲気が映像に反映されるのは、テキストと映像の潜在空間を共同で対応づけるマルチモーダル学習の恩恵です。
なお、JST(科学技術振興機構)のプレプリントサーバーjxivに収録された研究「動画生成AIのテキストプロンプトへの忠実性の調査」(jxiv.jst.go.jp)では、各モデルがプロンプトの意図をどの程度正確に映像化できるかを定量的に検証しており、テキストへの忠実性がモデル間で有意に異なると報告されています。ツールを選ぶ際には、こうした学術的な検証の知見も参考になります。
動画生成AIの技術的限界と倫理的論点
動画生成AIへの期待が高まる一方で、技術的な制約と社会的な課題についても正確に把握しておく必要があります。
現時点での主な技術的限界
第一に、テキストプロンプトへの忠実性のばらつきがあります。JSTのjxivに収録された研究「動画生成AIのテキストプロンプトへの忠実性の調査」(jxiv.jst.go.jp)は、モデルによってプロンプトの意図を映像化する精度に有意差があることを示しています。特に複数の属性や位置関係を指定した複雑なプロンプトでは、意図と異なる映像が生成されやすい点に注意が必要です。
第二に、細部の物理整合性の問題があります。液体の動き、布のなびき方、人物の手指の描写など、細かい物理現象の再現は多くのモデルで今も課題として残っています。第三に、テキスト・数字の正確な描写が苦手で、映像内に文字を配置する用途では後処理が必要になることが多いです。第四に、長い動画で一貫した物語を保つことは、現状の多くのモデルで実用上の限界があります。プロの仕上がりには、プロンプト設計・後処理・人による確認が引き続き欠かせません。
ディープフェイクと法規制の現状
実在の人物の映像を無断で学習・生成することは、肖像権の侵害や名誉毀損のリスクをはらみます。2026年2月、中国IT大手バイトダンスが実在人物の顔を使ったAI動画生成を停止したことが、科学技術振興機構(JST)のSciencePortal Chinaで報告されています(https://spap.jst.go.jp/china/news/kyodo/260203/ktopic_4_02.html)。実在の人物を用いた生成物への規制強化は各国で加速しており、日本でも政治的なディープフェイクへの対応が立法の論点になっています。見分け方と悪用の手口はディープフェイクとはで解説しています。
EU AI法(2024年施行・段階的に適用)はAIが生成したコンテンツへのウォーターマーク付与・開示義務を定めており、ニュース・広告・選挙関連のコンテンツではAI生成物であることの明示が求められる場面が増えています。動画生成AIを業務に組み込む際は、生成物の利用目的・公開範囲・表示義務について、法務部門と連携した運用設計が欠かせません。
著作権と生成物の権利帰属
学習データに含まれるコンテンツの著作権問題は、2026年現在も世界的に未解決の論点で、各国の司法・立法が対応を模索している段階です。生成した映像が既存の著作物に似ている場合の侵害リスクと、生成物そのものの著作権の帰属については、現時点で確定した解釈を示すことができません。利用規約の商用利用の条件・禁止コンテンツの条項は、その都度確認することが求められます。
国内での普及と支援環境
国内でも動画生成AIの実務活用は広がっており、福岡県よろず支援拠点が「動画生成AIで集客丸わかり!セミナー」(https://yorozu-fukuoka.go.jp/douga-ai/)を開くなど、中小企業向けの活用支援も始まっています。技術の理解と、倫理・法的なリテラシーの両輪での習熟が実務者には求められます。
動画生成AIの技術進化の軌跡と今後の方向性
技術の現在地を正確に把握するには、その進化の道筋を理解することが役に立ちます。
| 時期 | 技術・出来事 | 意義 |
|---|---|---|
| 〜2022年 | GAN系モデルが主流。低解像度・短尺が中心 | 研究段階。商用利用はほぼ不可 |
| 2023年 | Runway Gen-2・Pika Labsが商用提供開始。拡散モデルが主流へ | 実用期の幕開け。クリエイター層への普及 |
| 2024年前半 | OpenAI Sora発表。DiT系アーキテクチャが注目 | 物理整合性・長尺生成の可能性を業界に示す |
| 2024年後半〜2025年 | Kling・Hailuo・Luma・Veoなど多数が台頭。無料ツール充実 | 市場競争が激化。長尺・高解像度化が加速 |
| 2026年現在 | マルチモーダル統合・音声連動・API業務自動化が普及期へ。OpenAIのSoraは提供終了(4月・9月)。GoogleはGeminiアプリの動画生成をVeoからGemini Omniへ切り替え | ワークフロー組み込みが本格化 |
今後の技術的な方向性として、研究コミュニティと商用開発の双方で注目されているのは、次の3点です。
第一に、世界モデル(World Model)への発展です。単に映像を生成するだけでなく、物理世界のルールをモデルの内部に保持し、任意の介入に対して整合性のある映像を生成できる「シミュレーターとしてのAI」への進化が議論されています。第二に、パーソナライズ動画の大量自動生成です。ユーザーデータとAPIを組み合わせ、個人ごとに最適化した映像コンテンツを大量に生成するシステムの実用化が進みつつあります。機械学習や強化学習との統合により、生成映像の品質を自動的に最適化するループも研究されています。第三に、リアルタイム動画生成です。ゲームエンジンやライブ配信プラットフォームとの統合により、対話的に映像を生成・更新する技術が実装の段階に入りつつあります。
バーチャルヒューマン領域における動画生成AIの特化的展開
動画生成AIの応用領域として近年注目を集めているのが、リアルな外見を持つデジタルの人物が映像の中で自然に発話・行動するバーチャルヒューマン・AIアバターの生成です。これはText-to-Videoの汎用的な生成とは技術的に異なり、特定の人物の顔・声・表情・動作のパターンをデジタルに再現し、台本に沿って動画化する特化型のアプローチです。リップシンク・表情生成・音声合成・対話AIを統合して初めて実現できる領域です。
クリスタルメソッドが開発する「DeepAI」は、実在の人物の容姿・表情・声・振る舞いをデジタル空間で再現するバーチャルヒューマン/AIアバターのソリューションです。リップシンク・表情生成・音声合成・対話AIを組み合わせ、接客・研修・面接練習・広報など企業のさまざまな用途に対応しています。このような特化型のソリューションは、Synthesia・HeyGen・D-IDなどの海外ツールと並ぶ用途領域に位置しますが、日本語・日本人の表情・文化的な文脈への適応という観点では、国内での開発・カスタマイズに固有の強みが生まれやすい領域です。
バーチャルヒューマン技術では、実在の人物の映像を無断で使うことへの法的・倫理的な制約がとりわけ厳しく、前述のバイトダンスの事例(JST SciencePortal China, 2026年2月)に見られるように、国際的に規制が強化される方向にあります。利用目的・権利処理・表示義務の設計は、技術の実装と同じ優先度で検討すべき事項です。
テキストマイニングや自然言語処理と連携した動画コンテンツの分析・最適化についてはテキストマイニング解説も参考になります。また、動画生成AIと関連の深いスパースモデリングによる効率的な学習手法はスパースモデリング解説を参照してください。
よくある質問
Q. 動画生成AIと画像生成AIは何が違いますか?
A. 画像生成AIは1枚の絵を作りますが、動画生成AIは連続した多数のコマを作り、コマとコマの間で人物や背景が食い違わないようにする必要があります。この「時間の流れの中での一貫性」を保つ点が、いちばん大きな違いです。
Q. どんな技術で動画が作られていますか?
A. 現在の主流は、ノイズから少しずつ映像を復元していく「拡散モデル」と、文章の意味やコマ同士の関係をとらえる「Transformer」を組み合わせた方式です。以前主流だったGANは、解像度を上げる処理やコマの補間などで使われています。
Q. 代表的なツールにはどんなものがありますか?
A. 汎用的な映像生成ではRunway・Kling AI・Google(Veo/Geminiアプリの動画生成モデルGemini Omni)・Hailuo AI・Pika・Adobe Firefly、原稿を読み上げるアバター動画ではSynthesiaなどがあります。OpenAIのSoraは、2026年にウェブ版・アプリ版・APIの提供を終了しています。
Q. 利用にあたって注意すべき点は?
A. 指示どおりにならないことがある、手や文字など細部が崩れやすい、長い動画では人物や背景が途中で変わりやすい、といった技術的な限界があります。あわせて、実在の人物の映像を無断で作らない、生成物の商用利用の条件を規約で確認する、AIで作ったことの表示が求められる場面がある、という点に注意が必要です。
Q. 動画生成AIは無料で使えますか?
A. 多くのツールに無料枠がありますが、生成できる本数・長さ・解像度に制限があり、透かし(ウォーターマーク)が入ることもあります。公開用途や商用利用では有料プランが前提になるため、本文「無料で試せる主な動画生成AI」と「主要な動画生成AIツールの比較」で条件を確認してください。
Q. 生成した動画は商用利用できますか?
A. ツールの利用規約によります。有料プランで商用利用を認めるものが多い一方、生成物の権利の扱い、実在の人物や他社ブランドを含む生成の禁止など条件があります。公開前に規約の「商用利用」「生成物の権利」「禁止事項」を確認してください。
Q. 自社の商品や人物をそのまま動画にできますか?
A. 画像を起点に動かす方式なら、商品や人物の見た目を保ったまま動きを付けやすくなります。実在の人物を使う場合は本人の同意が必要で、ディープフェイク規制や肖像権にも注意が必要です(本文「技術的限界と倫理的論点」参照)。
まとめ
動画生成AIとは、拡散モデルとTransformerを中心とした深層学習の技術が、テキスト・画像・映像を入力として、時間的な一貫性を持つ映像を自動で生成する技術の総称です。2024年以降、Kling・Google(Veo/Gemini Omni)・Runwayなど多数のツールが実用の段階に達し(話題を集めたOpenAIのSoraは2026年に提供を終了)、広告制作・教育・エンターテインメント・バーチャルヒューマンなど、産業をまたいだ活用が進んでいます。
一方で技術的には、プロンプトへの忠実性のばらつき(JST jxiv掲載の研究より)、細部の物理整合性、長い動画での物語の維持など、未解決の課題が残っています。倫理・法的な側面では、ディープフェイク規制の国際的な強化(バイトダンスの生成停止はその端的な事例です)、著作権の帰属の未確定、AI生成コンテンツの開示義務が急速に整備されつつあります。
動画生成AIを実務や研究に組み込む際には、技術原理の理解と法的なリテラシーの両輪が欠かせません。より詳しい技術解説はディープラーニングの仕組み・マルチモーダルAI・GAN解説を、AIの最新動向は最新AI情報を参照してください。
弊社について:クリスタルメソッド株式会社は、バーチャルヒューマン/AIアバターソリューション「DeepAI」を開発・提供しています。動画生成AIおよびバーチャルヒューマン技術の業務活用に関するお問い合わせは公式サイトよりご連絡ください。
参考文献
- 科学技術振興機構(JST)jxiv「動画生成AIのテキストプロンプトへの忠実性の調査」
https://jxiv.jst.go.jp/index.php/jxiv/preprint/view/1532 - 科学技術振興機構 SciencePortal China「実在人物使用のAI動画生成停止 中国IT大手のバイトダンス」(2026年2月)
https://spap.jst.go.jp/china/news/kyodo/260203/ktopic_4_02.html - 福岡県よろず支援拠点「動画生成AIで集客丸わかり!セミナー」
https://yorozu-fukuoka.go.jp/douga-ai/ - OpenAI ヘルプセンター「What to know about the Sora discontinuation」
https://help.openai.com/en/articles/20001152-what-to-know-about-the-sora-discontinuation - Google「Gemini Omni – 動画生成」(Gemini アプリの動画生成モデル・2026年10月13日確認)
https://gemini.google/overview/video-generation/?hl=ja - Google「Gemini アプリで動画を生成する」(Gemini アプリ ヘルプ・2026年10月13日確認)
https://support.google.com/gemini/answer/16126339?hl=ja - Google DeepMind「Veo 3.1」(2026年10月13日確認)
https://deepmind.google/models/veo/ - Runway 公式サイト・料金ページ(Gen-4.5・2026年10月13日確認)
https://runway.com//https://runway.com/pricing - Kling AI 公式サイト(Kling 4.0・2026年10月13日確認)
https://klingai.com/global/ - Hailuo AI 公式サイト(MiniMax H3・2026年10月13日確認)
https://hailuoai.video/ - Pika 公式サイト・料金ページ(Pika 2.5・2026年10月13日確認)
https://pika.art//https://pika.art/pricing - Synthesia 公式サイト(2026年10月13日確認)
https://www.synthesia.io/ - Adobe Firefly プラン比較ページ(2026年10月13日確認)
https://www.adobe.com/jp/products/firefly/plans.html
動画生成AIの関連記事
関連記事
監修
河合 継(クリスタルメソッド株式会社 代表取締役)
AI・ディープラーニングに関する特許16件の発明者。過去、国立がん研究センターとの共同研究や、テレビ番組でのAI解説実績を持つAI研究者として、AIの研究開発を主導している。
運営会社について | 編集方針
Read next
あわせて読みたい
-
動画生成AIツール比較|性能・料金・用途で選ぶ2026年版
本ページは主要な動画生成AIツールの「比較・選び方」(性能・料金・用途別の向き不向き)に特化しています。動画生成AIの基礎知識は動画生成AIとは?仕組みを解説を...
-
動画生成AIの料金を徹底比較|主要サービスの料金プランとクレジットの仕組み【2026年版】
動画生成AIの導入を検討するとき、最初に気になるのが「実際いくらかかるのか」という料金の問題です。2025〜2026年現在、Sora・Runway・Pika・K...
-
動画生成AIの事例を徹底解説|業界別の活用法と導入のポイント
動画生成AIの事例を徹底解説|業界別の活用法と導入のポイント 動画生成AIは、テキストや画像を入力するだけでプロ品質の映像を自動生成する技術として、2024〜2...